

Am dezvoltat un design de rețea pentru centrele de date, care permite desfășurarea de clustere de calcul cu mai mult de 100.000 de servere, cu lățimi de bandă de secțiune transversală (bisection bandwidth) de peste un petabyte pe secundă.
Din raportul lui Dmitry Afanasyev veți afla despre principiile de bază ale noului design, scalarea topologiilor, problemele care apar în acest context, variantele de soluționare, precum și despre particularitățile rutării și scalării funcțiilor forwarding plane ale dispozitivelor de rețea moderne în topologii 'dens conectate' (densely connected) cu un număr mare de rute ECMP. De asemenea, Dima a vorbit pe scurt despre organizarea conectivității externe, nivelul fizic, sistemul de cabluri și modalitățile de creștere a capacității.
— Bună ziua tuturor! Numele meu este Dmitry Afanasyev, sunt arhitect de rețea la Yandex și mă ocup în principal de designul rețelelor pentru centrele de date.
Povestea mea va fi despre rețeaua actualizată a centrelor de date Yandex. Aceasta este, într-o mare măsură, o evoluție a designului pe care l-am avut, dar în același timp sunt și unele elemente noi. Aceasta este o prezentare generală, deoarece a fost necesar să încadrez o cantitate destul de mare de informații într-un timp scurt. Vom începe cu alegerea topologiei logice. Apoi va fi o prezentare generală a control plane și a problemelor de scalabilitate ale data plane, alegerea a ceea ce se va întâmpla la nivel fizic, vom privi câteva particularități ale dispozitivelor. Vom atinge și subiectul MPLS în data center, despre care am vorbit acum ceva timp.
Deci, ce este Yandex din perspectiva sarcinilor și serviciilor? Yandex este un hiperscaler tipic. Dacă privim în direcția utilizatorilor, avem în primul rând procesarea cererilor utilizatorilor. De asemenea, diferite servicii de streaming și livrarea de date, deoarece avem și servicii de stocare. Dacă ne îndreptăm spre backend, atunci apar sarcini și servicii infrastructurale, cum ar fi stocarea de obiecte distribuite, replicarea datelor și, bineînțeles, cozi persistente. Unul dintre principalele tipuri de sarcini este MapReduce și astfel de sisteme, procesare de fluxuri, învățare automată etc.
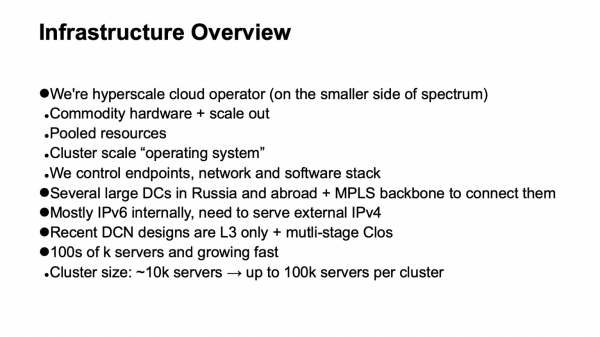
Cum este organizată infrastructura pe care se desfășoară toate acestea? Iarăși, suntem un hiperscaler tipic, deși poate ne aflăm puțin mai aproape de acea parte a spectrului unde se află hiperscalerii mai mici. Dar avem toate atributele. Folosim hardware de tip commodity și scalăm orizontal fiecare dată când este posibil. Resursele sunt centralizate: nu operăm cu mașini sau rack-uri individuale, ci le îmbinăm într-un mare pool de resurse interschimbabile, susținut de servicii suplimentare care se ocupă de planificare și alocare, lucrând cu tot acest pool.
Astfel, apare următorul nivel — sistemul de operare la nivelul clusterului de calcul. Este foarte important că avem control complet asupra stivei tehnologice utilizate. Controlăm punctele finale (gazdele), rețeaua și stiva software.
Avem câteva centre de date mari în Rusia și în străinătate. Acestea sunt conectate printr-un backbone care utilizează tehnologia MPLS. Infrastructura noastră internă este aproape în totalitate construită pe IPv6, dar deoarece trebuie să deservim traficul extern, care este în continuare majoritar pe IPv4, trebuie să reușim să livrăm solicitările venind prin IPv4 către frontend-servere, și să ne conectăm puțin și la internetul extern pe IPv4 — de exemplu, pentru indexare.
Ultimele câteva iterații ale designului rețelelor centrelor de date utilizează topologii Clos cu mai multe niveluri, și se aplică doar L3. Am renunțat la L2 cu ceva timp în urmă și am respirat ușurați. În cele din urmă, infrastructura noastră include sute de mii de instanțe de calcul (servere). Dimensiunea maximă a unui cluster a fost acum ceva timp de aproximativ 10.000 de servere. Acest lucru este în mare măsură determinat de modul în care funcționează acele sisteme de operare de nivel cluster, planificatorii, alocarea resurselor etc. Deoarece pe partea software-ului de infrastructură a avut loc un progres, acum dimensiunea țintă este de aproximativ 100.000 de servere într-un cluster de calcul, iar noi ne-am confruntat cu provocarea de a construi fabrici de rețea care să permită pooling-ul eficient al resurselor în acel cluster.
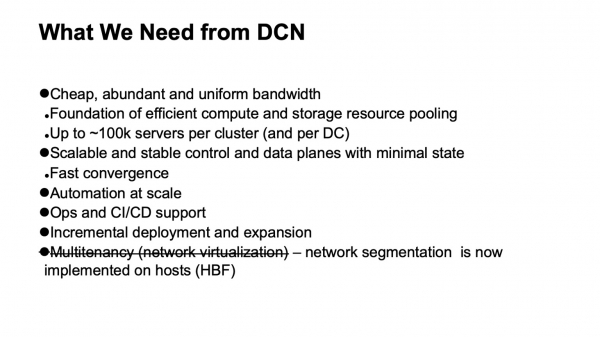
Ce ne dorim de la rețeaua unui centru de date? În primul rând, multă lățime de bandă ieftină și suficient de uniform distribuită. Pentru că rețeaua este substratul prin care putem face pooling de resurse. Noua dimensiune țintă este de aproximativ 100.000 de servere într-un cluster.
De asemenea, ne dorim, desigur, un control plane scalabil și stabil, pentru că într-o infrastructură atât de mare apar multe dureri de cap chiar și din evenimente întâmplătoare, și nu vrem să ne aducă și control plane-ul dureri de cap. În același timp, dorim să minimizăm starea în el. Cu cât starea este mai mică, cu atât mai bine și mai stabil funcționează totul, și este mai ușor de diagnosticat.
Desigur, avem nevoie de automatizare, pentru că gestionarea manuală a unei astfel de infrastructuri este imposibilă și nu a fost posibilă cu mult timp în urmă. Avem nevoie de suport pentru operațiuni operaționale și suport pentru CI/CD, cât mai mult posibil.
La astfel de dimensiuni ale centrelor de date și clusterelor, problema suportului pentru implementarea incrementală și extinderea fără întreruperea serviciului a devenit deja destul de acută. Dacă pe clustere de dimensiuni de o mie de mașini, poate chiar până la zece mii de mașini, acestea puteau fi extinse ca o operațiune unică – adică planificăm extinderea infrastructurii, iar câteva mii de mașini sunt adăugate ca o operațiune unică – atunci un cluster de dimensiuni de aproape o sută de mii de mașini nu apare imediat astfel, ci se construiește de-a lungul timpului. Și ar fi de dorit ca, pe tot parcursul acestui timp, tot ceea ce a fost deja implementat, infrastructura care a fost desfășurată, să fie disponibilă.
Și o cerință pe care o aveam și care a dispărut: aceasta este suportul pentru multitenancy, adică virtualizarea sau segmentarea rețelei. Acum nu mai trebuie să facem asta la nivelul fabricii de rețea, pentru că segmentarea a fost mutată la gazde, ceea ce ne-a ușurat enorm scalarea. Datorită IPv6 și a spațiului de adrese mare, nu a fost nevoie să folosim adrese dublate în infrastructura internă, întreaga adresare a fost oricum unică. Iar datorită faptului că am mutat filtrarea și segmentarea rețelei la gazde, nu a fost nevoie să creăm entități virtuale de rețea în rețelele centrelor de date.
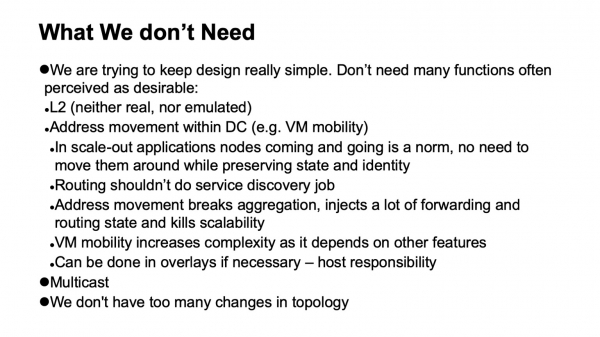
Un aspect foarte important este că nu avem nevoie de anumite funcții. Dacă anumite funcționalități pot fi eliminată din rețea, acest lucru simplifică mult viața și, de obicei, lărgește gama de echipamente și software disponibile, simplificând foarte mult diagnosticarea.
Așadar, ce anume nu avem nevoie, ce am putut să eliminăm, nu întotdeauna cu bucurie în momentul în care s-a întâmplat, dar cu multă ușurare când procesul s-a încheiat?
În primul rând, renunțarea la L2. Nu avem nevoie de L2, nici real, nici emulat. Acesta nu este folosit în mare măsură datorită faptului că controlăm stiva aplicațiilor. Aplicațiile noastre sunt scalabile pe orizontală, funcționează cu adresarea L3, și nu își fac prea multe griji că un anumit instanț se oprește, pur și simplu derulează unul nou, care nu trebuie să pornească pe o adresă veche, deoarece există un nivel separat de descoperire servicii și monitorizare a mașinilor din cluster. Nu delegăm această sarcină către rețea. Sarcina rețelei este de a livra pachete din punctul A în punctul B.
De asemenea, nu avem situații în care adresele se deplasează în interiorul rețelei, și acest lucru trebuie monitorizat. În multe designuri, acest lucru este, de obicei, necesar pentru a susține mobilitatea VM-urilor. Nu folosim mobilitatea mașinilor virtuale în infrastructura internă a marelui Yandex, și în plus, considerăm că, chiar dacă se face, acest lucru nu ar trebui să implică suportul rețelei. Dacă este absolut necesar, trebuie făcut la nivel de gazde și să fie incluse adresele care pot migra în overlay-uri, astfel încât să nu influențăm și să nu aducem prea multe modificări dinamice în sistemul de rutare a rețelei subiacente (transport).
O altă tehnologie pe care nu o folosim este multicastul. Pot să explic în detaliu de ce celor interesați. Acest lucru simplifică mult viața pentru că, dacă cineva a avut de-a face cu el și a observat cum arată control plane-ul multicastului – în toate instalațiile, cu excepția celor mai simple, este o mare durere de cap. Și mai mult, este greu de găsit o implementare open-source care să funcționeze bine, de exemplu.
Și în cele din urmă, proiectăm rețelele noastre astfel încât să nu se întâmple prea multe modificări. Ne putem aștepta ca fluxul de evenimente externe în sistemul de rutare să fie redus.
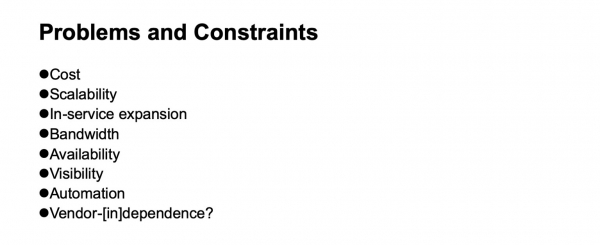
Ce probleme apar și ce limitări trebuie să luăm în considerare atunci când dezvoltăm o rețea de centre de date? Costul, desigur. Scalabilitatea, până la ce nivel vrem să creștem. Necesitatea de a extinde fără a opri serviciul. Lățimea de bandă, disponibilitatea. Vizibilitatea a ceea ce se întâmplă în rețea, pentru sistemele de monitorizare, pentru echipele de operare. Suportul pentru automatizare — din nou, cât mai mult posibil, deoarece diferite sarcini pot fi rezolvate la diferite niveluri, inclusiv prin introducerea unor straturi suplimentare. Și, desigur, dependența de furnizori. Deși, în diferite perioade istorice, în funcție de perspectiva pe care o avem, această independență a fost mai ușor sau mai greu de realizat. Dacă ne uităm la eșantionul chip-urilor echipamentelor de rețea, până recent, a vorbi despre independența de furnizori, dacă voiam și chip-uri cu lățime de bandă mare, era foarte condiționat.
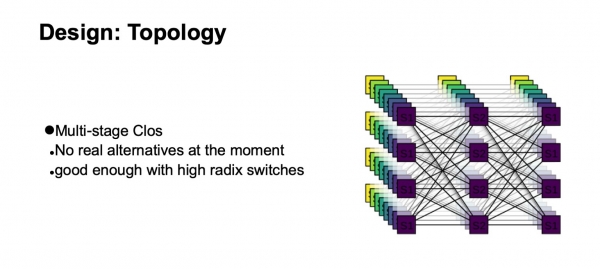
Pe ce topologie logică ne vom baza pentru a construi rețeaua noastră? Va fi o topologie Clos multi-nivel. De fapt, în present nu există alternative reale. Și topologia Clos este suficient de bună, chiar și când o comparăm cu diverse topologii avansate, care în prezent sunt mai mult în domeniul interesului academic, dacă avem comutatoare cu un radix mare.
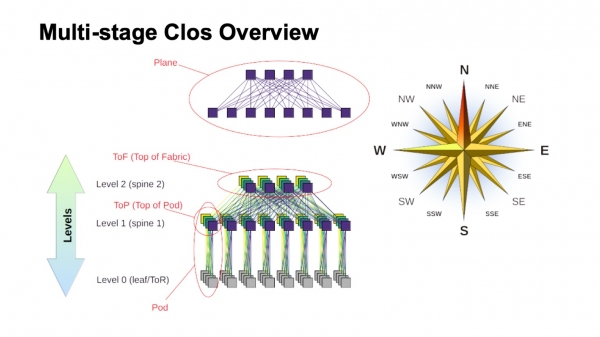
Cum este structurată aproximativ o rețea Clos multi-nivel și cum sunt denumite diferitele sale elemente? În primul rând, o busolă, pentru a ne orienta unde este nordul, unde este sudul, unde este estul, unde este vestul. Rețele de acest tip sunt construite de obicei de cei care au un trafic foarte mare din vest spre est. În ceea ce privește celelalte elemente, în partea de sus este reprezentat un comutator virtual, format din comutatoare mai mici. Aceasta este ideea principală a construcției recursive a rețelelor Clos. Luăm elemente cu un anumit radix și le conectăm astfel încât ceea ce am obținut să poată fi considerat un comutator cu un radix mai mare. Dacă este nevoie de și mai mult, procedura poate fi repetată.
În cazuri precum Clos cu două niveluri, când putem distinge clar componentele care în schema mea sunt verticale, acestea sunt de obicei denumite planuri. Dacă am construi Clos cu trei niveluri de switch-uri spine (toate cele care nu sunt de graniță și nu sunt switch-uri ToR și care sunt utilizate doar pentru tranzit), atunci planurile ar arăta mai complex, cele cu două niveluri arată așa. Blocul de switch-uri ToR sau leaf și switch-urile spine asociate de primul nivel le numim Pod. Switch-urile spine de nivel spine-1 de deasupra Pod-ului sunt top of Pod, vârful Pod-ului. Switch-urile care sunt amplasate în vârful întregii structuri sunt stratul superior al fabricii, Top of fabric.
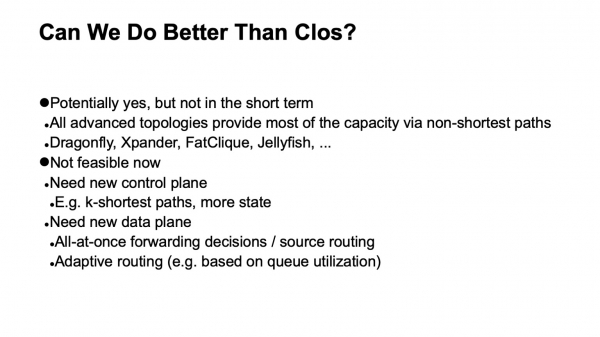
Desigur, apare întrebarea: rețelele Clos sunt construite de ceva timp, iar conceptul provine din vremurile telefoniei clasice și a rețelelor TDM. Poate a apărut ceva mai bun, poate putem face ceva mai bine? Și da, și nu. Teoretic da, în practică, în perioada următoare, cu siguranță nu. Pentru că există un anumit număr de topologii interesante, unele dintre ele fiind chiar utilizate în producție, de exemplu, Dragonfly este utilizat în aplicațiile HPC; există și topologii interesante precum Xpander, FatClique, Jellyfish. Dacă observăm lucrările de la conferințe precum SIGCOMM sau NSDI din ultima vreme, putem descoperi un număr destul de mare de lucrări despre topologii alternative care au proprietăți mai bune (într-un fel sau altul) decât Clos.
Dar toate aceste topologii au o caracteristică interesantă. Aceasta împiedică implementarea lor în rețelele de centre de date pe care încercăm să le construim pe hardware comun și care costă suficient de puțin. În toate aceste topologii alternative, cea mai mare parte a lățimii de bandă, din păcate, nu este disponibilă pe căile cele mai scurte. Prin urmare, ne pierdem imediat posibilitatea de a folosi planul de control tradițional.
Teoretic, soluția problemei este cunoscută. De exemplu, există modificări ale stării legăturii folosind k-celi mai scurți, dar din nou, nu există astfel de protocoale care să fie implementate în producție și disponibile pe scară largă pe echipamente.
În plus, deoarece cea mai mare parte a capacității nu este disponibilă pe cele mai scurte căi, trebuie să modificăm nu doar control plane-ul pentru a selecta toate aceste căi (și, apropo, acesta este un stadiu semnificativ mai mare în control plane). De asemenea, trebuie să modificăm forwarding plane-ul, și, de obicei, sunt necesare cel puțin două caracteristici suplimentare. Aceasta este capacitatea de a lua toate deciziile de forwarding al pachetelor simultan, de exemplu, pe gazdă. De fapt, acest lucru este routing-ul sursă, uneori în literatura despre rețelele de interconectare se numește decizii de forwarding all-at-once. Și încă routing adaptiv — aceasta este o funcție necesară în nodurile rețelei, referindu-se, de exemplu, la faptul că alegem următorul hop pe baza informațiilor despre cea mai mică încărcare a cozii. Ca exemplu, pot exista alte opțiuni.
Astfel, direcția este interesantă, dar, din păcate, în prezent nu o putem aplica.
Okay, ne-am oprit la topologia logică Clos. Cum o vom scalabiliza? Să vedem cum este structurat și ce se poate face.
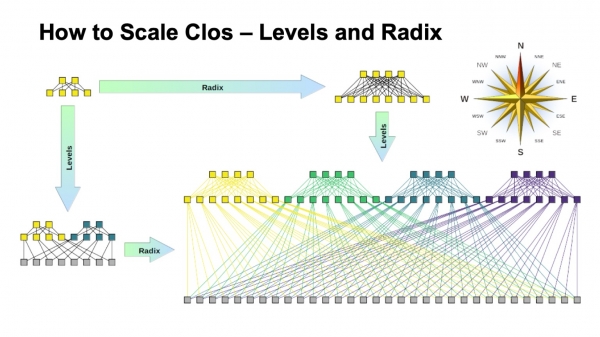
În rețeaua Clos, există doi parametri principali pe care îi putem varia pentru a obține diferite rezultate: radixul elementelor și numărul de niveluri din rețea. Am reprezentat schematic cum ambele influențează dimensiunea. În ideal, combinăm atât unul, cât și celălalt.
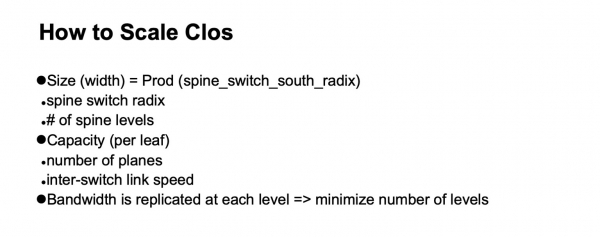
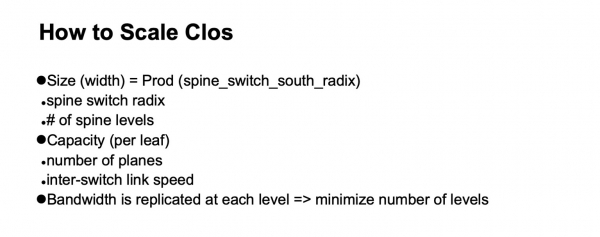
Se vede că lățimea finală a rețelei Clos este produsul tuturor nivelurilor switch-urilor spine ale radixului sudic, adică câte linkuri avem în jos, cum se ramifică. Așa scalăm dimensiunea rețelei.
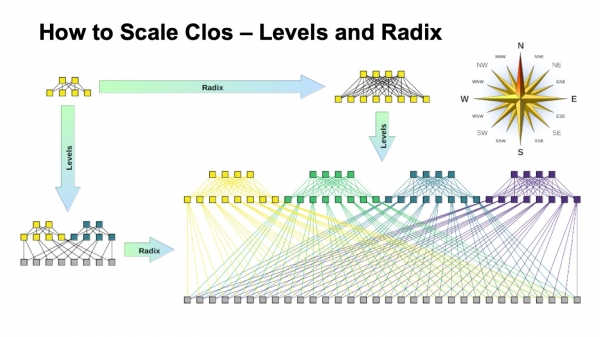
În ceea ce privește capacitatea, în special pe switch-urile ToR, avem două opțiuni de scalare. Fie putem, păstrând topologia generală, utiliza linkuri de viteză mai mare, fie putem adăuga un număr mai mare de planuri.
Dacă ne uităm la varianta extinsă a rețelei Clos (în colțul din dreapta jos) și revenim la această imagine cu rețeaua Clos de mai jos...
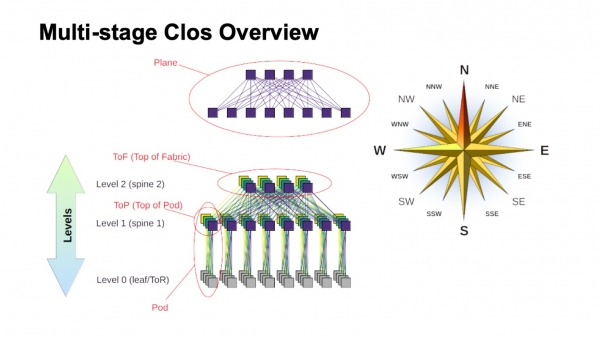
... este aceeași topologie, dar în această prezentare este comprimată mai compact și planurile fabricii sunt suprapuse. Este același lucru.
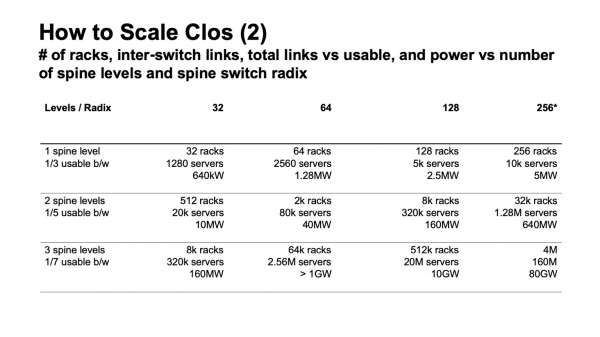
Cum arată scalarea rețelei Clos în cifre? Aici am prezentat datele despre ce lățime maximă poate avea rețeaua, câte rackuri, switch-uri ToR sau switch-uri leaf putem obține, dacă nu se află în rackuri, în funcție de radicul switch-urilor utilizate pentru nivelurile spine și câte niveluri folosim.
Aici este prezentat câte rack-uri avem, câte servere și aproximativ câtă putere ar putea consuma totul, calculat la 20 kW pe rack. Cu puțin timp în urmă, am menționat că ne propunem o dimensiune a cluster-ului de aproximativ 100.000 de servere.
Se observă că, în întreaga această construcție, interesul se concentrează pe două variante și jumătate. Există o variantă cu două straturi de spine și switch-uri cu 64 de porturi, care este puțin insuficientă. Apoi, există opțiuni excelente pentru switch-urile spine cu 128 de porturi (cu radix 128) cu două niveluri, sau switch-uri cu radix 32 cu trei niveluri. Și în toate cazurile, unde radicul este mai mare și nivelurile sunt mai multe, se poate construi o rețea foarte mare, dar dacă te uiți la consumul așteptat, de obicei, acolo sunt gigawați. Cablurile pot fi trase, dar astfel de cantități de electricitate într-o singură locație sunt puțin probabile să le obținem. Dacă ne uităm la statistici, datele publice despre centrele de date — foarte puține centre de date pot fi găsite cu o putere estimată mai mare de 150 MW. Ceea ce este mai mult, de obicei, sunt campusuri de centre de date, mai multe centre mari de date situate destul de aproape unul de altul.
Există și un alt parametru important. Dacă te uiți la coloana din stânga, acolo este menționată lățimea de bandă utilizabilă. Nu este greu de observat că într-o rețea Clos, o parte semnificativă a porturilor este dedicată conectării switch-urilor între ele. Lățimea de bandă utilizabilă — este ceea ce poate fi transmis în exterior, spre servere. Este evident că vorbesc despre porturi declarative și despre lățime. De obicei, legăturile din rețea sunt mai rapide decât legăturile spre servere, dar pe unitatea de lățime, cât putem oferi spre echipamentele noastre de servere, trebuie să mai alocăm o parte a lățimii în cadrul rețelei însăși. Iar cu cât mai multe niveluri facem, cu atât mai mari sunt costurile unitare pentru a oferi această lățime în exterior.
Mai mult, chiar și această lățime suplimentară nu este complet uniformă. Atunci când distanțele sunt scurte, putem folosi ceva de genul DAC (direct attach copper, adică cabluri twinax), sau fibră optică multimod, care este relativ rezonabil ca preț. De îndată ce trecem la distanțe mai lungi — de obicei, aceasta este fibră optică single mode, și costul acestei lățimi suplimentare crește semnificativ.
Și iarăși, revenind la diapozitivul anterior, dacă construim o rețea Clos fără reînscriere, nu e greu să ne uităm la schemă, să vedem cum se construiește rețeaua - adăugând fiecare nivel de switch-uri spine, repetăm întreaga bandă care era în partea de jos. Plus nivelul - plus toată aceeași bandă, încă atâtea porturi la comutatoare, încă atâția transceivere. Prin urmare, numărul de niveluri ale switch-urilor spine ar trebui să fie minimizat.
Pe baza acestei imagini, este clar că ne dorim foarte mult să ne construim pe ceva de tipul switch-urilor cu radix 128.
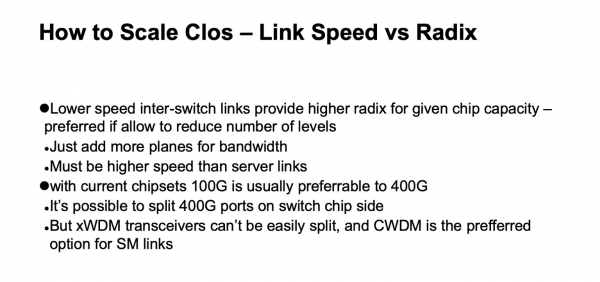
Aici, în principiu, totul este la fel ca ceea ce am spus acum, acest diapozitiv este mai degrabă pentru o revizuire ulterioară.
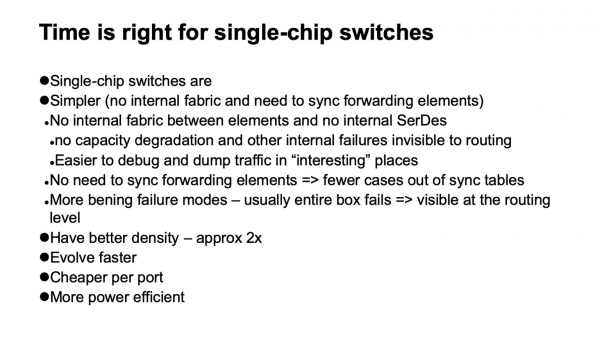
Ce opțiuni avem de ales ca astfel de comutatoare? O veste foarte plăcută pentru noi este că acum aceste rețele final au început să poată fi construite pe comutatoare cu un singur cip. Și acest lucru este grozav, au o mulțime de caracteristici plăcute. De exemplu, au aproape lipsă structură internă. Aceasta înseamnă că se defectează mai ușor. Se defectează, fără îndoială, dar, din fericire, se defectează complet. În dispozitivele modulare există o mulțime de defecte (foarte neplăcute), când din punctul de vedere al vecinilor și al controlului de plan părea că funcționează, dar, de exemplu, o parte din fabrică a ieșit din funcțiune și nu lucrează la capacitate maximă. Iar traficul către el este echilibrat pe baza faptului că este complet funcțional, iar noi putem obține o suprasarcină.
Sau, de exemplu, apar probleme cu backplane-ul, deoarece în interiorul dispozitivului modular există de asemenea SerDes-uri de mare viteză - este într-adevăr complex organizat în interior. Sau tabelele între elementele de forwarding sunt sincronizate sau nu. În general, orice dispozitiv modular performant, format dintr-un număr mare de elemente, conține, de obicei, aceeași rețea Clos, doar că este foarte greu de diagnosticat. Adesea, chiar și pentru furnizor, este greu de diagnosticat.
Și are un număr mare de scenarii de defectare, în care dispozitivul se degradează, dar nu iese complet din topologie. Deoarece avem o rețea mare, se folosește activ echilibrarea între elemente identice, rețeaua este foarte regulată, adică o cale, pe care totul este în regulă, nu se deosebește de cealaltă cale, ne este mai avantajos să pierdem pur și simplu o parte din dispozitive din topologie decât să ajungem în situația în care unele dintre ele par să funcționeze, dar parcă nu.
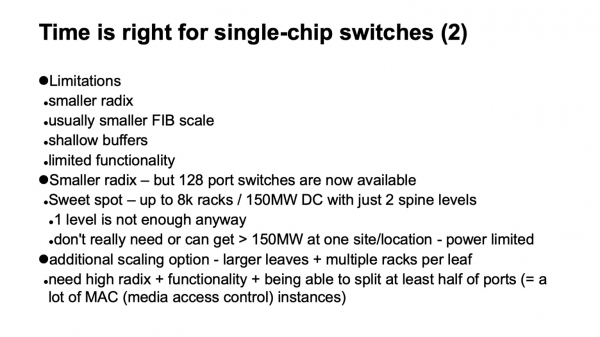
Următoarea caracteristică plăcută a dispozitivelor cu un singur cip este că acestea evoluează mai bine și mai repede. De asemenea, ele au, în general, o capacitate mai bună. Dacă luăm construcțiile mari pe care le avem, în medie, capacitatea pe unitate de rack pe porturi cu aceeași viteză se dovedește aproape de două ori mai bună decât la dispozitivele modulare. Dispozitivele construite în jurul unui singur cip devin semnificativ mai ieftine decât cele modulare și consumă mai puțin energie.
Dar, desigur, toate acestea nu vin fără neajunsuri. În primul rând, practic întotdeauna au un radix mai mic decât dispozitivele modulare. Dacă putem obține un dispozitiv construit în jurul unui singur cip cu 128 de porturi, atunci un dispozitiv modular poate avea sute de porturi deja fără probleme semnificative.
Aceasta duce la o dimensiune semnificativ mai mică a tabelelor de forwarding și, în general, a tot ceea ce ține de scalabilitatea planului de date. Bufferele sunt superficiale. Și, în general, funcționalitatea este destul de limitată. Dar se dovedește că, dacă cunoaștem aceste limitări și ne ocupăm din timp pentru a le o ocoli sau pur și simplu a le lua în considerare, nu este atât de grav. Faptul că radixul este mai mic, la dispozitivele recent apărute cu finalmente un radix de 128 nu mai este o problemă, putem construi în două straturi de spine. Și mai puțin de două nu putem construi nimic interesant ca dimensiune. Cu un singur nivel, obținem clustere foarte mici. Chiar și designurile și cerințele noastre anterioare le depășeau.
În realitate, dacă soluția este la limită, există o altă modalitate de a scalabili. Deoarece ultimul (sau primul), cel mai de jos nivel la care se conectează serverele sunt switch-urile ToR sau switch-urile leaf, nu suntem obligați să conectăm un singur rack la ele. Așadar, dacă soluția nu reușește să acopere o capacitate de două ori, putem lua în considerare utilizarea unui switch cu un radix mai mare la nivelul de bază și conectarea, de exemplu, a două sau trei rack-uri la un singur switch. Acesta este, de asemenea, o opțiune, are costurile sale, dar funcționează destul de bine și poate fi o soluție decentă atunci când trebuie să atingem de două ori dimensiunea.
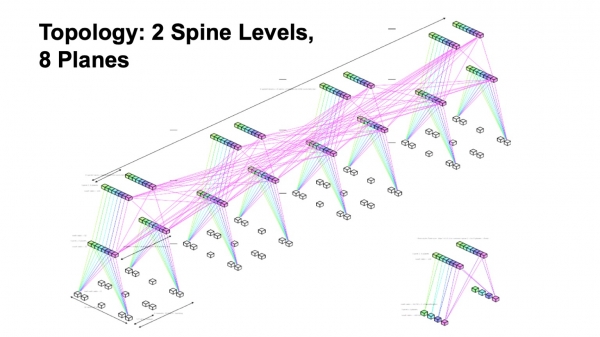
În concluzie, ne construim pe o topologie cu două nivele de spine, cu opt straturi de fabrică.
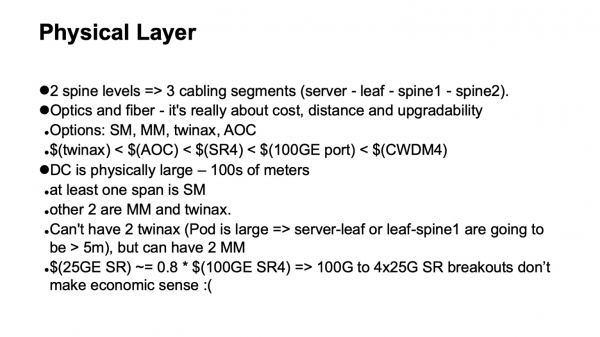
Ce se va întâmpla cu fizica? Calcul foarte simplu. Dacă avem două niveluri de spine, atunci avem în total trei niveluri de switch-uri, și ne așteptăm ca în rețea să există trei segmente de cablu: de la servere la switch-urile leaf, la spine 1, la spine 2. Opțiunile pe care le putem folosi sunt twinax, multimode, single mode. Aici trebuie să luăm în considerare ce lățime de bandă este disponibilă, cât va costa, care sunt dimensiunile fizice, ce deschideri putem traversa și cum ne vom face upgrade.
În ceea ce privește costul, totul poate fi organizat pe o linie. Twinax-urile sunt semnificativ mai ieftine decât optica activă, mai ieftine decât transceiverele multimode, dacă ne raportăm la deschidere, puțin mai ieftine decât un port de switch de 100 gigabiți. Și, atenție, este mai ieftin decât optica single mode, deoarece în deschiderile unde este necesară optica single mode, în centrele de date este mai logic să utilizăm CWDM, iar utilizarea single mode paralel (PSM) nu este foarte convenabilă, rezultând pachete foarte mari de fibră, iar dacă rămânem la aceste tehnologii, ierarhia prețurilor arată aproximativ așa.
O altă observație: din păcate, nu se poate utiliza foarte bine porturile multimode de 100 la 4x25. Din cauza particularităților construcției transceiverelor SFP28, acestea nu sunt semnificativ mai ieftine decât QSFP28 la 100 Gbps. Și această descompunere pentru multimode nu funcționează foarte bine.
O altă limitare este aceea că, din cauza dimensiunii clustere de calcul și a numărului de servere, centrele noastre de date devin fizic mari. Aceasta înseamnă că va trebui să realizăm cel puțin un segment cu fibră monomodală. Din nou, din cauza dimensiunii fizice a Pods, nu se poate realiza un segment cu cabluri twinax (cupru) care să treacă pe două tronsoane.
Prin urmare, dacă optimizăm după preț și luăm în considerare geometria acestei construcții, obținem un segment twinax, un segment multimodal și un segment monomodal folosind CWDM. Aceasta ia în calcul căile posibile de upgrade.
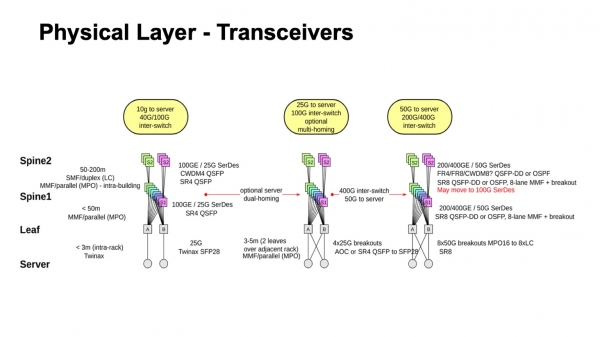
Așa arată aproximativ ceea ce s-a întâmplat recent, încotro ne îndreptăm și ce este posibil. Este clar, cel puțin, cum să ne mișcăm spre SerDes de 50 gigabiți și atât pentru multimod, cât și pentru monomod. Mai mult, dacă ne uităm la ce există acum în transceivere monomode și la perspectiva pentru 400G, adesea când vin SerDes de 50G pe partea electrică, fibră poate susține deja 100 Gbps per canal. Prin urmare, este foarte posibil ca, în loc de o tranziție la 50, să se treacă la SerDes de 100 gigabiți și 100 Gbps per canal, deoarece conform promisiunilor multor furnizori, disponibilitatea acestora este așteptată destul de curând. Perioada în care SerDes de 50G au fost cele mai rapide pare că nu va fi foarte lungă, deoarece primele exemplare de 100G SerDes ar putea apărea chiar anul următor. Și, după un timp, este posibil ca acestea să aibă un preț rezonabil.
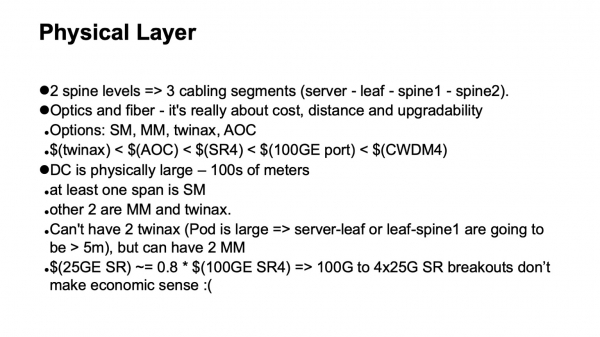
Un alt detaliu în privința alegerii fizicii. În principiu, deja acum putem folosi porturi de 400 sau 200 gigabiți cu SerDes de 50G. Dar se dovedește că nu are un sens special, deoarece, așa cum am menționat anterior, ne dorim un radix destul de mare pe comutatoare, în limite rezonabile, desigur. Ne dorim 128. Și dacă capacitatea chip-ului este limitată și creștem viteza legăturii, atunci radix, evident, scade, nu sunt miracole.
Iar capacitatea totală o putem crește prin plane, fără costuri speciale, putând adăuga numărul de plane. Iar dacă pierdem radix, va trebui să introducem un nivel suplimentar, așa că în condițiile actuale, cu capacitatea maximă disponibilă pe un singur chip, se dovedește că este mai eficient să folosim porturi de 100 gigabiți, deoarece acestea permit obținerea unui radix mai mare.
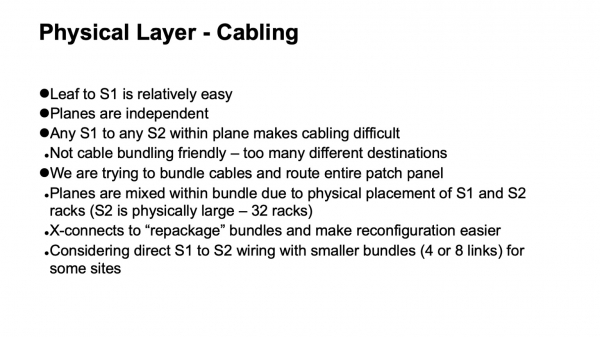
Următorul subiect este cum este organizată fizica, dar din perspectiva infrastructurii de cablare. Se dovedește că aceasta este organizată într-un mod destul de interesant. Cablarea între switch-urile leaf și spine de primul nivel – nu sunt atât de multe legături, totul este construit relativ simplu. Însă, dacă luăm o planșă, ceea ce se întâmplă în interior – trebuie să conectăm toate spine-urile de primul nivel cu toate spine-urile de al doilea nivel.
În plus, de obicei, există anumite cerințe cu privire la cum ar trebui să arate în interiorul centrului de date. De exemplu, ne-am dorit foarte mult să grupăm cablurile într-un bundle și să le tragem astfel încât un panou de patch-uri de înaltă densitate să se ducă complet într-un panou de patch-uri, pentru a nu avea un haos al lungimilor. Am reușit să rezolvăm această problemă. Dacă privim inițial topologia logică, se vede că planșele sunt independente, fiecare planșă poate fi construită de sine stătător. Dar când adăugăm un astfel de bundling și dorim să tragem complet un panou de patch-uri în alt panou, trebuie să amestecăm diferite planșe în cadrul unui singur bundle și să introducem o structură intermediară sub formă de cross-connect-uri optice, pentru a le reambala de la modul în care au fost asamblate pe un segment, la modul în care vor fi asamblate pe alt segment. Datorită acestui lucru, obținem o caracteristică plăcută: toată comutația complexă nu depășește limitele rack-urilor. Când este necesar să le împletim foarte mult, „să desfășurăm planșele”, așa cum se numește uneori în rețelele Clos, totul este concentrat în cadrul unui singur rack. Nu avem comutații foarte descompuse, până la legături individuale, între rack-uri.
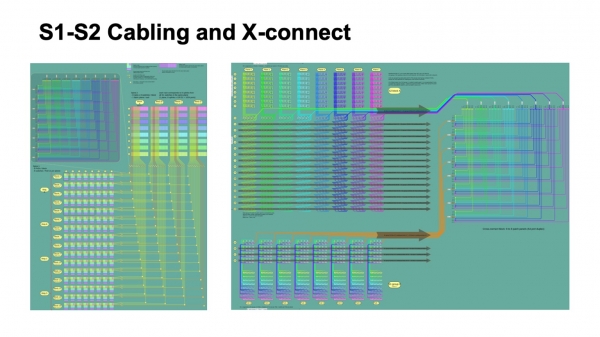
Așa arată din perspectiva organizării logice a infrastructurii de cablare. În imaginea din stânga, blocurile colorate reprezintă blocuri de spine-switch-uri de primul nivel, câte opt, și cele patru bundle-uri de cabluri care pleacă de la acestea, care se intersectează cu bundle-urile provenite de la blocurile de spine-2-switch-uri.
Cercurile mici indică intersecții. În colțul din stânga sus este prezentată desfășurarea fiecărei astfel de intersecții, de fapt, este un modul de cross-connect cu 512 la 512 porturi, care reambalează cablurile astfel încât să ajungă complet într-o singură rack, având doar un singur plan spine-2. Iar la dreapta este desfășurarea acestei imagini puțin mai detaliată, aplicabilă mai multor Pods la nivelul spine-1, și cum această structură este ambalată în cross-connect, cum ajunge la nivelul spine-2.
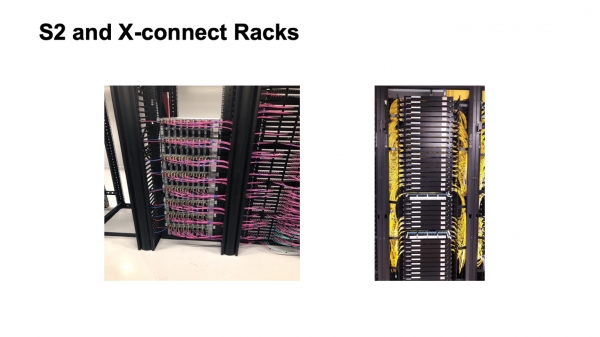
Iată cum arată. Un rack spine-2 încă necompletat (stânga) și rack-ul cross-connect. Din păcate, nu se vede foarte mult. Întreaga această construcție se desfășoară chiar acum în unul dintre centrele noastre de date mari, care este în expansiune. Este un proces în desfășurare, va arăta mai bine, va fi umplut mai bine.
O întrebare importantă: am ales o topologie logică, am construit fizica. Ce se va întâmpla cu control plane-ul? Este bine cunoscut din experiența operării că există un anumit număr de prezentări, că protocoalele link state sunt bune, este plăcut să lucrezi cu ele, dar, din păcate, în topologiile dens interconectate, acestea scalazează prost. Și există un factor principal care interferează - modul în care funcționează flooding-ul în protocoalele link state. Dacă pur și simplu luăm algoritmul de flooding, uităm la cum este construită rețeaua noastră, observăm că la fiecare pas va exista un fanout foarte mare, ceea ce va inunda control plane-ul cu actualizări. Anume aceste topologii, împreună cu algoritmul tradițional de flooding în protocoalele link state, se amestecă foarte prost.
Soluția - utilizarea BGP. Cum să îl pregătim corect, este descris în RFC 7938 despre utilizarea BGP în centre mari de date. Ideile de bază sunt simple: o cantitate minimă de prefixe pe host și, în general, o cantitate minimă de prefixe în rețea, utilizarea agregării, dacă este posibil, și suprimarea path hunting-ului. Vrem o distribuție foarte controlată a actualizărilor, ceea ce se numește valley free. Vrem ca actualizările, în călătoria lor prin rețea, să se desfășoare exact o dată. Dacă ele provin dintr-un anumit punct, trebuie să urce, desfășurându-se nu mai mult de o dată. Trebuie să evităm zigzagurile. Zigzagurile sunt foarte dăunătoare.
Pentru a face acest lucru, folosim un schelet destul de simplu pentru a aplica mecanismele de bază BGP. Adică, utilizăm eBGP, care funcționează pe link local, iar sistemele autonome sunt atribuite astfel: un sistem autonom pe ToR, un sistem autonom pentru întreaga bloc de switch-uri spine-1 ale unui Pod și un sistem autonom general pentru întregul Top of Fabric. Nu este greu să se verifice și să se observe că, chiar și comportamentul normal al BGP ne oferă propagarea actualizărilor pe care le dorim.
Desigur, trebuie să proiectăm adresarea și agregarea adreselor astfel încât să fie compatibile cu modul în care este construită rutarea, pentru a asigura stabilitatea control plane-ului. Adresarea L3 în transport este legată de topologie, deoarece fără aceasta nu se poate realiza agregarea, fără aceasta, adresele individuale vor pătrunde în sistemul de rutare. Și mai este un lucru - agregarea, din păcate, nu se combină foarte bine cu multi-path, deoarece atunci când avem multi-path și există agregare, totul este bine când întreaga rețea funcționează, fără eșecuri. Din păcate, de îndată ce apar eșecuri în rețea și simetria topologiei este pierdută, putem ajunge în punctul din care a fost anunțat agregatul, din care nu putem trece mai departe către locul de care avem nevoie. De aceea, este mai bine să agregăm acolo unde nu mai există multi-path, în cazul nostru, acestea sunt switch-urile ToR.
De fapt, agregarea este posibilă, dar cu prudență. Dacă putem realiza o dezagregare controlată în cazul apariției eșecurilor în rețea. Dar aceasta este o sarcină destul de complexă, ne-am gândit chiar dacă este posibil să implementăm automatizări suplimentare, și automate finite care vor interacționa corect cu BGP pentru a obține comportamentul dorit. Din păcate, gestionarea cazurilor-limită este foarte neclară și complicată, iar prin conectarea echipamentelor externe la BGP, această problemă nu este soluționată bine.
O muncă foarte interesantă în acest sens a fost realizată în cadrul protocolului RIFT, despre care va fi vorbit în următoarea prezentare.
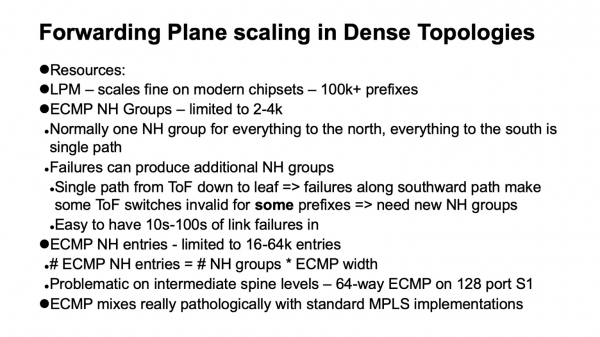
Un alt aspect important este modul în care se scalează data plane-urile în topologii dense, unde avem un număr mare de căi alternative. Aici sunt utilizate câteva structuri de date suplimentare: grupuri ECMP, care descriu, la rândul lor, grupurile Next Hop.
Într-o rețea care funcționează corect, fără întreruperi, atunci când ne deplasăm pe topologia Clos, este suficient să folosim un singur grup, deoarece tot ceea ce nu este local este descris de default, putem merge în sus. Atunci când ne deplasăm de sus în jos spre sud, toate căile nu ECMP sunt căi unice. Totul este în regulă. Problema este că, și particularitatea topologiei Clos clasice, este că, dacă ne uităm la Top of fabric, la orice element, de la orice element de jos există o singură cale. Dacă apar întreruperi pe această cale, atunci acel element de sus al fabricii devine invalid pentru acele prefixe care se află pe calea defectă. Iar pentru celelalte este valid, și trebuie să examinăm grupurile ECMP și să introducem un nou state.
Cum arată scalabilitatea planului de date pe dispozitivele moderne? Dacă facem LPM (longest prefix match), totul este destul de bine, peste 100k prefixe. Dacă vorbim despre grupurile Next Hop, lucrurile sunt mai rele, între 2-4 mii. Dacă ne referim la tabelul care conține descrierea Next Hops (sau adiacențe), atunci acest lucru este undeva între 16k și 64k. Și aceasta poate deveni o problemă. Și aici ajungem la o digresiune interesantă: ce s-a întâmplat cu MPLS în centrele de date? Practic, am vrut să-l implementăm.
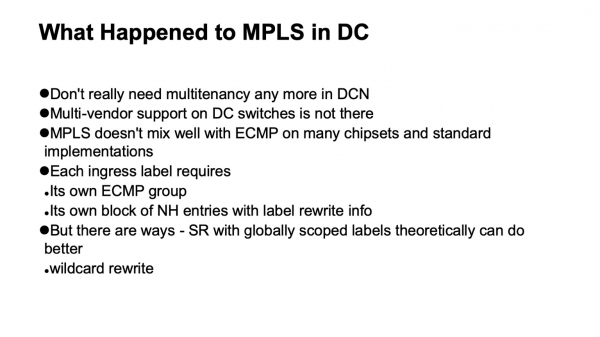
S-au întâmplat două lucruri. Am realizat microsegmente pe gazde, astfel că nu mai era necesar să facem acest lucru la nivelul rețelei. Nu a fost foarte bine cu suportul din partea diferitelor furnizori și cu atât mai puțin cu implementările deschise pe white boxes cu MPLS. Iar MPLS, cel puțin, implementările sale tradiționale, din păcate, se combină foarte prost cu ECMP. Și aceasta este rațiunea.
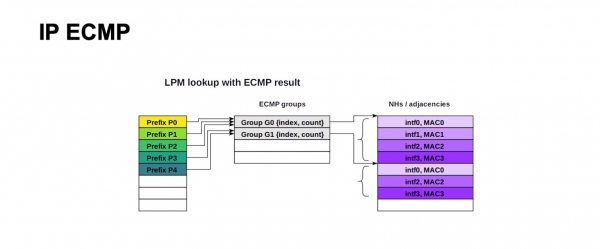
Aceasta este structura de forwarding ECMP pentru IP. Un număr mare de prefixe poate utiliza același grup și același bloc de Next Hops (sau adiacențe, în documentația diferitelor dispozitive aceasta poate fi denumită diferit). Ideea este că este descris ca un port de ieșire și pe ce să rescriem adresa MAC pentru a ajunge la Next Hop corect. Pentru IP, totul arată simplu, putem utiliza un număr foarte mare de prefixe pe același grup, același bloc de Next Hops.
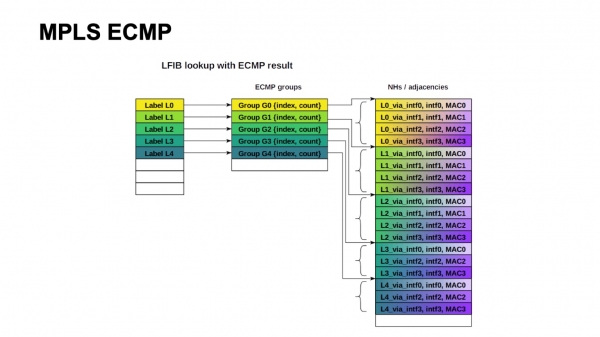
Arhitectura clasică MPLS presupune că, în funcție de interfața de ieșire, eticheta poate fi rescrisă în valori diferite. De aceea, trebuie să păstrăm un grup și un bloc de Next Hops pentru fiecare etichetă de intrare. Și, din păcate, aceasta nu se scalează.
Nu este greu să observăm că, în structura noastră, aveam nevoie de aproximativ 4000 de switch-uri ToR, cu o lățime maximă de 64 de căi ECMP, dacă ne îndepărtăm de spine-1 spre spine-2. Ne facem cu greu loc, la limită, într-un singur tabel de grupuri ECMP, dacă doar un prefix cu ToR se îndepărtează, și nu reușim deloc să ne încadrăm în tabelul Next Hops.
Toate nu sunt disperate, pentru că arhitecturi de tip Segment Routing implică etichete globale. Formal, ar fi fost posibil să comprima din nou toate aceste blocuri Next Hops. Pentru aceasta, este necesară o operație de tip wild card: să luăm o etichetă și să o scriem din nou pe aceeași fără o valoare specifică. Din păcate, în implementările disponibile, acest lucru nu prea se regăsește.
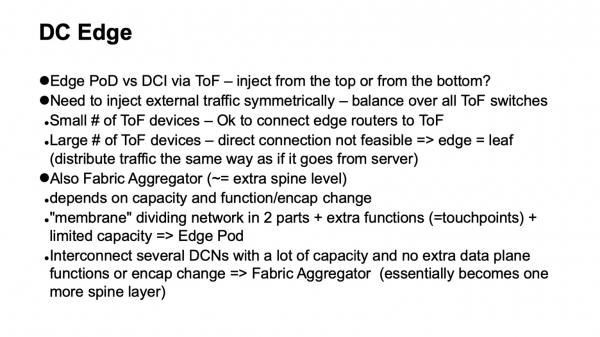
Și, în cele din urmă, trebuie să aducem trafic extern în centru de date. Cum se face acest lucru? În trecut, traficul era introdus în rețelele Clos de sus. Adică existau routere de frontieră care se conectau la toate dispozitivele de la Top of fabric. Această soluție funcționează destul de bine la dimensiuni mici și medii. Din păcate, pentru a introduce traficul în mod simetric în întreaga rețea, trebuie să ne conectăm simultan la toate elementele Top of fabric, iar când numărul acestora depășește o sută, se dovedește că avem nevoie de un radix mare și pe routerele de frontieră. În general, asta costă bani, pentru că routerele de frontieră sunt mai funcționale, iar porturile de pe acestea sunt mai scumpe, iar configurația nu este foarte frumoasă.
O altă variantă este să introducem astfel de trafic din partea de jos. Nu este greu să ne convingem că topologia Clos este construită astfel încât traficul care intră din partea de jos, adică din partea ToR, este distribuit uniform pe niveluri în întreaga rețea Top of fabric în două iterații, încărcând întreaga rețea. Prin urmare, introducem un tip special de Pod, Edge Pod, care asigură conectivitatea externă.
Există o altă opțiune. De exemplu, Facebook o folosește. Ei o numesc Fabric Aggregator sau HGRID. Se introduce un nivel suplimentar de spine pentru a conecta mai multe centre de date. Această structură este posibilă dacă nu avem funcții suplimentare la intersecții sau schimbări de încapsulare. Dacă acestea există, sunt puncte de atingere suplimentare, ceea ce este complicat. De obicei, apar mai multe funcții și un fel de membrană care separă diferitele părți ale centrului de date. Nu ar trebui să facem această membrană foarte mare, dar dacă este absolut necesară, are sens să considerăm posibilitatea de a o transporta, de a o face cât mai largă și a o muta pe hosts. Așa fac, de exemplu, mulți operatori de cloud. Ei au overlay-uri, care încep de la hosts.
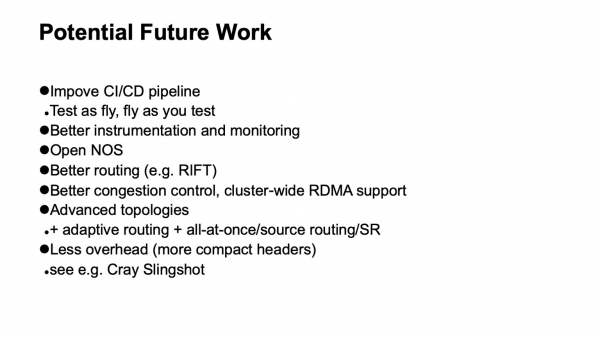
Ce oportunități de dezvoltare observăm? În primul rând, îmbunătățirea suportului pentru pipeline-ul CI/CD. Vrem să operăm așa cum testăm și să testăm așa cum operăm. Acest lucru nu funcționează foarte bine, deoarece infrastructura este mare și nu putem să o duplicăm pentru teste. Trebuie să înțelegem cum să introducem elemente de testare în infrastructura operațională, fără a o afecta.
Instrumentarea mai bună, monitorizarea mai bună sunt întotdeauna utile. Totul depinde de echilibrul dintre eforturi și rezultate. Dacă se poate adăuga în mod rezonabil, este foarte bine.
Sisteme de operare deschise pentru dispozitivele de rețea. Cele mai bune protocoale și cele mai bune sisteme de rutare, de exemplu RIFT. De asemenea, sunt necesare cercetări privind aplicarea celor mai bune scheme de control al congestionării și, eventual, implementarea, cel puțin în unele puncte, a suportului RDMA în cadrul clusterului.
Dacă ne uităm la un viitor mai îndepărtat, sunt necesare topologii avansate și, posibil, rețele care utilizează un overhead mai mic. Printre inovațiile recente se numără publicarea tehnologiilor de fabricare pentru HPC Cray Slingshot, care se bazează pe Ethernet comercial, dar cu opțiunea de a utiliza antete mult mai scurte. Ca urmare, overhead-ul scade.
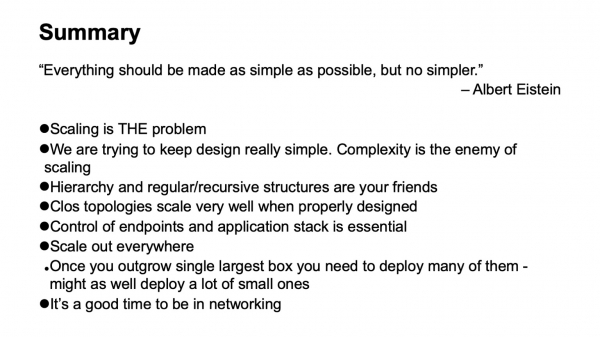
Trebuie să facem totul cât mai simplu posibil, dar nu mai simplu. Complexitatea este dușmanul scalabilității. Simplitatea și structurile regulate sunt prietenii noștri. Dacă se poate face scale-out undeva — fă-o. În general, acum este o perioadă interesantă pentru tehnologiile de rețea. Se întâmplă multe lucruri interesante. Mulțumesc.
Sursa: habr.com
