

Cu baza de date Apache Cassandra și necesitatea de a o gestiona în cadrul unei infrastructuri bazate pe Kubernetes ne confruntăm în mod regulat. În acest material vom împărtăși viziunea noastră asupra pașilor necesari, criteriilor și soluțiilor existente (inclusiv o prezentare a operatorilor) pentru migrarea Cassandra în K8s.
„Cine poate gestiona o femeie, poate gestiona și un stat”
Cine este Cassandra? Este un sistem distribuit de stocare, destinat gestionării unor volume mari de date, asigurând în același timp o disponibilitate ridicată fără un singur punct de eșec. Proiectul cu greu are nevoie de o prezentare lungă, așa că voi menționa doar principalele caracteristici ale Cassandra, care vor fi relevante în contextul acestui articol:
- Cassandra este scrisă în Java.
- Topologia Cassandra include mai multe niveluri:
- Node — o instanță Cassandra desfășurată;
- Rack — un grup de instanțe Cassandra, unite după un anumit criteriu, aflate într-un singur centru de date;
- Datacenter — totalitatea grupurilor de instanțe Cassandra, aflate într-un singur centru de date;
- Cluster — totalitatea tuturor centrelor de date.
- Pentru identificarea nodului, Cassandra folosește adresa IP.
- Pentru rapiditatea operațiunilor de scriere și citire, o parte din datele Cassandra sunt stocate în memorie.
Acum — la propriu la posibila mutare în Kubernetes.
Check-list pentru transfer
Când vorbim despre migrarea Cassandra în Kubernetes, sperăm că odată cu mutarea va deveni mai convenabilă gestionarea acesteia. Ce este necesar pentru aceasta, ce va ajuta în acest proces?
1. Stocare pentru date
După cum s-a menționat, o parte din datele Cassandra sunt stocate în memorie — în Memtable. Dar există și o altă parte a datelor, care este salvată pe disc — sub formă de SSTable. Acestor date li se adaugă entitatea Commit Log — înregistrări despre toate tranzacțiile, care de asemenea sunt salvate pe disc.
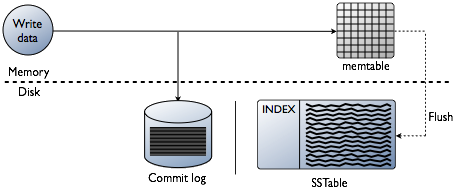
Schema de tranzacții de scriere în Cassandra
În Kubernetes, putem folosi PersistentVolume pentru stocarea datelor. Datorită mecanismelor deja bine stabilite, lucrul cu datele în Kubernetes devine, an de an, tot mai simplu.
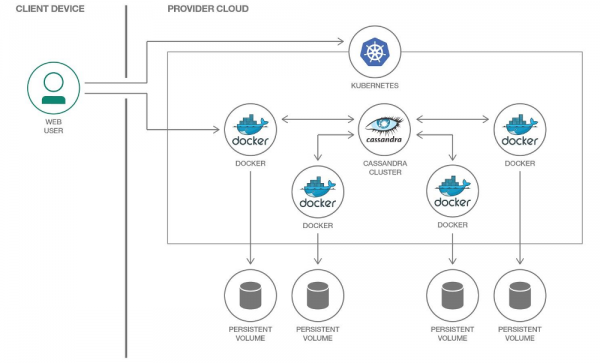
Fiecare pod Cassandra va primi propriul său PersistentVolume.
Este important de menționat că Cassandra în sine implică replicarea datelor, oferind pentru aceasta mecanisme integrate. Prin urmare, dacă construiți un cluster Cassandra dintr-un număr mare de noduri, nu este necesar să utilizați sisteme distribuite pentru stocarea datelor, cum ar fi Ceph sau GlusterFS. În acest caz, ar fi logic să stocați datele pe discul nodului folosind sau prin montare hostPath.
O altă întrebare este dacă doriți să creați un mediu separat pentru dezvoltatori pentru fiecare ramură de features. În acest caz, abordarea corectă ar fi să ridicați un nod Cassandra și să stocați datele într-un stocare distribuită, adică Ceph și GlusterFS menționate vor fi opțiunea dvs. Atunci dezvoltatorul va fi sigur că nu va pierde datele de testare chiar și în cazul pierderii unuia dintre nodurile clusterului Kubernetes.
2. Monitorizarea
Alegerea aproape fără alternativă pentru implementarea monitorizării în Kubernetes este Prometheus (în detaliu am discutat despre acest lucru în ). Ce face Cassandra în ceea ce privește exportatorii de metrici pentru Prometheus? Și, ceea ce este chiar mai important, cu dashboard-uri potrivite pentru Grafana?
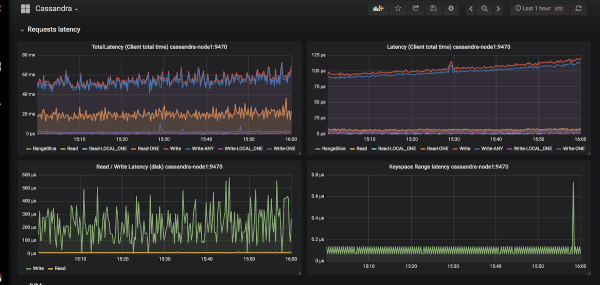
Exemplu de aspect al graficelor în Grafana pentru Cassandra
Există doar doi exportatori: și .
Am ales pentru noi pe primul, deoarece:
- JMX Exporter crește și se dezvoltă, în timp ce Cassandra Exporter nu a reușit să obțină sprijin corespunzător din partea comunității. Cassandra Exporter nu suportă în continuare cele mai multe versiuni Cassandra.
- Poate fi lansat ca javaagent prin adăugarea flag-ului
-javaagent:<plugin-dir-name>/cassandra-exporter.jar=--listen=:9180. - Pentru acesta există , care nu este compatibil cu Cassandra Exporter.
3. Alegerea primitivelor Kubernetes
Conform structurii de mai sus a clusterului Cassandra, încercăm să traducem tot ce este descris în terminologia Kubernetes:
- Nod Cassandra → Pod
- Rack Cassandra → StatefulSet
- Centrul de date Cassandra → un grup de StatefulSets
- Cluster Cassandra → ???
Se pare că lipsește o anumită entitate suplimentară pentru a gestiona întregul cluster Cassandra simultan. Dar dacă lipsește ceva, putem crea noi! În Kubernetes, pentru aceasta există mecanismul definiției resurselor proprii — .
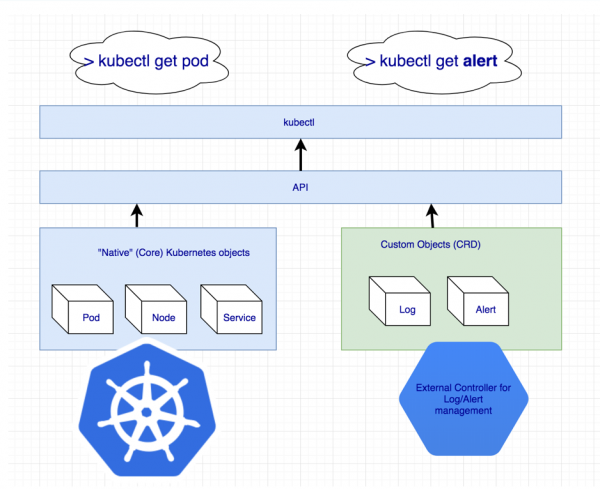
Declararea resurselor suplimentare pentru jurnale și alerte
Dar resursa personalizată în sine nu înseamnă nimic: pentru ea este necesar un controller. Este posibil să fie necesar să apelăm la ajutorul …
4. Identificarea pod-urilor
În punctul anterior, am convenit că un nod Cassandra va corespunde unui pod în Kubernetes. Dar adresele IP ale pod-urilor vor fi diferite de fiecare dată. Identificarea nodului în Cassandra se face exact pe baza adresei IP... Așadar, după fiecare eliminare a unui pod, clusterul Cassandra va adăuga un nou nod.
Există soluții, și nu doar una:
- Putem ține evidența după identificatorii gazdelor (UUID-uri, care identifică în mod unic instanțele Cassandra) sau după adresele IP și să păstrăm toate acestea în anumite structuri/tabele. Metoda are două dezavantaje principale:
- Risc de apariție a unei condiții de competiție în cazul în care se prăbușesc simultan două noduri. După ridicare, nodurile Cassandra vor solicita simultan o adresă IP din tabel și vor concura pentru aceeași resursă.
- Dacă un nod Cassandra și-a pierdut datele, nu-l vom mai putea identifica.
- A doua soluție pare a fi un mic hack, dar totuși: putem crea un Service cu ClusterIP pentru fiecare nod Cassandra. Problemele acestei implementări sunt:
- Dacă în clusterul Cassandra sunt foarte multe noduri, va trebui să creăm foarte multe Service-uri.
- Funcționalitatea ClusterIP este realizată prin iptables. Aceasta poate deveni o problemă dacă în clusterul Cassandra sunt multe (1000... sau chiar 100?) noduri. Deși poate rezolva această problemă.
- A treia soluție este de a folosi rețeaua nodurilor pentru nodurile Cassandra în locul unei rețele dedicate pod-urilor prin activarea setării
hostNetwork: true. Această metodă impune anumite restricții:- Referitor la înlocuirea nodurilor. Este necesar ca noul nod să aibă aceeași adresă IP ca și cel anterior (în servicii cloud precum AWS, GCP, aceasta este aproape imposibil de realizat);
- Folosind rețeaua nodurilor clusterului, începem să concurăm pentru resursele de rețea. Prin urmare, a plasa mai mult de un pod cu Cassandra pe un nod al clusterului va fi problematic.
5. Backup-uri
Dorim să păstrăm o versiune completă a datelor unui nod Cassandra conform unui program. Kubernetes oferă o oportunitate convenabilă prin utilizarea , dar aici Cassandra ne pune obstacole.
Reamintesc că o parte din datele Cassandra sunt stocate în memorie. Pentru a efectua un backup complet, trebuie să transferăm datele din memorie (Memtables) pe disc (SSTables). În acest moment, nodul Cassandra încetează să acceptă conexiuni, devenind complet inactiv în cadrul clusterului.
După aceasta, se face backup-ul (snapshot) și se păstrează schema (keyspace). Și aici se dovedește că o simplă copie de rezervă nu ne ajută: trebuie să păstrăm identificatorii datelor pentru care nodul Cassandra este responsabil — acestea sunt tokenuri speciale.
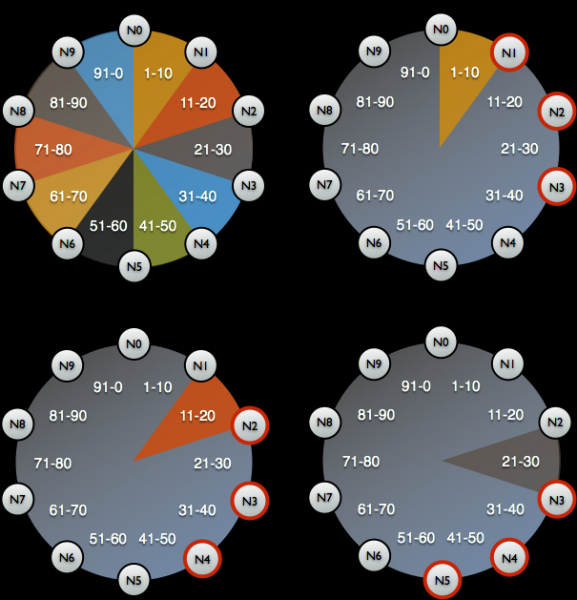
Distribuția tokenurilor pentru identificarea datelor pentru care nodurile Cassandra sunt responsabile
Un exemplu de script pentru realizarea unei copii de rezervă Cassandra de la Google în Kubernetes poate fi găsit la . Singurul aspect pe care scriptul nu îl ia în considerare este resetarea datelor pe nod înainte de a face snapshot-ul. Asta înseamnă că backup-ul nu se face pentru starea actuală, ci pentru o stare anterioară. Dar acest lucru ajută să nu scoatem nodul din funcțiune, ceea ce pare foarte logic.
set -eu

if [[ -z "$1" ]]; then
  info "Te rugăm să oferi un keyspace"
  exit 1
fi

KEYSPACE="$1"

result=$(nodetool snapshot "${KEYSPACE}")

if [[ $? -ne 0 ]]; then
  echo "Eroare în timpul realizării snapshot-ului"
  exit 1
fi

timestamp=$(echo "$result" | awk '\/Snapshot directory: \/ { print $3 }')

mkdir -p \/tmp\/backup

for path in $(find "\/var\/lib\/cassandra\/data\/${KEYSPACE}" -name $timestamp); do
  table=$(echo "${path}" | awk -F "[\/ -]" '{print $7}')
  mkdir \/tmp\/backup\/$table
  mv $path \/tmp\/backup\/$table
done


tar -zcf \/tmp\/backup.tar.gz -C \/tmp\/backup .

nodetool clearsnapshot "${KEYSPACE}"
Exemplu de script bash pentru realizarea unei copii de rezervă de pe un nod Cassandra
Soluții gata pregătite pentru Cassandra în Kubernetes
Ce se utilizează acum pentru a desfășura Cassandra în Kubernetes și care dintre acestea se potrivește cel mai bine cerințelor date?
1. Soluții bazate pe StatefulSet sau Helm charts
Folosirea funcțiilor de bază ale StatefulSets pentru a lansa un cluster Cassandra este o opțiune bună. Prin utilizarea unui chart Helm și a șabloanelor Go, se poate oferi utilizatorului o interfață flexibilă pentru desfășurarea Cassandra.
De obicei, funcționează bine… până când se întâmplă ceva neprevăzut - de exemplu, defectarea unui nod. Instrumentele standard Kubernetes pur și simplu nu pot ține cont de toate caracteristicile descrise mai sus. În plus, această abordare este foarte limitată în ceea ce privește extinderea pentru utilizări mai complexe: înlocuirea nodurilor, backup-uri, restaurări, monitorizare etc.
Reprezentanți:
- ;
- .
Ambele charts sunt la fel de bune, dar sunt supuse problemelor menționate mai sus.
2. Soluții bazate pe Kubernetes Operator
Aceste opțiuni sunt mai interesante deoarece oferă posibilități extinse de gestionare a clusterului. Pentru proiectarea operatorului Cassandra, la fel ca pentru orice altă bază de date, un model bun arată ca Sidecar Controller CRD:
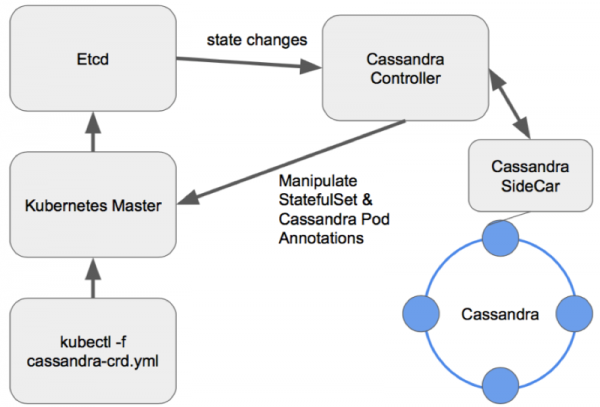
Schema de gestionare a nodurilor într-un operator Cassandra bine proiectat
Să analizăm operatorii existenți.
1. Cassandra-operator de la instaclustr
- Stare: Alpha
- Licență: Apache 2.0
- Realizat în: Java
Acesta este, într-adevăr, un proiect foarte promițător și în continuă dezvoltare de la o companie care oferă desfășurări Cassandra gestionate. Folosește un container sidecar, care primește comenzi prin HTTP. Este scris în Java, așa că, uneori, îi lipsește funcționalitatea mai avansată a bibliotecii client-go. De asemenea, operatorul nu susține diverse rack-uri pentru un singur Data Center.
Pe de altă parte, operatorul are avantaje precum suportul pentru monitorizare, managementul de nivel înalt al cluster-ului prin CRD și chiar documentație pentru realizarea de backup-uri.
2. Navigator de la Jetstack
- Stare: Alpha
- Licență: Apache 2.0
- Realizat în: Golang
Un operator destinat desfășurării DB-as-a-Service. În prezent, suportă două baze de date: Elasticsearch și Cassandra. Are soluții interesante, cum ar fi controlul accesului la baza de date prin RBAC (pentru acest lucru se ridică un navigator-apiserver separat). Este un proiect interesant, la care merită să ne uităm, totuși, ultimul commit a fost făcut cu un an și jumătate în urmă, ceea ce îi reduce clar potențialul.
3. Cassandra-operator de la vgkowski
- Stare: Alpha
- Licență: Apache 2.0
- Realizat în: Golang
Nu s-a luat în serios, deoarece ultimul commit în repository a fost acum mai bine de un an. dezvoltarea operatorului a fost abandonată: ultima versiune Kubernetes, declarat ca fiind susținută, este 1.9.
4. Cassandra-operator de la Rook
- Stare: Alpha
- Licență: Apache 2.0
- Realizat în: Golang
Un operator, al cărui dezvoltare nu decurge atât de repede pe cât ne-am dori. Are o structură CRD bine gândită pentru gestionarea cluster-ului, rezolvă problema identificării nodurilor cu ajutorul Serviciului cu ClusterIP (același «hack»)… dar până acum asta este tot. Monitorizarea și backup-urile nu sunt incluse în mod standard (de altfel, pentru monitorizare ne-am ). Un aspect interesant este că, cu ajutorul acestui operator, se poate desfășura și ScyllaDB.
NB: Acest operator, cu mici modificări, a fost utilizat într-unul dintre proiectele noastre. Nu au fost observate probleme în funcționarea operatorului pe întreaga durată de utilizare (~4 luni de lucru).
5. CassKop de la Orange
- Stare: Alpha
- Licență: Apache 2.0
- Realizat în: Golang
Cel mai tânăr operator din listă: prima commit a fost realizată pe 23 mai 2019. Deja are în arsenalul său un număr mare de funcționalități din lista noastră, cu care vă puteți familiariza în depozitul proiectului. Operatorul este construit pe baza popularului operator-sdk. Suportă monitorizarea "din cutie". Principala diferență față de alți operatori este utilizarea , realizat în Python și utilizat pentru comunicarea între nodurile Cassandra.
Conclusions
Numărul de abordări și opțiuni posibile pentru migrarea Cassandra în Kubernetes vorbește de la sine: subiectul este solicitat.
În acest stadiu, încercarea unor soluții menționate mai sus se face pe propriul risc: niciunul dintre dezvoltatori nu garantează funcționarea 100%-ă a soluțiilor sale în mediu de producție. Dar deja, multe produse arată promițător pentru a fi utilizate în standuri pentru dezvoltare.
Cred că, în viitor, această femeie de pe navă va fi binevenită!
P.S.
Citiți și în blogul nostru:
- «»;
- «»;
- «»;
- «».
Sursa: habr.com
