

Inspirat din prezentările mele de la Highload++ și DataFest Minsk 2019.
Pentru mulți, astăzi, emailul reprezintă o parte esențială a vieții online. Prin intermediul acestuia, purtăm corespondență de afaceri, stocăm o varietate de informații importante legate de finanțe, rezervări de hoteluri, plasarea comenzilor și multe altele. La mijlocul anului 2018, am formulat o strategie de produs pentru dezvoltarea serviciului de email. Cum ar trebui să arate emailul modern?
Emailul trebuie să fie inteligent, adică să ajute utilizatorii să se descurce în volumul tot mai mare de informații: să filtreze, să structureze și să ofere aceste informații într-un mod cât mai convenabil. De asemenea, acesta trebuie să fie utilă, permițându-le utilizatorilor să rezolve diverse taskuri direct din inbox, cum ar fi plata amenzilor (o funcție pe care, din păcate, o folosesc). Și, firește, emailul trebuie să asigure protecția informațiilor, blocând spamul și apărând utilizatorii de atacurile cibernetice, adică să fie sigur.
Aceste direcții definesc o serie de sarcini cheie, multe dintre care pot fi rezolvate eficient cu ajutorul învățării automate. Iată exemple de caracteristici deja implementate, dezvoltate în cadrul strategiei—câte una pentru fiecare direcție.
- Răspuns inteligent. În email există o funcție de răspuns inteligent. Rețeaua neuronală analizează textul emailului, înțelege sensul și scopul acestuia și, ca urmare, propune trei variante cele mai potrivite de răspuns: pozitiv, negativ și neutră. Acest lucru ajută la economisirea semnificativă a timpului în răspunsurile la emailuri și, de asemenea, permite uneori să răspundem în moduri neobișnuite și amuzante.
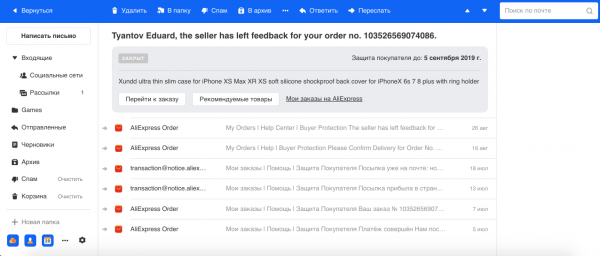
- Gruparea emailurilor, referitoare la comenzile efectuate în magazinele online. Facem adesea cumpărături pe internet și, de regulă, magazinele pot trimite câteva emailuri pentru fiecare comandă. De exemplu, de la AliExpress, cel mai mare serviciu, vin foarte multe emailuri pentru o singură comandă, iar noi am estimat că, în cazuri extreme, numărul acestora poate ajunge până la 29. Prin urmare, cu ajutorul modelului Named Entity Recognition, extragem numărul comenzii și alte informații din text și grupăm toate emailurile într-un singur fir. De asemenea, afișăm informațiile principale despre comandă într-un panou separat, ceea ce facilitează gestionarea acestui tip de emailuri.

- Anti-phishingPhishingul este un tip de fraudă extrem de periculos prin care infractorii încearcă să obțină informații financiare (inclusiv detalii despre cardurile bancare ale utilizatorilor) și identificatori. Aceste mesaje mimează aspectul celor originale, trimise de servicii, inclusiv vizual. Prin urmare, folosind Computer Vision, recunoaștem siglele și stilul de design al e-mailurilor de la mari companii (de exemplu, Mail.ru, Sber, Alfa) și luăm în considerare aceste aspecte împreună cu textul și alte semne în clasificatoarele noastre de spam și phishing.
Învățarea automată
Un pic despre învățarea automată în e-mailuri în general. E-mailul este un sistem cu încărcare ridicată: prin serverele noastre trec în medie 1,5 miliarde de mesaje pe zi pentru 30 de milioane de utilizatori DAU. Aproape 30 de sisteme de învățare automată îndeplinesc toate funcțiile și caracteristicile necesare.
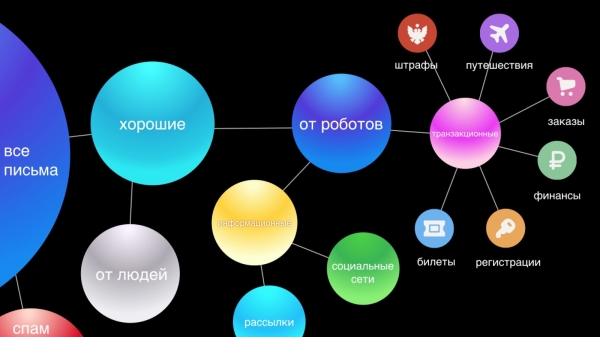
Fiecare e-mail trece printr-un întreg conveior de clasificare. Mai întâi, filtrăm spamul și păstrăm e-mailurile bune. Utilizatorii adesea nu observă activitatea antispam, deoarece 95—99% din spam nu ajunge chiar și în folderul corespunzător. Recunoașterea spamului este o parte foarte importantă a sistemului nostru și cea mai complexă, deoarece în domeniul antispamului se desfășoară o adaptare constantă între sistemele de protecție și atac, ceea ce prezintă o provocare ingineresască continuă pentru echipa noastră.
Apoi, separăm e-mailurile trimise de oameni de cele trimise de roboți. E-mailurile de la oameni sunt cele mai importante, de aceea le oferim funcții de tip Smart Reply. E-mailurile de la roboți se împart în două categorii: tranzacționale — acestea sunt mesaje importante de la servicii, cum ar fi confirmările achizițiilor sau rezervărilor de hotel, și informaționale — acestea sunt publicitate de afaceri, reduceri.
Considerăm că informațiile tranzacționale sunt la fel de importante ca corespondența personală. Ele trebuie să fie la îndemână, deoarece este adesea necesar să găsim rapid informații despre o comandă sau o rezervare de bilet de avion, iar noi pierdem timp cu căutarea acestor mesaje. De aceea, pentru comoditate, le împărțim automat în șase categorii principale: călătorii, comenzi, finanțe, bilete, înregistrări și, în sfârșit, amenzi.
Scrisorile informative sunt cel mai numeros și, probabil, cel mai puțin important grup, care nu necesită o reacție imediată, deoarece nimic semnificativ nu se va schimba în viața utilizatorului dacă acesta nu citește o astfel de scrisoare. În noul nostru interval de vizualizare, le grupăm în două threaduri: rețele sociale și newslettere, curățând astfel vizual căsuța poștală și lăsând la vedere doar scrisorile importante.
Exploatare
Un număr mare de sisteme aduce multe dificultăți în exploatare. Modelele se degradează în timp, la fel ca orice software: semnalele se strică, mașinile se defectează, codul devine confuz. În plus, datele se schimbă constant: se adaugă altele noi, se transformă tiparele comportamental ale utilizatorilor etc., astfel încât modelul, fără o susținere adecvată, va funcționa din ce în ce mai prost în timp.
Nu trebuie uitat că, cu cât învățarea automată pătrunde mai adânc în viața utilizatorilor, cu atât influența lor asupra ecosistemului devine mai mare, și, ca urmare, pierderile financiare sau profiturile pe care le pot obține jucătorii de pe piață pot fi semnificative. De aceea, din ce în ce mai multe domenii, actorii se adaptează la lucrul cu algoritmi ML (exemple clasice: publicitate, căutare și deja menționatul antispam).
De asemenea, sarcinile de învățare automată au o particularitate: orice modificare, chiar și una nesemnificativă, în sistem poate genera multă muncă cu modelul: lucrul cu datele, reînvățarea, implementarea, ceea ce poate dura săptămâni sau luni. Prin urmare, cu cât mediu se schimbă mai repede, cu atât mai multe eforturi sunt necesare pentru susținerea acestora. Echipa poate crea numeroase sisteme și se poate bucura de acest lucru, iar apoi să cheltuie aproape toate resursele pentru susținerea lor, fără posibilitatea de a face ceva nou. Ne-am confruntat o dată cu o astfel de situație în echipa de antispam. Și am ajuns la concluzia evidentă că suportul trebuie automatizat.
Automatizarea
Ce poate fi automatizat? De fapt, aproape totul. Am identificat patru direcții care definesc infrastructura învățării automate:
- colectarea datelor;
- reînvățarea;
- implementarea;
- testarea & monitorizarea.
Dacă mediul este instabil și se schimbă constant, atunci întreaga infrastructură din jurul modelului devine mult mai importantă decât modelul în sine. Poate fi un vechi și bun clasificador liniar, dar dacă îi oferim caracteristici corecte și stabilim un feedback bun de la utilizatori, va funcționa mult mai bine decât modelele de vârf cu toată tehnologia lor.
Ciclul de feedback
Acest ciclu reunește colectarea datelor, reînvățarea și implementarea — practic, întregul ciclu de actualizare a modelului. De ce este important? Uitați-vă la grafica înregistrărilor în e-mail:
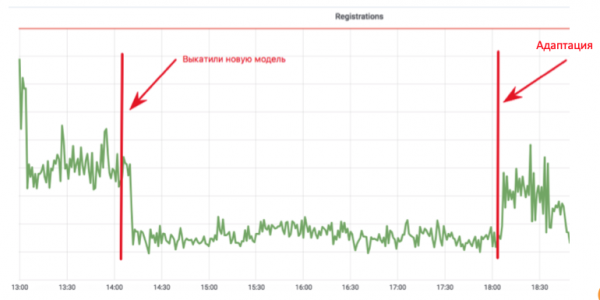
Dezvoltatorul de învățare automată a implementat un model anti-bot care împiedică roboții să se înregistreze în e-mail. Grafica scade până la o valoare la care rămân doar utilizatorii reali. Totul este minunat! Dar după patru ore, cei care creează boturi își ajustează scripturile, iar totul revine la normal. În această implementare, dezvoltatorul a petrecut o lună adăugând caracteristici și reînvățând modelul, dar spammerul a reușit să se adapteze în patru ore.
Pentru a nu suferi atât de mult și a nu fi nevoit să refacem totul, trebuie să ne gândim din timp cum va arăta ciclul de feedback și ce vom face dacă mediul se va schimba. Să începem cu colectarea datelor — aceasta este combustibilul pentru algoritmii noștri.
Colectarea datelor
Este clar că pentru rețele neuronale moderne, cu cât avem mai multe date, cu atât este mai bine, iar acestea, în esență, sunt generate de utilizatorii produsului. Utilizatorii ne pot ajuta să etichetăm datele, dar nu trebuie să abuzăm de asta, deoarece, la un moment dat, utilizatorilor li se va face dor să îmbunătățească modelele noastre și vor trece la un alt produs.
Una dintre cele mai frecvente greșeli (aici fac referire la Andrew Ng) este o orientare prea puternică spre metricele pe setul de date de testare, în loc de feedbackul de la utilizator, ceea ce este, de fapt, principala măsură a calității muncii, deoarece creăm un produs pentru utilizator. Dacă utilizatorului nu îi este clar sau nu-i place modul în care funcționează modelul, înseamnă că totul este inutil.
De aceea, utilizatorul ar trebui să aibă întotdeauna posibilitatea de a vota; trebuie să-i dăm un instrument pentru feedback. Dacă considerăm că în căsuța de e-mail a venit un mesaj legat de finanțe, trebuie să-l etichetăm ca 'finanțe' și să desenează un buton pe care utilizatorul îl poate apăsa și să spună că nu este finanțe.
Calitatea feedbackului
Să discutăm despre calitatea feedback-ului utilizatorului. În primul rând, este posibil ca tu și utilizatorul să conferiți diferite sensuri aceluiași concept. De exemplu, tu și managerii de produs considerați că „finanțele” se referă la scrisori de la bancă, în timp ce utilizatorul crede că o scrisoare de la bunica despre pensie se încadrează, de asemenea, în categoria finanțelor. În al doilea rând, sunt utilizatori care apasă butoanele fără să aibă vreo logică. În al treilea rând, utilizatorul poate avea concluzii complet greșite. Un exemplu clar din practica noastră este implementarea clasificatorului , un tip de spam destul de amuzant, în care utilizatorului i se propune să încaseze câteva milioane de dolari de la un oarecare văr găsit brusc în Africa. După implementarea acestui clasificator, am verificat clicurile pe „Nu este spam” pentru aceste scrisori și s-a dovedit că 80% dintre ele erau spamuri nigeriene evidente, ceea ce sugerează că utilizatorii pot fi extrem de naivi.
Și să nu uităm că butoanele nu sunt apăsate doar de oameni, ci și de diverse bot-uri care se pretind a fi browsere. Așadar, feedback-ul brut nu este adecvat pentru învățare. Ce putem face cu aceste informații?
Aplicăm două abordări:
- Feedback de la ML asociat. De exemplu, avem un sistem online anti-bot care, așa cum am menționat anterior, ia decizii rapide bazate pe un număr limitat de caracteristici. Și există un al doilea sistem, mai lent, care funcționează post-factum. Acesta dispune de mai multe date despre utilizator, despre comportamentul său etc. Ca urmare, se ia cea mai bine fundamentată decizie, reieșind din aceasta având o acuratețe și o completitudine mai mare. Se poate direcționa diferența în funcționarea acestor sisteme ca date pentru învățare în primul. Astfel, sistemul mai simplu va încerca mereu să se apropie de performanța celui mai complex.
- Clasificarea clicurilor. Poate fi simplu să clasifici fiecare clic al utilizatorului, să-i evaluezi validitatea și utilizarea. Așa facem în antispam-ul de e-mail, folosind caracteristicile utilizatorului, istoricul său, caracteristicile expeditorului, textul în sine și rezultatul clasificatoarelor. În final, obținem un sistem automat care validează feedback-ul utilizatorului. Și, deoarece trebuie să fie realimentat mult mai rar, munca sa poate deveni principală pentru toate celelalte sisteme. Principala prioritate în acest model este precizia, deoarece antrenarea modelului cu date inexacte implică riscuri semnificative.
Cât timp curățăm datele și realimentăm sistemele noastre ML, nu trebuie să uităm de utilizatori, deoarece pentru noi, mii, milioane de erori pe grafic reprezintă statistici, iar pentru utilizator, fiecare bug este o tragedie. În plus față de faptul că utilizatorul trebuie să supraviețuiască cu eroarea din produsul vostru, el așteaptă, după feedback, excluderea unei situații similare în viitor. De aceea, este întotdeauna recomandabil să oferi utilizatorilor nu doar posibilitatea de a vota, ci și de a corecta comportamentul sistemelor ML, creând, de exemplu, heuritici personale pentru fiecare clic de feedback; în cazul e-mailului, aceasta ar putea fi capacitatea de a filtra astfel de mesaje în funcție de expeditor și subiect pentru acel utilizator.
De asemenea, trebuie să construim modelul pe baza unor rapoarte sau solicitări în suport, într-un mod semi-automat sau manual, pentru a evita ca alți utilizatori să sufere din cauza unor probleme similare.
Heuritici pentru antrenare
Cu aceste heuristici și soluții temporare există două probleme. Prima este că numărul în continuă creștere de soluții temporare este greu de întreținut, fără a menționa calitatea și funcționarea lor pe termen lung. A doua problemă este că eroarea poate să nu fie frecventă, iar câteva clicuri pentru realimentarea modelului nu vor fi suficiente. Ar părea că aceste două efecte neconectate pot fi semnificativ reduse dacă aplicăm următoarea abordare.
- Creăm o soluție temporară.
- Direcționăm datele din aceasta către model, care se realimentează regulat, inclusiv pe baza datelor obținute. Aici, desigur, este important ca heuristica să aibă o precizie ridicată, pentru a nu reduce calitatea datelor din setul de antrenament.
- Apoi, configurăm monitorizarea pentru declanșarea suportului temporar, și dacă după un timp suportul temporar nu mai este necesar și este complet acoperit de model, atunci îl putem șterge fără ezitare. Acum, această problemă nu ar mai trebui să reapară.
Deci, armata suporturilor temporare este foarte utilă. Principalul lucru este ca serviciul lor să fie urgent, nu permanent.
Reînvățare
Reînvățarea este procesul de adăugare a unor date noi, obținute ca rezultat al feedback-ului de la utilizatori sau alte sistem, și de antrenare a modelului existent pe acestea. Există câteva probleme cu reînvățarea:
- Modelul poate să nu suporte pur și simplu reînvățarea și să poată învăța doar de la zero.
- În cartea naturii nu este scris nicăieri că reînvățarea va îmbunătăți neapărat calitatea funcționării în producție. Deseori se întâmplă chiar opusul, adică poate apărea o deteriorare.
- Schimbările pot fi imprevizibile. Acesta este un punct destul de delicat pe care l-am descoperit. Chiar dacă un model nou în testul A/B arată rezultate similare cu cel actual, acest lucru nu înseamnă deloc că va funcționa identic. Funcționarea lor poate diferi cu un anumit procent, care poate aduce erori noi sau poate readuce erori vechi deja rezolvate. Cu erorile actuale, noi și utilizatorii am învățat deja să trăim, și atunci când apar multe erori noi, utilizatorul poate să nu înțeleagă ce se întâmplă, deoarece se așteaptă la un comportament predictibil.
De aceea, cel mai important în reînvățare este să îmbunătățim garantat modelul sau, cel puțin, să nu-l deteriorăm.
Primul lucru care îmi vine în minte când vorbim despre reînvățare este abordarea Active Learning. Ce înseamnă asta? De exemplu, un clasificator determină dacă un e-mail aparține categoriei financiară, și în jurul limitei sale de decizie adăugăm un eșantion din exemplele etichetate. Acest lucru funcționează bine, de exemplu, în publicitate, unde există foarte mult feedback și se poate antrena modelul în timp real. Dar dacă feedback-ul este puțin, atunci obținem un eșantion foarte părtinitor în raport cu distribuția datelor de producție, pe baza căruia nu se poate evalua comportamentul modelului în procesul de exploatare.
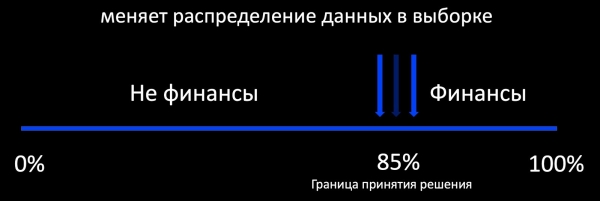
În realitate, scopul nostru este să păstrăm vechile modele, modelele deja cunoscute, și să dobândim altele noi. Aici, continuitatea este importantă. Modelul pe care l-am lansat cu multe dificultăți funcționează deja, așa că ne putem orienta după performanța sa.
În e-mail se aplică diferite modele: arbori, liniare, rețele neuronale. Pentru fiecare creăm propriul algoritm de reînvățare. În procesul de reînvățare, obținem nu doar date noi, ci și adesea noi caracteristici pe care le vom lua în considerare în toate algoritmii de mai jos.
Modele liniare
Să zicem că avem regresie logistică. Formăm funcția de pierdere a modelului din următoarele componente:
- LogLoss pe datele noi;
- regularizăm greutățile noilor caracteristici (nu atingem vechile);
- învățăm și pe datele vechi, pentru a păstra vechile modele;
- și, poate cel mai important: aplicăm Regularizarea Harmonică, care garantează o modificare moderată a greutăților în raport cu modelul vechi din punct de vedere al normei.
Deoarece fiecare componentă a pierderii are coeficienți, putem ajusta valorile optime pentru sarcina noastră pe baza validării încrucișate sau în funcție de cerințele de produs.
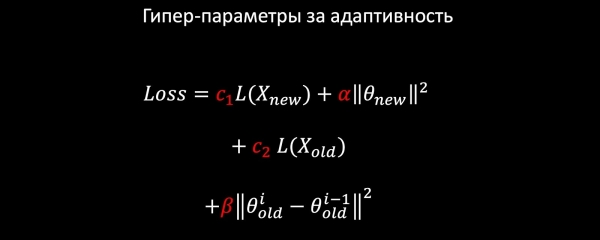
Arbori
Să trecem la arbori de decizie. Am implementat următorul algoritm de reînvățare pentru arbori:
- În producție funcționează o pădure de 100—300 de arbori, care a fost antrenată pe un set de date vechi.
- La final, eliminăm M = 5 arbori și adăugăm 2M = 10 noi, antrenați pe întregul set de date, dar cu un coeficient ridicat pentru datele noi, ceea ce garantează în mod natural o modificare incrementală a modelului.
Este evident că, de-a lungul timpului, numărul arborilor crește semnificativ, iar aceștia trebuie periodic reduceri pentru a ne menține în limitele temporale. Pentru aceasta, folosim acum bine-cunoscuta Distilare a Cunoștințelor (KD). Pe scurt, despre principiul de funcționare.
- Avem modelul „complex” curent. Îl rulăm pe setul de date de antrenament și obținem distribuția probabilităților pentru clase la ieșire.
- Apoi, antrenăm modelul elev (un model cu un număr mai mic de arbori în acest caz) să reproducă rezultatele modelului, folosind distribuția claselor ca variabilă țintă.
- Este important de menționat că nu folosim deloc eticheta dataset-ului, așa că putem folosi date arbitrare. Bineînțeles, utilizăm un eșantion de date din fluxul de producție ca set de antrenament pentru modelul elev. Astfel, setul de antrenament ne permite să asigurăm exactitatea modelului, iar eșantionul din flux garantează o performanță similară în distribuția de producție, compensând devierea setului de antrenament.
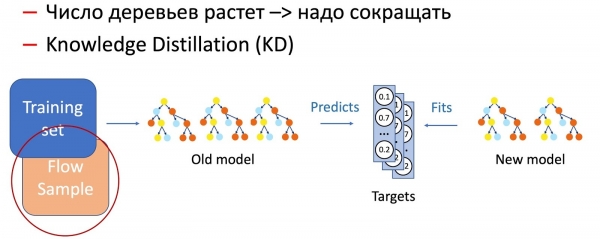
Combinarea acestor două tehnici (adăugarea de copaci și reducerea periodică a acestora prin Knowledge Distillation) asigură introducerea de noi modele și continuitate completă.
Prin KD, realizăm de asemenea distincția operațiunilor cu caracteristici ale modelului, cum ar fi eliminarea caracteristicilor și operarea cu absențe. În cazul nostru, avem o serie de caracteristici statistice importante (pe baza expeditorilor, hash-urilor de text, URL-urilor etc.), care sunt stocate într-o bază de date cu proprietatea de a refuza. La o astfel de desfășurare a evenimentelor, modelul nu este pregătit, deoarece în setul de antrenament nu apar situații de refuz. În astfel de cazuri, combinăm tehnicile KD și augmentarea: pentru antrenamentul unui subset de date, eliminăm sau resetăm caracteristicile necesare, iar etichetele (ieșirile modelului curent) rămân inițiale, modelul elev învață să reproducă această distribuție.
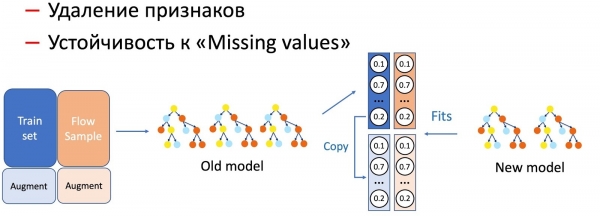
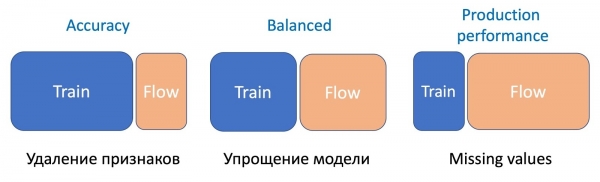
Am observat că cu cât manipularea modelelor este mai serioasă, cu atât mai mult este necesar un eșantion din flux ca proporție procentuală.
Pentru a elimina caracteristicile, cea mai simplă operațiune, este necesară doar o mică parte din flux, deoarece se schimbă doar câteva caracteristici, iar modelul curent a fost antrenat pe același set - diferența este minimă. Pentru simplificarea modelului (reducerea numărului de copaci de câteva ori) este necesar deja un raport de 50 la 50. Iar pentru absențele caracteristicilor statistice importante, care influențează serios performanța modelului, este necesar și mai mult flux pentru a uniformiza funcționarea noului model rezistent la absențe pe toate tipurile de e-mailuri.
FastText
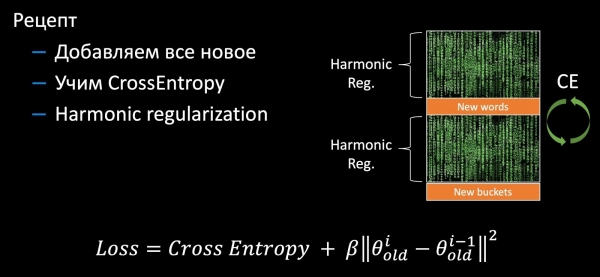
Să trecem la FastText. Amintesc că reprezentarea (Embedding) unui cuvânt constă din suma embedding-ului cuvântului în sine și a tuturor N-gram-urilor sale literale, de obicei trigramuri. Deoarece pot exista multe trigramuri, se folosește Bucket Hashing, adică transformarea întregului spațiu într-un harta hash fixă. În rezultat, matricea greutăților iese cu dimensiunea straturilor interne în funcție de numărul de cuvinte + bucket-uri.
În timpul antrenamentului suplimentar apar noi caracteristici: cuvinte și trigramuri. În antrenamentul standard suplimentar de la Facebook nu se întâmplă nimic semnificativ. Numai greutățile vechi sunt ajustate cu entropia încrucișată pe date noi. Astfel, noile caracteristici nu sunt folosite, desigur, această abordare are toate dezavantajele menționate anterior legate de imprevizibilitatea modelului în producție. Prin urmare, am făcut câteva ajustări la FastText. Adăugăm toate greutățile noi (cuvinte și trigramuri), antrenăm întreaga matrice cu entropia încrucișată și adăugăm regularizare armonică, similar cu modelul liniar, care garantează o modificare nesemnificativă a greutăților vechi.
CNN
Cu rețelele convoluționale este puțin mai complicat. Dacă în CNN se antrenează ultimele straturi, atunci, desigur, se poate aplica regularizarea armonică și se poate garanta continuitatea. Dar în cazul în care este necesară antrenarea întregii rețele, atunci o astfel de regularizare nu poate fi aplicată pe toate straturile. Totuși, există o opțiune de a învăța embedding-uri complementare prin Triplet Loss ().
Triplet Loss
Pe exemplul sarcinii de anti-phishing vom analiza în linii mari Triplet Loss. Luăm logo-ul nostru și exemple pozitive și negative de logo-uri ale altor companii. Minimalizăm distanța dintre primele și maximizăm distanța dintre celelalte, făcând acest lucru cu un mic interval pentru a asigura o compactitate mai mare a claselor.
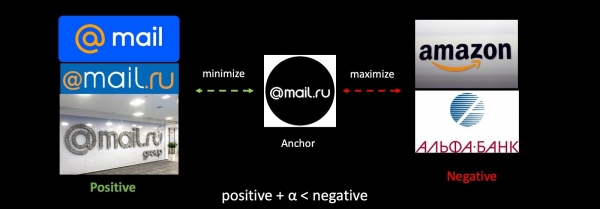
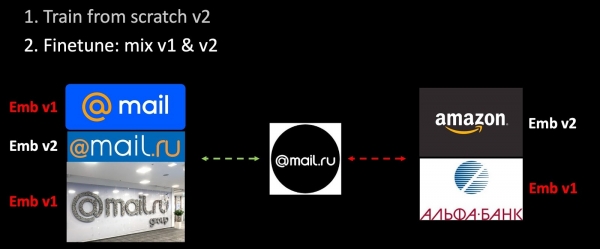
Dacă antrenăm rețeaua, atunci ne schimbă complet spațiul metric, iar acesta devine complet incompatibil cu cel anterior. Aceasta este o problemă serioasă în sarcinile care utilizează vectori. Pentru a o ocoli, vom amesteca în timpul antrenamentului embedding-uri vechi.
Am adăugat date noi în setul de antrenament și instruim de la zero a doua versiune a modelului. În a doua etapă, ne continuăm antrenarea rețelei (Finetuning): mai întâi se antrenează ultimul strat, apoi se decongelează întreaga rețea. În procesul de generare a tripletelor, doar o parte din embedding-uri sunt calculate folosind modelul antrenat, restul fiind obținute cu ajutorul celui vechi. În acest fel, în timpul antrenării suplimentare, asigurăm compatibilitatea spațiilor metrice v1 și v2. O variantă unică de regularizare armonică.
Arhitectura integrală
Dacă analizăm întreaga sistemă folosind exemplul anti-spamului, modelele nu sunt izolate, ci integrate una în alta. Luăm imagini, text și alte semne, obținem embedding-uri folosind CNN și Fast Text. Apoi, deasupra embedding-urilor se aplică clasificatoare care oferă scoruri pentru diferite clase (tipuri de mesaje, spam, prezența logo-ului). Scorurile și semnalele ajung într-o pădure de copaci pentru a lua decizia finală. Clasificatoarele separate din această schemă permit o interpretare mai bună a rezultatelor sistemului și o ajustare mai precisă a componentelor în cazul apariției problemelor, mai degrabă decât a furniza toate datele brute în copacii deciziilor.
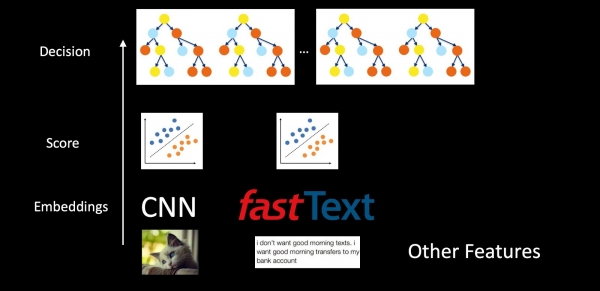
În final, garantăm continuitatea la fiecare nivel. La nivelul de bază în CNN și Fast Text folosim regularizare armonică, iar pentru clasificatoarele de mijloc - de asemenea, regularizare armonică și calibrarea scorului pentru compatibilitatea distribuției probabilităților. În plus, boostingul copacilor se antrenează incremental sau folosind Knowledge Distillation.
În general, suportarea unui astfel de sistem integrat de învățare automată este adesea problematică, deoarece orice componentă de la nivelul inferior duce la actualizarea întregului sistem de la niveluri superioare. Însă, deoarece în setup-ul nostru fiecare componentă se schimbă nesemnificativ și este compatibilă cu cea anterioară, întregul sistem poate fi actualizat pe bucăți fără a necesita reantrenarea întregii structuri, ceea ce permite menținerea acestuia fără un overhead semnificativ.
Deploy
Am discutat despre colectarea datelor și antrenarea diferitelor tipuri de modele, așa că trecem la implementarea lor în mediu de producție.
A/B-testare
Așa cum am menționat anterior, în procesul de colectare a datelor, de obicei, obținem un eșantion distorsionat, pe baza căruia nu putem evalua performanța modelului în producție. Prin urmare, la implementare, este esențial să comparăm modelul cu versiunea anterioară, pentru a înțelege cum stau lucrurile de fapt, adică să realizăm teste A/B. De fapt, procesul de lansare și analiza graficelor este destul de rutină și se pretează foarte bine la automatizare. Lansează modelele noastre gradual, pe 5 %, 30 %, 50 % și 100 % din utilizatori, în timp ce colectăm toate metriile disponibile despre răspunsurile modelului și feedback-ul utilizatorilor. În caz de abateri semnificative, revenim automat la model, iar pentru celelalte cazuri, odată ce acumulăm un număr suficient de clicuri din partea utilizatorilor, luăm o decizie cu privire la creșterea procentului. În final, ajungem să lansăm noul model la 50 % din utilizatori complet automat, iar aprobarea lansării pentru întreaga audiență este realizată de o persoană, deși și acest pas poate fi automatizat.
Cu toate acestea, procesul de teste A/B oferă oportunități pentru optimizare. Problema este că orice test A/B durează destul de mult (în cazul nostru, între 6 și 24 de ore, în funcție de cantitatea de feedback), ceea ce îl face destul de costisitor și cu resurse limitate. În plus, este necesar un procent suficient de mare de flux pentru test, pentru a accelera în esență timpul total al testului A/B (a acumula un eșantion statistic semnificativ pentru evaluarea metricilor la un procent mic poate dura foarte mult), ceea ce face ca numărul de sloturi A/B să fie extrem de limitat. Este evident că trebuie să scoatem la test doar cele mai promițătoare modele, de care avem destul de multe în procesul de antrenare suplimentară.
Pentru a aborda această problemă, am instruit un clasificator separat care prezice succesul testului A/B. În acest scop, luăm ca trăsături statistica deciziilor, Precision, Recall și alte metrici pe setul de antrenament, pe setul de validare și pe eșantionul din flux. De asemenea, comparăm modelul cu cel actual în producție, cu euristicile, și luăm în considerare complexitatea (Complexity) modelului. Folosind toate aceste trăsături, clasificatorul instruit pe istoricul testelor evaluează modelele-candidată, în cazul nostru fiind vorba de păduri de arbori, și ia o decizie cu privire la care dintre ele să fie inclus în testul A/B.
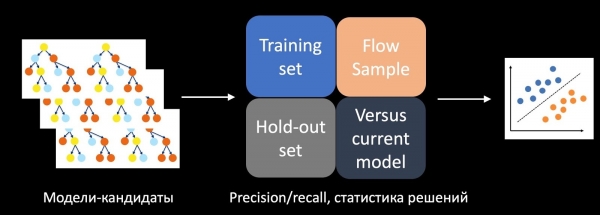
La momentul implementării, această abordare a permis creșterea de câteva ori a numărului de teste A/B reușite.
Testare & monitorizare
Testarea și monitorizarea, surprinzător, nu dăunează sănătății noastre, ci, dimpotrivă, îmbunătățesc și ne scapă de stresuri inutile. Testarea permite prevenirea defecțiunilor, iar monitorizarea – identificarea acestora la timp pentru a reduce impactul asupra utilizatorilor.
Aici este important să înțelegem că, mai devreme sau mai târziu, sistemul vostru va face întotdeauna greșeli – aceasta este legată de ciclul de dezvoltare al oricărui software. La începutul dezvoltării sistemului, există întotdeauna multe erori până când totul se stabilește și se finalizează etapa principală a inovațiilor. Dar, cu timpul, entropia își face simțită prezența și apar din nou greșeli – din cauza degradării componentelor din jur și modificării datelor, despre care am vorbit la început.
Aici aș dori să subliniez că orice sistem de învățare automată trebuie considerat din perspectiva profitabilității sale pe toată durata ciclului de viață. Mai jos, graficul ilustrează exemplul funcționării unui sistem de detectare a unui tip rar de spam (linia este aproape de zero pe grafic). Odată, din cauza unei caracteristici cache-uite greșit, a înnebunit. Din păcate, nu a existat monitorizare pentru activarea anormală, iar sistemul a început să salveze mesajele în folderul „spam” în cantități mari la limita luării unei decizii. În ciuda remedierii consecințelor, sistemul a greșit atât de mult încât nu se va amortiza nici măcar în cinci ani. Acesta este un eșec total din perspectiva ciclului de viață al modelului.
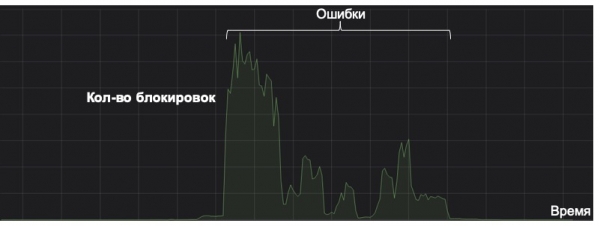
De aceea, o activitate atât de simplă precum monitorizarea poate deveni esențială în viața modelului. Pe lângă metricile standard și evidente, luăm în calcul distribuția răspunsurilor și scorurilor modelului, precum și distribuția valorilor caracteristicilor cheie. Folosind divergența KL, putem compara distribuția actuală cu cea istorică sau valorile din testul A/B cu restul fluxului, ceea ce permite observarea anomaliilor în model și întoarcerea modificărilor la timp.
În cele mai multe cazuri, lansăm primele versiuni ale sistemelor noastre folosind simple heuristici sau modele, pe care în viitor le folosim ca monitorizare. De exemplu, monitorizăm modelul NER în comparație cu regex-urile pentru magazine online specifice, iar dacă acoperirea clasificatorului scade în comparație cu acestea, investigăm cauzele. O altă utilizare utilă a heuristicii!
Concluzii
Să trecem din nou prin ideile cheie ale articolului.
- Fibdæk. Întotdeauna ne gândim la utilizator: cum va trăi el cu greșelile noastre, cum va putea să le raporteze. Nu uităm că utilizatorii nu sunt o sursă de feedback curat pentru antrenarea modelelor și că acesta trebuie curățat cu ajutorul sistemelor ML auxiliare. Dacă nu există posibilitatea de a colecta un semnal de la utilizator, căutăm surse alternative de feedback, de exemplu, sisteme conexe.
- Reînvățare. Aici, esențială este continuitatea, așa că ne bazăm pe modelul actual în producție. Antrenăm noile modele astfel încât să nu se abată prea mult de la precedentul, prin regularizare armonică și trucuri similare.
- Deploy. Autodezvoltarea pe baza metricilor reduce semnificativ timpul de implementare a modelelor. Monitorizarea statisticilor și distribuției deciziilor, numărul de false pozitive din partea utilizatorilor este esențială pentru somnul dumneavoastră liniștit și weekendurile productive.
Ei bine, sper că ceea ce ați citit vă va ajuta să îmbunătățiți mai repede sistemele voastre ML, să le accelerați lansarea pe piață și să le faceți mai fiabile, reducând stresul de la muncă.
Sursa: habr.com
