

În Am discutat despre prognozarea seriei temporale. O continuare logică ar fi un articol despre detectarea anomaliilor.
Aplicare
Detectarea anomaliilor este utilizată în domenii precum:
1) Predicția defectării echipamentului
Astfel, în 2010, centrifugele din Iran au fost atacate de virusul Stuxnet, care a impus un mod de funcționare neoptimizat și a deteriorat o parte din echipament din cauza uzurii accelerate.
Dacă pe echipament s-ar fi folosit algoritmi de căutare a anomaliilor, situațiile de defectare ar fi putut fi evitate.
Căutarea anomaliilor în funcționarea echipamentului nu este utilizată doar în industria nucleară, ci și în metalurgie și în funcționarea turbinelor aviatice. Și în alte domenii unde utilizarea diagnosticării predictive este mai ieftină decât posibilele pierderi cauzate de defectări imprevizibile.
2) Predicția fraudelor
Dacă bani sunt retrăși de pe cardul pe care îl folosești în Podolsk, în Albania, este posibil ca tranzacțiile să merite o verificare suplimentară.
3) Detectarea modelelor de consum anormale
Dacă o parte din clienți demonstrează un comportament anormal, este posibil să existe o problemă despre care nu știi.
4) Detectarea cererii și încărcării anormale
Dacă vânzările dintr-un magazin FMCG au scăzut sub limita intervalului de încredere al prognozei, merită să găsești cauza acestui fenomen.
Aproape de detectarea anomaliilor
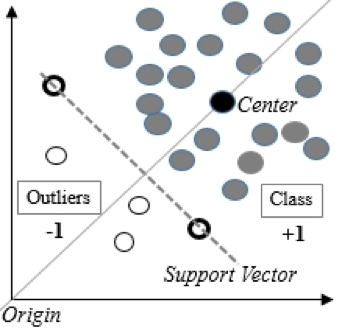
1) Metoda vectorilor de suport cu un singur clasa One-Class SVM
Se potrivește atunci când datele din setul de antrenament se supun unei distribții normale, iar cele din test conțin anomalii.
Metoda cu un singur clasa a vectorilor de suport construiește o suprafață neliniară în jurul originii coordonatelor. Este posibil să se stabilească o limită de tăiere pentru a determina ce date sunt considerate anormale.
Din experiența echipei noastre DATA4, One-Class SVM este cel mai frecvent algoritm utilizat pentru a aborda problema căutării anomaliilor.
2) Metoda pădurii de izolare – isolate forest
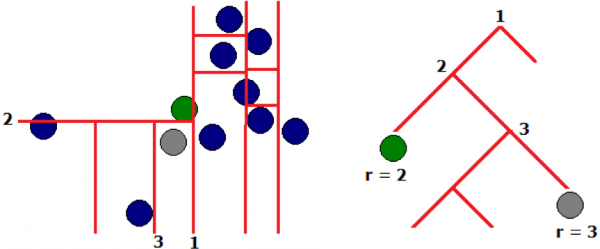
Prin metoda de construcție aleatorie a copacilor, valorile anormale vor ajunge în frunze în etapele inițiale (la o adâncime mică a copacului), adică valorile anormale sunt mai ușor de „izolat”. Evidențierea valorilor anormale se face în primele iterații ale funcționării algoritmului.
3) Învelișul eliptic și metodele statistice
Este utilizat atunci când datele sunt distribuite normal. Cu cât o măsurare este mai aproape de coada mixturii de distribuții, cu atât valoarea este mai anormală.
Această clasă include și alte metode statistice.
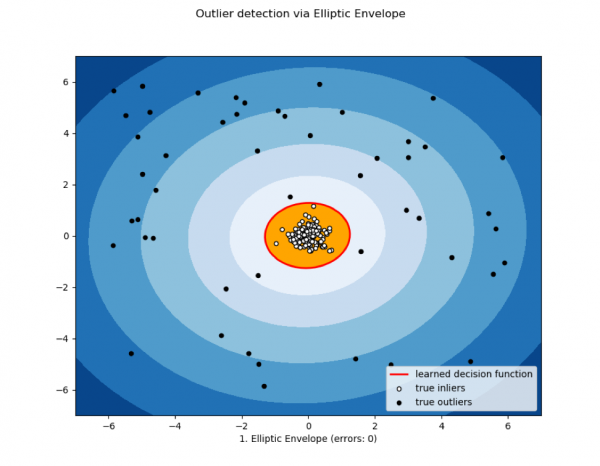
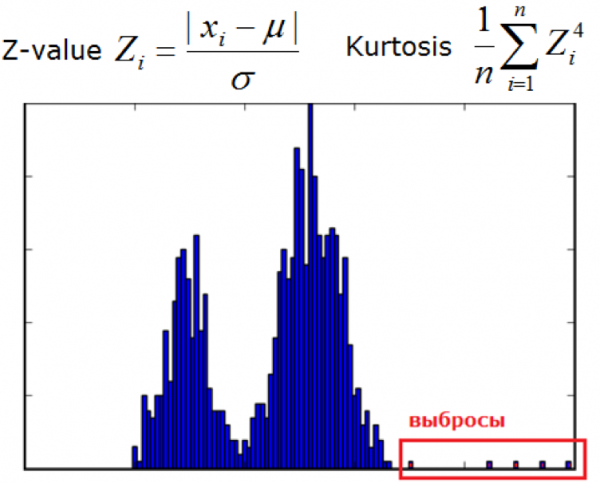
Imagine de pe site-ul dyakonov.org
4) Metodele metrice
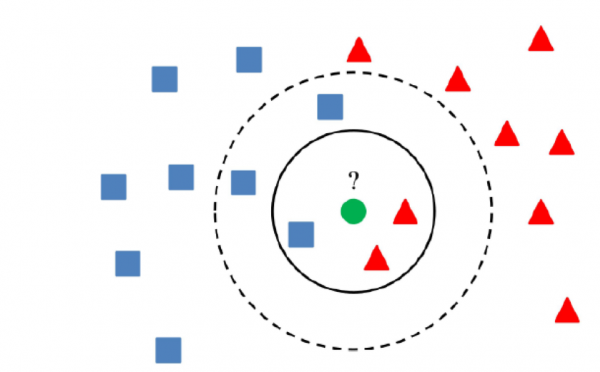
Printre metode se numără algoritmii, cum ar fi k-nearest neighbors, k-vecinul cel mai apropiat, ABOD (detectarea anomaliilor bazată pe unghi) sau LOF (factorul de anomalii local).
Acestea sunt potrivite dacă distanța dintre valorile caracteristicilor este egală sau normalizată (pentru a nu măsura șarpele în papagali).
Algoritmul k-nearest neighbors presupune că valorile normale sunt situate într-o anumită zonă a spațiului multidimensional, iar distanța față de anomalii va fi mai mare decât față de hiperplanul de separare.
5) Metodele de clustering
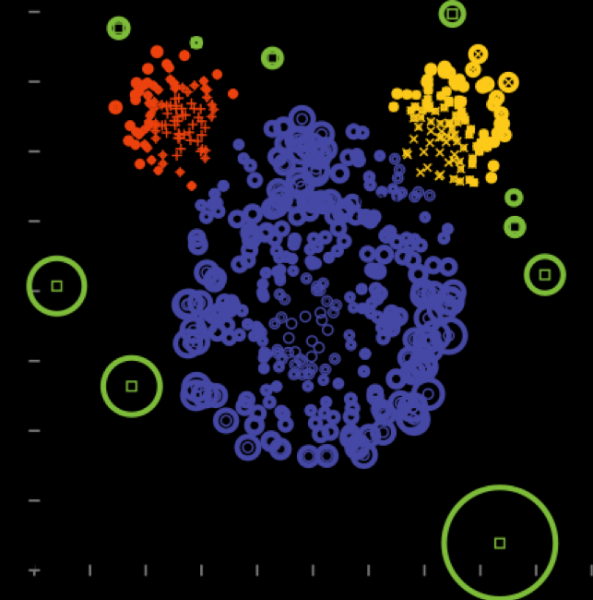
Esenta metodelor de clustering este că dacă o valoare este îndepărtată de centrele cluster-elor cu mai mult decât o anumită mărime, valoarea poate fi considerată anormală.
Principalul lucru este să folosești un algoritm care clusterizează corect datele, ceea ce depinde de sarcina specifică.
6) Metoda componentelor principale
Este potrivită acolo unde se evidențiază direcțiile de cea mai mare schimbare a dispersiei.
7) Algoritmi bazati pe prognozarea seriilor temporale
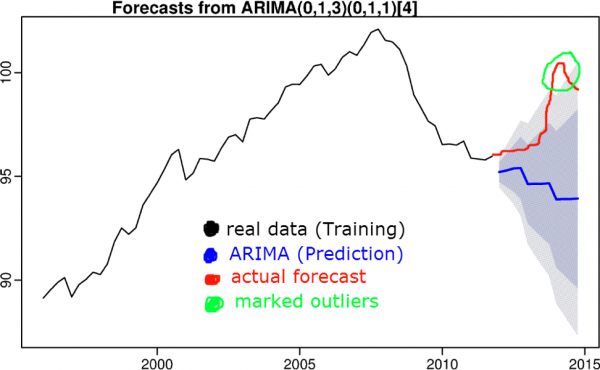
Ideea este că dacă o valoare deviază din intervalul de încredere al prognozei, valoarea este considerată anormală. Pentru prognozarea seriilor temporale se folosesc algoritmi precum netezirea triplă, S(ARIMA), boosting etc.
Despre algoritmii de prognozare a seriilor temporale s-a vorbit în articolul precedent.
8) Învățare supravegheată (regresie, clasificare)
Dacă datele permit, folosim algoritmi de la regresia liniară la rețele neuronale recurente. Vom măsura diferența dintre prognoză și valoarea reală și vom trasa concluzia despre cât de mult datele deviază de la normal. Este important ca algoritmul să aibă o capacitate de generalizare suficientă și ca setul de antrenament să nu conțină valori anormale.
9) Teste de model
Vom aborda problema identificării anomaliilor ca pe o problemă de generare de recomandări. Vom descompune matricea noastră de caracteristici folosind SVD sau mașini de factorizare și valorile din noua matrice, care se abate semnificativ de la cele originale, le vom considera anormale.
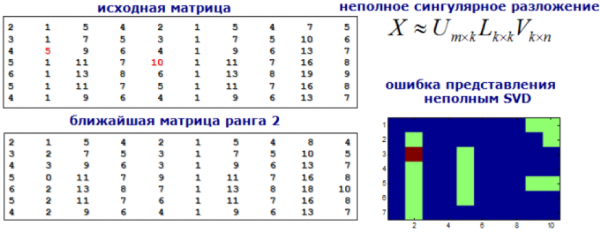
Imagine de pe site-ul dyakonov.org
Concluzie
În acest articol am analizat principalele abordări pentru detectarea anomaliilor.
Căutarea anomaliilor poate fi considerată, într-o mare măsură, o artă. Nu există un algoritm sau o metodă perfectă care să rezolve toate problemele. De regulă, se folosește un set de metode pentru a aborda un caz specific. Căutarea anomaliilor se realizează prin intermediul metodei SVM (Support Vector Machine), pădurilor izolate, metode metrice și de clustering, precum și prin utilizarea componentelor principale și predicția seriilor temporale.
Dacă știți alte metode, scrieți despre ele în comentarii la articol.
Sursa: habr.com
