

Povestea
Avem automate de vânzare dezvoltate intern. În interior se află un Raspberry Pi și puțin hardware pe o placă separată. Sunt conectate un acceptor de monede, un acceptor de bancnote, un terminal bancar... Totul este gestionat de un program personalizat. Întreaga istorie a funcționării este scrisă într-un jurnal pe un stick USB (MicroSD), care apoi este transmis prin internet (cu ajutorul unui modem USB) pe server, unde este stocată într-o bază de date. Informațiile despre vânzări sunt încărcate în 1c, existând de asemenea o interfață web simplă pentru monitorizare etc.
Așadar, jurnalul este absolut necesar — pentru contabilitate (acolo sunt veniturile, vânzările etc.), monitorizare (diverse erori și alte forțe majore); aceasta este, poate, toată informația pe care o avem despre acest automat.
Problema
Sticlele USB se dovedesc a fi dispozitive foarte nesigure. Ele se defectează cu o regularitate envidiată. Acest lucru duce atât la oprirea automatelor, cât și (dacă din diverse motive jurnalul nu a putut fi transmis online) la pierderi de date.
Aceasta nu este prima experiență cu stick-uri USB, înainte am avut un alt proiect cu mai mult de o sută de dispozitive, unde jurnalul era stocat pe stick-uri USB, acolo au fost și probleme de fiabilitate, uneori numărul celor defecte pe lună se ridica la zeci. Am încercat diferite stick-uri, inclusiv branduri cu memorie SLC, da, unele modele sunt mai fiabile decât altele, dar înlocuirea stick-urilor nu a rezolvat problema în mod radical.
Atenție! Longread! Dacă nu te interesează «de ce», ci doar «cum», poți merge direct articolului.
Soluție
Primul lucru care îmi vine în minte: să renunț la MicroSD, să pun, de exemplu, un SSD, și să încarc de pe acesta. Teoretic este posibil, probabil, dar relativ scump și nu atât de fiabil (se adaugă un adaptor USB-SATA; statisticile de eșec pentru SSD-urile bugetare nu sunt îmbucurătoare).
Un HDD USB de asemenea nu pare o soluție prea atractivă.
Așadar, am ajuns la această variantă: să păstrăm încărcarea de pe MicroSD, dar să le folosim în modul read-only, iar jurnalul de funcționare (și alte informații unice ale dispozitivului — numărul de serie, calibrarea senzorilor etc.) să le stocăm undeva în altă parte.
Tema sistemelor de fișiere read-only pentru Raspberry Pi a fost deja studiată pe de-a întregul, nu voi detalia implementarea în acest articol (dar dacă va exista interes — poate voi scrie un articol scurt pe această temă). Un singur lucru pe care vreau să-l menționez: atât din experiența personală, cât și din recenziile celor care deja au implementat, există o câștigare în fiabilitate. Da, imposibilitatea de a elimina complet defectele este reală, însă reducerea semnificativă a frecvenței acestora – este pe deplin realizabilă. De asemenea, cardurile devin standardizate, ceea ce simplifică considerabil înlocuirea pentru personalul de întreținere.
Partea hardware
Nu au fost îndoieli legate de alegerea tipului de memorie – NOR Flash.
Argumente:
- conexiune simplă (cel mai adesea magistrala SPI, o experiență de utilizare a acesteia existând, astfel că nu se prevăd probleme „hardware”);
- preț amuzant;
- protocol standard de funcționare (implementarea este deja în kernelul Linux, dacă se dorește, se pot lua soluții externe, care există și ele, sau chiar se poate scrie una personalizată, bineînțeles că este simplu);
- fiabilitate și durabilitate:
dintr-o fișă tehnică tipică: datele sunt stocate timp de 20 de ani, 100000 de cicluri de ștergere pentru fiecare bloc;
din surse externe: BER extrem de scăzut, se postulează lipsa necesității codurilor de corecție a erorilor (în unele lucrări se discută despre ECC pentru NOR, dar de obicei acolo se referă la MLC NOR, există și așa ceva).
Să estimăm cerințele legate de capacitate și resursă.
Vreau ca datele să fie salvate garantat timp de câteva zile. Aceasta este necesară pentru ca, în caz de probleme de conectivitate, istoricul vânzărilor să nu fie pierdut. Ne vom baza pe 5 zile, în acest interval (chiar și luând în considerare weekendurile și sărbătorile) se poate rezolva problema.
În prezent, pe parcursul unei zile se acumulează aproximativ 100 KB de jurnale (3-4 mii de înregistrări), dar treptat acest număr crește – se detaliază, se adaugă noi evenimente. În plus, uneori apar vârfuri (de exemplu, un senzor începe să trimită alarme false). Vom calcula pe baza a 10 mii de înregistrări de 100 de biți – un megabit pe zi.
Deci avem 5 MB de date pure (care pot fi comprimate bine). La acestea se mai adaugă (estimare grosieră) 1 MB de date de servicii.
Asta înseamnă că avem nevoie de un circuit integrat de 8 MB dacă nu utilizăm compresia, sau 4 MB dacă o utilizăm. Cifre perfect realiste pentru acest tip de memorie.
Cât despre resurse: dacă planificăm că memoria va fi rescrisă complet nu mai des de o dată la 5 zile, atunci pe o durată de 10 ani de funcționare vom obține mai puțin de o mie de cicluri de rescriere.
Reamintesc că producătorul promite o sută de mii.
Câteva cuvinte despre NOR vs NAND
Astăzi, desigur, memoria NAND este mult mai populară, însă pentru acest proiect nu aș recomanda utilizarea ei: NAND, spre deosebire de NOR, necesită în mod obligatoriu utilizarea codurilor de corecție a erorilor, tabele de blocuri defecte etc., iar pinii microcipurilor NAND sunt de obicei mult mai numeroși.
Printre dezavantajele NOR se pot menționa:
- capacitate mică (și, prin urmare, preț ridicat pe megabyte);
- viteza de transfer redusă (în mare parte din cauza interfeței secvențiale, de obicei SPI sau I2C);
- ștergere lentă (în funcție de dimensiunea blocului, durează între fracțiuni de secundă și câteva secunde).
Nu pare nimic critic pentru noi, așa că continuăm.
Dacă sunteți interesat de detalii, a fost ales microcipul (totuși, acest aspect nu este crucial, pe piață există o mulțime de analogi, compatibili cu pinout-ul și sistemul de comenzi; chiar dacă vom dori să instalăm un microcip de la un alt producător și/sau cu o altă capacitate, totul va funcționa fără a modifica codul).
Folosesc driverul încorporat în nucleul Linux, iar pe Raspberry, datorită suportului pentru overlay-uri de arbore de dispozitive, totul este foarte simplu — trebuie să plasăm overlay-ul compilat în /boot/overlays și să modificăm puțin /boot/config.txt.
Exemplu de fișier dts
Sincer să fiu, nu sunt sigur că este scris fără erori, dar funcționează.
/*
 * Device tree overlay for at25 at spi0.1
 */

/dts-v1/;
/plugin/;

/ {
    compatible = "brcm,bcm2835", "brcm,bcm2836", "brcm,bcm2708", "brcm,bcm2709";

    /* disable spi-dev for spi0.1 */
    fragment@0 {
        target = <&spi0>;
        __overlay__ {
            status = "okay";
            spidev@1{
                status = "disabled";
            };
        };
    };

    /* the spi config of the at25 */
    fragment@1 {
        target = <&spi0>;
        __overlay__ {
            #address-cells = <1>;
            #size-cells = <0>;
            flash: m25p80@1 {
                    compatible = "atmel,at25df321a";
                    reg = <1>;
                    spi-max-frequency = <50000000>;

                    /* default to false:
                    m25p,fast-read ;
                    */
            };
        };
    };

    __overrides__ {
        spimaxfrequency = <&flash>,"spi-max-frequency:0";
        fastread = <&flash>,"m25p,fast-read?";
    };
};
Și încă o linie în config.txt
dtoverlay=at25:spimaxfrequency=50000000Descrierea conexiunii microcipului la Raspberry Pi o voi omite. Pe de o parte, nu sunt expert în electronică, iar pe de altă parte — totul este banal chiar și pentru mine: microcipul are doar 8 picioare, dintre care ne trebuie masa, alimentarea, SPI (CS, SI, SO, SCK); nivelurile corespund celor de la Raspberry Pi, nu este necesară nicio legătură suplimentară — este suficient să conectăm cele 6 contacte indicate.
Formularea problemei
Ca de obicei, formularea problemei trece prin mai multe iterații, mi se pare că a venit timpul pentru încă una. Așa că haideți să ne oprim, să adunăm tot ce a fost deja scris și să clarificăm detaliile rămase în umbră.
Așadar, ne-am decis că jurnalul va fi stocat în SPI NOR Flash.
Ce este NOR Flash pentru cei care nu știu
Este o memorie non-volatilă, cu care se pot efectua trei operațiuni:
- Citire:
Cea mai obișnuită citire: transmitem adresa și citim atâtea bilete câte avem nevoie; - Scriere:
Scrierea în memorie NOR flash arată normal, dar are o caracteristică: se poate schimba doar 1 în 0, dar nu și invers. De exemplu, dacă avem în celula de memorie 0x55, după ce scriem 0x0f, va fi păstrată 0x05. (vezi tabelul de mai jos); - Stergere:
Desigur, trebuie să putem face și operația inversă - să schimbăm 0 în 1, și anume pentru aceasta există operația de ștergere. Spre deosebire de primele două, aceasta operează nu cu octeți, ci cu blocuri (blocul minim de ștergere în circuitul ales este de 4 KB). Ștergerea distruge întregul bloc și este singurul mod de a schimba 0 în 1. Astfel, atunci când lucrăm cu memorie flash, adesea trebuie să aliniem structurile de date la limita blocului de ștergere.
Scrierea în NOR Flash:
Date binare
A fost
01010101
Am scris
00001111
A devenit
00000101
Jurnalul însuși reprezintă o secvență de înregistrări de lungime variabilă. Lungimea tipică a unei înregistrări este de aproximativ 30 de octeți (deși uneori pot apărea înregistrări cu lungimi de câțiva kilobiți). În acest caz, lucrăm cu ele pur și simplu ca cu un set de octeți, dar, dacă sunteți interesat, în interiorul înregistrărilor se folosește CBOR.
Pe lângă jurnal, avem nevoie să stocăm unele informații de «setare», atât actualizabile, cât și neactualizabile: un fel de ID al aparatului, calibrarea senzorilor, un steag «aparatul este temporar oprit», etc.
Această informație constă într-un set de înregistrări cheie-valoare, de asemenea stocată în CBOR. Această informație nu este foarte voluminoasă (maxim câțiva kilobiți), fiind actualizată rar.
În continuare, o vom numi context.
Dacă ne amintim de unde a început acest articol, este foarte important să ne asigurăm că stocarea datelor este fiabilă și, pe cât posibil, funcționarea continuă chiar și în cazul de defecte hardware/întârzieri de date.
Ce surse de probleme putem lua în considerare?
- Deconectarea alimentării în momentul operațiunilor de scriere/ștergere. Aceasta este de domeniul „împotriva durerii nu există remediu”.
Informația din de pe stackexchange: când alimentarea este oprită în timpul lucrului cu flash, atât ștergerea (setarea în 1), cât și scrierea (setarea în 0) duc la un comportament nedefinit: datele pot fi scrise, scrise parțial (de exemplu, am transmis 10 octeți/80 de biți, dar am reușit să scriem doar 45 de biți), nu este exclus că unele biți pot fi în stare „intermediară” (citirea poate returna atât 0, cât și 1); - Erori ale memoriei flash însăși.
BER, deși foarte scăzut, nu poate fi egal cu zero; - Erori pe magistrală
Datele transmise prin SPI nu sunt protejate în niciun fel, iar atât erorile unice de bit, cât și erorile de sincronizare — pierderi sau inserții de biți (ceea ce duce la distorsiuni masive ale datelor) se pot întâmpla; - Alte erori/falamente
Erori în cod, „buguri” Raspberry, intervenția extratereștrilor…
Am formulat cerințele pe care, în opinia mea, este necesar să le îndeplinim pentru a asigura fiabilitatea:
- înregistrările trebuie să ajungă imediat în memoria flash, nu se ia în considerare scrierea întârziată; - dacă apare o eroare, aceasta trebuie detectată și gestionată cât mai devreme; - sistemul trebuie, dacă este posibil, să își restaureze funcționarea după erori.
(exemplu din viață „cum nu ar trebui să fie”, cu care, cred, că s-a confruntat toată lumea: după o repornire de urgență, sistemul de fișiere s-a stricat și sistemul de operare nu mai pornește)
Idei, abordări, reflecții
Când am început să mă gândesc la această sarcină, o mulțime de idei îmi treceau prin minte, de exemplu:
- a folosi compresia datelor;
- a utiliza structuri de date ingenioase, de exemplu, a stoca titlurile înregistrărilor separat de înregistrările în sine, astfel încât, în cazul unei erori într-o înregistrare, să se poată citi fără probleme celelalte;
- a folosi câmpuri de biți pentru a controla finalizarea înregistrării în caz de întrerupere a alimentării;
- a stoca adrese de control pentru tot și toate;
- a folosi o varietate de codare rezistentă la interferențe.
O parte din aceste idei au fost folosite, iar de parte s-a decis renunțarea. Să le luăm pe rând.
Compresia datelor
Evenimentele pe care le înregistrăm în jurnal sunt destul de omogene și repetitive („am aruncat o monedă de 5 ruble”, „am apăsat pe butonul de returnare a restului”, ...). Prin urmare, compresia ar trebui să se dovedească destul de eficientă.
Costurile de compresie sunt nesemnificative (procesorul nostru este destul de puternic, chiar și pe primul Pi era un nucleu cu o frecvență de 700 MHz, iar pe modelele actuale mai multe nuclee cu frecvențe de peste un gigahertz), viteza de schimb cu stocarea este scăzută (câteva megabytes pe secundă), dimensiunea înregistrărilor nu este mare. În general, dacă compresia va avea un impact asupra performanței, acesta va fi doar pozitiv (absolut necritic, doar constat). Avem un Linux obișnuit, nu un embedded adevărat, așa că implementarea nu ar trebui să necesite multe eforturi (este suficient să legăm biblioteca și să folosim câteva funcții din ea).
A fost preluat un fragment de log de la un dispozitiv funcțional (1.7Mb, 70 de mii de înregistrări) și, pentru început, a fost verificat pentru comprimabilitate folosind gzip, lz4, lzop, bzip2, xz, zstd disponibile pe computer.
- gzip, xz, zstd au arătat rezultate apropiate (40Kb).
M-a surprins că xz, care este popular, a avut performanțe la nivelul gzip sau zstd; - lzip cu setările implicite a oferit un rezultat puțin mai slab;
- lz4 și lzop au arătat rezultatele nu foarte bune (150Kb);
- bzip2 a arătat un rezultat surprinzător de bun (18Kb).
Așadar, datele se comprimă foarte bine.
Deci, (dacă nu găsim defecte fatale) comprimarea este posibilă! Pur și simplu pentru că se vor potrivi mai multe date pe aceeași unitate flash.
Hai să ne gândim la dezavantaje.
Prima problemă: am convenit deja că fiecare înregistrare trebuie să ajungă imediat pe flash. De obicei, arhivatorul colectează date din fluxul de intrare până când decide că este momentul să scrie în ieșire. Noi trebuie să obținem imediat un bloc de date comprimate și să-l salvăm în memoria nevolatilă.
Văd trei soluții:
- A comprima fiecare înregistrare folosind compresia prin dicționar în loc de algoritmii discutati mai sus.
Este o variantă viabilă, dar nu-mi place. Pentru a asigura un nivel de comprimare mai mult sau mai puțin acceptabil, dicționarul trebuie să fie 'ajustat' pentru datele specifice, orice modificare va duce la o scădere catastrofală a nivelului de comprimare. Da, problema poate fi rezolvată prin crearea unei versiuni noi a dicționarului, dar asta reprezintă o bătaie de cap – va trebui să păstrăm toate versiunile dicționarului; în fiecare înregistrare va trebui să indicăm cu ce versiune a dicționarului a fost comprimată… - A comprima fiecare înregistrare folosind algoritmi 'clasici', dar în mod independent de celelalte.
Algoritmii de compresie considerați nu sunt proiectați pentru a lucra cu înregistrări de această dimensiune (câteva zeci de octeți), coeficientul de comprimare va fi evident sub 1 (adică o creștere a volumului de date în loc de comprimare); - A efectua un FLUSH după fiecare înregistrare.
În multe biblioteci de compresie există suport pentru FLUSH. Aceasta este o comandă (sau un parametru pentru procedura de compresie) care, odată primită, face ca arhivatorul să formeze un flux comprimat astfel încât să se poată recupera tot date necomprimate care au fost deja primite. O analogiesyncîn sistemele de fișiere sauConfigurarea stivei (iStack)în sql.
Este important că operațiunile ulterioare de comprimare vor putea utiliza dicționarul acumulat și gradul de compresie nu va suferi atât de mult ca în varianta precedentă.
Cred că este evident că am ales a treia variantă, să ne oprim asupra ei în detaliu.
Am găsit despre FLUSH în zlib.
Am realizat un test, inspirat de articol, am luat 70 de mii de înregistrări din jurnal de pe un dispozitiv real, cu dimensiunea paginii de 60KB (la dimensiunea paginii vom reveni) am obținut:
Datele originale
Comprimare gzip -9 (fără FLUSH)
zlib cu Z_PARTIAL_FLUSH
zlib cu Z_SYNC_FLUSH
Volum, KB
1692
40
352
604
La prima vedere, costul impus de FLUSH pare excesiv de mare, dar, de fapt, avem o alegere limitată — fie să nu comprimăm deloc, fie să comprimăm (și destul de eficient) cu FLUSH. Nu trebuie să uităm că avem 70 de mii de înregistrări, iar redundanța adusă de Z_PARTIAL_FLUSH este de doar 4-5 octeți pe înregistrare. Iar coeficientul de compresie s-a dovedit a fi aproape 5:1, ceea ce reprezintă un rezultat excelent.
Poate părea surprinzător, dar de fapt Z_SYNC_FLUSH este o metodă mai eficientă de a face FLUSH
În cazul utilizării Z_SYNC_FLUSH, cei patru octeți finali ai fiecărei înregistrări vor fi întotdeauna 0x00, 0x00, 0xff, 0xff. Iar dacă îi cunoaștem — atunci putem să nu-i stocăm, astfel încât dimensiunea finală ajunge la doar 324KB.
În articolul la care fac referire, există o explicație:
Un nou bloc de tip 0 cu conținuturi goale este adăugat.
Un bloc de tip 0 cu conținuturi goale constă din:
- antetul blocului cu trei biți;
- 0 până la 7 biți egali cu zero, pentru a atinge alinierea pe octeți;
- secvența de patru octeți 00 00 FF FF.
După cum se poate observa, în ultimul bloc înainte de cei 4 octeți există între 3 și 10 biți nuli. Totuși, practica a arătat că biții nuli sunt de fapt minimum 10.
Se pare că astfel de blocuri de date de dimensiuni reduse sunt în mod obișnuit (întotdeauna?) codificate folosind un bloc de tip 1 (bloc fix), care se încheie întotdeauna cu 7 biți nuli, obținând astfel 10-17 biți nuli garantat (iar ceilalți vor fi nuli cu o probabilitate de aproximativ 50%).
Așadar, la datele de test în 100% din cazuri înainte de 0x00, 0x00, 0xff, 0xff există un octet nul, iar în mai mult de o treime din cazuri — două octeți nuli (poate că este din cauza că folosesc CBOR binar, iar la utilizarea JSON-ului text, blocuri de tip 2 — bloc dinamic, ar apărea mai des, și astfel ar apărea blocuri fără octeți nuli suplimentari înainte de 0x00, 0x00, 0xff, 0xff).
În total, cu datele de test disponibile, se poate realiza o compresie de mai puțin de 250KB de date comprimate.
Se pot economisi și ceva mai multe resurse, jonglând cu biții: acum ignorăm existența mai multor biți nul la sfârșitul blocului, mai mulți biți la începutul blocului nu se schimbă de asemenea...
Dar atunci am luat decizia fermă de a mă opri, altfel, cu acest ritm, aș putea ajunge să dezvolt propriul meu arhivator.
În total, din datele mele de test am obținut 3-4 biți pe scriere, raportul de compresie a fost mai mare de 6:1. Să fiu sincer: nu m-am așteptat la un astfel de rezultat; din punctul meu de vedere, tot ce e mai bun de 2:1 este deja un rezultat care justifică utilizarea compresiei.
Totul este excelent, dar zlib (deflate) rămâne totuși un algoritm de compresie arhaic și puțin învechit. Deja, faptul că se folosesc ultimele 32KB din fluxul de date necomprimate ca dicționar pare ciudat în zilele noastre (adică, dacă un bloc de date este foarte similar cu ceea ce a fost în fluxul de intrare acum 40KB, acesta va începe să fie arhivat din nou, și nu va face referire la intrarea trecută). În arhivatoarele moderne, dimensiunea dicționarului este adesea măsurată în megabytes, nu în kilobytes.
Așa că continuăm mini-investigarea noastră asupra arhivatorilor.
Următorul testat a fost bzip2 (îmi amintesc, fără FLUSH a arătat o rată de compresie fantastică, aproape 100:1). Din păcate, cu FLUSH a avut o performanță foarte slabă, dimensiunea datelor comprimate s-a dovedit a fi mai mare decât cea a datelor necomprimate.
Presupunerile mele cu privire la motivele eșecului
Libbz2 oferă doar o opțiune de flush, care pare să curețe dicționarul (analog cu Z_FULL_FLUSH în zlib), și nu poate fi vorba despre o compresie eficientă după asta.
Și în cele din urmă, am testat zstd. În funcție de parametri, comprimă fie la nivelul gzip, dar mult mai repede, fie mai bine decât gzip.
Din păcate, cu FLUSH, a avut și el o performanță 'nu foarte bună': dimensiunea datelor comprimate a fost de aproximativ 700KB.
Eu pe pagina proiectului pe github, am primit răspunsul că ar trebui să ne așteptăm la până la 10 biți de date de overhead pentru fiecare bloc de date comprimate, ceea ce este aproape de rezultatele obținute; deflate nu poate fi depășit sub nici o formă.
Aici am decis să mă opresc cu experimentele cu arhivatoarele (îmi amintesc că xz, lzip, lzo, lz4 nu s-au dovedit a fi foarte performante nici în stadiul de testare fără FLUSH, iar considerarea unor algoritmi de compresie mai exotici nu a fost o opțiune).
Ne întoarcem la problemele de arhivare.
A doua problemă (așa cum se spune, în ordinea numerelor, nu după semnificație) este că datele comprimate reprezintă un singur flux, în care se fac trimitere constantă la segmentele anterioare. Astfel, în cazul deteriorării unei secțiuni a datelor comprimate, nu doar blocul asociat de date necomprimate va fi pierdut, ci și toate celelalte ulterioare.
Există abordări pentru a rezolva această problemă:
- Avertizarea cu privire la apariția problemei — adăugarea de redundanță în datele comprimate, care va permite detectarea și corectarea erorilor; despre aceasta vom discuta mai târziu;
- Minimizarea consecințelor în cazul apariției problemei
Am menționat anterior că fiecare bloc de date poate fi comprimat independent, astfel încât problema să dispară de la sine (deteriorarea datelor unui bloc va conduce la pierderea doar a datelor acelui bloc). Totuși, acesta este un caz extrem, în care comprimarea datelor va fi ineficientă. Extremul opus: utilizarea întregii noastre cip pentru arhivare ca un singur tot, ceea ce ne va oferi o comprimare excelentă, dar consecințe catastrofale în cazul deteriorării datelor.
Da, este nevoie de un compromis din punct de vedere al fiabilității. Dar trebuie să ținem cont că dezvoltăm un format de stocare a datelor pentru memorie nevolatilă cu un BER extrem de scăzut și o durată de viață a datelor declarată de 20 de ani.
În timpul experimentelor, am descoperit că pierderile notabile la nivelul comprimării încep cu blocuri de date comprimate de dimensiuni mai mici de 10Kb.
S-a menționat anterior că memoria utilizată are o organizare pe pagini, nu văd motive pentru care nu ar trebui să folosim corespondența "o pagină — un bloc de date comprimate".
Astfel, dimensiunea minimă rezonabilă a unei pagini este de 16Kb (cu un buffer pentru informațiile de control). Totuși, o dimensiune atât de mică a paginii impune restricții semnificative asupra dimensiunii maxime a unui înregistrări.
Deși nu prevăd înregistrări mai mari de un kilobyte în formă comprimată, am decis să folosesc pagini de dimensiune 32Kb (adică un total de 128 de pagini pe cip).
Rezumat:
- Datele sunt stocate comprimate cu zlib (deflate);
- Pentru fiecare înregistrare setăm Z_SYNC_FLUSH;
- La fiecare înregistrare comprimată, tăiem byte-urile finale (de exemplu, 0x00, 0x00, 0xff, 0xff); în antet indicăm câți byte am tăiat;
- Datele sunt stocate în pagini de 32K; în interiorul paginii există un flux continuu de date comprimate; pentru fiecare pagină, comprimarea începe din nou.
Și, înainte de a încheia procesul de comprimare, aș dori să subliniez că datele comprimate rezultă în doar câțiva biți pe scriere, așa că este extrem de important să nu umflăm informațiile de control, fiecare bit contează.
Stocarea header-elor de date
Deoarece avem înregistrări de lungime variabilă, trebuie să găsim o modalitate de a determina plasarea/limitele înregistrărilor.
Știu trei abordări:
- Toate înregistrările sunt stocate într-un flux continuu, mai întâi se află header-ul înregistrării, care conține lungimea, urmat de înregistrare.
În această variantă, atât header-urile, cât și datele pot avea lungime variabilă.
Practic, obținem o listă simplu legată, utilizată frecvent; - Header-urile și înregistrările în sine sunt stocate în fluxuri separate.
Folosind header-uri de lungime constantă, ne asigurăm că deteriorarea unui header nu afectează celelalte.
Această abordare este utilizată, de exemplu, în multe sisteme de fișiere; - Înregistrările sunt stocate într-un flux continuu, limita înregistrării este determinată de un anumit marker (simbol/serie de simboluri care sunt interzise în interiorul blocurilor de date). Dacă întâlnim un marker în interiorul înregistrării, îl înlocuim cu o anumită secvență (îl escapăm).
O astfel de abordare este utilizată, de exemplu, în protocolul PPP.
Voi ilustra.
Variantă 1:
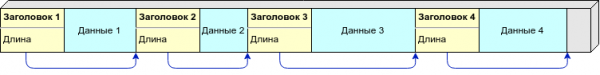
Aici totul este foarte simplu: cunoscând lungimea înregistrării putem calcula adresa următorului header. Astfel, ne mișcăm prin header-uri până întâlnim o zonă umplută cu 0xff (zona liberă) sau sfârșitul paginii.
Variantă 2:
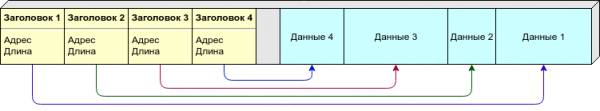
Din cauza lungimii variabile a înregistrărilor, nu putem prezice dinainte câte înregistrări (și deci câte header-uri) ne vor fi necesare pe pagină. Putem dispersa header-urile și datele pe pagini diferite, dar prefer o altă abordare: atâta header cât și datele sunt plasate pe aceeași pagină, dar header-urile (de dimensiune constantă) sunt de la începutul paginii, iar datele (de lungime variabilă) sunt de la sfârșit. Atunci când "se întâlnesc" (spațiul liber nu este suficient pentru o nouă înregistrare) — considerăm această pagină completă.
Variantă 3:

Nu este nevoie să păstrăm în antet lungimea sau alte informații despre locația datelor, este suficient să avem marcatori care să indice limitele înregistrărilor. Totuși, datele trebuie prelucrate la scriere/citire.
Ca marcator, aș folosi 0xff (cu care este umplută pagina după ștergere), astfel încât zona liberă nu va fi interpretată ca date.
Tabel de comparație:
Opțiunea 1
Opțiunea 2
Opțiunea 3
Rezistență la erori
—
+
+
Compactitate
+
—
+
Complexitate de implementare
*
**
**
Opțiunea 1 are un dezavantaj fatal: dacă se deteriorează unul dintre antete, întreaga secvență ulterioară se va distruge. Celelalte opțiuni permit recuperarea unei părți din date chiar și în cazul unor deteriorări majore.
Dar aici este oportun să ne amintim că am decis să stocăm datele într-o formă comprimată, astfel că, în orice caz, pierdem toate datele de pe pagină după o înregistrare „stricată”, așa că, deși în tabel apare un minus, nu-l luăm în considerare.
Compactitate:
- în prima opțiune trebuie să păstrăm în antet doar lungimea, iar dacă folosim variabile de lungime întreagă, în cele mai multe cazuri putem folosi doar un byte;
- în a doua opțiune trebuie să păstrăm adresa de început și lungimea; înregistrarea trebuie să fie de dimensiune fixă, eu o estimez la 4 bytes pe înregistrare (două bytes pentru offset și două bytes pentru lungime);
- în a treia opțiune este suficient un singur caracter pentru a indica începutul înregistrării, plus că înregistrarea în sine, din cauza escapării, va crește cu 1-2%. În general, o paritate estimativă cu prima opțiune.
Inițial am considerat a doua opțiune ca fiind principală (și chiar am scris o implementare). Am renunțat la ea doar atunci când am decis în mod final să folosesc compresia.
Poate că, cândva, voi folosi totuși o astfel de opțiune. De exemplu, dacă va trebui să mă ocup cu stocarea datelor pentru o navă care călătorește între Pământ și Marte — cerințe complet diferite de fiabilitate, radiație cosmică,…
Cât despre a treia opțiune: i-am dat două stele pentru complexitatea de implementare pur și simplu pentru că nu-mi place să mă ocup cu escaparea, modificarea lungimii în proces etc. Da, poate că este părtinitor, dar codul trebuie să-l scriu eu — de ce să mă oblig să fac ceva ce nu-mi place.
Rezumat: Alegem varianta de stocare sub formă de lanțuri „antet cu lungime - date de lungime variabilă” datorită eficienței și simplității implementării.
Utilizarea câmpurilor binare pentru a controla succesul operațiunilor de scriere.
Încă nu-mi amintesc unde am văzut ideea, dar arată cam așa:
Pentru fiecare înregistrare alocăm câțiva biți pentru stocarea flagurilor.
După cum am spus anterior, după erase toți biții sunt umpluți cu 1, și putem schimba 1 în 0, dar nu invers. Așadar, pentru „flag neterminat” folosim 1, pentru „flag terminat” - 0.
Iată cum ar putea arăta plasarea unei înregistrări de lungime variabilă în flash:
- Setăm flagul „începerea scrierii lungimii”;
- Scriem lungimea;
- Setăm flagul „începerea scrierii datelor”;
- Scriem datele;
- Setăm flagul „scrierea s-a terminat”.
În plus, vom avea un flag „a apărut o eroare”, deci în total 4 flaguri binare.
În acest caz, avem două stări stabile „1111” - scrierea nu a început și „1000” - scrierea a avut succes; în cazul unei întreruperi neprevăzute a procesului de scriere, vom obține stări intermediare pe care le putem detecta și gestiona ulterior.
Abordarea este interesantă, dar protejează doar împotriva întreruperilor bruste de alimentare și a unor astfel de erori, ceea ce este important, dar nu este singura (și nici măcar principala) cauză a posibilelor defecțiuni.
Rezumat: Să continuăm căutările pentru o soluție bună.
Sumele de control.
Sumele de control oferă și ele posibilitatea de a ne asigura (cu o probabilitate suficientă) că citim exact ceea ce ar fi trebuit să fie scris. Și, spre deosebire de câmpurile binare discutate mai sus, acestea funcționează întotdeauna.
Dacă analizăm lista potențialelor surse de probleme despre care am vorbit mai sus, suma de control poate detecta o eroare indiferent de sursa ei. (cu excepția, poate, a extratereștrilor rău intenționați - aceștia ar putea falsifica și suma de control).
Așadar, dacă scopul nostru este să verificăm că datele sunt intacte, sumele de control sunt o idee excelentă.
Alegerea algoritmului de calcul a sumei de control nu a ridicat întrebări - CRC. Pe de o parte, proprietățile matematice permit capturarea 100% a unor tipuri de erori, pe de altă parte - pe datele aleatorii, acest algoritm prezintă de obicei o probabilitate a coliziunilor nu semnificativ mai mare decât limita teoretică.  Deși aceasta nu este cea mai rapidă algoritmă, nici întotdeauna minimă în ceea ce privește numărul coliziunilor, are o calitate foarte importantă: în testele pe care le-am întâlnit, nu am găsit tipare în care să eșueze vizibil. Stabilitatea este calitatea principală în acest caz.
Exemplu de studiu amplu: , (linkuri către narod.ru, îmi pare rău).
Cu toate acestea, sarcina de a alege o sumă de control nu este finalizată, CRC fiind o întreagă familie de sume de control. Trebuie să ne decidem asupra lungimii și apoi să alegem un polinom.
Alegerea lungimii unei sume de control nu este o întrebare atât de simplă pe cât pare la prima vedere.
Să ilustrez:
Să presupunem că avem o probabilitate de eroare în fiecare byte  și o sumă de control ideală, să calculăm numărul mediu de erori la un milion de înregistrări:
Date, byte
Sumă de control, byte
Erori nedetectate
Detectări false de erori
Total erori false
1
0
1000
0
1000
1
1
4
999
1003
1
2
≈0
1997
1997
1
4
≈0
3990
3990
10
0
9955
0
9955
10
1
39
990
1029
10
2
≈0
1979
1979
10
4
≈0
3954
3954
1000
0
632305
0
632305
1000
1
2470
368
2838
1000
2
10
735
745
1000
4
≈0
1469
1469
Părea simplu — alege în funcție de lungimea datelor protejate lungimea sumei de control cu un minim de erori false — și am terminat.
Cu toate acestea, cu sumele de control scurte apare o problemă: deși acestea detectează bine erorile de bit unice, pot cu o mare probabilitate să accepte date complet aleatorii ca fiind corecte. Pe Habr a fost deja un articol care descria .
Prin urmare, pentru a face coincidența aleatoare a sumei de control practic imposibilă, trebuie să folosim sume de control de 32 de biți sau mai mult. (pentru lungimi de peste 64 de biți, se folosesc de obicei funcții de hash criptografice).
Deși am scris anterior că trebuie să economisim spațiu cu orice preț, totuși vom folosi o sumă de control de 32 de biți (16 biți sunt puțini, probabilitatea coliziunii fiind mai mare de 0.01%; iar 24 de biți, cum se spune, nu sunt nici aici, nici acolo).
Aici poate apărea o obiecție: am economisit fiecare byte în alegerea compresiei pentru a justifica acum livrarea a 4 bytes imediat? Nu era mai bine să nu comprimăm și să nu adăugăm suma de control? Desigur că nu, absența compresiei nu înseamnă, că verificarea integrității nu este necesară.
În privința alegerii polinomului, nu vom reinventa roata, ci vom lua un popular CRC-32C.
Acest cod detectează 6 erori de biți în pachete de până la 22 de octeți (probabil cel mai frecvent caz pentru noi), 4 erori de biți în pachete de până la 655 de octeți (de asemenea, un caz frecvent pentru noi), 2 sau orice număr impar de erori de biți în pachete de orice lungime rezonabilă.
Dacă pe cineva îl interesează detaliile
despre CRC.
pe — probabil cel mai important specialist pe planetă în domeniul CRC.
În are , care oferă parametrii puțin mai buni pentru lungimile de pachete relevante pentru noi, dar nu am considerat că diferența este semnificativă, și mă consider suficient de competent pentru a alege un cod personalizat în locul unuia standard bine cercetat.
De asemenea, având în vedere că datele noastre sunt comprimate, apare întrebarea: ar trebui să calculăm suma de control pentru date comprimate sau necomprimate?
Argumente „pentru” calcularea sumei de control pentru datele necomprimate:
- în cele din urmă trebuie să verificăm integritatea stocării datelor — iată cum o verificăm direct (în acest sens, vor fi verificate și eventualele erori în implementarea compresiei/decompresiei, deteriorările cauzate de memoria defectă etc.);
- algoritmul deflate din zlib are o implementare suficient de matură și nu ar trebui să eșueze cu date de intrare „strâmbe”, ba mai mult, de multe ori este capabil să detecteze singur erorile din fluxul de intrare, reducând probabilitatea totală de neobservare a erorii (am efectuat un test cu inversarea unui singur bit într-o înregistrare scurtă, zlib a detectat eroarea în aproximativ o treime din cazuri).
Argumente „împotrivă” calculării sumei de control pentru datele necomprimate:
- CRC este „adaptat” pentru erori de biți puțin numeroase, care sunt caracteristice memoriei flash (o eroare de bit în fluxul comprimat poate duce la modificări masive ale fluxului de ieșire, pe care, teoretic, le putem „prinde” ca o coliziune);
- nu mi se pare plăcut să transmit decompresorului date posibil corupte, , cum va reacționa.
În acest proiect am decis să mă abat de la practica acceptată de a stoca suma de control pentru datele necomprimate.
Rezumat: folosim CRC-32C, suma de control fiind calculată pe baza datelor așa cum sunt ele scrise în flash (după comprimare).
Redundanță
Utilizarea codării redundante nu elimină, desigur, pierderea de date, totuși, poate reduce semnificativ (adesea cu multe ordini de mărime) probabilitatea unei pierderi ireparate de date.
Putem folosi diferite tipuri de redundanță pentru a corecta erorile.
Codurile Hamming pot corecta erorile unice de bit, codurile Reed-Solomon sunt simbolice, mai multe copii de date împreună cu sumele de control sau codificarea de tip RAID-6 pot ajuta la recuperarea datelor chiar și în cazul unor daune extinse.
La început am fost predispus la utilizarea pe scară largă a codării rezistente la interferențe, dar apoi am realizat că trebuie mai întâi să avem o idee despre ce tip de erori dorim să ne protejăm, și abia apoi să alegem codificarea.
Am menționat anterior că erorile trebuie identificate cât mai repede posibil. În ce momente putem întâlni erori?
- Înregistrare incompletă (din diverse motive, alimentarea s-a oprit în momentul înregistrării, Raspberry s-a blocat, ...)
Din păcate, în cazul unei astfel de erori, nu rămâne decât să ignorăm înregistrările invalide și să considerăm datele pierdute; - Erori de scriere (din diverse motive, a fost scris în memoria flash ceea ce nu a fost de fapt înregistrat)
Aceste erori pot fi detectate imediat dacă, după scriere, facem o citire de control; - Deformarea datelor în memorie în timpul stocării;
- Erori de citire
Pentru a corecta, este suficient în cazul unei neconcordanțe a sumei de control să repetăm citirea de câteva ori.
Adică, doar erorile de tip trei (degradarea spontană a datelor în timpul stocării) nu pot fi corectate fără codificare rezistentă la interferențe. Se crede că astfel de erori sunt foarte puțin probabile.
Rezumat: s-a decis abandonarea codării redundante, dar, dacă exploatarea va arăta că această decizie este eronată, se va reveni asupra acestei chestiuni (cu statistica acumulată pe defecte, care va permite alegerea celui mai optim tip de codificare).
Altele
Desigur, formatul articolului nu permite justificarea fiecărui bit în format (și oricum mi-au epuizat forțele), așa că voi trece rapid prin câteva aspecte care nu au fost discutate anterior.
- S-a decis să facem toate paginile "de egalitate"
Asta înseamnă că nu vor exista pagini speciale cu metadate, fluxuri separate etc., ci un singur flux care rescrie toate paginile pe rând.
Acest lucru asigură uzura uniformă a paginilor, absența unui singur punct de defecțiune și pur și simplu ne place; - Este necesar să se prevadă versiunea formatului.
Un format fără numărul versiunii în antet este rău!
Este suficient să adăugăm în antetul paginii un câmp cu un anumit Magic Number (semnătură) care va indica versiunea formatului utilizat. (nu cred că în practică vor fi chiar zece); - Utilizați pentru înregistrări (care sunt foarte multe) un antet de lungime variabilă, încercând în cele mai multe cazuri să-l faceți de lungime de 1 byte;
- Pentru codificarea lungimii antetului și a lungimii părții tăiate din înregistrarea comprimată, utilizați coduri binare de lungime variabilă.
M-a ajutat foarte mult de coduri Huffman. În doar câteva minute am reușit să găsesc codurile de lungime variabilă necesare.
Descrierea formatului de stocare a datelor
Ordinea octeților
Câmpurile de dimensiune mai mare de un byte sunt stocate în format big-endian (ordine de byte de rețea), adică 0x1234 este stocat ca 0x12, 0x34.
Împărțirea în pagini
Întreaga memorie flash este împărțită în pagini de dimensiuni egale.
Dimensiunea paginii, în mod implicit, este de 32KB, dar nu mai mult de 1/4 din dimensiunea totală a cipului de memorie (pentru un cip de 4MB, se obțin 128 de pagini).
Fiecare pagină stochează date independent de altele (adică datele unei pagini nu se referă la datele altei pagini).
Toate paginile sunt numerotate în ordine naturală (în ordine crescătoare a adreselor), începând cu numărul 0 (pagina zero începe cu adresa 0, prima cu 32KB, a doua cu 64KB etc.)
Cipul de memorie este utilizat ca un buffer circular (ring buffer), adică mai întâi scrierea se face în pagina cu numărul 0, apoi în pagina cu numărul 1, ... când umplem ultima pagină, începe un nou ciclu și scrierea continuă din pagina zero.
În interiorul paginii
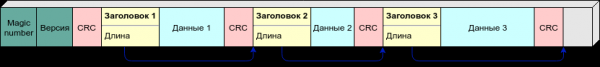
La începutul paginii se află un antet de 4 bytes, apoi checksum-ul antetului (CRC-32C), apoi se stochează înregistrările în formatul „antet, date, checksum”.
Antetul paginii (în diagramă de culoare verde murdar) constă din:
- un câmp de 2 bytes Magic Number (care este și semnul versiunii formatului)
pentru versiunea curentă a formatului, este considerat ca0xed00 ⊕ numărul paginii; - counterul pe 2 bytes „Versionarea paginii” (numărul ciclului de rescriere a memoriei).
Înregistrările paginii sunt stocate într-un format comprimat (folosind algoritmul deflate). Toate înregistrările de pe o pagină sunt comprimate într-un singur flux (se folosește un dicționar comun), la fiecare pagină nouă, comprimarea începe de la zero. Asta înseamnă că pentru decomprimarea oricărei înregistrări sunt necesare toate înregistrările precedente de pe această pagină (și doar de pe aceasta).
Fiecare înregistrare va fi comprimată cu flag-ul Z_SYNC_FLUSH, iar la sfârșitul fluxului comprimat se vor găsi 4 bytes 0x00, 0x00, 0xff, 0xff, posibil precedați de încă unul sau două bytes zero.
Această secvență (de lungime 4, 5 sau 6 bytes) este eliminată la scrierea în memoria flash.
Antetul înregistrării constă din 1, 2 sau 3 bytes, care conțin:
- un bit (T), care reprezintă tipul înregistrării: 0 — context, 1 — jurnal;
- un câmp de lungime variabilă (S) de la 1 la 7 bits, care definește lungimea antetului și „coada” care trebuie adăugată la înregistrare pentru decomprimare;
- lungimea înregistrării (L).
Tabelul valorilor S:
S
Lungimea antetului, bytes
Eliminat la scriere, bytes
0
1
5 (00 00 00 ff ff)
10
1
6 (00 00 00 00 ff ff)
110
2
4 (00 00 ff ff)
1110
2
5 (00 00 00 ff ff)
11110
2
6 (00 00 00 00 ff ff)
1111100
3
4 (00 00 ff ff)
1111101
3
5 (00 00 00 ff ff)
1111110
3
6 (00 00 00 00 ff ff)
Am încercat să ilustrez, nu știu cât de clar a ieșit:
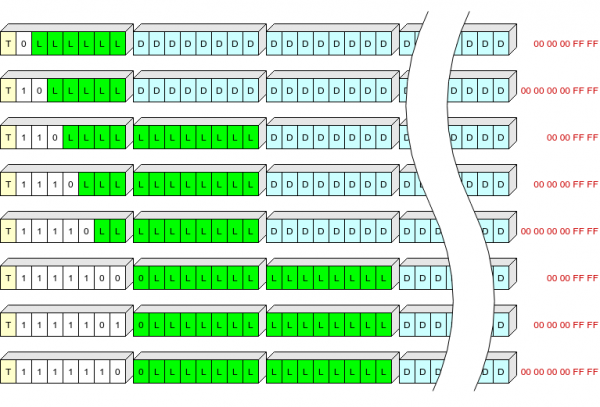
Galbenul reprezintă câmpul T, alb câmpul S, verde L (lungimea datelor comprimate în bytes), albastrul — datele comprimate, roșu — bytes finale ale datelor comprimate care nu sunt scrise în memoria flash.
Astfel, anteturile înregistrărilor cele mai comune (până la 63+5 bytes în formă comprimată) le putem scrie într-un singur byte.
După fiecare înregistrare se află o sumă de control CRC-32C, care are ca valoare inițială (init) valoarea inversată a sumei de control anterioare.
CRC are proprietatea „continuității”, funcționează (aproximativ inversarea bitilor în proces) cu următoarea formulă:  .
Adică, practic calculăm CRC pentru toți bytes anteriori ai antetelor și datelor de pe această pagină.
Imediat după suma de control se află antetul următoarei înregistrări.
Antetul este construit astfel încât primul său byte să fie întotdeauna diferit de 0x00 și 0xff (dacă întâlnim 0xff în loc de primul byte al antetului, înseamnă că aceasta este o zonă neutilizată; 0x00 semnalizează o eroare).
Algoritmi aproximativi
Citire din memoria flash
Orice citire se face cu verificarea sumei de control.
Dacă suma de control nu corespunde, citirea se repetă de mai multe ori în speranța de a citi datele corecte.
(aceasta are sens, Linux nu cachează citirile din NOR Flash, verificat)
Scriere în memorie flash
Scriem datele.
Le citim.
Dacă datele citite nu se potrivesc cu cele scrise, umplem zona cu zerouri și semnalizăm o eroare.
Pregătirea noului cip pentru funcționare
Pentru inițializare, în prima (mai bine zis, pagina zero) se scrie un header cu versiunea 1.
După aceasta, în această pagină se scrie contextul inițial (conține UUID-ul automatului și setările implicite).
Totul, memoria flash este pregătită pentru funcționare.
Încărcarea automatului
La încărcare, se citesc primii 8 biți din fiecare pagină (header + CRC), paginile cu număr magic necunoscut sau CRC incorect sunt ignorate.
Din paginile „corecte” se aleg paginile cu versiunea maximă, din care se ia pagina cu cel mai mare număr.
Se citește prima înregistrare, se verifică corectitudinea CRC-ului, prezența steagului „context”. Dacă totul este în regulă, această pagină este considerată curentă. Dacă nu, revenim la pagina anterioară, până găsim o pagină „viabilă”.
Pe pagina găsită citim toate înregistrările, cele cu steagul „context” se aplică.
Salvăm dicționarul zlib (va fi necesar pentru scrierea ulterioară pe această pagină).
Totul, încărcarea s-a finalizat, contextul a fost restabilit, se poate lucra.
Adăugarea unei înregistrări în jurnal
Compresăm înregistrarea cu dicționarul corect, indicând Z_SYNC_FLUSH. Verificăm dacă înregistrarea comprimată încapacitează pagina curentă.
Dacă nu încap (sau pe pagină au fost erori CRC) - începem o pagină nouă (vezi mai jos).
Scriem înregistrarea și CRC. Dacă a apărut o eroare - începem o pagină nouă.
Pagină nouă
Alegem o pagină liberă cu cel mai mic număr (considerăm liberă o pagină cu suma de control greșită în header sau cu versiunea mai mică decât cea curentă). Dacă nu există astfel de pagini, alegem pagina cu cel mai mic număr dintre cele care au versiunea egală cu cea curentă.
Facem pagina aleasă erase. Comparăm conținutul cu 0xff. Dacă ceva nu este în regulă, luăm urmatoarea pagină liberă etc.
Pe pagina ștearsă scriem headerul, prima înregistrare este starea curentă a contextului, următoarea - înregistrarea jurnalului nescris (dacă există).
Aplicabilitatea formatului
Din punctul meu de vedere, a rezultat un format decent pentru stocarea oricăror fluxuri de informații mai mult sau mai puțin comprimate (text simplu, JSON, MessagePack, CBOR, poate chiar protobuf) în NOR Flash.
Desigur, formatul este „adaptat” pentru SLC NOR Flash.
Nu ar trebui folosit cu suporturi cu BER ridicat, cum ar fi NAND sau MLC NOR. (Există vreo astfel de memorie la vânzare? Am văzut doar mențiuni în lucrările despre coduri de corecție.).
Cu atât mai mult, nu ar trebui folosit cu dispozitive care au propriul FTL: USB flash, SD, MicroSD, etc. (Pentru astfel de memorii, am creat un format cu dimensiunea paginii de 512 byte, cu o semnătură la începutul fiecărei pagini și identificatori unici pentru înregistrări — uneori, reușeam să recuperez toate datele prin simpla citire secvențială de pe o memorie flash „glicată”.).
În funcție de sarcini, formatul poate fi folosit fără modificări pe flash-uri de la 128Kbit (16Kb) până la 1Gbit (128Mb). Dacă se dorește, poate fi folosit și pe cipuri de o capacitate mai mare, dar, probabil, ar trebui ajustată dimensiunea paginii. (Dar aici apare întrebarea eficienței economice, prețul pe NOR Flash de mare capacitate nu este încurajator.).
Dacă cineva a găsit formatul interesant și vrea să-l folosească într-un proiect deschis — scrieți-mi, voi încerca să găsesc timp să revizuiesc codul și să-l public pe github.
Concluzie
După cum vedem, în cele din urmă, formatul s-a dovedit a fi simplu. Și chiar plictisitor..
În articol este greu să reflectăm evoluția punctului meu de vedere, dar credeți-mă: inițial mi-am dorit să creez ceva sofisticat, indestructibil, capabil să supraviețuiască chiar și unei explozii nucleare în imediata apropiere. Cu toate acestea, rațiunea (sper) a învins totuși și prioritățile s-au mutat treptat spre simplitate și compactitate.
Ar putea să fie așa încât să mă fi înșelat? Da, desigur. Este foarte posibil, de exemplu, să fi cumpărat un lot de cipuri de calitate slabă. Sau, din orice alt motiv, echipamentele să nu îndeplinească așteptările de fiabilitate.
Am un plan în acest caz? Cred că, după ce veți citi articolul, nu aveți îndoieli că există un plan. Și nu unul singur.
Dacă vorbim mai serios, formatul a fost dezvoltat simultan atât ca variantă funcțională, cât și ca „test”.
În prezent, totul funcționează normal pe birou, și în câteva zile soluția va fi implementată. (aproximativ) pe sute de dispozitive, haideți să vedem ce se va întâmpla în utilizarea „în luptă” (sper că formatul permite o detectare fiabilă a defecțiunilor; astfel, vom putea aduna statistici complete). În câteva luni, vom putea trasa concluzii (dacă nu avem noroc — atunci și mai devreme).
Dacă, în urma utilizării, vor apărea probleme serioase și vor fi necesare modificări, voi scrie cu siguranță despre acest lucru.
Literatură
Nu am vrut să fac o listă lungă și plictisitoare de lucrări utilizate, în fond, Google este la îndemână pentru toată lumea.
Aici am decis să păstrez o listă a descoperirilor care mi s-au părut deosebit de interesante, totuși, treptat acestea au fost integrate direct în textul articolului, iar în listă a rămas un singur punct:
- Utilitarul de la autorul zlib. Poate să afișeze, într-o formă clară, conținutul arhivelor deflate/zlib/gzip. Dacă trebuie să te familiarizezi cu structura internă a formatului deflate (sau gzip) — îți recomand cu căldură.
Sursa: habr.com
