

Articolul analizează mai multe moduri de determinare a ecuației matematice a unei linii de regresie simple (bivariat).
Toate metodele discutate aici pentru rezolvarea ecuației se bazează pe metoda celor mai mici pătrate. Să notăm metodele după cum urmează:
- Soluția analitică
- Declinarea gradientului
- Declinarea gradientului stocastic
Pentru fiecare dintre metodele de rezolvare a ecuației liniare, articolul oferă diferite funcții, care se împart în principal în cele care sunt scrise fără utilizarea bibliotecii NumPy și cele care folosesc NumPy. Se consideră că utilizarea abilă a NumPy va reduce costurile de calcul.
Tot codul prezentat în articol este scris în limbajul python 2.7 folosind Jupyter Notebook. Codul sursă și fișierul cu datele setului de date sunt disponibile pe
Articolul este destinat atât începătorilor, cât și celor care au început ușor să exploreze un domeniu vast al inteligenței artificiale — învățarea automată.
Pentru a ilustra materialul, vom folosi un exemplu foarte simplu.
Condițiile exemplului
Avem cinci valori, care caracterizează dependența Y de la X (Tabela nr. 1):
Tabela nr. 1 „Condițiile exemplului”
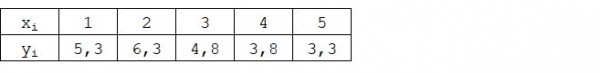
Să considerăm că valorile  reprezintă luna anului, iar
 reprezintă venitul din această lună. Cu alte cuvinte, venitul depinde de luna anului, iar
 reprezintă singurul atribut care afectează venitul.
Exemplul este destul de simplu, atât din perspectiva dependenței condiționate a venitului de luna anului, cât și din perspectiva numărului de valori — acestea sunt foarte puține. Totuși, această simplificare va permite, așa cum se spune, să explicați, nu întotdeauna cu ușurință, materialul care este adesea greu de digerat de începători. De asemenea, simplitatea numerelor va permite celor care doresc să rezolve exemplul „pe hârtie” fără eforturi semnificative.
Să presupunem că dependența prezentată în exemplu poate fi aproximată destul de bine printr-o ecuație matematică a unei linii de regresie simple (bivariate) de forma:

unde  — acesta este luna în care a fost realizat venitul,
 — venitul corespunzător lunii,
 și
 — coeficientii regresiei liniei estimate.
Să notăm că coeficientul  este adesea numit coeficient unghiular sau gradient al liniei estimate; reprezintă mărimea cu care se va schimba
 la o modificare
 .
Este evident că sarcina noastră în exemplu este de a alege coeficienții în ecuație  și
 , pentru care abaterile valorilor noastre calculate ale veniturilor pe luni de la răspunsurile reale, adică valorile prezentate în eșantion, vor fi minime.
Metoda celor mai mici pătrate
Conform metodei celor mai mici pătrate, abaterile trebuie calculate prin ridicarea la pătrat. Această abordare evită anularea reciprocă a abaterilor, în cazul în care acestea au semne opuse. De exemplu, dacă în cazul unuia, abaterea este +5 (plus cinci), iar în celălalt -5 (minus cinci), atunci suma abaterilor se va anula reciproc și va fi 0 (zero). Nu este necesar să ridicăm abaterea la pătrat, ci putem folosi proprietatea modulului și atunci toate abaterile vor fi pozitive și se vor acumula. Nu ne vom opri asupra acestui aspect în detaliu, ci vom menționa doar că, pentru comoditatea calculului, este obișnuit să ridicăm abaterea la pătrat.
Așa arată formula pe care o vom folosi pentru a determina cea mai mică sumă a pătratelor abaterilor (eroare):

unde  — aceasta este funcția de aproxiamare a răspunsurilor reale (adică venitul pe care l-am calculat),
 — acestea sunt răspunsurile reale (venitul furnizat în eșantion),
 — acesta este indexul eșantionului (numărul lunii în care are loc determinarea abaterii)
Vom deriva funcția, vom defini ecuațiile derivatelor parțiale și vom fi pregătiți să trecem la soluția analitică. Dar, pentru început, să facem o mică excursie despre ce este derivarea și să ne amintim sensul geometric al derivatelor.
Derivarea
Derivarea este operația de găsire a derivatei unei funcții.
De ce este necesară derivata? Derivata unei funcții caracterizează viteza de schimbare a funcției și ne indică direcția acesteia. Dacă derivata în punctul dat este pozitivă, atunci funcția crește; în caz contrar, funcția scade. Și cu cât valoarea derivatei este mai mare în modul, cu atât viteza de schimbare a valorilor funcției este mai mare, iar unghiul de înclinație al graficului funcției este mai abrupt.
De exemplu, în condițiile sistemului de coordonate cartezian, valoarea derivatei în punctul M(0,0), care este +25 indică faptul că, în punctul dat, prin deplasarea valorii  în dreapta cu o unitate convențională, valoarea
 crește cu 25 de unități convenționale. Pe grafic, acest lucru arată ca o pantă suficient de abruptă a valorilor.
 de la punctul dat.
Un alt exemplu. Valoarea derivatei egală -0,1 înseamnă că, la o deplasare  de o unitate convențională, valoarea
 scade doar cu 0,1 unitate convențională. În acest caz, pe graficul funcției, putem observa o ușoară înclinare descendentă. Comparând cu muntele, parcă coborâm foarte lent pe o panta ușoară, spre deosebire de exemplul anterior, unde trebuia să ne confruntăm cu vârfuri foarte abrupte.
Astfel, după efectuarea derivării funcției  după coeficienți,
 și
 vom determina ecuațiile derivatelor parțiale de ordinul întâi. După determinarea ecuațiilor, vom obține un sistem de două ecuații, rezolvând care vom putea găsi valorile coeficienților
 și
 , pentru care valorile derivatelor corespunzătoare în punctele date se modifică cu o valoare foarte, foarte mică, iar în cazul unei soluții analitice nu se schimbă deloc. Cu alte cuvinte, funcția de eroare la coeficienții găsiți va ajunge la minim, deoarece valorile derivatelor parțiale în aceste puncte vor fi egale cu zero.
Astfel, conform regulilor derivării, ecuația derivatei parțiale de ordinul întâi după coeficientul  va avea forma:

ecuația derivatei parțiale de ordinul întâi după  va avea forma:

În consecință, am obținut un sistem de ecuații care are o soluție analitică destul de simplă:
begin{equation*}
begin{cases}
na + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i = 0
sumlimits_{i=1}^nx_i(a +bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i) = 0
end{cases}
end{equation*}
Înainte de a rezolva ecuația, vom încărca, vom verifica corectitudinea încărcării și vom formata datele.
Încărcarea și formatarea datelor
Este important de menționat că, datorită faptului că pentru soluția analitică, iar ulterior pentru descendența gradientului și descendența stocastică a gradientului, vom utiliza codul în două variații: cu utilizarea bibliotecii NumPy și fără utilizarea acesteia, va fi necesară o formatare corespunzătoare a datelor (vezi codul).
Codul de încărcare și procesare a datelor
# импортируем все нужные нам библиотеки
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import math
import pylab as pl
import random

# графики отобразим в Jupyter
%matplotlib inline

# укажем размер графиков
from pylab import rcParams
rcParams['figure.figsize'] = 12, 6

# отключим предупреждения Anaconda
import warnings
warnings.simplefilter('ignore')

# загрузим значения
table_zero = pd.read_csv('data_example.txt', header=0, sep='t')

# посмотрим информацию о таблице и на саму таблицу
print table_zero.info()
print '********************************************'
print table_zero
print '********************************************'

# подготовим данные без использования NumPy

x_us = []
[x_us.append(float(i)) for i in table_zero['x']]
print x_us
print type(x_us)
print '********************************************'

y_us = []
[y_us.append(float(i)) for i in table_zero['y']]
print y_us
print type(y_us)
print '********************************************'

# подготовим данные с использованием NumPy

x_np = table_zero[['x']].values
print x_np
print type(x_np)
print x_np.shape
print '********************************************'

y_np = table_zero[['y']].values
print y_np
print type(y_np)
print y_np.shape
print '********************************************'
Vizualizare
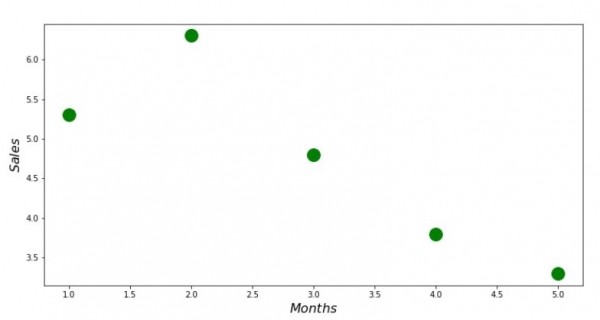
Acum, după ce, întâi, am încărcat datele, apoi am verificat corectitudinea încărcării și, în final, am formatat datele, vom efectua prima vizualizare. Adesea, pentru acest lucru se folosește metoda pairplot NanoGUI Seaborn. În exemplul nostru, din cauza limitării cifrelor, nu are sens să aplicăm biblioteca Seaborn. Vom folosi biblioteca obișnuită Matplotlib și ne vom uita doar la diagrama de dispersie.
Codul diagramei de dispersie
print 'Grafica nr. 1 "Dependența veniturilor de luna anului"'

plt.plot(x_us,y_us,'o',color='green',markersize=16)
plt.xlabel('$Months$', size=16)
plt.ylabel('$Sales$', size=16)
plt.show()
Grafica nr. 1 «Dependența veniturilor de luna anului»
Soluția analitică
Vom folosi cele mai obișnuite instrumente în python și vom rezolva sistemul de ecuații:
begin{equation*}
begin{cases}
na + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i = 0
sumlimits_{i=1}^nx_i(a +bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i) = 0
end{cases}
end{equation*}
După regula lui Cramer vom găsi determinatul general, precum și determinanții după  și după
 , după care, împărțind determinatul după
 la determinatul general — vom găsi coeficientul
 , în mod similar, vom găsi coeficientul
 .
Codul soluției analitice
# определим функцию для расчета коэффициентов a и b по правилу Крамера
def Kramer_method (x,y):
        # сумма значений (все месяца)
    sx = sum(x)
        # сумма истинных ответов (выручка за весь период)
    sy = sum(y)
        # сумма произведения значений на истинные ответы
    list_xy = []
    [list_xy.append(x[i]*y[i]) for i in range(len(x))]
    sxy = sum(list_xy)
        # сумма квадратов значений
    list_x_sq = []
    [list_x_sq.append(x[i]**2) for i in range(len(x))]
    sx_sq = sum(list_x_sq)
        # количество значений
    n = len(x)
        # общий определитель
    det = sx_sq*n - sx*sx
        # определитель по a
    det_a = sx_sq*sy - sx*sxy
        # искомый параметр a
    a = (det_a / det)
        # определитель по b
    det_b = sxy*n - sy*sx
        # искомый параметр b
    b = (det_b / det)
        # контрольные значения (прооверка)
    check1 = (n*b + a*sx - sy)
    check2 = (b*sx + a*sx_sq - sxy)
    return [round(a,4), round(b,4)]

# запустим функцию и запишем правильные ответы
ab_us = Kramer_method(x_us,y_us)
a_us = ab_us[0]
b_us = ab_us[1]
print ' 33[1m' + ' 33[4m' + "Оптимальные значения коэффициентов a и b:"  + ' 33[0m'
print 'a =', a_us
print 'b =', b_us
print

# определим функцию для подсчета суммы квадратов ошибок
def errors_sq_Kramer_method(answers,x,y):
    list_errors_sq = []
    for i in range(len(x)):
        err = (answers[0] + answers[1]*x[i] - y[i])**2
        list_errors_sq.append(err)
    return sum(list_errors_sq)

# запустим функцию и запишем значение ошибки
error_sq = errors_sq_Kramer_method(ab_us,x_us,y_us)
print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений" + ' 33[0m'
print error_sq
print

# замерим время расчета
# print ' 33[1m' + ' 33[4m' + "Время выполнения расчета суммы квадратов отклонений:" + ' 33[0m'
# % timeit error_sq = errors_sq_Kramer_method(ab,x_us,y_us)
Iată ce am obținut:
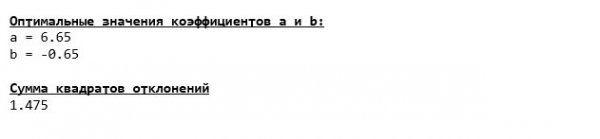
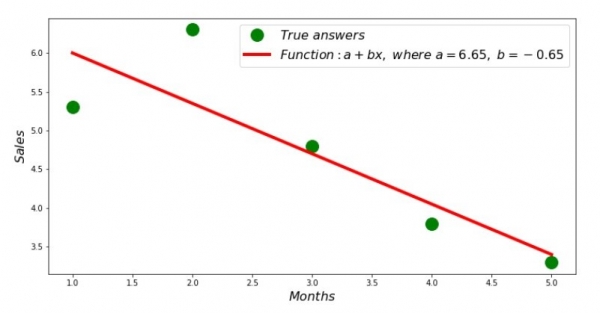
Astfel, valorile coeficientilor au fost găsite, suma pătratelor abaterilor a fost stabilită. Vom desena pe histograma de dispersie o linie conform coeficientilor găsiți.
Codul liniei de regresie
# определим функцию для формирования массива рассчетных значений выручки
def sales_count(ab,x,y):
    line_answers = []
    [line_answers.append(ab[0]+ab[1]*x[i]) for i in range(len(x))]
    return line_answers

# построим графики
print 'Грфик№2 "Правильные и расчетные ответы"'
plt.plot(x_us,y_us,'o',color='green',markersize=16, label = '$True$ $answers$')
plt.plot(x_us, sales_count(ab_us,x_us,y_us), color='red',lw=4,
         label='$Function: a + bx,$ $where$ $a='+str(round(ab_us[0],2))+',$ $b='+str(round(ab_us[1],2))+'$')
plt.xlabel('$Months$', size=16)
plt.ylabel('$Sales$', size=16)
plt.legend(loc=1, prop={'size': 16})
plt.show()
Grafica nr. 2 «Răspunsuri corecte și calculate»
Se poate privi graficul abaterilor pentru fiecare lună. În cazul nostru, nu vom extrage nicio valoare practică semnificativă, dar vom satisface curiozitatea cu privire la cât de bine caracterizează ecuația regresiei liniare simple dependența veniturilor de luna anului.
Codul graficului abaterilor
# определим функцию для формирования массива отклонений в процентах
def error_per_month(ab,x,y):
    sales_c = sales_count(ab,x,y)
    errors_percent = []
    for i in range(len(x)):
        errors_percent.append(100*(sales_c[i]-y[i])/y[i])
    return errors_percent

# построим график
print 'График№3 "Отклонения по-месячно, %"'
plt.gca().bar(x_us, error_per_month(ab_us,x_us,y_us), color='brown')
plt.xlabel('Months', size=16)
plt.ylabel('Calculation error, %', size=16)
plt.show()
Grafica nr. 3 «Abaterile, %»
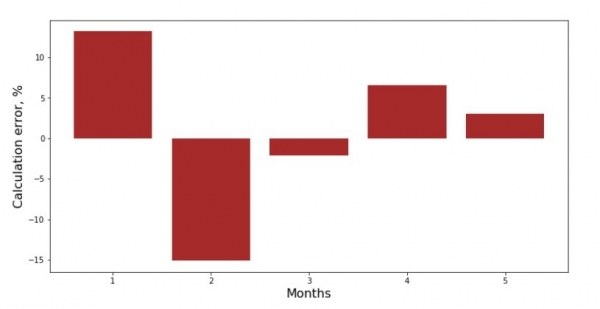
Nu e perfect, dar ne-am îndeplinit sarcina.
Vom scrie o funcție care pentru determinarea coeficientilor  și
 folosește biblioteca NumPy, mai exact — vom scrie două funcții: una cu utilizarea matricei pseudo-inverse (nu este recomandat în practică, deoarece procesul este computațional complex și instabil), cealaltă cu utilizarea ecuației matrice.
Codul soluției analitice (NumPy)
# для начала добавим столбец с не изменяющимся значением в 1.
# Данный столбец нужен для того, чтобы не обрабатывать отдельно коэффицент a
vector_1 = np.ones((x_np.shape[0],1))
x_np = table_zero[['x']].values # на всякий случай приведем в первичный формат вектор x_np
x_np = np.hstack((vector_1,x_np))

# проверим то, что все сделали правильно
print vector_1[0:3]
print x_np[0:3]
print '***************************************'
print

# напишем функцию, которая определяет значения коэффициентов a и b с использованием псевдообратной матрицы
def pseudoinverse_matrix(X, y):
    # задаем явный формат матрицы признаков
    X = np.matrix(X)
    # определяем транспонированную матрицу
    XT = X.T
    # определяем квадратную матрицу
    XTX = XT*X
    # определяем псевдообратную матрицу
    inv = np.linalg.pinv(XTX)
    # задаем явный формат матрицы ответов
    y = np.matrix(y)
    # находим вектор весов
    return (inv*XT)*y

# запустим функцию
ab_np = pseudoinverse_matrix(x_np, y_np)
print ab_np
print '***************************************'
print

# напишем функцию, которая использует для решения матричное уравнение
def matrix_equation(X,y):
    a = np.dot(X.T, X)
    b = np.dot(X.T, y)
    return np.linalg.solve(a, b)

# запустим функцию
ab_np = matrix_equation(x_np,y_np)
print ab_np
Să comparăm timpul necesar pentru determinarea coeficientilor  și
 , conform celor 3 metode prezentate.
Codul pentru calcularea timpului de calcule
print ' 33[1m' + ' 33[4m' + "Timpul de execuție al calculului coeficientilor fără utilizarea bibliotecii NumPy:" + ' 33[0m'
% timeit ab_us = Kramer_method(x_us,y_us)
print '***************************************'
print
print ' 33[1m' + ' 33[4m' + "Timpul de execuție al calculului coeficientilor cu utilizarea matricii pseudo-inverse:" + ' 33[0m'
%timeit ab_np = pseudoinverse_matrix(x_np, y_np)
print '***************************************'
print
print ' 33[1m' + ' 33[4m' + "Timpul de execuție al calculului coeficientilor cu utilizarea ecuației matriciale:" + ' 33[0m'
%timeit ab_np = matrix_equation(x_np, y_np)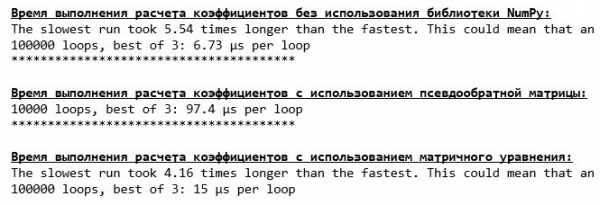
Pe un volum mic de date, funcția „personalizată” care găsește coeficientii prin metoda lui Kramer iese în evidență.
Acum putem trece la alte metode de găsire a coeficientilor.  și
 .
Declinarea gradientului
Mai întâi, să definim ce este un gradient. În termeni simpli, gradientul este un segment care indică direcția de creștere maximă a funcției. Analizând acest concept prin analogie cu un munte, direcția pe care o arată gradientul este cea mai abruptă urcare către vârful muntelui. Continuând cu exemplul muntelui, ne amintim că de fapt avem nevoie de cea mai abruptă coborâre pentru a ajunge cât mai repede la vale, adică minimul — locul în care funcția nu crește și nu scade. În acel loc, derivata va fi egală cu zero. Prin urmare, avem nevoie nu de gradient, ci de anti-gradient. Pentru a găsi anti-gradientul, trebuie doar să înmulțim gradientul cu -1 (minus unu).
Să observăm că funcția poate avea mai multe minime, iar dacă ajungem într-unul dintre ele conform algoritmului propus mai jos, nu vom putea găsi un alt minim care ar putea fi mai jos decât cel găsit. Să ne relaxăm, nu ne amenință asta! În cazul nostru, ne confruntăm cu un singur minim, deoarece funcția noastră  pe grafic reprezintă o parabolă obișnuită. Și, așa cum ar trebui să știm cu toții din cursul de matematică de liceu — o parabolă are un singur minim.
După ce am clarificat de ce avem nevoie de gradient, și faptul că gradientul este un segment, adică un vector cu coordonate date, care sunt exact coeficientii de care avem nevoie,  și
 putem implementa metoda de coborâre a gradientului.
Înainte de a începe, vă sugerez să citiți în linii mari câteva propoziții despre algoritmul de coborâre:
- Definim coordonatele coeficientilor în mod pseudo-aleator.
 și . În exemplul nostru, vom determina coeficienții în apropierea zero. Aceasta este o practică comună, totuși pentru fiecare caz poate fi prevăzută propria practică.
- De la coordonata scădem valoarea derivatelor parțiale de ordinul întâi în punctul . Așadar, dacă derivata este pozitivă, funcția crește. Prin urmare, scăzând valoarea derivatelor, ne vom deplasa în direcția opusă creșterii, adică spre coborâre. Dacă derivata este negativă, înseamnă că funcția scade în acel punct și scăzând valoarea derivatelor ne deplasăm spre coborâre.
- Executăm o operație similară cu coordonata : scăzând valoarea derivatelor parțiale în punctul .
- Pentru a nu sări peste minim și a nu zbura în spațiul cosmic, este necesar să stabilim mărimea pasului în direcția coborârii. În general, s-ar putea scrie un întreg articol despre cum să stabilim corect pasul și cum să-l schimbăm în timpul coborârii pentru a reduce costurile de calcul. Dar acum avem o sarcină puțin diferită, iar prin metoda științifică a „tușei” sau cum se spune în popor, pe cale empirie, vom stabili dimensiunea pasului.
- După ce am scăzut valorile derivatelor din coordonatele date și obținem noi coordonate și . Facem următorul pas (scădere), deja din coordonatele calculate. Și astfel ciclul se repete din nou și din nou, până când se atinge convergența dorită.
 și
 . În exemplul nostru, vom determina coeficienții în apropierea zero. Aceasta este o practică comună, totuși pentru fiecare caz poate fi prevăzută propria practică.
 scădem valoarea derivatelor parțiale de ordinul întâi în punctul
 . Așadar, dacă derivata este pozitivă, funcția crește. Prin urmare, scăzând valoarea derivatelor, ne vom deplasa în direcția opusă creșterii, adică spre coborâre. Dacă derivata este negativă, înseamnă că funcția scade în acel punct și scăzând valoarea derivatelor ne deplasăm spre coborâre.
 : scăzând valoarea derivatelor parțiale în punctul
 .
 și
 obținem noi coordonate
 și
 . Facem următorul pas (scădere), deja din coordonatele calculate. Și astfel ciclul se repete din nou și din nou, până când se atinge convergența dorită.
Totul! Acum suntem pregătiți să plecăm în căutarea celui mai adânc canion al Grohotei Marianelor. Să începem.
Cod pentru coborârea gradientului
# напишем функцию градиентного спуска без использования библиотеки NumPy.
# Функция на вход принимает диапазоны значений x,y, длину шага (по умолчанию=0,1), допустимую погрешность(tolerance)
def gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001):
    # сумма значений (все месяца)
    sx = sum(x_us)
    # сумма истинных ответов (выручка за весь период)
    sy = sum(y_us)
    # сумма произведения значений на истинные ответы
    list_xy = []
    [list_xy.append(x_us[i]*y_us[i]) for i in range(len(x_us))]
    sxy = sum(list_xy)
    # сумма квадратов значений
    list_x_sq = []
    [list_x_sq.append(x_us[i]**2) for i in range(len(x_us))]
    sx_sq = sum(list_x_sq)
    # количество значений
    num = len(x_us)
    # начальные значения коэффициентов, определенные псевдослучайным образом
    a = float(random.uniform(-0.5, 0.5))
    b = float(random.uniform(-0.5, 0.5))
    # создаем массив с ошибками, для старта используем значения 1 и 0
    # после завершения спуска стартовые значения удалим
    errors = [1,0]
    # запускаем цикл спуска
    # цикл работает до тех пор, пока отклонение последней ошибки суммы квадратов от предыдущей, не будет меньше tolerance
    while abs(errors[-1]-errors[-2]) > tolerance:
        a_step = a - l*(num*a + b*sx - sy)/num
        b_step = b - l*(a*sx + b*sx_sq - sxy)/num
        a = a_step
        b = b_step
        ab = [a,b]
        errors.append(errors_sq_Kramer_method(ab,x_us,y_us))
    return (ab),(errors[2:])

# запишем массив значений
list_parametres_gradient_descence = gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001)


print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_gradient_descence[0][0],3)
print 'b =', round(list_parametres_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в градиентном спуске:" + ' 33[0m'
print len(list_parametres_gradient_descence[1])
print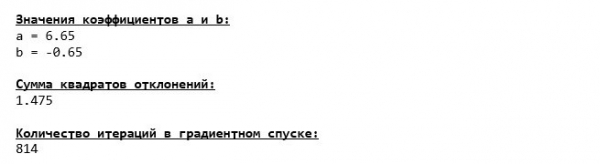
Am ajuns la fundul Grohotei Marianelor și acolo am descoperit aceleași valori ale coeficienților  și
 , ceea ce, de fapt, era de așteptat.
Vom face o nouă scufundare, dar de data aceasta, conținutul aparatului nostru subacvatic va folosi alte tehnologii, și anume biblioteca NumPy.
Cod pentru coborârea gradientului (NumPy)
# перед тем определить функцию для градиентного спуска с использованием библиотеки NumPy,
# напишем функцию определения суммы квадратов отклонений также с использованием NumPy
def error_square_numpy(ab,x_np,y_np):
    y_pred = np.dot(x_np,ab)
    error = y_pred - y_np
    return sum((error)**2)

# напишем функцию градиентного спуска с использованием библиотеки NumPy.
# Функция на вход принимает диапазоны значений x,y, длину шага (по умолчанию=0,1), допустимую погрешность(tolerance)
def gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001):
    # сумма значений (все месяца)
    sx = float(sum(x_np[:,1]))
    # сумма истинных ответов (выручка за весь период)
    sy = float(sum(y_np))
    # сумма произведения значений на истинные ответы
    sxy = x_np*y_np
    sxy = float(sum(sxy[:,1]))
    # сумма квадратов значений
    sx_sq = float(sum(x_np[:,1]**2))
    # количество значений
    num = float(x_np.shape[0])
    # начальные значения коэффициентов, определенные псевдослучайным образом
    a = float(random.uniform(-0.5, 0.5))
    b = float(random.uniform(-0.5, 0.5))
    # создаем массив с ошибками, для старта используем значения 1 и 0
    # после завершения спуска стартовые значения удалим
    errors = [1,0]
    # запускаем цикл спуска
    # цикл работает до тех пор, пока отклонение последней ошибки суммы квадратов от предыдущей, не будет меньше tolerance
    while abs(errors[-1]-errors[-2]) > tolerance:
        a_step = a - l*(num*a + b*sx - sy)/num
        b_step = b - l*(a*sx + b*sx_sq - sxy)/num
        a = a_step
        b = b_step
        ab = np.array([[a],[b]])
        errors.append(error_square_numpy(ab,x_np,y_np))
    return (ab),(errors[2:])

# запишем массив значений
list_parametres_gradient_descence = gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_gradient_descence[0][0],3)
print 'b =', round(list_parametres_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_gradient_descence[1][-1],3)
print

print ' 33[1m' + ' 33[4m' + "Количество итераций в градиентном спуске:" + ' 33[0m'
print len(list_parametres_gradient_descence[1])
print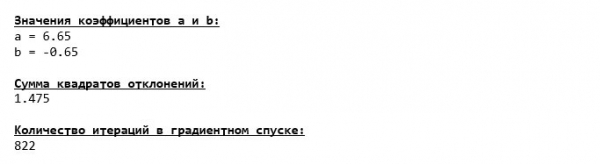
Valorile coeficienților  și
 sunt neschimbate.
Să ne uităm la modul în care a variat eroarea în timpul coborârii gradientului, adică cum a variat suma pătratelor abaterilor cu fiecare pas.
Cod pentru graficul sumelor pătratelor abaterilor
print 'Grafic№4 "Suma pătratelor abaterilor pe pași"'
plt.plot(range(len(list_parametres_gradient_descence[1])), list_parametres_gradient_descence[1], color='red', lw=3)
plt.xlabel('Pași (Iterație)', size=16)
plt.ylabel('Suma pătratelor abaterilor', size=16)
plt.show()
Grafic nr. 4 „Suma pătratelor abaterilor în timpul scăderii gradientului”
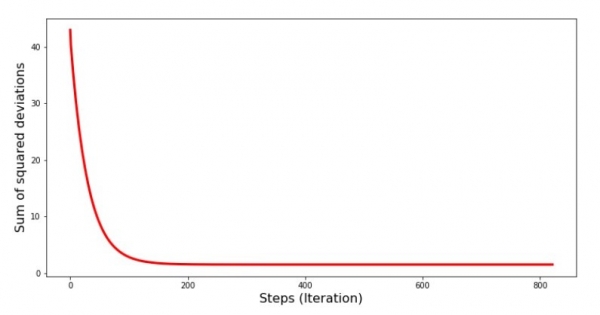
În grafic, vedem că, cu fiecare pas, eroarea scade, iar după un anumit număr de iterații observăm practic o linie orizontală.
În final, să evaluăm diferența de timp de execuție a codului:
Cod pentru a determina timpul de calcul al scăderii gradientului
print ' 33[1m' + ' 33[4m' + "Timpul de execuție al scăderii gradientului fără utilizarea bibliotecii NumPy:" + ' 33[0m'
%timeit list_parametres_gradient_descence = gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001)
print '***************************************'
print

print ' 33[1m' + ' 33[4m' + "Timpul de execuție al scăderii gradientului cu utilizarea bibliotecii NumPy:" + ' 33[0m'
%timeit list_parametres_gradient_descence = gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001)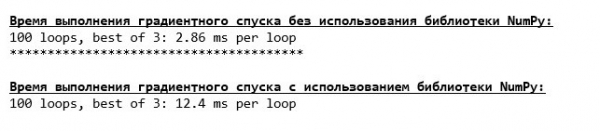
Poate că facem ceva greșit, dar iarăși, o simplă funcție „scrisă de mână” care nu folosește biblioteca NumPy o depășește în timp de execuție pe funcția care utilizează biblioteca NumPy.
Dar nu stăm pe loc, ci ne îndreptăm spre studierea unei alte modalități fascinante de a rezolva ecuația regresiei liniare simple. Întâmpinați!
Declinarea gradientului stocastic
Pentru a înțelege mai bine principiul funcționării scăderii gradientului stohastic, este mai bine să-i determinăm diferențele față de scăderea gradientului obișnuit. În cazul scăderii gradientului, în ecuațiile derivative de  și
 am folosit sumele valorilor tuturor caracteristicilor și răspunsurilor adevărate disponibile în eșantion (adică sumele tuturor
 și
 ). În scăderea gradientului stohastic nu vom folosi toate valorile disponibile în eșantion, ci în schimb, vom alege aleatoriu, printr-un index de eșantion, valorile acestuia.
De exemplu, dacă indexul a fost determinat ca fiind numărul 3 (trei), atunci luăm valorile  și
 , apoi le înlocuim în ecuațiile derivate și determinăm noile coordonate. Apoi, având coordonatele, din nou alegem aleatoriu indexul eșantionului, înlocuim valorile corespunzătoare indexului în ecuațiile derivate parțiale, redefinim coordonatele
 și
 și așa mai departe până la convergență. La prima vedere, s-ar putea părea că cum poate funcționa asta, totuși, funcționează. E adevărat că nu cu fiecare pas eroarea scade, dar tendința este cu siguranță prezentă.
Care sunt avantajele algoritmului de optimizare prin gradient stocastic în comparație cu cel obișnuit? În cazul în care dimensiunea eșantionului este foarte mare, ajungând la zeci de mii de valori, este mult mai simplu să procesăm, să spunem, o mie aleatoare dintre ele, decât întregul eșantion. Aici intervine algoritmul de optimizare prin gradient stocastic. În cazul nostru, desigur, nu vom observa o mare diferență.
Să ne uităm la cod.
Cod pentru optimizarea prin gradient stocastic
# определим функцию стох.град.шага
def stoch_grad_step_usual(vector_init, x_us, ind, y_us, l):
#     выбираем значение икс, которое соответствует случайному значению параметра ind
# (см.ф-цию stoch_grad_descent_usual)
    x = x_us[ind]
#     рассчитывыаем значение y (выручку), которая соответствует выбранному значению x
    y_pred = vector_init[0] + vector_init[1]*x_us[ind]
#     вычисляем ошибку расчетной выручки относительно представленной в выборке
    error = y_pred - y_us[ind]
#     определяем первую координату градиента ab
    grad_a = error
#     определяем вторую координату ab
    grad_b = x_us[ind]*error
#     вычисляем новый вектор коэффициентов
    vector_new = [vector_init[0]-l*grad_a, vector_init[1]-l*grad_b]
    return vector_new


# определим функцию стох.град.спуска
def stoch_grad_descent_usual(x_us, y_us, l=0.1, steps = 800):
#     для самого начала работы функции зададим начальные значения коэффициентов
    vector_init = [float(random.uniform(-0.5, 0.5)), float(random.uniform(-0.5, 0.5))]
    errors = []
#     запустим цикл спуска
# цикл расчитан на определенное количество шагов (steps)
    for i in range(steps):
        ind = random.choice(range(len(x_us)))
        new_vector = stoch_grad_step_usual(vector_init, x_us, ind, y_us, l)
        vector_init = new_vector
        errors.append(errors_sq_Kramer_method(vector_init,x_us,y_us))
    return (vector_init),(errors)


# запишем массив значений
list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.1, steps = 800)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print

print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])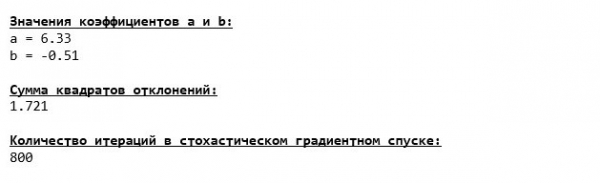
Privind cu atenție coeficienții, ne surprindem întrebându-ne „Cum așa?”. Am obținut alte valori ale coeficientilor.  și
 . Poate algoritmul de optimizare prin gradient stocastic a găsit parametrii mai optimi pentru ecuație? Din păcate, nu. Este suficient să ne uităm la suma pătratelor abaterilor pentru a observa că, având noi valori ale coeficientilor, eroarea a crescut. Să nu ne grăbim să ne descurajăm. Să construim un grafic al variației erorii.
Cod pentru graficul sumei pătratelor abaterilor în optimizarea prin gradient stocastic
print 'Grafic nr. 5 "Suma pătratelor abaterilor pas cu pas"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1])), list_parametres_stoch_gradient_descence[1], color='red', lw=2)
plt.xlabel('Pași (Iterație)', size=16)
plt.ylabel('Suma pătratelor abaterilor', size=16)
plt.show()
Grafic nr. 5 „Suma pătratelor abaterilor în optimizarea prin gradient stocastic”
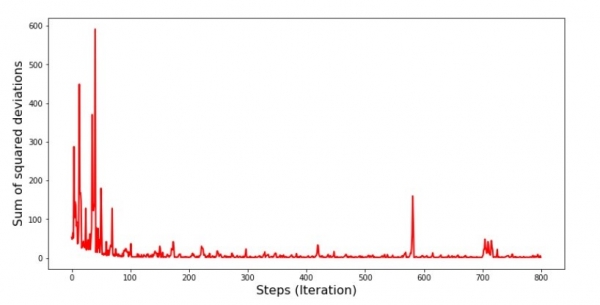
După ce am privit graficul, totul își găsește locul și acum vom corecta totul.
Așadar, ce s-a întâmplat? S-a întâmplat următorul lucru. Atunci când alegem aleator un anumit lună, algoritmul nostru își propune să reducă eroarea în calculul veniturilor pentru luna aleasă. Apoi alegem o altă lună și repetăm calculul, dar acum reducem eroarea pentru a doua lună aleasă. Și acum să ne amintim că primele două luni se abat semnificativ de la linia ecuației regresiei liniare simple. Asta înseamnă că, atunci când se alege oricare dintre aceste două luni, reducând eroarea fiecăreia, algoritmul nostru crește semnificativ eroarea pe întregul eșantion. Ce este de făcut? Răspunsul este simplu: trebuie să micșorăm pasul de optimizare. Cu cât micșorăm pasul de optimizare, cu atât eroarea nu va mai „sări” atât de mult în sus și în jos. Mai precis, eroarea nu va înceta să „sară”, dar o va face într-un mod mai controlat :) Să verificăm.
Cod pentru pornirea SGD cu un pas mai mic
# запустим функцию, уменьшив шаг в 100 раз и увеличив количество шагов соответсвующе
list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.001, steps = 80000)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])

print 'График №6 "Сумма квадратов отклонений по-шагово"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1])), list_parametres_stoch_gradient_descence[1], color='red', lw=2)
plt.xlabel('Steps (Iteration)', size=16)
plt.ylabel('Sum of squared deviations', size=16)
plt.show()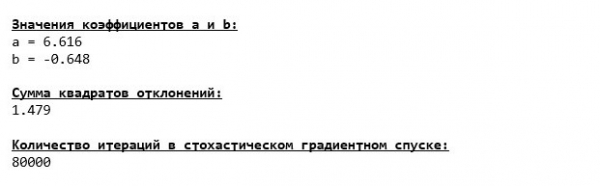
Grafic nr. 6 „Suma pătratelor abaterilor în optimizarea prin gradient stocastic (80 de mii pași)”
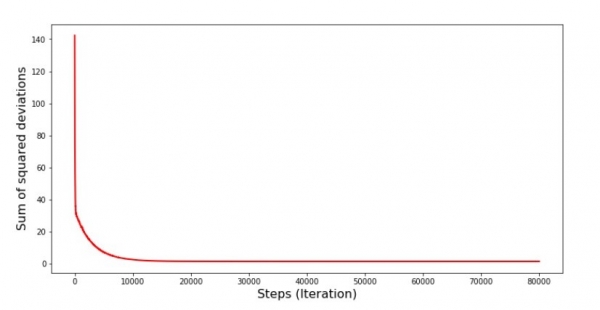
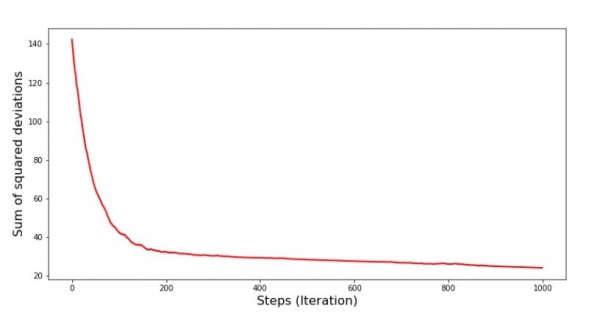
Valorile coeficientului s-au îmbunătățit, dar nu sunt încă ideale. Teoretic, aceasta poate fi corectată astfel. Să alegem, de exemplu, valorile coeficientului din ultimele 1000 de iterații, cu care s-a comis cea mai mică eroare. Adevărul este că va trebui să înregistrăm și valorile coeficientilor. Nu vom face asta, ci mai bine ne vom concentra asupra graficului. Acesta arată uniform, iar eroarea pare să scadă constant. De fapt, nu este așa. Să ne uităm la primele 1000 de iterații și să le comparăm cu cele finale.
Cod pentru graficul SGD (primele 1000 de pași)
print 'Grafic nr. 7 "Suma pătratelor abaterilor pas cu pas. Primele 1000 de iterații"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1][:1000])),
         list_parametres_stoch_gradient_descence[1][:1000], color='red', lw=2)
plt.xlabel('Pași (Iterație)', size=16)
plt.ylabel('Suma pătratelor abaterilor', size=16)
plt.show()

print 'Grafic nr. 7 "Suma pătratelor abaterilor pas cu pas. Ultimele 1000 de iterații"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1][-1000:])),
         list_parametres_stoch_gradient_descence[1][-1000:], color='red', lw=2)
plt.xlabel('Pași (Iterație)', size=16)
plt.ylabel('Suma pătratelor abaterilor', size=16)
plt.show()
Grafic nr. 7 «Suma pătratelor abaterilor SGD (primele 1000 de pași)»
Grafic nr. 8 «Suma pătratelor abaterilor SGD (ultimele 1000 de pași)»
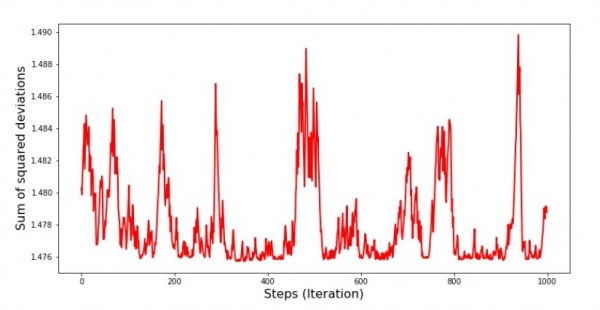
La începutul descenderii observăm o scădere relativ uniformă și abruptă a erorii. În ultimele iterații vedem că eroarea oscilează în jurul valorii de 1,475 și în anumite momente chiar atinge această valoare optimă, dar apoi, din nou, crește... Repet, putem înregistra valorile coeficientului  și
 , apoi să alegem acelea pentru care eroarea este minimă. Totuși, o problemă mai serioasă a apărut: a trebuit să facem 80 de mii de pași (vezi codul) pentru a obține valori apropiate de cele optime. Iar asta contrazice deja ideea de economisire a timpului de calcul în cadrul descentei gradientale stocastice în comparație cu cea gradient. Ce putem corecta și îmbunătăți? Nu este greu de observat că în primele iterații ne îndreptăm în jos cu încredere și, prin urmare, ar trebui să păstrăm un pas mare în primele iterații și, pe măsură ce avansăm, să reducem pasul. Nu vom face asta în acest articol — oricum s-a întins destul. Cei dornici pot să se gândească singuri la cum să facă asta, nu este complicat 🙂
Acum să efectuăm descendența gradientului stocastic, folosind biblioteca NumPy (și nu ne vom împiedica de pietrele pe care le-am identificat anterior)
Cod pentru descendentul stochastican al gradientului (NumPy)
# для начала напишем функцию градиентного шага
def stoch_grad_step_numpy(vector_init, X, ind, y, l):
    x = X[ind]
    y_pred = np.dot(x,vector_init)
    err = y_pred - y[ind]
    grad_a = err
    grad_b = x[1]*err
    return vector_init - l*np.array([grad_a, grad_b])

# определим функцию стохастического градиентного спуска
def stoch_grad_descent_numpy(X, y, l=0.1, steps = 800):
    vector_init = np.array([[np.random.randint(X.shape[0])], [np.random.randint(X.shape[0])]])
    errors = []
    for i in range(steps):
        ind = np.random.randint(X.shape[0])
        new_vector = stoch_grad_step_numpy(vector_init, X, ind, y, l)
        vector_init = new_vector
        errors.append(error_square_numpy(vector_init,X,y))
    return (vector_init), (errors)

# запишем массив значений
list_parametres_stoch_gradient_descence = stoch_grad_descent_numpy(x_np, y_np, l=0.001, steps = 80000)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])
print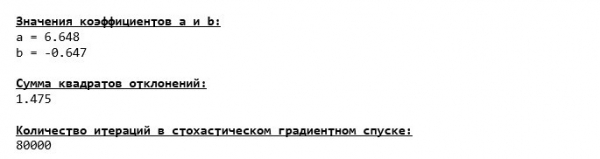
Valorile obținute au fost aproape identice cu cele obținute fără utilizarea NumPy. Totuși, acest lucru este logic.
Să aflăm cât de mult timp ne-au luat descendenții stochastici ai gradientului.
Cod pentru determinarea timpului de calcul pentru SGD (80.000 de pași)
print ' 33[1m' + ' 33[4m' +
"Timpul de execuție al descendentului stochastican al gradientului fără utilizarea bibliotecii NumPy:"
+ ' 33[0m'
%timeit list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.001, steps = 80000)
print '***************************************'
print

print ' 33[1m' + ' 33[4m' +
"Timpul de execuție al descendentului stochastican al gradientului cu utilizarea bibliotecii NumPy:"
+ ' 33[0m'
%timeit list_parametres_stoch_gradient_descence = stoch_grad_descent_numpy(x_np, y_np, l=0.001, steps = 80000)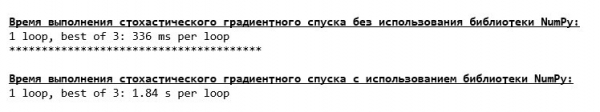
Cu cât ne îndepărtăm mai mult în pădure, cu atât norii devin mai întunecați: din nou, formula „scrisă de mână” arată cele mai bune rezultate. Toate acestea ne fac să reflectăm asupra faptului că ar trebui să existe și modalități mai subtile de a utiliza biblioteca NumPy, care chiar accelerează operațiunile de calcul. În acest articol, nu vom afla despre ele. Va fi ceva la ce să ne gândim în timpul nostru liber:)
Să rezumăm
Înainte de a rezuma, aș dori să răspund la o întrebare care probabil a apărut în mintea cititorului nostru drag. De ce, totuși, aceste „chinuri” cu descendenții, de ce trebuie să urcăm pe munte în sus și în jos (preponderent în jos) pentru a găsi valea dorită, dacă în mâinile noastre avem un instrument atât de puternic și simplu, sub forma unei soluții analitice, care ne teleportă instantaneu în locul dorit?
Răspunsul la această întrebare este evident. Acum am discutat un exemplu foarte simplu, în care răspunsul adevărat  depinde de o singură caracteristică
 . În viață, întâlnești rar așa ceva, așa că să presupunem că avem 2, 30, 50 sau mai multe caracteristici. Să adăugăm la asta mii, poate chiar zeci de mii de valori pentru fiecare caracteristică. În acest caz, soluția analitică poate să nu reziste provocării și să eșueze. În schimb, descendentul gradientului și variațiile sale ne vor apropia încet, dar sigur, de obiectiv — minimul funcției. Și în ceea ce privește viteza, nu vă faceți griji — cu siguranță vom analiza din nou modalități care ne vor permite să stabilim și să reglementăm lungimea pasului (adică viteza).
Și acum, un rezumat scurt.
În primul rând, sper că materialul prezentat în articol va ajuta începătorii „data scientists” să înțeleagă cum să rezolve ecuațiile regresiei liniare simple (și nu numai).
În al doilea rând, am examinat câteva metode de rezolvare a ecuației. Acum, în funcție de situație, putem alege varianta care se potrivește cel mai bine pentru a rezolva problema propusă.
În al treilea rând, am văzut puterea setărilor suplimentare, și anume, lungimea pasului în algoritmul gradient descent. Acest parametru nu poate fi neglijat. Așa cum s-a menționat mai sus, pentru a reduce costurile de calcul, lungimea pasului ar trebui ajustată pe parcursul algoritmului.
În al patrulea rând, în cazul nostru, funcțiile „scrise de mână” au demonstrat cele mai bune rezultate de timp în evaluări. Probabil că acest lucru se datorează utilizării nu tocmai profesionale a capacităților bibliotecii. NumPy. Dar, oricum, concluzia care se impune este următoarea. Pe de o parte, uneori ar trebui să contestăm opiniile bine stabilite, iar pe de altă parte — nu întotdeauna este necesar să complicăm lucrurile — din contră, uneori o soluție mai simplă se dovedește a fi mai eficientă. Și, având în vedere că obiectivul nostru a fost să discutăm trei abordări în rezolvarea ecuației regresiei liniare simple, utilizarea funcțiilor „scrise de mână” ne-a fost suficientă.
Literatură (sau ceva de genul acesta)
1. Regresie liniară
2. Metoda celor mai mici pătrate
3. Derivată
4. Gradient
5. Gradient descent
6. Biblioteca NumPy
Sursa: habr.com
