

Fiți atenți la operațiile care aduc bufferi...
Pe un exemplu de interogare mică, vom analiza unele abordări universale pentru optimizarea interogărilor în PostgreSQL. Fie că le utilizați sau nu - alegerea vă aparține, dar ar trebui să fiți conștienți de ele.
În versiunile ulterioare ale PG, situația ar putea să se schimbe cu "inteligența" planificatorului, dar pentru 9.4/9.6 arată aproximativ la fel ca exemplele de aici.
Voi lua o interogare complet reală:
SELECT
  TRUE
FROM
  "Document" d
INNER JOIN
  "DocumentExtensia" doc_ex
    USING("@Document")
INNER JOIN
  "TipDocument" t_doc ON
    t_doc."@TipDocument" = d."TipDocument"
WHERE
  (d."Persoana3" = 19091 or d."Angajat" = 19091) AND
  d."$Ciornă" IS NULL AND
  d."Șters" IS NOT TRUE AND
  doc_ex."Stare"[1] IS TRUE AND
  t_doc."TipDocument" = 'PlanActivitate'
LIMIT 1;
despre numele tabelor și câmpurilorLa numele „rusesti” ale câmpurilor și tabelelor se poate privi diferit, dar asta este o chestiune de gust. Având în vedere că iar PostgreSQL ne permite să folosim nume chiar și cu hieroglife, dacă ele sunt între ghilimele, preferăm să numim obiectele într-un mod clar, astfel încât să nu apară ambiguități.
Să ne uităm la planul obținut:
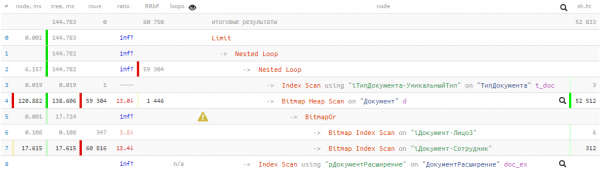
144ms și aproape 53K bufferi — adică mai mult de 400MB de date! Și ne va fi bine dacă toate acestea se află în cache la momentul interogării noastre, altfel va deveni de câteva ori mai lung la citirea de pe disc.
Algoritmul este cel mai important!
Pentru a optimiza orice interogare, trebuie mai întâi să înțelegem ce ar trebui să facă de fapt.
Vor lăsa proiectarea structurii Bazei de Date deoparte pentru această articol și vom conveni că putem scrie relativ "ieftin" interogarea și/sau să aplicăm bazei anumite indexuri.
Așadar, interogarea:
— verifică existența unui document,
— într-o stare necesară și de un tip specific,
— unde autorul sau executantul este angajatul dorit
JOIN + LIMIT 1
Destul de des, dezvoltatorului îi este mai ușor să scrie o interogare în care se face întâi o conexiune a unui număr mare de tabele, iar apoi din toată această mulțime rămâne o singură înregistrare. Dar mai ușor pentru dezvoltator nu înseamnă mai eficient pentru Baza de Date.
În cazul nostru, tabelele au fost doar 3 — iar efectul...
Să ne eliberăm mai întâi de conexiunea cu tabela "TipDocument" și, în același timp, să sugerăm bazei că înregistrarea tipului nostru este unică (noi știm asta, dar planificatorul nu bănuiește încă):
WITH T AS (
  SELECT
    "@TipDocument"
  FROM
    "TipDocument"
  WHERE
    "TipDocument" = 'PlanActivitate'
  LIMIT 1
)
...
WHERE
  d."TipDocument" = (TABLE T)
...
Da, dacă tabela/CTE constă dintr-un singur câmp al unei singure înregistrări, atunci în PG se poate scrie chiar așa, în loc de
d."TipDocument" = (SELECT "@TipDocument" FROM T LIMIT 1)"Calculări leneșe" în interogările PostgreSQL
BitmapOr vs UNION
În unele cazuri, Bitmap Heap Scan ne va costa foarte mult — de exemplu, în situația noastră, când un număr considerabil de înregistrări se încadrează în condiția cerută. L-am obținut din condiția OR, care s-a transformat în BitmapOr-operațiune în plan.
Să ne întoarcem la sarcina inițială — trebuie să găsim înregistrarea care corespunde oricărei dintre condiții — adică nu este nevoie să căutăm toate cele 59K înregistrări pe ambele condiții. Există o modalitate de a gestiona o condiție, iar la a doua să trecem doar când nu s-a găsit nimic pe prima. Ne va ajuta o astfel de structură:
(
  SELECT
    ...
  LIMIT 1
)
UNION ALL
(
  SELECT
    ...
  LIMIT 1
)
LIMIT 1
«Limita externă» 1 garantează că căutarea se va încheia la prima înregistrare găsită. Și dacă aceasta este găsită deja în primul bloc, execuția celui de-al doilea nu va avea loc (never executed în plan).
«Ascundem sub CASE» condiții complexe
În interogarea inițială există un moment extrem de incomod — verificarea stării pe tabelul asociat «DocumentExtensie». Indiferent de adevărul celorlalte condiții din expresie (de exemplu, d.«Șters» IS NOT TRUE), această asociere se execută întotdeauna și „înghite resurse”. Mai mult sau mai puțin va fi consumat — depinde de volumul acestui tabel.
Dar putem modifica interogarea astfel încât căutarea înregistrării asociate să aibă loc doar când este cu adevărat necesar:
SELECT
  ...
FROM
  "Document" d
WHERE
  ...
/*index cond*/ AND
  CASE
    WHEN "$Ciornă" IS NULL AND "Șters" IS NOT TRUE THEN (
      SELECT
        "Stare"[1] IS TRUE
      FROM
        "DocumentExtensie"
      WHERE
        "@Document" = d."@Document"
    )
  END
Deoarece din tabelul asociat nu avem nevoie de niciunul dintre câmpuri , avem posibilitatea să transformăm JOIN-ul într-o condiție de subinterogare.Vom lăsa câmpurile indexabile „în afara parantezelor” CASE, iar condițiile simple din înregistrare le introducem în blocul WHEN — și acum interogarea „greu” va fi executată doar atunci când trecem în THEN.
Numele meu este „Total”
Colectăm interogarea rezultantă cu toate mecanismele descrise mai sus:
Formăm cererea rezultantă folosind toate mecanismele descrise mai sus:
CU T CA (
  SELECT
    "@TipDocument"
  FROM
    "TipDocument"
  WHERE
    "TipDocument" = 'PlanLucrari'
)
  (
    SELECT
      TRUE
    FROM
      "Document" d
    WHERE
      ("Persoana3", "TipDocument") = (19091, (TABLE T)) AND
      CASE
        WHEN "$Ciorna" IS NULL AND "Sters" IS NOT TRUE THEN (
          SELECT
            "Stare"[1] IS TRUE
          FROM
            "DocumentExtensie"
          WHERE
            "@Document" = d."@Document"
        )
      END
    LIMIT 1
  )
UNION ALL
  (
    SELECT
      TRUE
    FROM
      "Document" d
    WHERE
      ("TipDocument", "Angajat") = ((TABLE T), 19091) AND
      CASE
        WHEN "$Ciorna" IS NULL AND "Sters" IS NOT TRUE THEN (
          SELECT
            "Stare"[1] IS TRUE
          FROM
            "DocumentExtensie"
          WHERE
            "@Document" = d."@Document"
        )
      END
    LIMIT 1
  )
LIMIT 1;
Adaptăm [pentru] indecși
Un ochi experimentat a observat că condițiile indexate în sub-blocurile UNION diferă ușor — asta pentru că avem deja indecși potriviți pe tabelă. Dar dacă nu ar fi existat — ar fi fost bine să-i creăm: Document(Persoana3, TipDocument) și Document(TipDocument, Angajat).
despre ordinea câmpurilor în condițiile ROWDin perspectiva planificatorului, desigur, se poate scrie și (A, B) = (constA, constB), și (B, A) = (constB, constA). Dar la scrierea în ordinea câmpurilor din index, această întrebare este pur și simplu mai ușor de depanat ulterior.
Ce planuri avem?
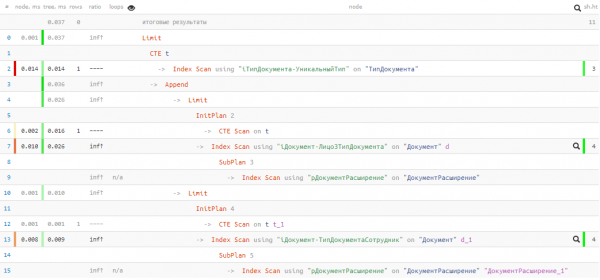
Din păcate, nu ne-a fost norocul de partea noastră, iar în primul bloc UNION nu s-a găsit nimic, așa că al doilea totuși a fost executat. Dar chiar și în acest caz — doar 0.037ms și 11 bufere!
Am accelerat interogarea și am redus "procesarea" datelor în memorie de câteva mii de ori, folosind metode suficient de simple — un rezultat bun pentru puțin copy-paste. 🙂
Sursa: habr.com
