

Acest articol este al doilea dintr-o serie despre comprimarea rapidă a datelor. În primul articol a fost descris un compresor care funcționează cu o viteză de 10GB/s pe un singur nucleu de procesor (compresie minimă, RTT-Min).
Acest compresor a fost implementat deja în echipamentele duplicatorilor criminalistici pentru comprimarea rapidă a dump-urilor de medii informaționale și pentru întărirea rezistenței criptografiei; de asemenea, poate fi utilizat pentru comprimarea imaginilor virtuale și a fișierelor swap din memoria RAM atunci când sunt salvate pe unități SSD de mare viteză.
În primul articol a fost, de asemenea, anunțată dezvoltarea unui algoritm de compresie pentru comprimarea backup-urilor HDD și SSD (compresie medie, RTT-Mid) cu parametrii de comprimare semnificativ îmbunătățiți. Până acum, acest compresor este complet gata și acest articol este dedicat lui.
Compresorul care implementează algoritmul RTT-Mid asigură un nivel de comprimare comparabil cu cel al arhivatorilor standard precum WinRar, 7-Zip, care funcționează în mod rapid. În același timp, viteza sa de lucru este cu cel puțin un ordin de mărime mai mare.
Viteza de comprimare/decoperire a datelor este un parametru critic care determină domeniul de aplicare al tehnologiilor de compresie. Este puțin probabil ca cineva să se gândească să comprime un terabyte de date cu o viteză de 10-15 MegaBiti pe secundă (acesta este viteza arhivatorilor în modul standard de compresie), deoarece ar dura aproape douăzeci de ore cu procesorul complet încărcat...
Pe de altă parte, același terabyte poate fi copiat cu viteze de aproximativ 2-3 GigaBiti pe secundă în aproximativ zece minute.
Prin urmare, comprimarea informațiilor de mare volum este relevantă dacă se realizează cu o viteză de cel puțin viteza reală de intrare/ieșire. Pentru sistemele moderne, aceasta nu este mai mică de 100 MegaBiti pe secundă.
Aceste viteze pot fi obținute de compresoare moderne doar în modul „rapid”. Tocmai în acest mod relevant vom compara algoritmul RTT-Mid cu compresoarele tradiționale.
Testarea comparativă a noului algoritm de compresie
Compresorul RTT-Mid a funcționat în cadrul unui program de testare. Într-o aplicație „reală” de lucru, acesta funcționează semnificativ mai repede, utilizând corect multi-threading-ul și aplicând un compilator „normal”, nu C#.
Deoarece compresoarele utilizate în testul comparativ sunt construite pe principii diferite și diferite tipuri de date comprimă diferit, pentru obiectivitatea testului s-a folosit metoda măsurării „temperaturii medii pe spital”...
A fost creat un fișier de dumping pe sectoare al discului logic cu sistemul de operare Windows 10, aceasta fiind cea mai naturală combinație de structuri de date disponibile pe fiecare computer. Comprimarea acestui fișier va permite compararea vitezei și gradului de compresie al noului algoritm cu cele mai avansate compresoare utilizate în arhivatoarele moderne.
Acesta este fișierul de dumping:
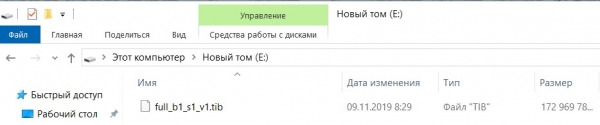
Fișierul de dumping a fost comprimat cu compresoare RTT-Mid, 7-zip, WinRar. Compresorul WinRar și 7-zip au fost setate pentru viteza maximă.
Compresorul funcționează 7-zip:
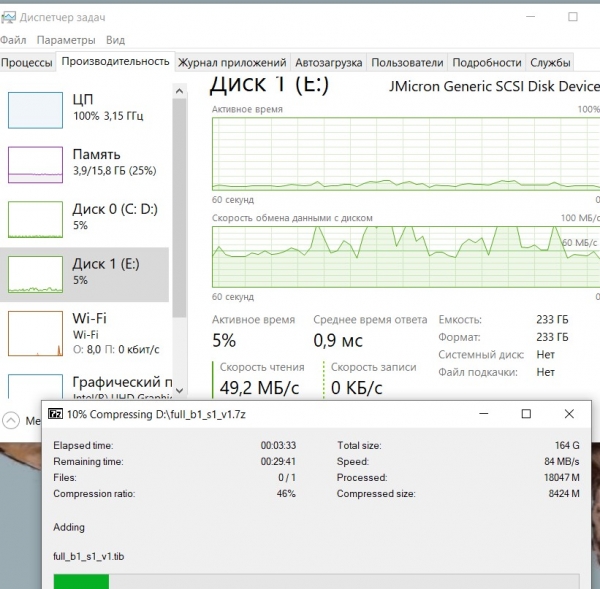
Acesta utilizează procesorul la 100%, cu o viteză medie de citire a fișierului de dumping de aproximativ 60 MegaOcteți/sec.
Compresorul funcționează WinRar:
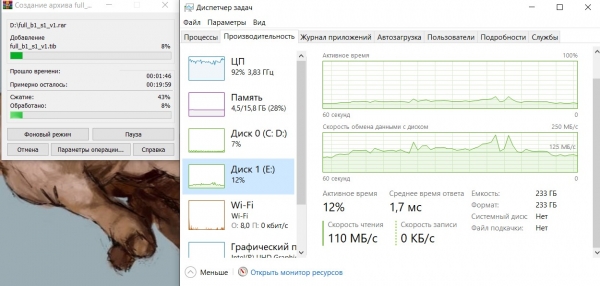
Situația este similară, utilizarea procesorului este aproape 100%, viteza medie de citire a dumpingului este de aproximativ 125 MegaOcteți/sec.
Ca și în cazul anterior, viteza de lucru a arhivatorului este limitată de capabilitățile procesorului.
Acum rulează programul de testare al compresorului RTT-Mid:
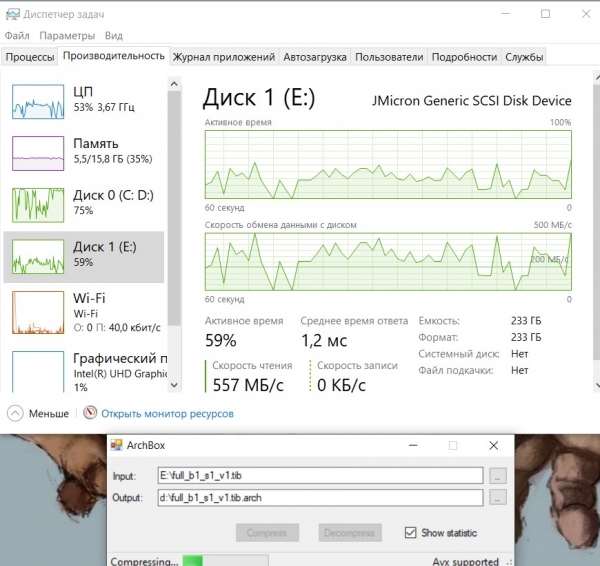
Captura de ecran arată că procesorul este utilizat la 50% și este inactiv restul timpului, deoarece nu există unde să fie descărcate datele comprimate. Discul de descărcare a datelor (Discul 0) este practic complet încărcat. Viteza de citire a datelor (Discul 1) fluctuează semnificativ, dar în medie este mai mare de 200 MegaOcteți/sec.
Viteza de lucru a compresorului este limitată în acest caz de capabilitățile de scriere a datelor comprimate pe Discul 0.
Acum gradul de compresie al arhivelor rezultate:
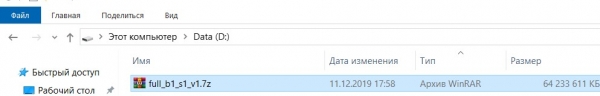
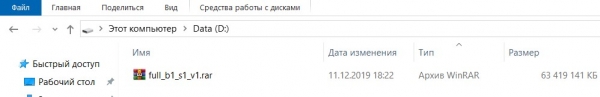
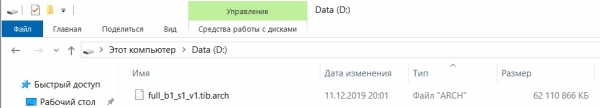
Se poate observa că compresorul RTT-Mid a realizat cea mai bună compresie, arhiva creată de acesta fiind cu 1,3 GigaOcteți mai mică decât arhiva WinRar și cu 2,1 GigaOcteți mai mică decât arhiva 7z.
Timpul necesar pentru crearea arhivei:
- 7-zip – 26 minute și 10 secunde;
- WinRar – 17 minute și 40 secunde;
- RTT-Mid – 7 minute și 30 secunde.
Astfel, chiar și programul de testare, neoptimizat, folosind algoritmul RTT-Mid, a reușit să creeze arhiva de mai bine de două ori mai repede, iar arhiva rezultată a fost semnificativ mai mică decât a concurenților...
Cei care nu cred capturile de ecran pot verifica veridicitatea acestora de unul singur. Programul de testare este disponibil la , descărcați și verificați.
Dar doar pe procesoarele care suportă AVX-2; fără suportul acestor instrucțiuni, compressorul nu funcționează, iar nu testați algoritmul pe procesoare AMD vechi, acestea sunt lente în executarea comenzilor AVX...
Metoda de compresie utilizată
Algoritmul utilizează metoda de indexare a fragmentelor repetitive de text la granulație de byte. Această metodă de comprimare este cunoscută de mult timp, dar nu a fost folosită, deoarece operația de căutare a corespondențelor era foarte costisitoare în termeni de resurse necesare și necesita mult mai mult timp decât construirea unui dicționar. Astfel, algoritmul RTT-Mid este un exemplu clasic al mișcării „înapoi în viitor”...
În compressorul RTT se utilizează un scaner de corespondențe unic și rapid, care a permis accelerarea procesului de compresie. Scanerul este realizat manual, acesta fiind „frumusețea mea…”, „prețul său nu este mic, deoarece este realizat în întregime manual” (scris în asamblare).
Scanerul de căutare a corespondențelor este realizat pe o schemă probabilistică cu două niveluri: mai întâi se scanează prezența „semnului” de corespondență, iar abia după ce este identificat „semnul” în acest loc se pornește procedura de descoperire a corespondenței reale.
Fereastra de căutare a corespondențelor are o dimensiune imprevizibilă, în funcție de gradul de entropie din blocul de date procesat. Pentru date complet aleatorii (nesuprimabile), dimensiunea acesteia este de megabytes, iar pentru datele care au repetări, dimensiunea este întotdeauna mai mare de un megabyte.
Însă multe formate moderne de date sunt nesuprimabile, iar utilizarea unui scaner resursiv pe acestea este inutilă și risipitoare, de aceea scanerul utilizează două moduri de funcționare. Inițial se caută porțiuni din textul original cu posibile repetări; această operație se desfășoară, de asemenea, printr-o metodă probabilistică și este realizată foarte rapid (cu o viteză de 4-6 Gigabytes/sec). Apoi, porțiunile cu posibile corespondențe sunt procesate de scanerul principal.
Compresia prin indexare nu este foarte eficientă, fiind nevoie să se înlocuiască fragmentele repetate cu indici, iar matricea de indici reduce semnificativ coeficientul de compresie.
Pentru a crește gradul de compresie, sunt indexate nu doar corespondențele complete ale șirurilor de octeți, ci și cele parțiale, atunci când în șir există octeți corespunzători și necorespunzători. Pentru aceasta, în formatul indexului este inclus un câmp de mască a corespondențelor care indică octeții corespunzători ai celor două blocuri. Pentru o compresie și mai mare, se folosește indexarea cu suprapunerea mai multor blocuri parțial corespunzătoare pe blocul curent.
Toate acestea au permis obținerea în compresorul RTT-Mid a unui grad de compresie comparabil cu cel al compresoarelor realizate prin metoda dicționarului, dar care funcționează mult mai repede.
Viteza de funcționare a noului algoritm de compresie
Dacă compresorul lucrează cu utilizarea monopolizată a cache-ului de memorie (4 MegaBaiți pentru un fir de execuție), atunci viteza de funcționare variază în intervalul de 700-2000 MegaBaiți/sec. pe un nucleu de procesor, în funcție de tipul datelor comprimate și depinde puțin de frecvența de lucru a procesorului.
În implementarea multi-threading a compresorului, scalabilitatea eficientă este determinată de volumul cache-ului de nivel trei. De exemplu, având 9 MegaBaiți de cache, nu are sens să pornim mai mult de două fire de compresie, deoarece viteza nu se va îmbunătăți. Dar cu un cache de 20 MegaBaiți, se pot porni deja cinci fire de compresie.
Un alt parametru semnificativ care determină viteza de funcționare a compresorului este latența memoriei RAM. Algoritmul folosește accesuri aleatorii la RAM, dintre care o parte nu ajung în cache (aproximativ 10%) și acesta este obligat să aștepte datele din RAM, ceea ce reduce viteza de funcționare.
De asemenea, sistemul de intrare/ieșire a datelor influențează semnificativ viteza compresorului. Cererile CPU pentru accesarea RAM de la intrare/ieșire blochează accesurile la date, ceea ce reduce, de asemenea, viteza de compresie. Această problemă este semnificativă pentru laptopuri și desktopuri, servere iar aceasta devine mai puțin semnificativă datorită unui modul de control al accesului avansat la magistrala de sistem și a memoriei RAM multicanel.
În întreaga text există referiri la compresie; decompresia este lăsată în afara acestei discuții, deoarece acolo „totul este în regulă”. Decompresia se realizează semnificativ mai rapid și este limitată de viteza de citire/scriere. Un nucleu fizic într-un singur fir asigură cu ușurință viteze de decompresie de 3-4 Gigabyte/sec.
Acest lucru se datorează absenței în procesul de decompresie a operației de căutare a potrivirilor, care „consumă” cele mai importante resurse ale procesorului și ale memoriei cache în timpul compresiei.
Fiabilitatea stocării datelor comprimate
Așa cum sugerează denumirea întregului tip de instrumente software care folosesc compresia datelor (compresoare), acestea sunt destinate stocării pe termen lung a informației, nu ani, ci secole și milenii...
Pe parcursul stocării, suporturile de informații își pierd o parte din date, iată un exemplu:
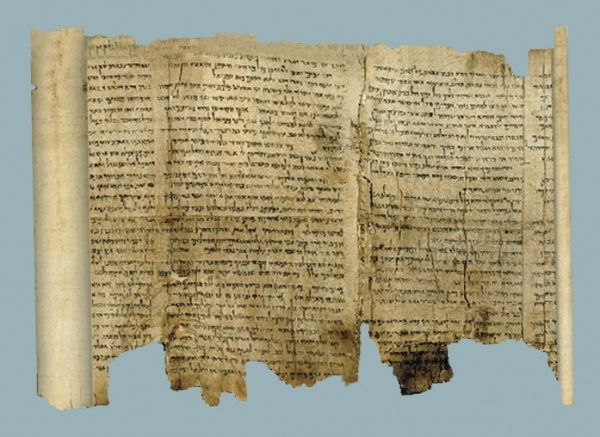
Acest suport de informație „analogic” are o mie de ani, unele fragmente au fost pierdute, dar în general informația este „citibilă”...
Niciunul dintre producătorii responsabili de sistemele moderne de stocare digitală și de suporturile digitale nu oferă garanții pentru integritatea completă a datelor mai mult de 75 de ani.
Și aceasta este o problemă, dar o problemă amânată; nepoții noștri o vor rezolva...
Sistemele de stocare a datelor digitale pot pierde date nu doar după 75 de ani; erorile în date pot apărea în orice moment, chiar și în timpul înregistrării acestora; aceste distorsiuni sunt minime prin utilizarea redundanței și prin corectarea erorilor. Redundanța și sistemele de corectare nu pot restabili informația pierdută întotdeauna, iar dacă o fac, nu există garanții că operația de recuperare s-a desfășurat corect.
Și aceasta este, de asemenea, o problemă majoră, dar nu amânată, ci actuală.
Compresoarele moderne utilizate pentru arhivarea datelor digitale sunt construite pe diferite modificări ale metodei de dicționar, iar pentru astfel de arhive, pierderea unui fragment de informație va fi un eveniment fatal; există chiar un termen consacrat pentru această situație — arhivă „corruptă”...
Fiabilitatea scăzută a stocării informațiilor în arhivele cu comprimare prin dicționar este legată de structura datelor comprimate. Informația dintr-o astfel de arhivă nu conține textul original, ci stochează numerele înregistrărilor din dicționar, iar dicționarul este modificat dinamic cu textul comprimat curent. În cazul pierderii sau deformării unui fragment din arhivă, toate înregistrările ulterioare nu pot fi identificate nici după conținut, nici după lungimea înregistrării în dicționar, deoarece nu este clar la ce corespunde numărul înregistrării din dicționar.
Recuperarea informației dintr-o astfel de arhivă „deteriorată” este imposibilă.
Algoritmul RTT se bazează pe o metodă de stocare a datelor comprimate mai fiabilă. Acesta aplică o metodă indexată pentru a ține evidența fragmentelor repetate. Această abordare a comprimării permite minimizarea consecințelor distorsiunii informației pe suport și, în multe cazuri, corectarea automată a distorsiunilor apărute în timpul stocării informațiilor.
Aceasta se datorează faptului că fișierul arhivă în cazul comprimării indexate conține două câmpuri:
- câmpul textului original, din care au fost eliminate secțiunile repetate;
- câmpul indicelui.
Câmpul indicelui, critic pentru recuperarea informației, nu este mare ca dimensiune și poate fi duplicat pentru a asigura o stocare fiabilă a datelor. Prin urmare, chiar dacă va fi pierdut un fragment din textul original sau din matricea indicelui, întreaga altă informație va putea fi recuperată fără probleme, la fel ca în imaginea unui suport de informație „analogic”.
Dezavantajele algoritmului
Fără dezavantaje nu există avantaje. Metoda indexată de comprimare nu comprimă secvențele repetate de dimensiuni mici. Acest lucru se datorează limitărilor metodei indexate. Indicele are o dimensiune de cel puțin 3 octeți și poate ajunge până la 12 octeți. Dacă apare o repetare cu o dimensiune mai mică decât indicele care o descrie, atunci aceasta nu este considerată, indiferent de cât de frecvent se pot identifica astfel de repetări în fișierul comprimat.
Metoda tradițională de compresie prin dicționar comprimă eficient multiple repetiții scurte, atingând astfel un coeficient de compresie mai mare comparativ cu compresia bazată pe index. Totuși, acest lucru se realizează printr-o încărcare ridicată a procesorului central; pentru a comprima datele mai eficient decât metoda de indexare, metoda prin dicționar trebuie să reducă viteza de procesare a datelor la 10-20 megabaiți pe secundă în condiții de calcul reale, atunci când CPU este complet încărcat.
Aceste viteze reduse sunt inacceptabile pentru sistemele moderne de stocare a datelor și reprezintă mai mult un interes „academic” decât unul practic.
Gradul de compresie a informațiilor va fi semnificativ îmbunătățit în următoarea modificare a algoritmului RTT (RTT-Max), care este deja în dezvoltare.
Așadar, ca întotdeauna, continuarea urmează…
Sursa: habr.com
