

Salut, habr.
Dacă cineva exploatează sistemul și s-a confruntat cu o problemă de performanță a stocării (IO, spațiul de stocare utilizat), atunci șansa ca cineva să fi privit ClickHouse ca o alternativă ar trebui să tinde spre unu. Această afirmație implică faptul că, ca receptor al metricelor, se folosește deja o implementare terță, de exemplu sau .
ClickHouse rezolvă bine problemele descrise. De exemplu, după ce am transferat 2TiB de date din whisper, acestea s-au încadrat în 300GiB. Nu voi insista pe comparații, există suficiente articole pe această temă. În plus, până de curând, nu totul era perfect cu depozitul nostru ClickHouse.
Probleme cu spațiul utilizat
La prima vedere, totul ar trebui să funcționeze bine. Urmând , creăm un config pentru schema de stocare a metricelor (ulterior retention), apoi creăm o tabelă conform recomandării backend-ului ales pentru graphite-web: + sau , în funcție de ce stivă este utilizată. Și... se activează o bombă cu ceas.
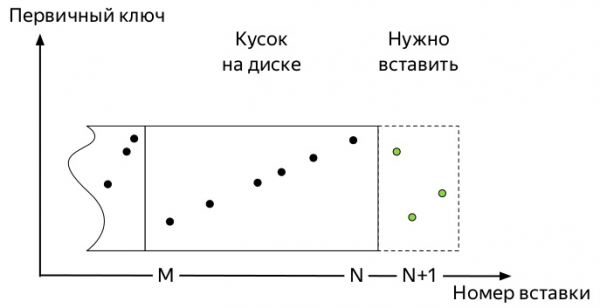
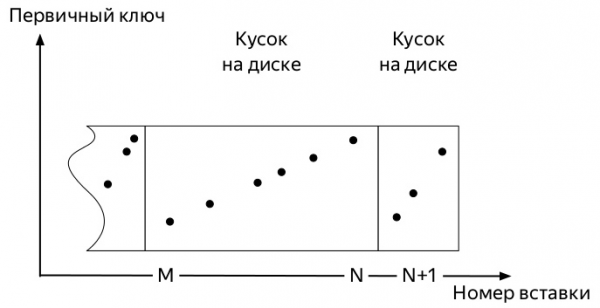
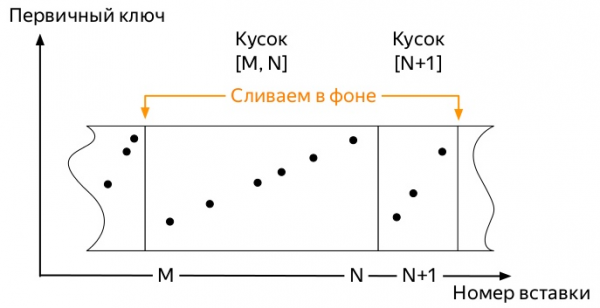
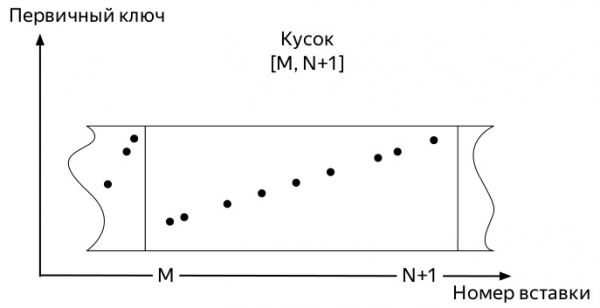
Pentru a înțelege care este aceasta, trebuie să știm cum funcționează inserțiile și parcursul ulterior al datelor în tabelele motoarelor din familia *MergeTree ClickHouse (diagrama este preluată din Alexei Zatelepin):
- Se introduce
un blocde date. În cazul nostru, acestea sunt metricile primite.

- Fiecare astfel de bloc, înainte de a fi scris pe disc, este sortat conform cheii
ORDER BY, specificată la crearea tabelului. - După sortare,
un fragment(part) de date este scris pe disc.
- Serverul monitorizează în fundal, pentru a se asigura că nu există multe astfel de fragmente, și pornește procesul de
îmbinare(merge, ulterior, îmbinări).
- Serverul încetează să pornească îmbinările automat, imediat ce datele încetează să mai curgă activ în
partiție(partition), dar procesul poate fi pornit manual cu comandaOPTIMIZE. - Dacă în partiție a rămas doar un singur fragment, atunci o îmbinare obișnuită nu va putea fi efectuată, este necesar să folosești
OPTIMIZE ... FINAL
Așadar, primele metrici sosesc. Și ele ocupă un anumit spațiu. Evenimentele ulterioare pot varia în funcție de mulți factori:
- Cheia de partiționare poate fi foarte mică (zi) sau foarte mare (câteva luni).
- Configurația de retenție poate conține mai multe praguri semnificative de agregare a datelor în interiorul unei partiții active (unde sunt scrise metricile), sau nu.
- Dacă sunt foarte multe date, cele mai vechi bucăți, care din cauza fuziunilor de fundal pot fi deja enorme (alegând o cheie de partiționare suboptimă), nu se vor fuziona singure cu bucățile proaspete mici.
Și totul se termină întotdeauna la fel. Locul ocupat de metrici în ClickHouse crește doar dacă:
- nu aplici
OPTIMIZE ... FINALmanual sau - nu introduci date în toate partițiile în mod constant, astfel încât, mai devreme sau mai târziu, să inițiezi o fuziune de fundal
A doua metodă pare cea mai simplă de implementat și, prin urmare, este greșită și a fost testată mai întâi.
Am scris un script destul de simplu în python, care trimitea metrici fictive pentru fiecare zi din ultimii 4 ani și rulați la fiecare oră prin cron.
Având în vedere că întreaga activitate a ClickHouse DBMS se bazează pe faptul că acest sistem va efectua mai devreme sau mai târziu toată munca de fundal, dar nu se știe când, nu am reușit să aștept momentul în care vechile bucăți enorme vor începe fuziunea cu noi bucăți mici. A devenit clar că trebuie să căutăm o modalitate de a automatiza optimizările forțate.
Informațiile din tabelele sistemului ClickHouse
Să ne uităm la structura tabelului . Aceasta este informația exhaustivă despre fiecare bucată din toate tabelele de pe serverul ClickHouse. Include, printre altele, următoarele coloane:
- numele BD (
database); - numele tabelului (
table); - numele și ID-ul partiției (
partition&partition_id); - când a fost creat bucata (
modification_time); - data minimă și maximă din bucată (partiționarea se face pe zile) (
min_date&max_date);
Există, de asemenea, un tabel , cu câmpurile interesante următoare:
- numele BD (
Tables.database); - numele tabelului (
Tables.table); - vârsta metricii, când ar trebui să fie aplicată următoarea agregare (
age);
Deci:
- Avem un tabel de bucăți și un tabel de reguli de agregare.
- Combinăm intersecția lor și obținem toate tabelele *GraphiteMergeTree.
- Căutăm toate partițiile în care:
- există mai mult de o bucată
- sau a venit momentul să aplicăm următoarea regulă de agregare și
modification_timesunt mai vechi decât acest moment.
Implementarea
Această interogare
SELECT
    concat(p.database, '.', p.table) AS table,
    p.partition_id AS partition_id,
    p.partition AS partition,
    -- Cea mai "veche" regulă care poate fi aplicată pentru
    -- partiție, dar nu în viitor, vezi (*)
    max(g.age) AS age,
    -- Numărul de bucăți în partiție
    countDistinct(p.name) AS parts,
    -- Cea mai veche metrică din partiție este considerată 00:00:00 din următoarea zi
    toDateTime(max(p.max_date + 1)) AS max_time,
    -- Când ar trebui să fie optimizată partiția
    max_time + age AS rollup_time,
    -- Când cea mai veche bucată din partiție a fost actualizată
    min(p.modification_time) AS modified_at
FROM system.parts AS p
INNER JOIN
(
    -- Toate regulile pentru toate tabelele *GraphiteMergeTree
    SELECT
        Tables.database AS database,
        Tables.table AS table,
        age
    FROM system.graphite_retentions
    ARRAY JOIN Tables
    GROUP BY
        database,
        table,
        age
) AS g ON
    (p.table = g.table)
    AND (p.database = g.database)
WHERE
    -- Doar bucăți active
    p.active
    -- (*) Și doar rânduri unde regulile de agregare ar trebui să fie deja aplicate
    AND ((toDateTime(p.max_date + 1) + g.age) < now())
GROUP BY
    table,
    partition
HAVING
    -- Doar partiții care sunt mai tinere decât momentul optimizării
    (modified_at  1)
ORDER BY
    table ASC,
    partition ASC,
    age ASC
returnează fiecare dintre partițiile tabelelor *GraphiteMergeTree, îmbinările cărora ar trebui să conducă la eliberarea spațiului pe disc. Rămâne doar să trecem prin ele toate cu o interogare OPTIMIZE ... FINAL. În implementarea finală este luat în considerare și faptul că nu este necesar să atingem partițiile cu scriere activă.
Exact asta face proiectul . Foștii colegi de la Yandex.Market l-au testat în producție, rezultatul muncii se poate vedea mai jos.
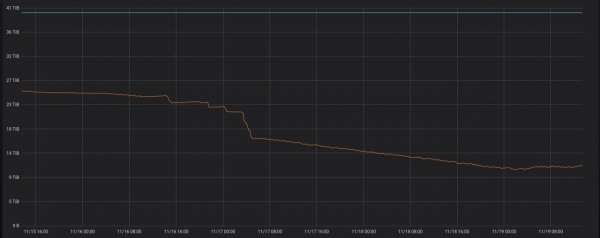
Dacă rulați programul pe un server cu ClickHouse, acesta va începe pur și simplu să funcționeze în modul demon. Odată la o oră va fi executată o interogare, verificând dacă au apărut noi partiții mai vechi de trei zile care pot fi optimizate.
Printre planurile viitoare — să oferim, cel puțin, pachete deb, iar dacă este posibil — și rpm.
În concluzie
În ultimele 9 luni am petrecut mult timp în cadrul companiei mele am fost împotmolit la intersecția dintre ClickHouse și graphite-web. A fost o experiență bună, rezultatul căreia a făcut posibilă tranziția rapidă de la whisper la ClickHouse ca depozit de metrici. Sper că acest articol este ceva de genul unui început de ciclu despre ce îmbunătățiri am adus în diferite părți ale acestui stivă și ce va fi făcut în viitor.
Au dezvoltarea cererii au fost consumate câteva litri de bere și zile de muncă împreună cu , pentru care vreau să-i exprim recunoștința mea. De asemenea, pentru recenzia acestui articol.
Sursa: habr.com
