

Nota traducătorului.: Service mesh este un fenomen care nu are încă o traducere stabilită în limba română (cu mai bine de 2 ani în urmă, am propus varianta „rețea de servicii”, iar puțin mai târziu, unii colegi au început să promoveze activ expresia „sită de servicii”). Discuțiile continue despre această tehnologie au dus la o situație în care componentele de marketing și cele tehnice s-au împletit într-un mod foarte strâns. Acest material remarcabil de la unul dintre autorii termenului original își propune să aducă claritate pentru ingineri și nu numai.
Comic de
Introducere
Dacă ești inginer software care lucrează în zona sistemelor backend, termenul „service mesh” s-a consolidat probabil în mintea ta în ultimii ani. Datorită unei ciudate conjuncturi, această sintagmă prinde tot mai mult avânt în industrie, iar hype-ul și propunerile publicitare aferente cresc precum un bulgăre de zăpadă care coboară pe o pantă, fără să dărâme vreo indicație de încetinire.
Service mesh a apărut în ape tulburi și tendițioase ale ecosistemului cloud native. Din păcate, acest lucru înseamnă că o parte semnificativă a polemicilor asociate variază de la „vorbe ușoare” până la — ca să folosim un termen tehnic — aberații clare. Dar, dacă eliminăm tot acest zgomot, putem observa că service mesh are o funcție reală, bine definită și importantă.
În această publicație, voi încerca să fac tocmai asta: să ofer un ghid onest, profund și orientat spre ingineri despre service mesh. Voi răspunde nu doar la întrebarea: „Ce este?”, — ci și „De ce?”, dar și pentru „De ce acum?”. În cele din urmă, voi încerca să conturez de ce (în opinia mea) această tehnologie a generat un interes atât de mare, ceea ce în sine este o poveste interesantă.
Cine sunt eu?
Salut tuturor! Mă numesc . Sunt unul dintre creatorii — primul proiect service mesh și proiectul care a fost responsabil pentru apariția termenului service mesh în sensul său (scuzați, băieți!). (Exemplu trad.: Apropo, la începutul apariției acestui termen, cu mai bine de 2,5 ani în urmă, am tradus deja un material timpuriu al aceluiași autor intitulat „».) De asemenea, conduc — startup care de crearea unor lucruri minunate de tip service mesh, precum Linkerd și .
Probabil că bănuiți că am o opinie destul de subiectivă și părtinitoare în legătură cu acest subiect. Cu toate acestea, voi încerca să reduc părtinirea la minimum (cu o excepție: „De ce există atât de multe discuții despre service mesh?”, — în care voi împărtăși totuși ideile mele subiective). De asemenea, voi depune toate eforturile pentru a face acest ghid cât mai obiectiv. În exemplele concrete, mă voi baza în principal pe experiența Linkerd, menționând în același timp diferențele cunoscute (dacă există) în implementarea altor tipuri de service mesh.
Ok, e timpul să trecem la lucruri interesante.
Ce este un service mesh?
În ciuda întregului hype, structural un service mesh este destul de simplu. Este pur și simplu o grămadă de proxy-uri de userspace, amplasate „în apropiere” de servicii (apoi vom vorbi puțin despre ce înseamnă „în apropiere”), plus un set de procese de control. Proxy-urile au fost denumite împreună data plane, iar procesele de control sunt numite control plane. Data plane interceptă apelurile între servicii și face „diverse lucruri” cu acestea; control plane, în consecință, coordonează comportamentul proxy-urilor și asigură accesul pentru tine, adică pentru operator, la API, permițând manipularea rețelei și măsurarea ei ca un întreg.
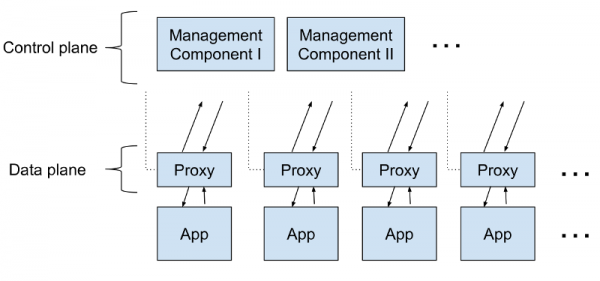
Ce sunt aceste proxy-uri? Sunt proxy-uri TCP de tip „Layer 7-aware” (adică „conștiente” de nivelul 7 al modelului OSI) , precum HAProxy și NGINX. Poți alege proxy-ul după preferințele tale; Linkerd utilizează un proxy scris în Rust, numit simplu . L-am creat special pentru service mesh. Alte mesh-uri preferă alte proxy-uri (Envoy este o alegere frecventă). Totuși, alegerea proxy-ului este doar o problemă de implementare.
Ce fac aceste servere proxy? Evident, ele proxy-uiesc apelurile către servicii și de la acestea (strict vorbind, ele îndeplinesc funcția de proxy și de proxy invers, gestionând atât apelurile de intrare, cât și pe cele de ieșire). Și ele implementează un set de funcții care se concentrează pe apelurile între servicii. Această concentrare asupra traficului între servicii le diferențiază pe proxy-urile service mesh de, să zicem, gateway-urile API sau proxy-urile ingress (cele din urmă se concentrează pe apelurile care vin în cluster din lume exterioară). (Nota traducătorului.: comparația controllerelor Ingress existente pentru Kubernetes, multe dintre care utilizează deja menționat Envoy, poate fi găsită în .)
Așadar, am clarificat aspectele legate de data plane. Control plane este mai simplu: este un set de componente care asigură toată mecanica necesară pentru ca data plane să funcționeze într-o manieră coordonată, inclusiv detectarea serviciilor, emiterea certificatelor TLS, agregarea metricilor etc. Data plane informează control plane despre comportamentul său; la rândul său, control plane oferă un API care permite modificarea și monitorizarea comportamentului data plane-ului ca un întreg.
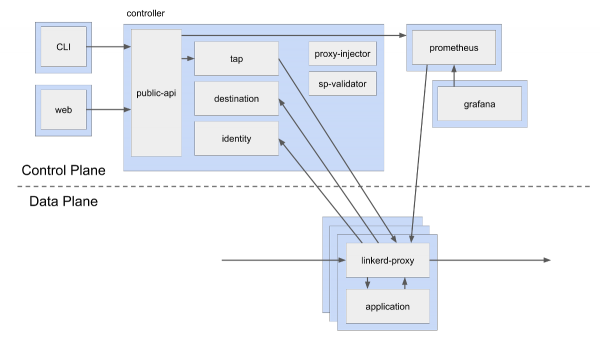
Mai jos este schema control plane și data plane în Linkerd. După cum se poate observa, control plane include mai multe componente diferite, inclusiv o instanță Prometheus, care colectează metrici de la serverele proxy, precum și alte componente, cum ar fi destination (detectarea serviciilor), identity (centru de certificare, CA) și public-api (endpoints pentru web și CLI). Spre deosebire de aceasta, data plane este un simplu linkerd-proxy lângă instanța aplicației. Aceasta este doar o schemă logică; în condiții reale de implementare, este posibil să aveți trei replici pentru fiecare componentă control plane și sute sau mii de proxy-uri în data plane.
(Dreptunghiurile albastre din această schemă simbolizează limitele pod-urilor Kubernetes. Se observă că containerele cu linkerd-proxy se află în același pod cu containerele aplicației. O astfel de schemă este cunoscută sub numele de sidecar-container.)
Arhitectura service mesh are câteva consecințe importante. În primul rând, deoarece sarcina proxy-ului este de a intercepta apelurile între servicii, service mesh are sens doar dacă aplicația dvs. a fost construită pe un anumit set de servicii. Mesh poate fi folosit cu monoliții, dar este evident redundant pentru un singur proxy, iar funcționalitatea sa este puțin probabil să fie solicitată.
O altă consecință importantă este că service mesh necesită o cantitate enormă de proxy-uri. De fapt, Linkerd atașează linkerd-proxy la fiecare instanță a fiecărui serviciu (alte implementări adaugă proxy la fiecare nod/gazdă/mașină virtuală. În orice caz, aceasta nu este o cantitate mică). Utilizarea atât de activă a proxy-urilor aduce cu sine o serie de complicații suplimentare:
- Proxy-urile din data plane trebuie să fie rapid, deoarece pentru fiecare apel există o pereche de solicitări către proxy: una pe partea clientului, una pe partea serverului.
- De asemenea, proxy-urile trebuie să fie mici și ușoare. Fiecare va consuma resurse de memorie și CPU, iar acest consum va crește liniar odată cu aplicația.
- Veți avea nevoie de un mecanism pentru desfășurarea și actualizarea unui număr mare de proxy-uri. A face acest lucru manual nu este o opțiune.
În general, mesh-ul de servicii arată astfel (cel puțin dintr-o perspectivă înaltă): desfășurați o mulțime de proxy-uri în spațiul utilizatorului care "fac ceva" cu traficul intern între servicii și utilizați planele de control pentru a le monitoriza și gestiona.
A sosit momentul întrebării „De ce?”
Care este scopul mesh-ului de servicii?
Pentru cei care se confruntă pentru prima dată cu ideea de mesh de servicii, este de înțeles să simțiți o ușoară neliniște. Structura mesh-ului de servicii înseamnă că nu doar că va crește întârzierea în aplicație, dar va consuma resurse și va adăuga o mulțime de noi mecanisme în infrastructură. Mai întâi instalați mesh-ul de servicii, apoi descoperiți brusc că trebuie să gestionați sute (dacă nu mii) de proxy-uri. Se pune întrebarea, cine ar accepta asta voluntar?
Răspunsul la această întrebare constă în două părți. În primul rând, costurile operaționale legate de desfășurarea acestor proxy-uri pot fi reduse semnificativ datorită unor schimbări care au loc în ecosistem (detalii despre acest subiect mai târziu).
În al doilea rând, un astfel de dispozitiv este într-adevăr un mod excelent de a introduce o logică suplimentară în sistem. Și nu doar pentru că, folosind mesh-ul de servicii, se pot adăuga multe funcționalități noi, ci și pentru că acest lucru se poate face fără a interveni în ecosistem. De fapt, întreaga model de mesh de servicii se bazează pe acest postulat: într-un sistem multi-servicii, indiferent de ceea ce fac serviciile individuale, traficul între ele este un punct ideal pentru adăugarea de funcționalitate.
De exemplu, în Linkerd (ca și în majoritatea mesh-urilor) funcționalitatea se concentrează în principal pe apelurile HTTP, inclusiv HTTP/2 și gRPC*. Funcționalitatea este destul de bogată - poate fi împărțită în trei clase:
- Funcții legate de fiabilitate.Reîncercări, timeout-uri, abordarea canar (împărțirea/redirecționarea traficului) etc.
- Funcții legate de monitorizare.Agregarea metricilor de succes, întârzierilor și volumelor de cereri pentru fiecare serviciu sau direcții specifice; construirea de hărți topologice ale serviciilor etc.
- Funcții legate de securitate.Mutual TLS, controlul accesului etc.
* Din perspectiva Linkerd, gRPC nu se deosebe în mod semnificativ de HTTP/2: pur și simplu, în payload se folosește protobuf. Din perspectiva dezvoltatorului, aceste două lucruri se diferențiază, desigur.
Multe dintre aceste mecanisme funcționează la nivelul cererilor (de aici denumirea de „proxy L7”). De exemplu, dacă serviciul Foo trimite un apel HTTP către serviciul Bar, linkerd-proxy de partea Foo poate efectua o echilibrare inteligentă a încărcării și poate redirecționa apelurile de la Foo către instanțele Bar, în funcție de latența observată; poate repeta cererea, dacă este necesar (și dacă aceasta este idempotentă); poate înregistra codul răspunsului și timpul de așteptare etc. În mod similar, linkerd-proxy de partea Bar poate respinge cererea, dacă aceasta nu este permisă sau dacă se depășește limita de cereri; poate înregistra latența din partea sa etc.
Proxy-urile pot „face ceva” și la nivelul conexiunii. De exemplu, linkerd-proxy de partea Foo poate iniția o conexiune TLS, iar linkerd-proxy de partea Bar poate să o închidă, și ambele părți pot verifica certificatele TLS ale celorlalte*. Aceasta asigură nu doar criptarea între servicii, ci și o modalitate criptografic securizată de a identifica serviciile: Foo și Bar pot „dovedi” că sunt cele care se declară.
* „Între ele” înseamnă că certificatul clientului este de asemenea verificat (mutual TLS). În TLS „clasic”, de exemplu, între un browser și un server, de obicei se verifică certificatul doar al unei singure părți (al serverului).
Indiferent dacă funcționează la nivelul cererilor sau al conexiunilor, este important să subliniem că toate funcțiile rețelei de servicii au un caracter operațional. Linkerd nu este capabil să transforme semantica payload-ului — de exemplu, să adauge câmpuri într-un fragment JSON sau să facă modificări în protobuf. Vom discuta despre această caracteristică importantă mai târziu, când va fi vorba despre ESB și middleware.
Acesta este setul de funcții pe care îl oferă rețeaua de servicii. Întrebarea este: de ce să nu le implementăm direct în aplicație? Și de ce să ne mai complicăm cu proxy-uri?
De ce rețeaua de servicii este o idee bună
Deși capabilitățile rețelei de servicii captează imaginația, valoarea sa de bază nu constă de fapt în funcționalități. La urma urmei, noi putem implementați-le direct în aplicație (mai târziu vom vedea că aceasta a fost originea service mesh). Dacă ar trebui să exprimăm acest gând într-o propoziție, valoarea service mesh este următoarea: oferă funcții esențiale pentru funcționarea software-ului server modern, uniform pentru întregul stivă și independent de codul aplicației.
Să analizăm această propoziție.
«Funcții esențiale pentru funcționarea software-ului server modern». Dacă creați o aplicație de server tranzacțional, legată de internetul public, care primește solicitări din lumea exterioară și răspunde în timp scurt – de exemplu, o aplicație web, un server API, sau aproape toate celelalte aplicații moderne – și dacă implementați aceasta ca un set de servicii care interacționează sincron, și dacă modernizați constant acest software, adăugând noi funcționalități, și dacă trebuie să mențineți acest sistem funcțional în timpul modificărilor – în acest caz, vă felicit, sunteți implicat în crearea software-ului server modern. Și toate aceste funcții minunate, enumerate mai sus, se dovedesc a fi esențiale pentru dumneavoastră. Aplicația trebuie să fie fiabilă, sigură, iar dumneavoastră trebuie să aveți posibilitatea de a observa ce face. Exact aceste întrebări ajută la rezolvarea service mesh.
(Bine, în paragraful precedent mi-a scăpat totuși convingerea că această abordare este o modalitate modernă de a crea software de server. Alții preferă să dezvolte monolite, «microservicii reactive» și alte lucruri care nu se încadrează în definiția dată mai sus. Aceste persoane au cu siguranță propria opinie, diferită de a mea. În schimb, eu consider că „nu au dreptate” – deși în orice caz service mesh nu le-ar fi foarte util).
«Uniform pentru întregul stivă». Funcțiile oferite de service mesh nu sunt doar esențiale. Ele se aplică tuturor serviciilor din aplicație, indiferent de limbajul în care sunt scrise, ce framework utilizează, cine le-a scris, cum au fost desfășurate și de toate celelalte detalii ale dezvoltării și utilizării lor.
«Dependent de codul aplicațieiÎn cele din urmă, service mesh nu doar oferă funcționalități unificate pentru întreaga stivă — o face într-un mod care nu necesită modificări ale aplicației. Fundamentul funcționalității service mesh, inclusiv sarcinile de configurare, actualizare, operare, întreținere etc., se află exclusiv la nivelul platformei și este independent de aplicație. Aplicația poate suferi modificări fără a afecta service mesh. La rândul său, service mesh poate suferi modificări fără nicio implicare din partea aplicației.
Pe scurt, service mesh nu doar oferă funcții vitale, ci o face într-un mod global, uniform și independent de aplicație. De aceea, deși funcționalitatea service mesh poate fi implementată în codul serviciului (de exemplu, sub forma unei biblioteci incluse în fiecare serviciu), această abordare nu va asigura uniformitatea și independența, aspecte atât de valoroase în cazul service mesh.
Și tot ce este necesar pentru asta este să adăugăm o mulțime de proxy-uri! Promit că foarte curând vom analiza costurile operaționale asociate cu adăugarea acestor proxy-uri. Dar mai întâi, haideți să ne oprim și să privim această idee de independență din perspectiva diferitelor persoane.
Cui îi este de folos service mesh?
Cât de neplăcut ar fi, dar pentru ca o tehnologie să devină o parte esențială a ecosistemului, aceasta trebuie să fie adoptată de oameni. Așadar, cine este interesat de service mesh? Cine beneficiază de utilizarea sa?
Dacă dezvoltați software de server modern, puteți aproxima echipa dvs. ca pe un grup de proprietari de servicii, care colaborează pentru a dezvolta și implementa logica de afaceri, și proprietari ai platformei, preocupați de dezvoltarea platformei interne pe care aceste servicii funcționează. În organizațiile mici, acestea pot fi aceleași persoane, dar pe măsură ce compania crește, aceste roluri devin de obicei mai pronunțate și chiar se împart în subroluri… (Aici se poate spune multe despre natura în schimbare a devops-ului, influența organizațională a microservicelor etc. Dar pentru acum, haideți să acceptăm aceste descrieri ca pe o dată).
Din această perspectivă, beneficiarii evidenți ai service mesh sunt proprietarii platformei. În cele din urmă, scopul echipei platformei este de a crea o platformă internă pe care proprietarii serviciilor să poată implementa logica de afaceri, făcând acest lucru într-un mod care le garantasează independența maximă de detaliile complicate ale operării acesteia. Service mesh nu numai că oferă capacități esențiale pentru a atinge acest obiectiv: o face într-un mod care, la rândul său, nu impune dependențe asupra proprietarilor serviciilor.
Proprietarii serviciilor câștigă, de asemenea, deși într-un mod mai indirect. Scopul proprietarului serviciului este de a fi cât mai productiv în implementarea logicii procesului de afaceri, iar cu cât trebuie să se îngrijoreze mai puțin de problemele operaționale, cu atât mai bine. În loc să se ocupe de implementarea, de exemplu, a politicilor de retry sau TLS, ei se pot concentra exclusiv asupra sarcinilor de afaceri și pot spera că platforma se va ocupa de tot restul. Aceasta este o mare avantaj pentru ei.
Valoarea organizațională a acestei separări între proprietarii platformei și cei ai serviciilor este greu de supraestimat. Cred că aceasta contribuie principal la valoarea service mesh.
Am învățat această lecție când unul dintre primii fani ai Linkerd ne-a spus de ce au ales service mesh: pentru că le-a permis să "minimizeze discuțiile". Iată câteva detalii: băieții de la o mare companie și-au migrat platforma în Kubernetes. Deoarece aplicația lucra cu informații confidențiale, au vrut să criptozeze toate comunicațiile din clustere. Totuși, situația era complicată de existența unor sute de servicii și sute de echipe de dezvoltatori. Perspectivele de a contacta pe toată lumea și a-i convinge să sprijine implementarea TLS în planurile lor nu le era deloc plăcută. Instalând Linkerd, ei au mutat responsabilitatea de la dezvoltatori (din perspectiva cărora aceasta era o corvoadă suplimentară) către echipa de platformă, pentru care aceasta era o prioritate de nivel înalt. Cu alte cuvinte, Linkerd rezolva pentru ei nu doar o problemă tehnică, ci mai degrabă o problemă organizațională.
Pe scurt, service mesh este mai degrabă o soluție nu doar tehnică, ci sociotehnică. (Mulțumiri lui Cindy Sridharan за знакомство с этим термином.)
Va rezolva service mesh toate problemele mele?
Da. Adică, nu!
Dacă ne uităm la cele trei clase de funcții menționate mai sus: fiabilitate, securitate și observabilitate, devine clar că service mesh nu reprezintă o soluție completă pentru niciuna dintre aceste probleme. Deși Linkerd poate trimite cereri repetate (dacă știe că sunt idempotente), nu poate decide ce să returneze utilizatorului dacă serviciul a căzut complet — aceste decizii trebuie luate de aplicație. Linkerd poate colecta statistici despre cererile reușite, dar nu poate privi în serviciu și oferi metricele interne ale acestuia — un astfel de instrumentar ar trebui să fie în aplicație. Și deși Linkerd poate organiza mTLS, soluțiile complete în ceea ce privește securitatea necesită mult mai mult.
Un subset de funcții în aceste domenii, oferite de service mesh, se referă la funcțiile platformei. Prin aceasta, mă refer la funcții care:
- Sunt independente de logica de afaceri.Modul în care se construiesc histogramele apelurilor între Foo și Bar nu depinde deloc de asta, de ce Foo apelează Bar.
- Este dificil de implementat corect.În Linkerd, încercările repetate sunt parametrizate de diverse caracteristici sofisticate, cum ar fi bugetele de încercare (retry budgets), deoarece o abordare directă în implementarea acestor lucruri va duce cu siguranță la apariția așa-numitului „furtună de cereri” (retry storm) și alte probleme caracteristice sistemelor distribuite.
- Sunt cele mai eficiente atunci când sunt aplicate uniform.Mecanismul TLS are sens doar atunci când este aplicat peste tot.
Deoarece aceste funcții sunt implementate la nivel de proxy (nu la nivel de aplicație), service mesh le oferă la nivel de platformă, nu la nivel de aplicație. Astfel, nu contează în ce limbaj sunt scrise serviciile, ce framework folosesc, cine le-a scris și de ce. Proxile funcționează dincolo de toate aceste detalii, iar fundația acestei funcționalități, inclusiv sarcinile de configurare, actualizare, operare, întreținere, etc., este exclusiv la nivel de platformă.
Exemple de capacități ale service mesh
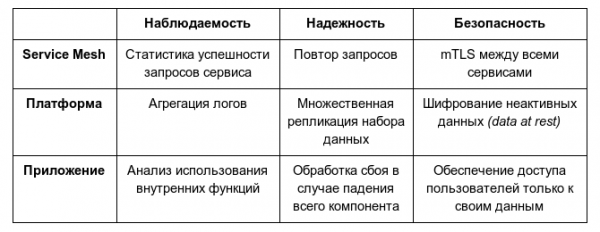
În concluzie, aș dori să subliniez că service mesh nu reprezintă o soluție completă pentru asigurarea fiabilității, observabilității sau securității. Scopul acestor domenii implică în mod obligatoriu participarea proprietarilor de servicii, echipelor Ops/SRE și altor părți interesate din companie. Service mesh oferă doar un „instantaneu” la nivel de platformă pentru fiecare dintre aceste domenii.
De ce a devenit service mesh popular tocmai acum?
Probabil că acum te întrebi: ok, dacă service mesh este atât de bună, de ce nu am început să desfășurăm milioane de proxy-uri în stivă cu zece ani în urmă?
Există un răspuns simplu la această întrebare: acum zece ani, toată lumea construia monolite și service mesh nu era necesar. Asta e adevărat, dar, în opinia mea, acest răspuns pierde esența. Chiar și acum zece ani, conceptul de microservicii ca o modalitate promițătoare de a construi sisteme la scară largă era larg discutat și aplicat în companii precum Twitter, Facebook, Google și Netflix. Părerea generală — cel puțin în acele părți ale industriei cu care am interacționat — era că microserviciile sunt „modul corect” de a crea sisteme mari, chiar dacă era incredibil de greu.
Desigur, deși acum zece ani existau companii care utilizau microservicii, nu înființau proxy-uri peste tot pentru a forma un service mesh. Totuși, dacă ne uităm mai atent, făceau ceva similar: în multe dintre aceste companii era impusă utilizarea unei biblioteci interne speciale pentru interacțiunea de rețea (câteodată numită bibliotecă de client gras, fat client library).
Netflix avea Hysterix, Google avea Stubby, iar Twitter — biblioteca Finagle. Finagle, de exemplu, era obligatorie pentru fiecare nou serviciu din Twitter. Aceasta gestiona atât partea client, cât și partea server a conexiunilor, permitea retrimiterea cererilor, sprijinea rutarea cererilor, echilibrarea sarcinii și măsurările. Oferă un strat consistent de fiabilitate și observabilitate pentru întreaga stivă Twitter, indiferent de activitatea specifică a serviciului. Desigur, funcționa doar pentru limbile JVM și se baza pe modelul de programare pe care trebuia să-l folosești pentru întreaga aplicație. Totuși, capabilitățile sale erau aproape la fel de bune ca cele ale unui service mesh. (De fapt, prima versiune a Linkerd a fost pur și simplu Finagle, înfășurat într-o formă de proxy.)
Astfel, acum zece ani existau nu doar microsservicii, ci și biblioteci speciale de proto-service-mesh care abordau aceleași probleme pe care le rezolvă astăzi service mesh. Cu toate acestea, service mesh-ul propriu-zis nu exista. A fost nevoie de o altă schimbare înainte de a apărea.
Și aici se află un răspuns mai profund, ascuns într-o altă schimbare care a avut loc în ultimii 10 ani: a existat o scădere bruscă a costurilor de implementare a microsserviciilor. Companiile menționate anterior, care foloseau microsservicii acum zece ani: Twitter, Netflix, Facebook, Google — erau companii de dimensiuni mari și cu resurse uriașe. Ele aveau nu doar nevoie, ci și posibilitatea de a crea, implementa și opera aplicații mari bazate pe microsservicii. Energia și eforturile pe care inginerii de la Twitter le-au investit în tranziția de la un model monolitic la un model pe microsservicii sunt pur și simplu uluitoare. (Sincer, la fel ca și faptul că acest lucru a reușit.) Acest tip de manevre infrastructurale erau imposibile pentru companiile mai mici.
Să ne mutăm în prezent. Astăzi există startup-uri în care raportul dintre microsservicii și dezvoltatori este de 5:1 (sau chiar ), și mai mult decât atât, se descurcă cu succes cu acestea! Dacă un startup format din 5 persoane poate, fără dificultate, să opereze 50 de microsservicii, înseamnă că ceva a redus clar costul implementării acestora.
1500 de microsservicii în Monzo; fiecare linie este o regulă de rețea prescrisă care permite traficul
Scăderea dramatică a costurilor de operare a microsserviciilor este rezultatul unui singur proces: creșterea popularității containerelor și orchestratorilor. Acesta este răspunsul profund la întrebarea ce a contribuit la apariția service mesh. Aceeași tehnologie a făcut atractive atât service mesh, cât și microsserviciile: Kubernetes și Docker.
De ce? Ei bine, Docker rezolvă o problemă mare — problema ambalării. Ambalând aplicația și dependențele sale (non-rețea) de runtime într-un container, Docker transformă aplicația într-o unitate interschimbabilă, care poate fi desfășurată și rulată oriunde. În același timp, simplifică semnificativ operarea multilingvului stiva: deoarece un container este o unitate atomică de execuție, pentru desfășurare și exploatare nu contează ce se află în interior, fie că este o aplicație pe JVM, Node, Go, Python sau Ruby. Trebuie doar să o pornești și atât.
Kubernetes ridică totul la un nou nivel. Acum, când există o mulțime de „lucruri executabile” și multe mașini pe care le poți rula, apare nevoia de un instrument capabil să le coreleze între ele. Într-un sens larg, oferi Kubernetes un număr mare de containere și numeroase mașini, iar el le corelează între ele (bineînțeles, acesta este un proces dinamic și în continuă schimbare: noi containere se mută prin sistem, mașinile pornesc și se opresc etc. Totuși, Kubernetes ține cont de toate acestea).
După configurarea Kubernetes, costurile temporale pentru desfășurarea și exploatarea unui singur serviciu sunt foarte asemănătoare cu cele pentru desfășurarea și exploatarea a zece servicii (de fapt, acestea sunt practic identice și pentru 100 de servicii). Adaugă la aceasta containerele ca mecanism de ambalare, care încurajează implementarea multilingvistică și obții o mulțime de noi aplicații implementate sub formă de microservicii, scrise în diverse limbaje – exact mediu pentru care service mesh se potrivește atât de bine.
Așadar, ajungem la răspunsul la întrebarea de ce ideea de service mesh a devenit populară tocmai acum: uniformitatea pe care Kubernetes o asigură pentru servicii se aplică direct sarcinilor de exploatare cu care se confruntă service mesh. Impachetezi un proxy în containere, oferi lui Kubernetes sarcina de a le atașa unde poate, iar voila! Rezultatul este un service mesh, toată mecanica desfășurării ei fiind gestionată de Kubernetes. (Cel puțin, dintr-o perspectivă de ansamblu. Desigur, în acest proces există multe nuanțe.)
În concluzie: motivul pentru care service mesh a devenit populară tocmai acum, și nu acum zece ani, este că Kubernetes și Docker nu doar că au crescut nevoia pentru aceasta, simplificând implementarea aplicațiilor sub formă de seturi de microservicii multilingvistice, ci și au redus semnificativ costurile pentru exploatarea ei, oferind mecanisme de desfășurare și suport pentru parcuri de proxy-uri sidecar.
De ce sunt atât de multe discuții despre service mesh?
Avertisment: în această secțiune fac apel la toate felurile de presupuneri, conjeturi, speculații și informații interne.
Căutând expresia „service mesh”, veți da peste o mulțime de conținut rescris de slabă calitate, proiecte ciudate și un caleidoscop de distorsiuni demne de camerele de ecou. Oricărei tehnologii noi la modă îi este specific acest lucru, dar în cazul service mesh problema este deosebit de acută. De ce?
Ei bine, parțial e vina mea. Am depus toate eforturile pentru a promova Linkerd și service mesh de câte ori am avut ocazia, prin nenumărate postări pe blog și articole ca acesta. Dar nu sunt atât de puternic. Pentru a răspunde cu adevărat la această întrebare, trebuie să discutăm puțin despre situația generală. Iar a discuta despre ea nu se poate fără a menționa un anumit proiect: — service mesh cu sursă deschisă, dezvoltat în colaborare de Google, IBM și Lyft.
(Aceste trei companii au roluri complet diferite: participarea Lyft pare rezumată doar la numele său; ei sunt autorii Envoy, dar nu utilizează Istio sau nu colaborează la dezvoltarea acestuia. IBM participă la dezvoltarea Istio și îl folosește. Google este activ implicată în dezvoltarea Istio, dar, din câte pot judeca, în realitate nu îl folosește.)
Proiectul Istio se remarcă prin două caracteristici. În primul rând, prin enormele eforturi de marketing pe care Google, în special, le depune pentru promovarea sa. Estimările mele sugerează că majoritatea oamenilor care sunt familiarizați cu conceptul de service mesh în prezent au aflat despre el pentru prima dată datorită Istio. A doua caracteristică constă în cât de slab a fost primit Istio. În această chestiune, evident, am un interes, dar încercând să rămân cât mai obiectiv, totuși nu pot să nu , nu foarte caracteristic (deși nu unic: vine în minte systemd, de mai multe ori
…) pentru un proiect Open Source. evaluării performanței Linkerd, realizată de o terță parte, specialiștii au descoperit situații în care întârzierea cozilor (tail latency) Istio depășea de 100 de ori un parametru similar pentru Linkerd, precum și situații de lipsă de resurse, când Linkerd continua să funcționeze cu succes, iar Istio înceta complet să funcționeze.)
Lăsând la o parte teoriile mele despre motivele pentru care s-a întâmplat așa, consider că entuziasmul exagerat pentru service mesh se explică în principal prin implicarea Google. Anume, combinația următoarelor trei factori:
- promovarea insistentă a Istio din partea Google;
- atitudinea critică corespunzătoare față de proiect;
- recenta creștere rapidă a popularității Kubernetes, amintirile despre care sunt încă proaspete.
Împreună, aceste condiții se combină într-un mediu intoxicant, hipoxic, în care capacitatea de judecată rațională slăbește, iar rămâne doar un anumit tip minunat de .
Din perspectiva Linkerd, aș descrie asta ca un bine ambiguu. Adică, este minunat că service mesh a devenit mainstream — lucru care nu era valabil în 2016, când Linkerd a apărut și a fost cu adevărat greu să atragi atenția asupra proiectului. Acum nu mai există această problemă! Dar este lamentabil că situația cu service mesh este atât de confuză încât este practic imposibil să înțelegem care proiecte aparțin cu adevărat categoriei service mesh (nevorbind despre a înțelege care dintre ele este cel mai potrivit pentru un anumit caz de utilizare). Acest lucru, fără îndoială, le face rău tuturor (și, în anumite cazuri, Istio sau alt proiect poate fi mai potrivit decât Linkerd, deoarece acesta din urmă nu este o soluție universală).
Din partea Linkerd, strategia noastră a fost să ignorăm gălăgia, să continuăm să ne concentrăm pe rezolvarea problemelor reale ale comunității și, în esență, să așteptăm să se domolească entuziasmul. În cele din urmă, hype-ul va scădea, iar noi vom putea continua să lucrăm în liniște.
Până atunci, va trebui să îndurăm puțin.
Îmi va fi de folos service mesh ca simplu software engineer?
Răspunsul la această întrebare poate fi clarificat de următorul chestionar:
Te ocupi exclusiv de implementarea logicii de afaceri? În acest caz, service mesh nu îți va fi de folos. Adică, desigur, ai putea fi interesat de aceasta, dar în ideal, service mesh nu ar trebui să influențeze direct nimic din mediu tău. Continuă să lucrezi la ceea ce ești plătit.
Întreții o platformă într-o companie care utilizează Kubernetes? Da, în acest caz, aveți nevoie de un service mesh (bineînțeles, dacă nu folosiți K8s doar pentru a rula un monolit sau pentru procesare în lot — dar atunci aș vrea să mă întreb de ce aveți nevoie de K8s). Cel mai probabil, veți fi într-o situație cu multe microservicii, scrise de persoane diferite. Toate acestea interacționează între ele și sunt legate într-un ghem de dependențe la runtime, iar dumneavoastră trebuie să găsiți o modalitate de a face față tuturor acestor lucruri. Utilizarea Kubernetes permite alegerea unui service mesh „pe măsura dumneavoastră”. Pentru aceasta, consultați capabilitățile și caracteristicile lor și răspundeți la întrebarea dacă vreun proiect existent vi se potrivește (vă recomand să începeți cercetarea cu Linkerd).
Sunteți responsabil pentru platformă într-o companie care NU folosește Kubernetes, dar folosește microservicii? În acest caz, service mesh vă va fi util, dar utilizarea sa va fi non-trivială. Desigur, puteți simula funcționalitatea service mesh, plasând o grămadă de proxy-uri, dar un avantaj important al Kubernetes este tocmai modelul de desfășurare: întreținerea acestor proxy-uri manual va necesita mult mai mult timp, efort și costuri.
Sunteți responsabil pentru platformă într-o companie care lucrează cu monolite? În acest caz, service mesh probabil nu vă este necesar. Dacă lucrați cu monolite (sau chiar cu seturi de monolite) cu modele clar definite și care se schimbă rar, service mesh nu va avea multe de oferit. Așa că puteți pur și simplu să o ignorați și să sperați că va dispărea ca un coșmar...
Concluzie
Probabil că nu ar trebui să numim service mesh „cea mai umflată tehnologie din lume” — această distincție discutabilă aparține, probabil, bitcoin-ului sau IA-ului. Poate că se află în primele cinci. Dar dacă reușiți să treceți prin straturile de zgomot și agitație, devine clar că service mesh aduce beneficii reale celor care dezvoltă aplicații în Kubernetes.
Aș dori să încercați Linkerd — instalarea sa în cluster-ul Kubernetes (sau chiar în Minikube pe laptop) , iar dumneavoastră veți putea vedea singur despre ce vorbesc.
Întrebări frecvente
— Dacă ignor service mesh, aceasta va dispărea?
— Trebuie să vă întristez: service mesh este aici pentru mult timp.
— Dar nu ÎMI DORESC să folosesc service mesh!
— Ei bine, nu e nevoie! Doar citiți chestionarul meu mai sus pentru a înțelege dacă ar trebui să vă familiarizați măcar cu elementele de bază ale acesteia.
— Nu este oare aceasta vechiul și bunul ESB/middleware sub un nou aspect?
— Service mesh se ocupă de logica operațională, nu de semnificație. a bus-ului de servicii al întreprinderii (). Menținerea acestei separări ajută service mesh să evite aceeași soartă.
— Cu ce se deosebește service mesh de gateway-urile API?
— Există milioane de articole pe această temă. Doar căutați pe Google.
— Envoy este un service mesh?
— Nu, Envoy nu este un service mesh, este un server proxy. Poate fi utilizat pentru a organiza un service mesh (și multe altele - este un proxy de uz general). Dar el însuși nu este un service mesh.
— Network Service Mesh este un service mesh?
— Nu. În ciuda numelui, acesta nu este un service mesh (ce minuni ale marketingului, nu-i așa?).
— Mă va ajuta service mesh cu sistemul meu reactiv asincron bazat pe cozi de mesaje?
— Nu, service mesh nu te va ajuta.
— Ce service mesh ar trebui să folosesc?
— , e clar ca bună ziua.
— Articolul este o porcărie! / Autorul merită să fie aruncat la gunoi!
— Te rog, împărtășește linkul cu toți prietenii ca să poată verifica și ei!
Mulțumiri
După cum ați putea ghici din titlu, acest articol a fost inspirat de faimosul tratat al lui Jay Kreps „”. L-am întâlnit pe Jay acum zece ani, când îl intervievam pentru LinkedIn, și de atunci el este o sursă de inspirație pentru mine.
Deși îmi place să mă numesc „dezvoltator Linkerd”, realitatea este că sunt mai degrabă un întreținător al fișierului README.md în proiect. La Linkerd lucrează astăzi , , oameni, iar acest proiect nu ar fi avut loc fără contribuția minunatului comunități de contribuabili și utilizatori.
Și la final, un mulțumesc special creatorului Linkerd, (primus inter pares), care, împreună cu mine, a sărit cu capul înainte în toată această agitație cu service mesh cu mulți ani în urmă.
P.S. de la traducător
Citiți și în blogul nostru:
- «»;
- «»;
- «»;
- «»;
- «».
Sursa: habr.com
