

În prezent, REST API a devenit standardul în dezvoltarea aplicațiilor web, permițând divizarea dezvoltării în părți independente. Pentru UI, la acest moment, sunt utilizate diverse cadre populare precum Angular, React, Vue și altele. Dezvoltatorii de backend pot alege dintr-o mare varietate de limbaje și cadre. Astăzi aș vrea să discut despre un astfel de cadru, și anume . Noi în îl folosim activ pentru proiectele interne. Folosind nest și pachetul , vom crea o aplicație CRUD simplă.
De ce NestJS
În ultima vreme, în comunitatea JavaScript au apărut multe cadre de backend. Și, deși în termeni de funcționalitate oferă posibilități asemănătoare celor din Nest, într-un singur aspect câștigă cu siguranță — arhitectura. Următoarele capabilități ale NestJS permit crearea de aplicații industriale și scalarea dezvoltării pentru echipe mari:
- utilizarea TypeScript ca limbaj principal de dezvoltare. Deși NestJS susține și JavaScript, unele funcționalități s-ar putea să nu funcționeze, mai ales când vine vorba de pachete externe;
- prezența unui container DI, care permite crearea de componente slab legate;
- funcționalitatea cadrelor de lucru este împărțită în componente independente și interschimbabile. De exemplu, pe fundal, un cadru precum , sau , pentru a lucra cu bazele de date, nest oferă din cutie legături către , , ;
- NestJS nu depinde de platformă și suportă REST, GraphQL, Websockets, gRPC etc.
Cadrele de lucru sunt inspirate de cadrul frontend Angular și conceptul are multe în comun cu acesta.
Instalarea NestJS și implementarea proiectului
Nest conține pachetul /cli, который позволяет быстро развернуть базовый каркас приложения. Установим глобально данный пакет:
npm install --global @nest/cliDupă instalare, vom genera structura de bază a aplicației noastre cu numele nest-rest. Aceasta se face folosind comanda nest new nest-rest.
nest new nest-rest
dmitrii@dmitrii-HP-ZBook-17-G3:~\/projects $ nest new nest-rest
  Vom crea aplicația ta în câteva secunde..

CREATE \/nest-rest\/.prettierrc (51 bytes)
CREATE \/nest-rest\/README.md (3370 bytes)
CREATE \/nest-rest\/nest-cli.json (84 bytes)
CREATE \/nest-rest\/nodemon-debug.json (163 bytes)
CREATE \/nest-rest\/nodemon.json (67 bytes)
CREATE \/nest-rest\/package.json (1805 bytes)
CREATE \/nest-rest\/tsconfig.build.json (97 bytes)
CREATE \/nest-rest\/tsconfig.json (325 bytes)
CREATE \/nest-rest\/tslint.json (426 bytes)
CREATE \/nest-rest\/src\/app.controller.spec.ts (617 bytes)
CREATE \/nest-rest\/src\/app.controller.ts (274 bytes)
CREATE \/nest-rest\/src\/app.module.ts (249 bytes)
CREATE \/nest-rest\/src\/app.service.ts (142 bytes)
CREATE \/nest-rest\/src\/main.ts (208 bytes)
CREATE \/nest-rest\/test\/app.e2e-spec.ts (561 bytes)
CREATE \/nest-rest\/test\/jest-e2e.json (183 bytes)

? Ce manager de pachete ai dori să folosești? yarn
 Instalare în curs...

  Proiectul nest-rest a fost creat cu succes
  Începe cu următoarele comenzi:

$ cd nest-rest
$ yarn run start

                          Mulțumim pentru instalarea Nest
                 Te rugăm să consideri să donezi pentru colectivul nostru deschis
                        pentru a ne ajuta să menținem acest pachet.

                 Donează: https:\/\/opencollective.com\/nest
Ca manager de pachete, vom alege yarn.
În prezent, poți porni serverul cu comanda npm start și, accesând adresa poți vizualiza pagina principală. Totuși, nu aceasta este intenția noastră și ne continuăm drumul.
Configurăm lucrul cu baza de date
Pentru acest articol, am ales PostgreSQL ca sistem de gestiune a bazelor de date. Gusturile nu se discută; consider că este cel mai matur SGBD, având toate funcționalitățile necesare. Așa cum s-a menționat anterior, pentru a lucra cu baze de date, Nest oferă integrare cu diverse pachete. Cum alegerea mea a fost PostgreSQL, este logic să aleg TypeORM ca ORM. Să instalăm pachetele necesare pentru integrarea cu baza de date:
yarn add typeorm @nestjs\/typeorm pg
Pe scurt, pentru ce este fiecare pachet:
- typeorm — pachetul efectiv al ORM-ului;
- @nestjs\/typeorm — pachetul TypeORM pentru NestJS. Adaugă module pentru import în modulele proiectului, precum și un set de decoratori-ajutători;
- pg — driverul pentru lucrul cu PostgreSQL.
Ok, pachetele sunt instalate, acum trebuie să pornesc baza de date. Pentru a desfășura baza voi folosi docker-compose.yml cu următorul conținut:
docker-compose.yml
version: '3.1'

services:
  db:
    image: postgres:11.2
    restart: always
    environment:
      POSTGRES_PASSWORD: example
    volumes:
      - ..\/db:\/var\/lib\/postgresql\/data
      - .\/postgresql.conf:\/etc\/postgresql\/postgresql.conf
    ports:
      - 5432:5432
  adminer:
    image: adminer
    restart: always
    ports:
      - 8080:8080
După cum se poate observa, acest fișier configurează lansarea a 2 containere:
- db — este containerul efectiv al bazei de date. În cazul nostru, se folosește PostgreSQL versiunea 11.2;
- adminer — managerul de lucrat cu baza de date. Oferă o interfață web pentru vizualizarea și gestionarea bazei de date.
Pentru a lucra cu conexiuni TCP, am adăugat o configurație de următorul conținut.
postgresql.conf
# -----------------------------
# PostgreSQL configuration file
# -----------------------------
#
# This file consists of lines of the form:
#
# name = value
#
# (The "=" is optional.) Whitespace may be used. Comments are introduced with
# "#" anywhere on a line. The complete list of parameter names and allowed
# values can be found in the PostgreSQL documentation.
#
# The commented-out settings shown in this file represent the default values.
# Re-commenting a setting is NOT sufficient to revert it to the default value;
# you need to reload the server.
#
# This file is read on server startup and when the server receives a SIGHUP
# signal. If you edit the file on a running system, you have to SIGHUP the
# server for the changes to take effect, run "pg_ctl reload", or execute
# "SELECT pg_reload_conf()". Some parameters, which are marked below,
# require a server shutdown and restart to take effect.
#
# Any parameter can also be given as a command-line option to the server, e.g.,
# "postgres -c log_connections=on". Some parameters can be changed at run time
# with the "SET" SQL command.
#
# Memory units: kB = kilobytes Time units: ms = milliseconds
# MB = megabytes s = seconds
# GB = gigabytes min = minutes
# TB = terabytes h = hours
# d = days
#------------------------------------------------------------------------------
# FILE LOCATIONS
#------------------------------------------------------------------------------
# The default values of these variables are driven from the -D command-line
# option or PGDATA environment variable, represented here as ConfigDir.
#data_directory = 'ConfigDir' # use data in another directory
# (change requires restart)
#hba_file = 'ConfigDir/pg_hba.conf' # host-based authentication file
# (change requires restart)
#ident_file = 'ConfigDir/pg_ident.conf' # ident configuration file
# (change requires restart)
# If external_pid_file is not explicitly set, no extra PID file is written.
#external_pid_file = '' # write an extra PID file
# (change requires restart)
#------------------------------------------------------------------------------
# CONNECTIONS AND AUTHENTICATION
#------------------------------------------------------------------------------
# - Connection Settings -
listen_addresses = '*'
#listen_addresses = 'localhost' # what IP address(es) to listen on;
# comma-separated list of addresses;
# defaults to 'localhost'; use '*' for all
# (change requires restart)
#port = 5432 # (change requires restart)
#max_connections = 100 # (change requires restart)
#superuser_reserved_connections = 3 # (change requires restart)
#unix_socket_directories = '/tmp' # comma-separated list of directories
# (change requires restart)
#unix_socket_group = '' # (change requires restart)
#unix_socket_permissions = 0777 # begin with 0 to use octal notation
# (change requires restart)
#bonjour = off # advertise server via Bonjour
# (change requires restart)
#bonjour_name = '' # defaults to the computer name
# (change requires restart)
# - TCP Keepalives -
# see "man 7 tcp" for details
#tcp_keepalives_idle = 0 # TCP_KEEPIDLE, in seconds;
# 0 selects the system default
#tcp_keepalives_interval = 0 # TCP_KEEPINTVL, in seconds;
# 0 selects the system default
#tcp_keepalives_count = 0 # TCP_KEEPCNT;
# 0 selects the system default
# - Authentication -
#authentication_timeout = 1min # 1s-600s
#password_encryption = md5 # md5 or scram-sha-256
#db_user_namespace = off
# GSSAPI using Kerberos
#krb_server_keyfile = ''
#krb_caseins_users = off
# - SSL -
#ssl = off
#ssl_ca_file = ''
#ssl_cert_file = 'server.crt'
#ssl_crl_file = ''
#ssl_key_file = 'server.key'
#ssl_ciphers = 'HIGH:MEDIUM:+3DES:!aNULL' # allowed SSL ciphers
#ssl_prefer_server_ciphers = on
#ssl_ecdh_curve = 'prime256v1'
#ssl_min_protocol_version = 'TLSv1'
#ssl_max_protocol_version = ''
#ssl_dh_params_file = ''
#ssl_passphrase_command = ''
#ssl_passphrase_command_supports_reload = off
#------------------------------------------------------------------------------
# RESOURCE USAGE (except WAL)
#------------------------------------------------------------------------------
# - Memory -
#shared_buffers = 32MB # min 128kB
# (change requires restart)
#huge_pages = try # on, off, or try
# (change requires restart)
#temp_buffers = 8MB # min 800kB
#max_prepared_transactions = 0 # zero disables the feature
# (change requires restart)
# Caution: it is not advisable to set max_prepared_transactions nonzero unless
# you actively intend to use prepared transactions.
#work_mem = 4MB # min 64kB
#maintenance_work_mem = 64MB # min 1MB
#autovacuum_work_mem = -1 # min 1MB, or -1 to use maintenance_work_mem
#max_stack_depth = 2MB # min 100kB
#shared_memory_type = mmap # the default is the first option
# supported by the operating system:
# mmap
# sysv
# windows
# (change requires restart)
#dynamic_shared_memory_type = posix # the default is the first option
# supported by the operating system:
# posix
# sysv
# windows
# mmap
# (change requires restart)
# - Disk -
#temp_file_limit = -1 # limits per-process temp file space
# in kB, or -1 for no limit
# - Kernel Resources -
#max_files_per_process = 1000 # min 25
# (change requires restart)
# - Cost-Based Vacuum Delay -
#vacuum_cost_delay = 0 # 0-100 milliseconds (0 disables)
#vacuum_cost_page_hit = 1 # 0-10000 credits
#vacuum_cost_page_miss = 10 # 0-10000 credits
#vacuum_cost_page_dirty = 20 # 0-10000 credits
#vacuum_cost_limit = 200 # 1-10000 credits
# - Background Writer -
#bgwriter_delay = 200ms # 10-10000ms between rounds
#bgwriter_lru_maxpages = 100 # max buffers written/round, 0 disables
#bgwriter_lru_multiplier = 2.0 # 0-10.0 multiplier on buffers scanned/round
#bgwriter_flush_after = 0 # measured in pages, 0 disables
# - Asynchronous Behavior -
#effective_io_concurrency = 1 # 1-1000; 0 disables prefetching
#max_worker_processes = 8 # (change requires restart)
#max_parallel_maintenance_workers = 2 # taken from max_parallel_workers
#max_parallel_workers_per_gather = 2 # taken from max_parallel_workers
#parallel_leader_participation = on
#max_parallel_workers = 8 # maximum number of max_worker_processes that
# can be used in parallel operations
#old_snapshot_threshold = -1 # 1min-60d; -1 disables; 0 is immediate
# (change requires restart)
#backend_flush_after = 0 # measured in pages, 0 disables
#------------------------------------------------------------------------------
# WRITE-AHEAD LOG
#------------------------------------------------------------------------------
# - Settings -
#wal_level = replica # minimal, replica, or logical
# (change requires restart)
#fsync = on # flush data to disk for crash safety
# (turning this off can cause
# unrecoverable data corruption)
#synchronous_commit = on # synchronization level;
# off, local, remote_write, remote_apply, or on
#wal_sync_method = fsync # the default is the first option
# supported by the operating system:
# open_datasync
# fdatasync (default on Linux)
# fsync
# fsync_writethrough
# open_sync
#full_page_writes = on # recover from partial page writes
#wal_compression = off # enable compression of full-page writes
#wal_log_hints = off # also do full page writes of non-critical updates
# (change requires restart)
#wal_buffers = -1 # min 32kB, -1 sets based on shared_buffers
# (change requires restart)
#wal_writer_delay = 200ms # 1-10000 milliseconds
#wal_writer_flush_after = 1MB # measured in pages, 0 disables
#commit_delay = 0 # range 0-100000, in microseconds
#commit_siblings = 5 # range 1-1000
# - Checkpoints -
#checkpoint_timeout = 5min # range 30s-1d
#max_wal_size = 1GB
#min_wal_size = 80MB
#checkpoint_completion_target = 0.5 # checkpoint target duration, 0.0 - 1.0
#checkpoint_flush_after = 0 # measured in pages, 0 disables
#checkpoint_warning = 30s # 0 disables
# - Archiving -
#archive_mode = off # enables archiving; off, on, or always
# (change requires restart)
#archive_command = '' # command to use to archive a logfile segment
# placeholders: %p = path of file to archive
# %f = file name only
# e.g. 'test ! -f /mnt/server/archivedir/%f && cp %p /mnt/server/archivedir/%f'
#archive_timeout = 0 # force a logfile segment switch after this
# number of seconds; 0 disables
# - Archive Recovery -
# These are only used in recovery mode.
#restore_command = '' # command to use to restore an archived logfile segment
# placeholders: %p = path of file to restore
# %f = file name only
# e.g. 'cp /mnt/server/archivedir/%f %p'
# (change requires restart)
#archive_cleanup_command = '' # command to execute at every restartpoint
#recovery_end_command = '' # command to execute at completion of recovery
# - Recovery Target -
# Set these only when performing a targeted recovery.
#recovery_target = '' # 'immediate' to end recovery as soon as a
# consistent state is reached
# (change requires restart)
#recovery_target_name = '' # the named restore point to which recovery will proceed
# (change requires restart)
#recovery_target_time = '' # the time stamp up to which recovery will proceed
# (change requires restart)
#recovery_target_xid = '' # the transaction ID up to which recovery will proceed
# (change requires restart)
#recovery_target_lsn = '' # the WAL LSN up to which recovery will proceed
# (change requires restart)
#recovery_target_inclusive = on # Specifies whether to stop:
# just after the specified recovery target (on)
# just before the recovery target (off)
# (change requires restart)
#recovery_target_timeline = 'latest' # 'current', 'latest', or timeline ID
# (change requires restart)
#recovery_target_action = 'pause' # 'pause', 'promote', 'shutdown'
# (change requires restart)
#------------------------------------------------------------------------------
# REPLICATION
#------------------------------------------------------------------------------
# - Sending Servers -
# Set these on the master and on any standby that will send replication data.
#max_wal_senders = 10 # max number of walsender processes
# (change requires restart)
#wal_keep_segments = 0 # in logfile segments; 0 disables
#wal_sender_timeout = 60s # in milliseconds; 0 disables
#max_replication_slots = 10 # max number of replication slots
# (change requires restart)
#track_commit_timestamp = off # collect timestamp of transaction commit
# (change requires restart)
# - Master Server -
# These settings are ignored on a standby server.
#synchronous_standby_names = '' # standby servers that provide sync rep
# method to choose sync standbys, number of sync standbys,
# and comma-separated list of application_name
# from standby(s); '*' = all
#vacuum_defer_cleanup_age = 0 # number of xacts by which cleanup is delayed
# - Standby Servers -
# These settings are ignored on a master server.
#primary_conninfo = '' # connection string to sending server
# (change requires restart)
#primary_slot_name = '' # replication slot on sending server
# (change requires restart)
#promote_trigger_file = '' # file name whose presence ends recovery
#hot_standby = on # "off" disallows queries during recovery
# (change requires restart)
#max_standby_archive_delay = 30s # max delay before canceling queries
# when reading WAL from archive;
# -1 allows indefinite delay
#max_standby_streaming_delay = 30s # max delay before canceling queries
# when reading streaming WAL;
# -1 allows indefinite delay
#wal_receiver_status_interval = 10s # send replies at least this often
# 0 disables
#hot_standby_feedback = off # send info from standby to prevent
# query conflicts
#wal_receiver_timeout = 60s # time that receiver waits for
# communication from master
# in milliseconds; 0 disables
#wal_retrieve_retry_interval = 5s # time to wait before retrying to
# retrieve WAL after a failed attempt
#recovery_min_apply_delay = 0 # minimum delay for applying changes during recovery
# - Subscribers -
# These settings are ignored on a publisher.
#max_logical_replication_workers = 4 # taken from max_worker_processes
# (change requires restart)
#max_sync_workers_per_subscription = 2 # taken from max_logical_replication_workers
#------------------------------------------------------------------------------
# QUERY TUNING
#------------------------------------------------------------------------------
# - Planner Method Configuration -
#enable_bitmapscan = on
#enable_hashagg = on
#enable_hashjoin = on
#enable_indexscan = on
#enable_indexonlyscan = on
#enable_material = on
#enable_mergejoin = on
#enable_nestloop = on
#enable_parallel_append = on
#enable_seqscan = on
#enable_sort = on
#enable_tidscan = on
#enable_partitionwise_join = off
#enable_partitionwise_aggregate = off
#enable_parallel_hash = on
#enable_partition_pruning = on
# - Planner Cost Constants -
#seq_page_cost = 1.0 # measured on an arbitrary scale
#random_page_cost = 4.0 # same scale as above
#cpu_tuple_cost = 0.01 # same scale as above
#cpu_index_tuple_cost = 0.005 # same scale as above
#cpu_operator_cost = 0.0025 # same scale as above
#parallel_tuple_cost = 0.1 # same scale as above
#parallel_setup_cost = 1000.0 # same scale as above
#jit_above_cost = 100000 # perform JIT compilation if available
# and query more expensive than this;
# -1 disables
#jit_inline_above_cost = 500000 # inline small functions if query is
# more expensive than this; -1 disables
#jit_optimize_above_cost = 500000 # use expensive JIT optimizations if
# query is more expensive than this;
# -1 disables
#min_parallel_table_scan_size = 8MB
#min_parallel_index_scan_size = 512kB
#effective_cache_size = 4GB
# - Genetic Query Optimizer -
#geqo = on
#geqo_threshold = 12
#geqo_effort = 5 # range 1-10
#geqo_pool_size = 0 # selects default based on effort
#geqo_generations = 0 # selects default based on effort
#geqo_selection_bias = 2.0 # range 1.5-2.0
#geqo_seed = 0.0 # range 0.0-1.0
# - Other Planner Options -
#default_statistics_target = 100 # range 1-10000
#constraint_exclusion = partition # on, off, or partition
#cursor_tuple_fraction = 0.1 # range 0.0-1.0
#from_collapse_limit = 8
#join_collapse_limit = 8 # 1 disables collapsing of explicit
# JOIN clauses
#force_parallel_mode = off
#jit = on # allow JIT compilation
#plan_cache_mode = auto # auto, force_generic_plan or
# force_custom_plan
#------------------------------------------------------------------------------
# REPORTING AND LOGGING
#------------------------------------------------------------------------------
# - Where to Log -
#log_destination = 'stderr' # Valid values are combinations of
# stderr, csvlog, syslog, and eventlog,
# depending on platform. csvlog
# requires logging_collector to be on.
# This is used when logging to stderr:
#logging_collector = off # Enable capturing of stderr and csvlog
# into log files. Required to be on for
# csvlogs.
# (change requires restart)
# These are only used if logging_collector is on:
#log_directory = 'log' # directory where log files are written,
# can be absolute or relative to PGDATA
#log_filename = 'postgresql-%Y-%m-%d_%H%M%S.log' # log file name pattern,
# can include strftime() escapes
#log_file_mode = 0600 # creation mode for log files,
# begin with 0 to use octal notation
#log_truncate_on_rotation = off # If on, an existing log file with the
# same name as the new log file will be
# truncated rather than appended to.
# But such truncation only occurs on
# time-driven rotation, not on restarts
# or size-driven rotation. Default is
# off, meaning append to existing files
# in all cases.
#log_rotation_age = 1d # Automatic rotation of logfiles will
# happen after that time. 0 disables.
#log_rotation_size = 10MB # Automatic rotation of logfiles will
# happen after that much log output.
# 0 disables.
# These are relevant when logging to syslog:
#syslog_facility = 'LOCAL0'
#syslog_ident = 'postgres'
#syslog_sequence_numbers = on
#syslog_split_messages = on
# This is only relevant when logging to eventlog (win32):
# (change requires restart)
#event_source = 'PostgreSQL'
# - When to Log -
#log_min_messages = warning # values in order of decreasing detail:
# debug5
# debug4
# debug3
# debug2
# debug1
# info
# notice
# warning
# error
# log
# fatal
# panic
#log_min_error_statement = error # values in order of decreasing detail:
# debug5
# debug4
# debug3
# debug2
# debug1
# info
# notice
# warning
# error
# log
# fatal
# panic (effectively off)
#log_min_duration_statement = -1 # logs statements and their durations
# according to log_statement_sample_rate. -1 is disabled,
# 0 logs all statement, > 0 logs only statements running at
# least this number of milliseconds.
#log_statement_sample_rate = 1 # Fraction of logged statements over
# log_min_duration_statement. 1.0 logs all statements,
# 0 never logs.
# - What to Log -
#debug_print_parse = off
#debug_print_rewritten = off
#debug_print_plan = off
#debug_pretty_print = on
#log_checkpoints = off
#log_connections = off
#log_disconnections = off
#log_duration = off
#log_error_verbosity = default # terse, default, or verbose messages
#log_hostname = off
#log_line_prefix = '%m [%p] ' # special values:
# %a = application name
# %u = user name
# %d = database name
# %r = remote host and port
# %h = remote host
# %p = process ID
# %t = timestamp without milliseconds
# %m = timestamp with milliseconds
# %n = timestamp with milliseconds (as a Unix epoch)
# %i = command tag
# %e = SQL state
# %c = session ID
# %l = session line number
# %s = session start timestamp
# %v = virtual transaction ID
# %x = transaction ID (0 if none)
# %q = stop here in non-session
# processes
# %% = '%'
# e.g. '<%u%%%d> '
#log_lock_waits = off # log lock waits >= deadlock_timeout
#log_statement = 'none' # none, ddl, mod, all
#log_replication_commands = off
#log_temp_files = -1 # log temporary files equal or larger
# than the specified size in kilobytes;
# -1 disables, 0 logs all temp files
#log_timezone = 'GMT'
#------------------------------------------------------------------------------
# PROCESS TITLE
#------------------------------------------------------------------------------
#cluster_name = '' # added to process titles if nonempty
# (change requires restart)
#update_process_title = on
#------------------------------------------------------------------------------
# STATISTICS
#------------------------------------------------------------------------------
# - Query and Index Statistics Collector -
#track_activities = on
#track_counts = on
#track_io_timing = off
#track_functions = none # none, pl, all
#track_activity_query_size = 1024 # (change requires restart)
#stats_temp_directory = 'pg_stat_tmp'
# - Monitoring -
#log_parser_stats = off
#log_planner_stats = off
#log_executor_stats = off
#log_statement_stats = off
#------------------------------------------------------------------------------
# AUTOVACUUM
#------------------------------------------------------------------------------
#autovacuum = on # Enable autovacuum subprocess? 'on'
# requires track_counts to also be on.
#log_autovacuum_min_duration = -1 # -1 disables, 0 logs all actions and
# their durations, > 0 logs only
# actions running at least this number
# of milliseconds.
#autovacuum_max_workers = 3 # max number of autovacuum subprocesses
# (change requires restart)
#autovacuum_naptime = 1min # time between autovacuum runs
#autovacuum_vacuum_threshold = 50 # min number of row updates before
# vacuum
#autovacuum_analyze_threshold = 50 # min number of row updates before
# analyze
#autovacuum_vacuum_scale_factor = 0.2 # fraction of table size before vacuum
#autovacuum_analyze_scale_factor = 0.1 # fraction of table size before analyze
#autovacuum_freeze_max_age = 200000000 # maximum XID age before forced vacuum
# (change requires restart)
#autovacuum_multixact_freeze_max_age = 400000000 # maximum multixact age
# before forced vacuum
# (change requires restart)
#autovacuum_vacuum_cost_delay = 2ms # default vacuum cost delay for
# autovacuum, in milliseconds;
# -1 means use vacuum_cost_delay
#autovacuum_vacuum_cost_limit = -1 # default vacuum cost limit for
# autovacuum, -1 means use
# vacuum_cost_limit
#------------------------------------------------------------------------------
# CLIENT CONNECTION DEFAULTS
#------------------------------------------------------------------------------
# - Statement Behavior -
#client_min_messages = notice # values in order of decreasing detail:
# debug5
# debug4
# debug3
# debug2
# debug1
# log
# notice
# warning
# error
#search_path = '"$user", public' # schema names
#row_security = on
#default_tablespace = '' # a tablespace name, '' uses the default
#temp_tablespaces = '' # a list of tablespace names, '' uses
# only default tablespace
#check_function_bodies = on
#default_transaction_isolation = 'read committed'
#default_transaction_read_only = off
#default_transaction_deferrable = off
#session_replication_role = 'origin'
#statement_timeout = 0 # in milliseconds, 0 is disabled
#lock_timeout = 0 # in milliseconds, 0 is disabled
#idle_in_transaction_session_timeout = 0 # in milliseconds, 0 is disabled
#vacuum_freeze_min_age = 50000000
#vacuum_freeze_table_age = 150000000
#vacuum_multixact_freeze_min_age = 5000000
#vacuum_multixact_freeze_table_age = 150000000
#vacuum_cleanup_index_scale_factor = 0.1 # fraction of total number of tuples
# before index cleanup, 0 always performs
# index cleanup
#bytea_output = 'hex' # hex, escape
#xmlbinary = 'base64'
#xmloption = 'content'
#gin_fuzzy_search_limit = 0
#gin_pending_list_limit = 4MB
# - Locale and Formatting -
#datestyle = 'iso, mdy'
#intervalstyle = 'postgres'
#timezone = 'GMT'
#timezone_abbreviations = 'Default' # Select the set of available time zone
# abbreviations. Currently, there are
# Default
# Australia (historical usage)
# India
# You can create your own file in
# share/timezonesets/.
#extra_float_digits = 1 # min -15, max 3; any value >0 actually
# selects precise output mode
#client_encoding = sql_ascii # actually, defaults to database
# encoding
# These settings are initialized by initdb, but they can be changed.
#lc_messages = 'C' # locale for system error message
# strings
#lc_monetary = 'C' # locale for monetary formatting
#lc_numeric = 'C' # locale for number formatting
#lc_time = 'C' # locale for time formatting
# default configuration for text search
#default_text_search_config = 'pg_catalog.simple'
# - Shared Library Preloading -
#shared_preload_libraries = '' # (change requires restart)
#local_preload_libraries = ''
#session_preload_libraries = ''
#jit_provider = 'llvmjit' # JIT library to use
# - Other Defaults -
#dynamic_library_path = '$libdir'
#------------------------------------------------------------------------------
# LOCK MANAGEMENT
#------------------------------------------------------------------------------
#deadlock_timeout = 1s
#max_locks_per_transaction = 64 # min 10
# (change requires restart)
#max_pred_locks_per_transaction = 64 # min 10
# (change requires restart)
#max_pred_locks_per_relation = -2 # negative values mean
# (max_pred_locks_per_transaction
# / -max_pred_locks_per_relation) - 1
#max_pred_locks_per_page = 2 # min 0
#------------------------------------------------------------------------------
# VERSION AND PLATFORM COMPATIBILITY
#------------------------------------------------------------------------------
# - Previous PostgreSQL Versions -
#array_nulls = on
#backslash_quote = safe_encoding # on, off, or safe_encoding
#escape_string_warning = on
#lo_compat_privileges = off
#operator_precedence_warning = off
#quote_all_identifiers = off
#standard_conforming_strings = on
#synchronize_seqscans = on
# - Other Platforms and Clients -
#transform_null_equals = off
#------------------------------------------------------------------------------
# ERROR HANDLING
#------------------------------------------------------------------------------
#exit_on_error = off # terminate session on any error?
#restart_after_crash = on # reinitialize after backend crash?
#data_sync_retry = off # retry or panic on failure to fsync
# data?
# (change requires restart)
#------------------------------------------------------------------------------
# CONFIG FILE INCLUDES
#------------------------------------------------------------------------------
# These options allow settings to be loaded from files other than the
# default postgresql.conf.
#include_dir = 'conf.d' # include files ending in '.conf' from
# directory 'conf.d'
#include_if_exists = 'exists.conf' # include file only if it exists
#include = 'special.conf' # include file
#------------------------------------------------------------------------------
# CUSTOMIZED OPTIONS
#------------------------------------------------------------------------------
# Add settings for extensions hereAsta e tot, putem porni containerele cu comanda docker-compose up -d. Sau într-o consolă separată cu comanda docker-compose up.
Deci, pachetele au fost instalate, baza a fost pornită, rămâne să le facem să colaboreze. Pentru asta, trebuie să adăugăm un fișier ormconfig.js în rădăcina proiectului, cu următorul conținut:
ormconfig.js
const process = require('process');

const username = process.env.POSTGRES_USER || "postgres";
const password = process.env.POSTGRES_PASSWORD || "example";

module.exports = {
  "type": "postgres",
  "host": "localhost",
  "port": 5432,
  username,
  password,
  "database": "postgres",
  "synchronize": true,
  "dropSchema": false,
  "logging": true,
  "entities": [__dirname + "\/src\/**\/*.entity.ts", __dirname + "\/dist\/**\/*.entity.js"],
  "migrations": ["migrations\/**\/*.ts"],
  "subscribers": ["subscriber\/**\/*.ts", "dist\/subscriber\/**\/*.js"],
  "cli": {
    "entitiesDir": "src",
    "migrationsDir": "migrations",
    "subscribersDir": "subscriber"
  }
}
Această configurație va fi folosită pentru CLI TypeORM.
Să ne oprim asupra acestei configurații în detaliu. În liniile 3 și 4, obținem numele de utilizator și parola din variabilele de mediu. Acest lucru este util atunci când aveți mai multe medii (dev, stage, prod, etc). Implicit, numele de utilizator este postgres, iar parola — example. În rest, configurația este trivială, așa că ne vom opri doar la cele mai interesante parametrii:
- synchronize — indică dacă schema bazei de date ar trebui să fie creată automat la pornirea aplicației. Fiți atenți cu această opțiune și nu o folosiți în producție, altfel veți pierde date. Această opțiune este convenabilă în timpul dezvoltării și debugării aplicației. Ca alternativă la această opțiune, puteți folosi comanda
schema:syncdin CLI TypeORM. - dropSchema — resetează schema de fiecare dată când se stabilește o conexiune. De asemenea, ca și în cazul anterior, această opțiune ar trebui folosită doar în procesul de dezvoltare și debugare a aplicației.
- entities — pe ce căi să căutăm descrierea modelelor. Rețineți că suportă căutarea după mască.
- cli.entitiesDir — directorul unde, în mod implicit, ar trebui să fie plasate modelele create din CLI TypeORM.
Pentru a putea folosi toate funcționalitățile TypeORM în aplicația noastră Nest, trebuie să importăm modulul TypeOrmModule în AppModule. Asta înseamnă că AppModule va arăta astfel:
app.module.ts
import { Module } from '@nestjs/common';
import { AppController } from './app.controller';
import { AppService } from './app.service';
import { TypeOrmModule } from '@nestjs/typeorm';
import * as process from "process";

const username = process.env.POSTGRES_USER || 'postgres';
const password = process.env.POSTGRES_PASSWORD || 'example';

@Module({
  imports: [
    TypeOrmModule.forRoot({
      type: 'postgres',
      host: 'localhost',
      port: 5432,
      username,
      password,
      database: 'postgres',
      entities: [__dirname + '/**/*.entity{.ts,.js}'],
      synchronize: true,
    }),
  ],
  controllers: [AppController],
  providers: [AppService],
})
export class AppModule {}
Așa cum ați observat, în metodă forRoot se transmite aceeași configurație pentru lucru cu baza, ca în fișierul ormconfig.ts
A mai rămas ultima retușare — să adăugăm câteva sarcini pentru lucru cu TypeORM în package.json. Ceea ce trebuie să știți este că CLI este scris în javascript și este rulat în mediu nodejs. Cu toate acestea, toate modelele și migrațiile noastre vor fi scrise în typescript. Prin urmare, este necesar să transpilez migrațiile și modelele noastre înainte de a utiliza CLI. Pentru aceasta, avem nevoie de pachetul ts-node:
yarn add -D ts-node
După aceasta, vom adăuga comenzile necesare în package.json:
"typeorm": "ts-node -r tsconfig-paths/register ./node_modules/typeorm/cli.js",
"migration:generate": "yarn run typeorm migration:generate -n",
"migration:create": "yarn run typeorm migration:create -n",
"migration:run": "yarn run typeorm migration:run"
Prima comandă, typeorm, adaugă un wrapper sub formă de ts-node pentru a rula CLI TypeORM. Celelalte comenzi sunt scurtături utile, pe care le veți folosi aproape zilnic în calitate de dezvoltator:
migration:generate — crearea unei migrații pe baza modificărilor din modelele dumneavoastră.
migration:create — crearea unei migrații goale.
migration:run — rularea migrațiilor.
Acum, chiar am terminat, am adăugat pachetele necesare, am configurat aplicația pentru a lucra cu baza atât din CLI, cât și din aplicație, iar acum am pornit SGBD-ul. A venit momentul să adăugăm logică în aplicația noastră.
Instalarea pachetelor pentru crearea CRUD
Folosind doar Nest, puteți crea un API care permite crearea, citirea, actualizarea și ștergerea unei entități. O astfel de soluție va fi maximum flexibilă, totuși, în unele cazuri, poate fi excesivă. De exemplu, dacă aveți nevoie să creați rapid un prototip, adesea puteți sacrifica flexibilitatea în favoarea vitezei de dezvoltare. Multe framework-uri oferă funcționalitatea de generare CRUD pe baza descrierii modelului de date al unei entități. Și Nest nu este o excepție! Această funcționalitate este oferită de pachetul . Posibilitățile sale sunt destul de interesante:
- instalare și configurare ușoară;
- independență de SGBD;
- un limbaj de interogare puternic cu capacități de filtrare, paginare, sortare, încărcare a relațiilor și entităților încorporate, caching etc.;
- un pachet pentru generarea interogărilor pe front-end;
- o suprascriere ușoară a metodelor controller-ului;
- o mică configurație;
- suport pentru documentația Swagger.
Funcționalitatea este împărțită în mai multe pachete:
- — pachetul de bază, care oferă decoratorul () pentru generarea rutelor, configurarea și validarea;
- — pachet care oferă un builder/parser pentru interogări utilizat pe partea frontend;
- — pachet pentru integrarea cu TypeORM, oferind serviciul de bază TypeOrmCrudService cu metode CRUD pentru lucrul cu entitățile în baza de date.
În acest ghid, vom avea nevoie de pachetele jsx/crud și jsx/crud-typeorm. Mai întâi, să le instalăm
yarn add @nestjsx/crud class-transformer class-validatorPachete și sunt necesare în această aplicație pentru a descrie declarativ regulile de transformare a instanțelor modelului și validarea cererilor de intrare, respectiv. Aceste pachete sunt de același autor, așa că interfețele sunt asemănătoare.
Implementarea efectivă a CRUD
Ca exemplu de model, vom lua lista de utilizatori. Utilizatorii vor avea următoarele câmpuri: id, username, displayName, email. id — câmp auto-incrementat, email și username — câmpuri unice. Totul este simplu! Rămâne să transformăm ideea noastră într-o aplicație Nest.
Primul pas este să creăm un modul aveau adrese de email pe domeniile, care va răspunde de gestionarea utilizatorilor. Vom folosi CLI-ul NestJS și în directorul rădăcină al proiectului nostru vom rula comanda nest g module users.
nest g module users
dmitrii@dmitrii-HP-ZBook-17-G3:~/projects/nest-rest git:(master*)$ nest g module users
CREATE /src/users/users.module.ts (82 bytes)
UPDATE /src/app.module.ts (312 bytes)
În acest modul vom adăuga un folder entities, unde vor fi modelele acestui modul. În special, vom adăuga aici fișierul user.entity.ts cu descrierea modelului utilizatorilor:
user.entity.ts
import { Column, Entity, PrimaryGeneratedColumn } from 'typeorm';

@Entity()
export class User {
  @PrimaryGeneratedColumn()
  id: string;

  @Column({unique: true})
  email: string;

  @Column({unique: true})
  username: string;

  @Column({nullable: true})
  displayName: string;
}
Pentru ca acest model să fie „văzut” de aplicația noastră, este necesar să importăm în modulul UsersModule următorul conținut: TypeOrmModule users.module.ts
users.module.ts
import { Module } from '@nestjs/common';
import { UsersController } from './controllers/users/users.controller';
import { UsersService } from './services/users/users.service';
import { TypeOrmModule } from '@nestjs/typeorm';
import { User } from './entities/user.entity';

@Module({
  controllers: [UsersController],
  providers: [UsersService],
  imports: [
    TypeOrmModule.forFeature([User])
  ]
})
export class UsersModule {}
Adică aici importăm TypeOrmModule, unde ca parametru al metodei forFeature indicăm lista modelelor care se referă la acest modul.
Rămâne să creăm entitatea corespunzătoare în baza de date. Pentru aceste scopuri, se folosește mecanismul de migrații. Pentru a crea o migrație pe baza modificărilor din modele, este necesar să executăm comanda npm run migration:generate -- CreateUserTable:
Titlu spoiler
$ npm run migration:generate -- CreateUserTable
Migrația /home/dmitrii/projects/nest-rest/migrations/1563346135367-CreateUserTable.ts a fost generată cu succes.
Finalizat în 1.96s.
Nu a fost necesar să scriem migrația manual, totul s-a întâmplat ca prin magie. Este aceasta o minune! Totuși, asta nu este tot. Să ne uităm la fișierul creat cu migrarea:
1563346135367-CreateUserTable.ts
import { MigrationInterface, QueryRunner } from "typeorm";

export class CreateUserTable1563346816726 implements MigrationInterface {

    public async up(queryRunner: QueryRunner): Promise {
        await queryRunner.query(`CREATE TABLE "user" ("id" SERIAL NOT NULL, "email" character varying NOT NULL, "username" character varying NOT NULL, "displayName" character varying, CONSTRAINT "UQ_e12875dfb3b1d92d7d7c5377e22" UNIQUE ("email"), CONSTRAINT "UQ_78a916df40e02a9deb1c4b75edb" UNIQUE ("username"), CONSTRAINT "PK_cace4a159ff9f2512dd42373760" PRIMARY KEY ("id"))`);
    }

    public async down(queryRunner: QueryRunner): Promise {
        await queryRunner.query(`DROP TABLE "user"`);
    }

}
După cum se poate observa, nu doar metoda pentru executarea migrației a fost generată automat, ci și metoda pentru revertirea acesteia. Fantastic!
Rămâne doar să aplicăm această migrație. Se face cu comanda următoare:
npm run migration:run.Totul, acum modificările schemei au fost aplicate în baza de date.
Apoi, să creăm un serviciu care va fi responsabil cu gestionarea utilizatorilor și să-l moștenim de la TypeOrmCrudService. În parametrul constructorului părinte trebuie să transmitem depozitul entității de interes, în cazul nostru Utilizator depozitul.
users.service.ts
import { Injectable } from '@nestjs/common';
import { TypeOrmCrudService } from '@nestjsx/crud-typeorm';
import { User } from '../..//entities/user.entity';
import { InjectRepository } from '@nestjs/typeorm';
import { Repository } from 'typeorm';

@Injectable()
export class UsersService extends TypeOrmCrudService{
  constructor(@InjectRepository(User) usersRepository: Repository){
    super(usersRepository);
  }
}
Acest serviciu ne va fi necesar în controler aveau adrese de email pe domeniile. Pentru a crea un controler, introduceți în consolă nest g controller users/controllers/users
nest g controller users/controllers/users
dmitrii@dmitrii-HP-ZBook-17-G3:~\/projects\/nest-rest git:(master*)$ nest g controller users\/controllers\/users
CREATE \/src\/users\/controllers\/users\/users.controller.spec.ts (486 bytes)
CREATE \/src\/users\/controllers\/users\/users.controller.ts (99 bytes)
UPDATE \/src\/users\/users.module.ts (188 bytes)
Să deschidem acest controler și să-l edităm pentru a adăuga puțină magie jsx\/crud. La clasă UsersController să adăugăm decoratorul de următorul tip:
@Crud({
  model: {
    type: User
  }
}) — acesta este decoratorul care adaugă în controler metodele necesare pentru a lucra cu modelul. Tipul modelului este specificat în câmpul model.type al configurației decoratorului.
Al doilea pas — este necesar să implementăm interfața CrudController<User>. Codul complet al controlerului arată astfel:
import { Controller } from '@nestjs\/common';
import { Crud, CrudController } from '@nestjsx\/crud';
import { User } from '..\/..\/entities\/user.entity';
import { UsersService } from '..\/..\/services\/users\/users.service';

@Crud({
  model: {
    type: User
  }
})
@Controller('users')
export class UsersController implements CrudController<User>{
  constructor(public service: UsersService){}
}
Și asta e tot! Acum controlerul suportă întreaga gamă de operațiuni cu modelul! Nu credeți? Hai să testăm aplicația noastră în acțiune!
Crearea unui scenariu de solicitări în TestMace
Pentru a testa serviciul nostru, vom folosi un IDE pentru lucrul cu API-uri. . De ce TestMace? Comparativ cu produsele similare, are următoarele avantaje:
- o gestionare puternică a variabilelor. În prezent, există mai multe tipuri de variabile, fiecare având un rol specific: variabile încorporate, variabile dinamice, variabile de mediu. Fiecare variabilă aparține unui nod cu suport pentru mecanismul de moștenire;
- crearea ușoară de scenarii fără programare. Despre acest aspect vom discuta mai jos;
- format ușor de citit, care permite salvarea proiectului în sistemele de control al versiunilor;
- completare automată, evidențierea sintaxei, evidențierea valorilor variabilelor;
- suport pentru descrierea API-ului cu posibilitatea de import din Swagger.
Hai să ne pornim serverul cu comanda npm start și să încercăm să accesăm lista utilizatorilor. Lista utilizatorilor, conform configurației controlerului nostru, poate fi obținută la URL-ul localhost:3000\/users. Să facem o solicitare la acest URL.
După rularea TestMace, ar trebui să vedeți o interfață de acest fel:
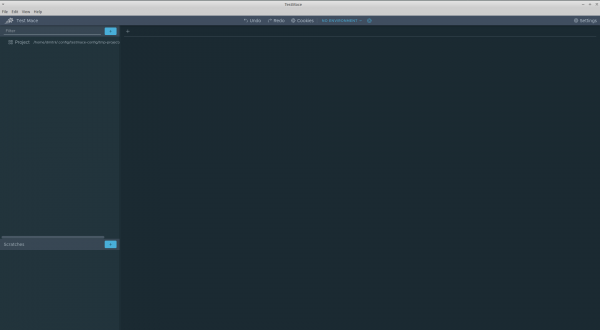
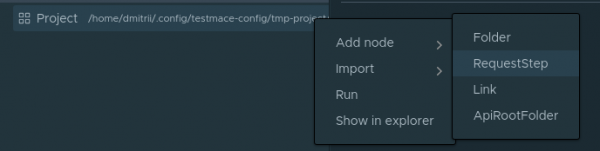
În colțul din stânga sus se află un arbore de proiecte cu nodul rădăcină. Hai să încercăm să creăm prima noastră solicitare pentru a obține lista utilizatorilor. Pentru aceasta, vom crea nodul. Acest lucru se face în meniul contextual al nodului Project. Add node -> RequestStep.
În câmpul URL introduceți localhost:3000/users și efectuați cererea. Vom obține codul 200 cu un array gol în corpul răspunsului. Ce este de așteptat, nu am adăugat pe nimeni încă.
Să creăm un scenariu care va include următorii pași:
- crearea unui utilizator;
- cererea după id-ul utilizatorului tocmai creat;
- ștergerea după id a utilizatorului creat la pasul 1.
Așadar, să începem. Pentru confort, să creăm un nod de tip . Practic, aceasta este doar o folder în care vom salva întregul scenariu. Pentru a crea un nod Folder, este necesar să selectați în meniul contextual al nodului Project Adăugați nod -> Folder. Să numim nodul check-create. În interiorul nodului check-create vom crea prima noastră cerere pentru crearea unui utilizator. Să numim noul nod creat create-user. Adică, în acest moment, ierarhia nodurilor va arăta astfel:
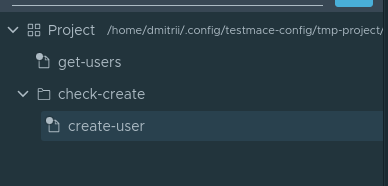
Hai să trecem la fila nodului deschis. create-user Vom introduce următoarele parametru pentru cerere:
- Tip cerere — POST
- URL — localhost:3000/users
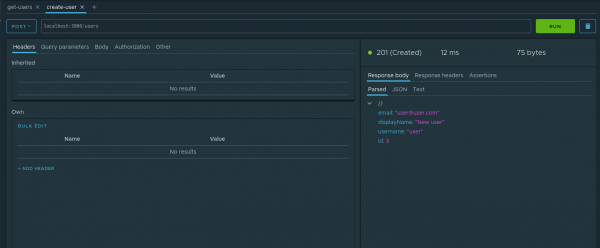
- Body — JSON cu valoarea
{"email": "user@user.com", "displayName": "Utilizator nou", "username": "user"}
Vom efectua această cerere. Aplicația noastră spune că înregistrarea a fost creată.
Ei bine, să verificăm acest fapt. Pentru a opera cu id-ul utilizatorului creat în pașii următori, acest parametru trebuie salvat. Mecanismul perfect pentru aceasta este . Să analizăm, cu exemplul nostru, cum funcționează acestea. În fila răspunsului analizat a nodului id, în meniul contextual trebuie să selectați opțiunea Atribuie variabilei. În fereastra de dialog trebuie să specificați următoarele parametru:
- Node — în care dintre strămoși să creăm variabila dinamică. Vom alege check-create
- Numele variabilei — denumirea acestei variabile. Să o numim
userId.
Iată cum arată procesul de creare a unei variabile dinamice:
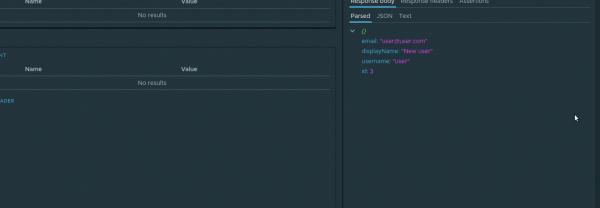
Acum, la fiecare execuție a acestei cereri, valoarea variabilei dinamice se va actualiza. Și cum variabilele dinamice suportă mecanismul de moștenire ierarhică, variabila userId va fi disponibilă în urma check-create nodului de orice nivel de adâncime.
În cererea următoare, această variabilă ne va fi utilă. Anume, vom solicita utilizatorul nou creat. Ca descendant al nodului check-create vom crea cererea check-if exists cu parametrul url egal cu localhost:3000/users/${$dynamicVar.userId}. Construcția de tip ${variable_name} reprezintă obținerea valorii variabilei. Cum avem o variabilă dinamică, pentru a o obține trebuie să ne adresăm obiectului $dynamicVar, adică un apel complet la variabila dinamică userId va arăta astfel ${$dynamicVar.userId}. Să facem cererea și să ne asigurăm că datele sunt solicitate corect.
Rămâne ultimul detaliu — să facem cererea de ștergere. Este necesară nu doar pentru a verifica funcționarea ștergerii, ci și, să spunem, pentru a curăța baza, deoarece câmpurile email și username sunt unice. Așadar, în nodul check-create, vom crea cererea delete-user cu următorii parametri
- Tipul cererii — DELETE
- URL —
localhost:3000/users/${$dynamicVar.userId}
Lansăm. Așteptăm. Ne bucurăm de rezultat)
Acum putem să rulăm întregul scenariu oricând. Pentru a rula scenariul, trebuie să selectăm din meniul contextual check-create elementul nodului Run.
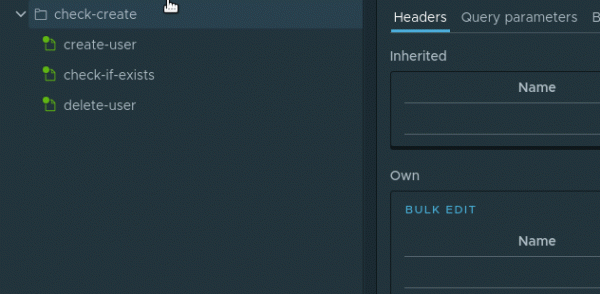
Nodurile din scenariu se vor executa unul după altul
Acest scenariu îl puteți salva în proiectul vostru, executând File -> Save project.
Concluzie
În formatul acestui articol nu au putut fi incluse toate caracteristicile instrumentelor utilizate. Cât despre principalul vinovat — pachetul jsx/crud — au rămas neexplorate următoarele subiecte:
- validarea personalizată și transformarea modelelor;
- un limbaj puternic de interogare și utilizarea sa comodă pe front;
- supra-scrierea și adăugarea de metode noi în controlerele crud;
- suport pentru swagger;
- gestionarea cache-ului.
Cu toate acestea, chiar și cele descrise în articol sunt suficiente pentru a înțelege că un cadru enterprise precum NestJS are în rezervă instrumente pentru prototiparea rapidă a aplicațiilor. Iar o IDE grozavă precum susține menținerea ritmului stabilit.
Codul sursă al acestui articol, împreună cu proiectul , este disponibil în repository . Pentru a deschide proiectul este suficient să executați în aplicație File -> Open project.
Sursa: habr.com
