

Bună ziua, locuitorii din Khabrovsk. Cursurile din prima grupă a cursului încep astăzi . În acest sens, am dori să vă spunem despre modul în care s-a desfășurat webinarul deschis despre acest curs.
В am vorbit despre provocările cu care se confruntă bazele de date SQL în era cloud-urilor și Kubernetes. În același timp, am analizat modul în care bazele de date SQL se adaptează și se mută sub influența acestor provocări.
Webinarul a avut loc , Google Cloud Practice Delivery Manager la EPAM Systems.
Când copacii erau mici...
În primul rând, să ne amintim cum a început alegerea DBMS la sfârșitul secolului trecut. Totuși, acest lucru nu va fi dificil, deoarece alegerea unui SGBD în acele zile a început și s-a încheiat Oracol.
La sfârșitul anilor 90 și începutul anilor 2, nu a existat, în esență, de ales când vine vorba de bazele de date scalabile industriale. Da, au existat IBM DBXNUMX, Sybase și alte baze de date care au venit și au plecat, dar în general nu au fost atât de vizibile pe fundalul Oracle. În consecință, abilitățile inginerilor din acele vremuri erau oarecum legate de singura alegere care exista.
Oracle DBA trebuia să poată:
- instalați Oracle Server din kitul de distribuție;
- configurați Oracle Server:
- init.ora;
- ascultător.ora;
- crea:
- tablespaces;
- scheme;
- utilizatorii;
— efectuați backup și restaurare;
— efectuarea monitorizării;
— tratați cererile suboptimale.
În același timp, nu a existat nicio cerință specială de la Oracle DBA:
- să poată alege SGBD-ul optim sau altă tehnologie pentru stocarea și procesarea datelor;
- să ofere disponibilitate ridicată și scalabilitate orizontală (aceasta nu a fost întotdeauna o problemă DBA);
- bune cunoștințe ale domeniului, infrastructurii, arhitecturii aplicațiilor, OS;
- încărcați și descărcați date, migrați datele între diferite SGBD.
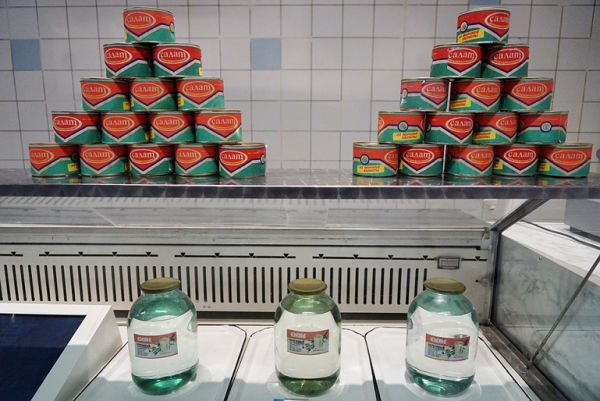
În general, dacă vorbim despre alegerea din acele zile, seamănă cu alegerea dintr-un magazin sovietic la sfârșitul anilor 80:
Timpul nostru
De atunci, desigur, copacii au crescut, lumea s-a schimbat și a devenit ceva de genul:
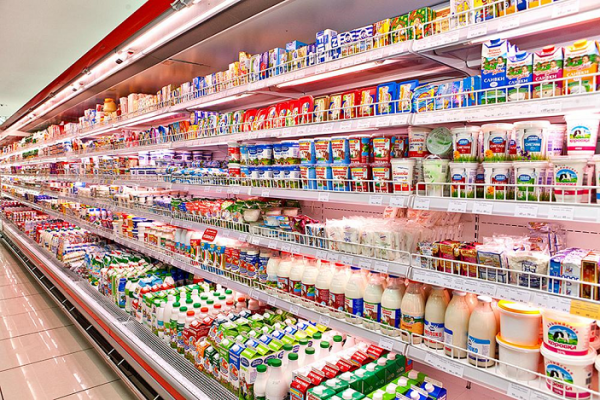
Piața DBMS s-a schimbat și ea, așa cum se poate vedea clar din ultimul raport de la Gartner:
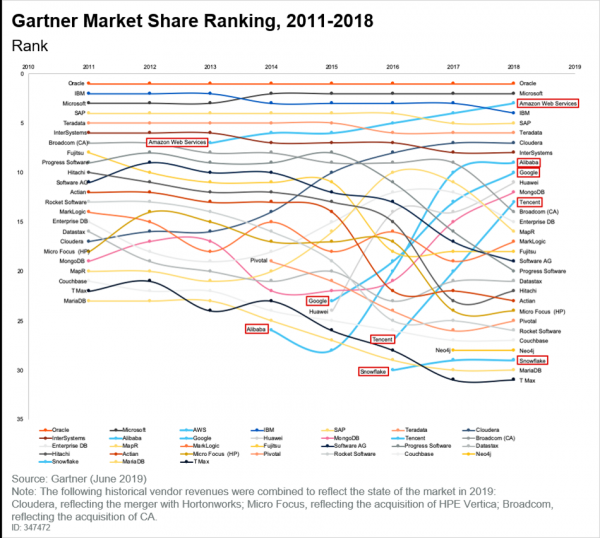
Și aici trebuie remarcat faptul că norii, a căror popularitate este în creștere, și-au ocupat nișa. Dacă citim același raport Gartner, vom vedea următoarele concluzii:
- Mulți clienți sunt pe calea mutarii aplicațiilor în cloud.
- Noile tehnologii apar pentru prima dată în cloud și nu este un fapt că vor trece vreodată la infrastructura non-cloud.
- Modelul de prețuri cu plata pe măsură a devenit obișnuit. Toată lumea vrea să plătească doar pentru ceea ce folosește, iar aceasta nu este nici măcar o tendință, ci pur și simplu o declarație de fapt.
Ce acum?
Astăzi suntem cu toții în nor. Iar întrebările care apar pentru noi sunt întrebări de alegere. Și este uriaș, chiar dacă vorbim doar despre alegerea tehnologiilor DBMS în format On-premises. Avem, de asemenea, servicii gestionate și SaaS. Astfel, alegerea devine doar mai dificilă în fiecare an.
Pe lângă întrebările de alegere, există și factori limitatori:
- preț. Multe tehnologii încă costă bani;
- aptitudini. Dacă vorbim de software liber, atunci se pune problema abilităților, deoarece software-ul liber necesită suficientă competență din partea oamenilor care îl implementează și îl operează;
- funcţional. Nu toate serviciile care sunt disponibile în cloud și construite, de exemplu, chiar și pe același Postgres, au aceleași caracteristici ca și Postgres On-premises. Acesta este un factor esențial care trebuie cunoscut și înțeles. Mai mult, acest factor devine mai important decât cunoașterea unor capacități ascunse ale unui singur SGBD.
Ce se așteaptă acum de la DA/DE:
- bună înțelegere a domeniului de studiu și a arhitecturii aplicațiilor;
- capacitatea de a selecta corect tehnologia DBMS adecvată, ținând cont de sarcina la îndemână;
- capacitatea de a selecta metoda optimă de implementare a tehnologiei selectate în contextul limitărilor existente;
- capacitatea de a efectua transfer de date și migrare;
- capacitatea de a implementa și opera soluții selectate.
Mai jos exemplu bazat pe GCP demonstrează cum funcționează alegerea uneia sau a altei tehnologii pentru lucrul cu date în funcție de structura acesteia:
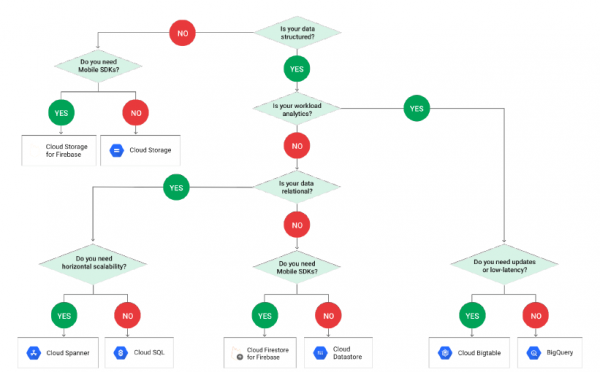
Vă rugăm să rețineți că PostgreSQL nu este inclus în schemă și acest lucru se datorează faptului că este ascuns sub terminologie CloudSQL. Și când ajungem la Cloud SQL, trebuie să facem din nou o alegere:
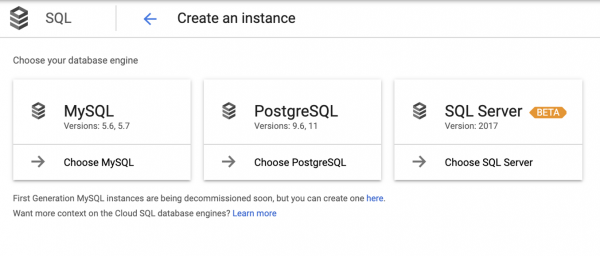
Trebuie remarcat faptul că această alegere nu este întotdeauna clară, așa că dezvoltatorii de aplicații sunt adesea ghidați de intuiție.
Total:
- Cu cât mergi mai departe, cu atât problema alegerii devine mai presantă. Și chiar dacă te uiți doar la GCP, servicii gestionate și SaaS, atunci o mențiune despre RDBMS apare doar la pasul 4 (și acolo Spanner este în apropiere). În plus, alegerea PostgreSQL apare în pasul 5, iar lângă ea sunt și MySQL și SQL Server, adică sunt multe de toate, dar trebuie să alegi.
- Nu trebuie să uităm de restricții pe fondul ispitelor. Practic, toată lumea vrea o cheie, dar este scumpă. Ca rezultat, o cerere tipică arată cam așa: „Vă rugăm să ne faceți un Spanner, dar pentru prețul Cloud SQL, sunteți profesioniști!”
Dar ce să faci?
Fără a pretinde că este adevărul suprem, să spunem următoarele:
Trebuie să ne schimbăm abordarea asupra învățării:
- nu are rost să predați modul în care DBA-urile erau predate înainte;
- cunoașterea unui produs nu mai este suficientă;
- dar cunoașterea zecilor la nivelul unuia este imposibil.
Trebuie să știți nu numai și nu cât de mult este produsul, ci:
- cazul de utilizare al aplicării sale;
- diferite metode de implementare;
- avantajele și dezavantajele fiecărei metode;
- produse similare și alternative pentru a face o alegere informată și optimă și nu întotdeauna în favoarea unui produs familiar.
De asemenea, trebuie să fiți capabil să migrați datele și să înțelegeți principiile de bază ale integrării cu ETL.
caz real
În trecutul recent, a fost necesar să se creeze un backend pentru o aplicație mobilă. Până când au început lucrările la el, backend-ul fusese deja dezvoltat și era gata de implementare, iar echipa de dezvoltare a petrecut aproximativ doi ani pe acest proiect. Au fost stabilite următoarele sarcini:
- construi CI/CD;
- revizuirea arhitecturii;
- pune totul în funcțiune.
Aplicația în sine era microservicii, iar codul Python/Django a fost dezvoltat de la zero și direct în GCP. În ceea ce privește publicul țintă, s-a presupus că vor exista două regiuni - SUA și UE, iar traficul a fost distribuit prin Global Load balancer. Toate sarcinile de lucru și încărcătura de lucru de calcul au rulat pe Google Kubernetes Engine.
În ceea ce privește datele, au fost 3 structuri:
- Stocare in cloud;
- Magazin de date;
- Cloud SQL (PostgreSQL).
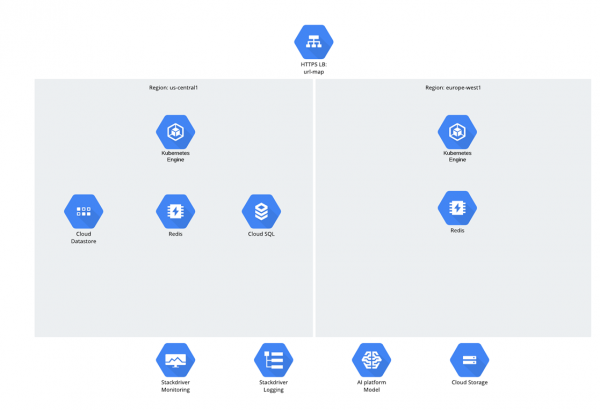
S-ar putea să se întrebe de ce a fost ales Cloud SQL? Pentru a spune adevărul, o astfel de întrebare a provocat un fel de pauză incomodă în ultimii ani - există sentimentul că oamenii au devenit timizi cu bazele de date relaționale, dar cu toate acestea continuă să le folosească activ ;-).
În cazul nostru, Cloud SQL a fost ales din următoarele motive:
- După cum am menționat, aplicația a fost dezvoltată folosind Django și are un model pentru maparea datelor persistente dintr-o bază de date SQL la obiecte Python (Django ORM).
- Cadrul în sine a susținut o listă destul de finită de SGBD-uri:
- PostgreSQL;
- MariaDB;
- MySQL;
- Oracol;
- SQLite.
În consecință, PostgreSQL a fost ales din această listă destul de intuitiv (ei bine, nu este Oracle să aleagă, într-adevăr).
Ce lipsea:
- aplicația a fost implementată doar în 2 regiuni, iar una a treia a apărut în planuri (Asia);
- Baza de date a fost localizată în regiunea Americii de Nord (Iowa);
- din partea clientului au existat preocupări cu privire la posibil întârzieri de acces din Europa şi Asia şi întreruperi în funcțiune în caz de nefuncţionare a DBMS.
În ciuda faptului că Django însuși poate lucra cu mai multe baze de date în paralel și le poate împărți în citire și scriere, în aplicație nu a fost atât de mult scris (mai mult de 90% este citit). Și în general, și în general, dacă s-a putut face read-replica a bazei principale din Europa și Asia, aceasta ar fi o soluție de compromis. Ei bine, ce e așa de complicat?
Dificultatea a fost că clientul nu a vrut să renunțe la utilizarea serviciilor gestionate și Cloud SQL. Iar capacitățile Cloud SQL sunt în prezent limitate. Cloud SQL acceptă High availability (HA) și Read Replica (RR), dar același RR este acceptat doar într-o singură regiune. După ce ai creat o bază de date în regiunea americană, nu poți face o replică citită în regiunea europeană folosind Cloud SQL, deși Postgres în sine nu te împiedică să faci acest lucru. Corespondența cu angajații Google nu a dus nicăieri și s-a încheiat cu promisiuni în stilul „știm problema și lucrăm la ea, într-o zi problema va fi rezolvată”.
Dacă enumerăm pe scurt capacitățile Cloud SQL, va arăta cam așa:
1. Disponibilitate ridicată (HA):
- în cadrul unei singure regiuni;
- prin replicarea discului;
- Motoarele PostgreSQL nu sunt folosite;
- control automat și manual posibil - failover/failback;
- La comutare, SGBD-ul este indisponibil timp de câteva minute.
2. Citiți replica (RR):
- în cadrul unei singure regiuni;
- standby la cald;
- Replicare în flux PostgreSQL.
În plus, după cum se obișnuiește, atunci când alegi o tehnologie te confrunți mereu cu unele restricții:
- clientul nu a dorit să creeze entități și să folosească IaaS, decât prin GKE;
- clientul nu ar dori să implementeze autoservire PostgreSQL/MySQL;
- Ei bine, în general, Google Spanner ar fi destul de potrivit dacă nu ar fi pentru prețul său, cu toate acestea, Django ORM nu poate funcționa cu el, dar este un lucru bun.
Având în vedere situația, clientul a primit o întrebare ulterioară: „Poți să faci ceva similar, astfel încât să fie ca Google Spanner, dar să funcționeze și cu Django ORM?”
Opțiunea de soluție nr. 0
Primul lucru care mi-a venit în minte:
- rămâneți în cadrul CloudSQL;
- nu va exista o replicare încorporată între regiuni sub nicio formă;
- încercați să atașați o replică la un Cloud SQL existent de către PostgreSQL;
- lansați o instanță PostgreSQL undeva și cumva, dar cel puțin nu atingeți master.
Din păcate, s-a dovedit că acest lucru nu se poate face, deoarece nu există acces la gazdă (este într-un proiect cu totul diferit) - pg_hba și așa mai departe și, de asemenea, nu există acces sub superutilizator.
Opțiunea de soluție nr. 1
După o reflecție suplimentară și ținând cont de circumstanțele anterioare, trenul de gândire s-a schimbat oarecum:
- Încă încercăm să rămânem în CloudSQL, dar trecem la MySQL, deoarece Cloud SQL by MySQL are un master extern, care:
— este un proxy pentru MySQL extern;
- arată ca o instanță MySQL;
- inventat pentru migrarea datelor din alte cloud-uri sau On-premises.
Deoarece configurarea replicării MySQL nu necesită acces la gazdă, în principiu totul a funcționat, dar a fost foarte instabil și incomod. Și când am mers mai departe, a devenit complet înfricoșător, pentru că am desfășurat întreaga structură cu terraform și brusc s-a dovedit că maestrul extern nu era susținut de terraform. Da, Google are un CLI, dar din anumite motive totul a funcționat aici din când în când - uneori este creat, alteori nu este creat. Poate pentru că CLI-ul a fost inventat pentru migrarea datelor externe și nu pentru replici.
De fapt, în acest moment a devenit clar că Cloud SQL nu este deloc potrivit. După cum se spune, am făcut tot ce am putut.
Opțiunea de soluție nr. 2
Deoarece nu a fost posibil să rămânem în cadrul Cloud SQL, am încercat să formulăm cerințe pentru o soluție de compromis. Cerințele s-au dovedit a fi următoarele:
- lucru în Kubernetes, utilizarea maximă a resurselor și capabilităților Kubernetes (DCS, ...) și GCP (LB, ...);
- lipsa balastului de la o grămadă de lucruri inutile în cloud, cum ar fi proxy HA;
- capacitatea de a rula PostgreSQL sau MySQL în regiunea principală HA; în alte regiuni - HA din RR a regiunii principale plus copia acesteia (pentru fiabilitate);
- multi master (nu am vrut să-l contactez, dar nu a fost foarte important)
.
Ca urmare a acestor cereri, pSGBD adecvate și opțiuni de legare:
- MySQL Galera;
- GândaciDB;
- Instrumente PostgreSQL
:
- pgpool-II;
— Patroni.
MySQL Galera
Tehnologia MySQL Galera a fost dezvoltată de Codership și este un plugin pentru InnoDB. Particularitati:
- multi master;
- replicare sincronă;
- citirea din orice nod;
- înregistrare la orice nod;
- mecanism HA încorporat;
- Există o diagramă Helm de la Bitnami.
GândacDB
Conform descrierii, chestia este absolut bombă și este un proiect open source scris în Go. Principalul participant este Cockroach Labs (fondat de oameni de la Google). Acest SGBD relațional a fost proiectat inițial pentru a fi distribuit (cu scalare orizontală din cutie) și tolerant la erori. Autorii săi de la companie au subliniat scopul de a „combina bogăția funcționalității SQL cu accesibilitatea orizontală familiară soluțiilor NoSQL”.
Un bonus frumos este suportul pentru protocolul de conectare post-gres.
Pgpool
Acesta este un add-on pentru PostgreSQL, de fapt, o nouă entitate care preia toate conexiunile și le procesează. Are propriul său echilibrator de încărcare și parser, licențiat sub licența BSD. Oferă oportunități ample, dar arată oarecum înfricoșător, deoarece prezența unei noi entități ar putea deveni sursa unor aventuri suplimentare.
Patroni
Acesta este ultimul lucru pe care mi-au căzut ochii și, după cum s-a dovedit, nu în zadar. Patroni este un utilitar open source, care este în esență un demon Python care vă permite să mențineți automat clustere PostgreSQL cu diferite tipuri de replicare și schimbare automată a rolurilor. Lucrul s-a dovedit a fi foarte interesant, deoarece se integrează bine cu cuberul și nu introduce nicio entitate nouă.
Ce ai ales pana la urma?
Alegerea nu a fost ușoară:
- GândacDB - foc, dar întuneric;
- MySQL Galera - nici nu e rau, este folosit in multe locuri, dar MySQL;
- Pgpool — o mulțime de entități inutile, integrare așa așa cu cloud-ul și K8-uri;
- Patroni - integrare excelentă cu K8s, fără entități inutile, se integrează bine cu GCP LB.
Astfel, alegerea a căzut asupra lui Patroni.
Constatări
Este timpul să rezumam pe scurt. Da, lumea infrastructurii IT s-a schimbat semnificativ, iar acesta este doar începutul. Și dacă înainte norii erau doar un alt tip de infrastructură, acum totul este diferit. Mai mult, inovațiile în cloud apar constant, vor apărea și, poate, vor apărea doar în cloud și abia atunci, prin eforturile startup-urilor, vor fi transferate în On-premises.
În ceea ce privește SQL, SQL va trăi. Aceasta înseamnă că trebuie să cunoașteți PostgreSQL și MySQL și să puteți lucra cu ele, dar și mai important este să le puteți utiliza corect.
Sursa: www.habr.com
