

Am primit o sarcină de acest tip. Este necesar să implementăm un container de stocare a datelor care să ofere următoarea funcționalitate:
- inserați un nou element
- ștergeți elementul după numărul de ordine
- obțineți elementul după numărul de ordine
- datele sunt stocate în mod sortat
Datele sunt adăugate și șterse constant, structura trebuie să asigure o viteză rapidă de lucru. La început am încercat să implementez aceasta folosind containerele standard din std. Această abordare nu a avut succes și am realizat că trebuie să implementez ceva de la zero. Singura idee care mi-a venit în minte a fost să folosesc un arbore binar de căutare. Deoarece acesta răspunde cerinței de inserare rapidă, ștergere și păstrare a datelor în mod sortat. A mai rămas doar să găsim o modalitate de a indexa toate elementele și de a regenera indecșii atunci când arborele se schimbă.
struct node_s {
    data_t data;

    uint64_t weight; // greutatea nodului

    node_t *left;
    node_t *right;

    node_t *parent;
};
În articol vor fi mai multe imagini și teorie decât cod. Codul poate fi vizionat la linkul de mai jos.
Greutate
Pentru aceasta, arborele a suferit o mică modificare, fiind adăugată o informație suplimentară despre greutate nodului. Greutatea nodului este numărul descendenților acestui nod + 1 (greutatea unui element singular).
Funcția de obținere a greutății nodului:
uint64_t bntree::get_child_weight(node_t *node) {
    if (node) {
        return node->weight;
    }

    return 0;
}
La frunză greutatea este astfel 0.
Apoi, să trecem la o reprezentare vizuală a unui astfel de arbore. În negru culoarea va indica cheia nodului (valoarea nu va fi afișată, deoarece nu este necesară), în roșu — greutatea nodului, în verde — indicele nodului.
Când arborele este gol, greutatea sa este 0. Să adăugăm un element rădăcină:
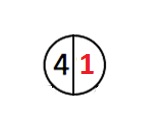
Greutatea arborelui devine 1, greutatea elementului rădăcină este 1. Greutatea elementului rădăcină este greutatea arborelui.
Să adăugăm încă câteva elemente:
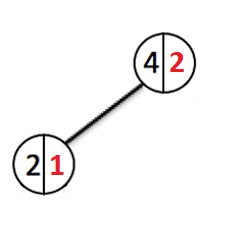
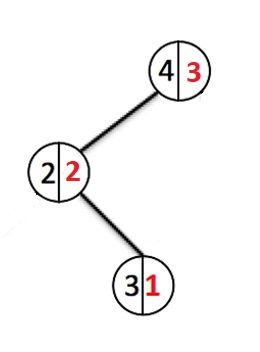
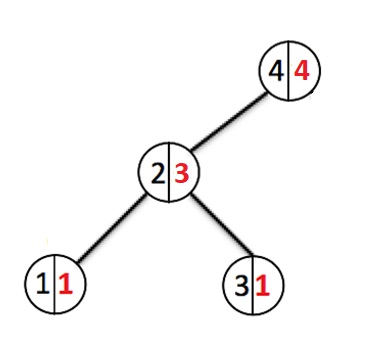
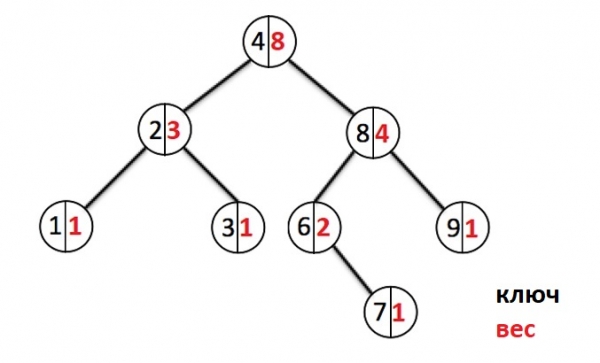
De fiecare dată când se adaugă un nou element, coborâm prin noduri și creștem contorul greutății fiecărui nod parcurs. Atunci când se creează un nou nod, acesta primește greutatea 1. Dacă un nod cu această cheie există deja, atunci vom suprascrie valoarea și ne vom întoarce la rădăcină, anulând modificările greutăților la toate nodurile pe care le-am parcurs.
Dacă se șterge un nod, atunci coborâm și decrementăm greutățile nodurilor parcurse.
Indecși
Acum să trecem la modul de a indexa nodurile. Nodurile nu păstrează în mod explicit indexul lor, acesta este calculat pe baza greutății nodurilor. Dacă ar păstra indexul, ar fi necesar O(n) timp pentru a actualiza indecșii tuturor nodurilor după fiecare modificare a arborelui.
Să trecem la o reprezentare vizuală. Arborele nostru este gol, să adăugăm primul nod:
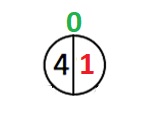
Primul nod are indexul 0, iar acum sunt posibile două cazuri. În primul, indexul elementului rădăcină se va schimba, în al doilea nu se va schimba.
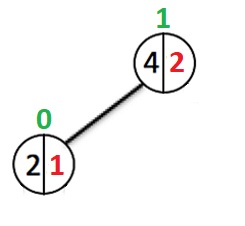
Rădăcina are un subarbore stâng cu greutatea 1.
Al doilea caz:
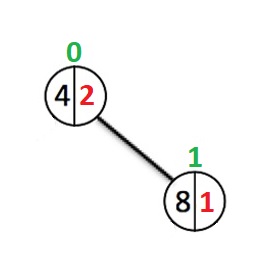
Indexul rădăcinii nu s-a schimbat, deoarece greutatea subarborelui său stâng a rămas 0.
Cum se calculează indexul unui nod, este greutatea subarborelui său stâng + numărul transmis de părintele său. Ce este acest număr? Este un contor de indecși, inițial acesta este 0, deoarece rădăcina nu are părinte. Mai departe, totul depinde de direcția în care coborâm, fie la copilul stâng, fie la cel drept. Dacă mergem la stâng, atunci contorul nu se mai mărește. Dacă mergem la dreapta, adăugăm indexul nodului curent.
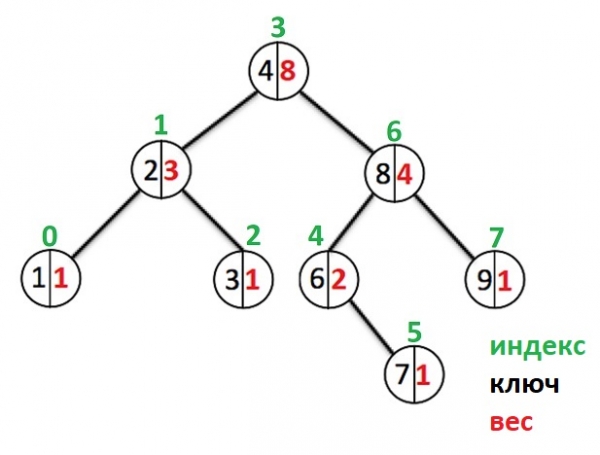
De exemplu, cum se calculează indexul elementului cu cheia 8 (copilul drept al rădăcinii). Este „Indexul rădăcinii” + „greutatea subarborelui stâng al nodului cu cheia 8” + „1” == 3 + 2 + 1 == 6
Indexul elementului cu cheia 6 va fi „Indexul rădăcinii” + 1 == 3 + 1 == 4
Prin urmare, pentru a obține sau a șterge un element după index, este necesar timpul O(log n), deoarece pentru a obține elementul dorit, mai întâi trebuie să-l găsim (să coborâm de la rădăcină până la acest element).
Adâncimea
Pe baza greutății se poate calcula și adâncimea arborelui. Este necesară pentru echilibrare.
Pentru aceasta, greutatea nodului curent trebuie rotunjită la prima putere de 2 care este mai mare sau egală cu greutatea dată și să luăm logaritmul binar al acesteia. Astfel, vom obține adâncimea arborelui, cu condiția ca acesta să fie echilibrat. Arborele se echilibrează după adăugarea unui nou element. Nu voi prezenta teoria despre cum să echilibrezi arborii. În codurile sursă este prezentată funcția de echilibrare.
Codul pentru convertirea greutății în adâncime.
/*
 * Возвращает первое число в степени 2, которое больше или ровно x
 */
uint64_t bntree::cpl2(uint64_t x) {
    x = x - 1;
    x = x | (x >> 1);
    x = x | (x >> 2);
    x = x | (x >> 4);
    x = x | (x >> 8);
    x = x | (x >> 16);
    x = x | (x >> 32);

    return x + 1;
}

/*
 * Двоичный логарифм от числа
 */
long bntree::ilog2(long d) {
    int result;
    std::frexp(d, &result);
    return result - 1;
}

/*
 * Вес к глубине
 */
uint64_t bntree::weight_to_depth(node_t *p) {
    if (p == NULL) {
        return 0;
    }

    if (p->weight == 1) {
        return 1;
    } else if (p->weight == 2) {
        return 2;
    }

    return this->ilog2(this->cpl2(p->weight));
}
Concluzii
- Adăugarea unui nou element se realizează în O(log n)
- ștergerea unui element după numărul său de ordine se realizează în O(log n)
- obținerea unui element după numărul său de ordine se realizează în O(log n)
Viteza O(log n) o plătim pentru faptul că toate datele sunt păstrate într-o formă sortată.
Nu știu unde ar putea fi utilă o astfel de structură. Este pur și simplu o sarcină pentru a înțelege cum funcționează arborii. Mulțumesc pentru atenție.
Linkuri
Proiectul conține date de test pentru a verifica viteza de funcționare. Arborele este umplut 1000000 de elemente. Și se efectuează ștergeri, inserții și obțineri secvențiale ale elementelor 1000000 de ori. Adică 3000000 operațiuni. Rezultatul s-a dovedit a fi destul de bun ~ 8 secunde.
Sursa: habr.com
