

A venit anul 2019, dar noi încă nu avem o soluție standard pentru agregarea logurilor în Kubernetes. În acest articol, ne-am propus să împărtășim căutările noastre, problemele întâmpinate și soluțiile aplicate, folosind exemple din practică.
Totuși, pentru început, trebuie să menționez că diferiți clienți înțeleg lucruri foarte diferite prin colectarea logurilor:
- unii doresc să vadă logurile de securitate și audit;
- alții — loguri centralizate ale întregii infrastructuri;
- iar unii sunt mulțumiți să colecteze doar logurile aplicației, excluzând, de exemplu, echilibrarea de sarcină.
Despre cum am implementat diverse „dorințe” și cu ce dificultăți ne-am confruntat, mai jos.
Teoria: despre uneltele pentru loguri
Povestea de fundal a componentelor sistemului de logare
Logarea a parcurs un drum lung, rezultând în metodologii de colectare și analiză a logurilor, pe care le aplicăm astăzi. Încă din anii 1950, în Fortran a apărut un echivalent al fluxurilor standard de intrare-ieșire, care ajutau programatorul în depanarea programului său. Acestea au fost primele loguri de calculator, care le-au ușurat viața programatorilor din acea vreme. Astăzi, vedem în ele primul component al sistemului de logare — sursa sau „producătorul” (producer) de loguri.
Știința calculatoarelor nu a stat pe loc: au apărut rețelele de calculatoare, primele clustere... Au început să funcționeze sisteme complexe, formate din mai multe calculatoare. Acum, administratorii de sistem erau nevoiți să colecteze loguri de pe mai multe mașini, iar în cazuri speciale puteau adăuga și mesaje ale nucleului OS, în cazul în care era necesar să investigheze o defecțiune sistematică. Pentru a descrie sistemele de colectare centralizată a logurilor, la începutul anilor 2000 a fost publicat , care a standardizat remote_syslog. Astfel, a apărut un alt component important: colectorul (sistemul de colectare) de loguri și stocarea acestora.
Odată cu creșterea volumului de loguri și implementarea pe scară largă a tehnologiilor web, a apărut necesitatea de a prezenta logurile utilizatorilor într-un mod convenabil. Astfel, instrumentele simple de linie de comandă (awk/sed/grep) au fost înlocuite de vizualizatoare de loguri — al treilea component.
În legătură cu creșterea volumului de jurnale, a devenit evident și altceva: jurnalele sunt necesare, dar nu toate. Și diferitele jurnale necesită diferite niveluri de păstrare: unele pot fi pierdute după o zi, iar altele trebuie păstrate timp de 5 ani. Astfel, în sistemul de jurnalizare a fost adăugat un component de filtrare și rutare a fluxurilor de date - să-l numim filtru.
Stocarea a făcut o salt semnificativ: de la fișiere obișnuite la baze de date relaționale, iar apoi la stocări orientate pe documente (de exemplu, Elasticsearch). Astfel, de colector s-a separat stocarea.
În cele din urmă, însăși noțiunea de jurnal s-a extins la un fel de flux abstract de evenimente pe care dorim să le păstrăm pentru istorie. Mai precis - în caz că este necesar să efectuăm o investigație sau să întocmim un raport analitic…
Astfel, într-un interval relativ scurt de timp, colectarea jurnalelor s-a dezvoltat într-un subsistem important, pe bună dreptate considerat una dintre subdisciplinele Big Data.
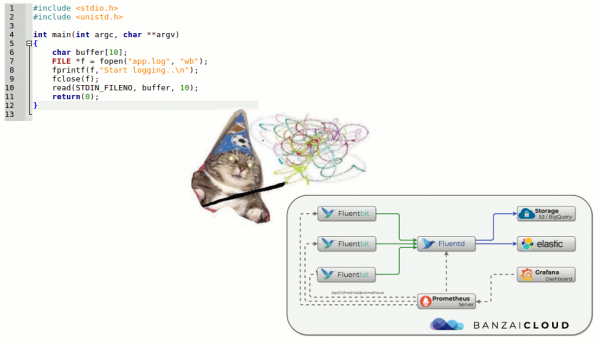
Dacă odată un simplu print ar fi fost suficient pentru „sistemul de jurnalizare”, acum situația s-a schimbat radical.
Kubernetes și jurnalele
Când infrastructura a fost adoptată de Kubernetes, problema existentă a colectării jurnalelor nu l-a ocolit nici pe el. Într-un anumit sens, a devenit chiar mai dureroasă: gestionarea platformei de infrastructură a fost nu doar simplificată, ci și în același timp complicată. Multe servicii vechi au început migrarea pe căile microserviciilor. În contextul jurnalelor, aceasta s-a tradus printr-un număr crescând de surse de jurnale, un ciclu de viață special al acestora și necesitatea de a urmări prin jurnale interconexiunile tuturor componentelor sistemului…
Privind înainte, pot constata că acum, din păcate, nu există o variantă standardizată de jurnalizare pentru Kubernetes care să se deosebească favorabil de toate celelalte. Cele mai populare scheme în comunitate se reduc la următoarele:
- cineva desfășoară un stac EFK (Elasticsearch, Fluentd, Kibana);
- cineva - încearcă recent lansatul sau folosește ;
- noi (sau poate nu doar noi?..) în mare parte ne mulțumește propria dezvoltare - …
De regulă, folosim astfel de combinații în clustere K8s (pentru soluții auto-gazduite):
- ;
- .
Cu toate acestea, nu voi aborda instrucțiunile pentru instalarea și configurarea lor. În schimb, mă voi concentra asupra dezavantajelor acestora și asupra concluziilor mai globale legate de situația generării de loguri în ansamblu.
Practicile de logare în K8s
„Loguri cotidiene”, cât de mulți sunteți?..
Colectarea centralizată a logurilor dintr-o infrastructură destul de mare necesită resurse semnificative, care vor fi utilizate pentru colectarea, stocarea și procesarea logurilor. În timpul operării diferitelor proiecte, ne-am confruntat cu diverse cerințe și probleme care decurg din acestea.
Să încercăm ClickHouse
Să luăm în considerare un depozit centralizat pentru un proiect cu o aplicație care generează loguri într-un ritm destul de activ: peste 5000 de linii pe secundă. Vom începe lucrul cu logurile sale, stocându-le în ClickHouse.
Atunci când este necesar un timp de răspuns maxim în timp real, un server cu 4 nuclei cu ClickHouse va fi deja supus unei încărcări mari pe subsistemul de stocare:
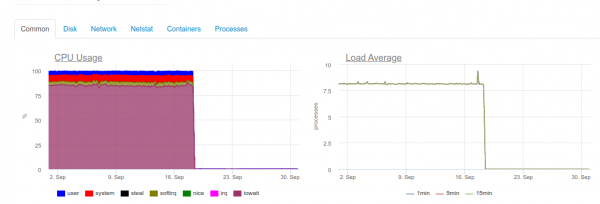
Acest tip de încărcare este legat de faptul că încercăm să scriem cât mai repede în ClickHouse. Iar baza de date reacționează la aceasta cu o încărcare crescută pe disc, din cauza căreia poate returna astfel de erori:
DB::Exception: Prea multe părți (300). Fuzionările se efectuează semnificativ mai lent decât inserțiile
Se întâmplă că din ClickHouse (unde sunt stocate datele logurilor) au propriile dificultăți în timpul operațiunilor de scriere. Datele inserate generează o partiție temporară, care apoi se fuzionează cu tabela principală. Drept rezultat, scrierea devine foarte exigentă față de disc, iar o limitare se aplică acesteia, de care am fost avertizați anterior: într-o secundă, nu pot fuziona mai mult de 300 de subpartiții (de fapt, acestea sunt 300 de inserții pe secundă).
Pentru a evita un astfel de comportament, cât mai mult posibil, în bucăți mari și nu mai des de o dată la 2 secunde. Totuși, scrierea în mari loturi presupune că trebuie să scriem mai rar în ClickHouse. Acest lucru, la rândul său, poate duce la umplerea bufferului și la pierderea logurilor. Soluția este – să creștem bufferul Fluentd, dar atunci va crește și consumul de memorie.
Notă: O altă problematică a soluției noastre cu ClickHouse a fost legată de faptul că partiționarea, în cazul nostru (loghouse), este implementată prin tabele externe, corelate . Aceasta duce la faptul că, la extragerea unor intervale mari de timp, este necesară o memorie RAM excesivă, deoarece metatabelul verifică toate partițiile — chiar și cele care, în mod evident, nu conțin datele necesare. Totuși, acum acest mod de abordare poate fi declarat cu ușurință depășit pentru versiunile actuale de ClickHouse (c ).
În cele din urmă, devine clar că pentru colectarea jurnalelor în timp real în ClickHouse, resursele nu sunt suficiente pentru fiecare proiect (mai precis, distribuția acestora nu va fi fezabilă). În plus, va fi necesar să folosim un acumulator, la care ne vom întoarce mai târziu. Cazul descris mai sus este real. Și în acel moment nu am putut oferi o soluție fiabilă și stabilă care să fie satisfăcătoare pentru client și să permită colectarea jurnalelor cu o întârziere minimă…
Dar Elasticsearch?
Este cunoscut faptul că Elasticsearch face față unor sarcini mari. Să-l încercăm în același proiect. Acum, sarcina arată astfel:
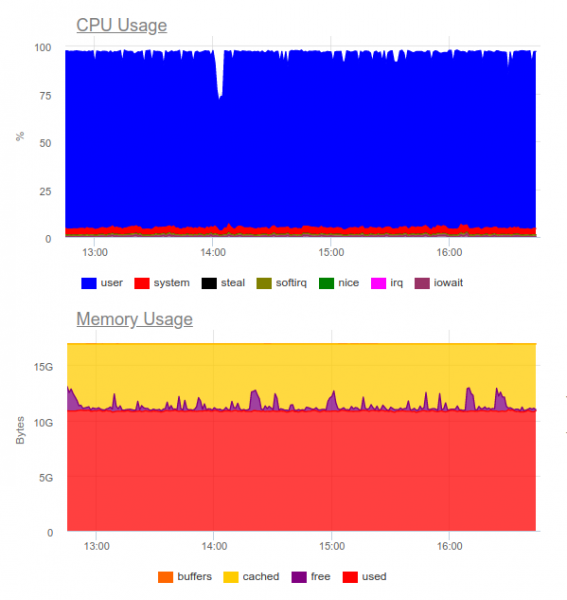
Elasticsearch a reușit să absoarbă fluxul de date, însă scrierea unor volume similare în acesta utilizează intens CPU-ul. Acest lucru se rezolvă prin organizarea unui cluster. Din punct de vedere tehnic, nu este o problemă, dar va rezulta că doar pentru funcționarea sistemului de colectare a jurnalelor, deja utilizăm aproximativ 8 nuclee și avem un component suplimentar foarte solicitat în sistem…
Concluzie: această opțiune poate fi justificată, dar doar în cazul în care proiectul este mare și conducerea sa este dispusă să investească resurse semnificative în sistemul de logare centralizată.
Atunci apare o întrebare firească:
Ce jurnale sunt cu adevărat necesare?
 Să încercăm să schimbăm abordarea: jurnalele trebuie să fie simultan informative și să nu acopere fiecare eveniment din sistem.
Să presupunem că avem un magazin online de succes. Ce jurnale sunt importante? Să colectăm maximum de informații, de exemplu, de la gateway-ul de plată — o idee excelentă. Dar de la serviciul de tăiere a imaginilor din catalogul produselor, nu toate jurnalele ne sunt critice: sunt suficiente doar erorile și monitorizarea extinsă (de exemplu, procentul de erori 500 generate de acest component).
Iată că am ajuns la concluzia că logarea centralizată nu este justificată de fiecare dată. Foarte des clientul dorește să colecteze toate jurnalele într-un singur loc, deși, de fapt, din toate jurnalele sunt necesare doar aproximativ 5% din mesajele care sunt critice pentru afacere:
- Uneori, este suficient să configurăm, să zicem, doar dimensiunea jurnalului containerului și colectorul de erori (de exemplu, Sentry).
- Pentru investigarea incidentelor, adesea poate fi suficient un avertisment de eroare și, de fapt, un jurnal local mare.
- Am avut proiecte care se descurcau exclusiv cu teste funcționale și sisteme de colectare a erorilor. Dezvoltatorilor nu le erau necesare jurnalele ca atare — tot ce aveau nevoie era vizibil în traseele de eroare.
Ilustrație din viața reală
Un exemplu bun ar putea fi o altă poveste. Am primit o solicitare de la echipa de securitate a unuia dintre clienți, care folosea deja o soluție comercială, dezvoltată cu mult înainte de implementarea Kubernetes.
A fost necesar să „împăcăm” sistemul de colectare centralizată a jurnalelor cu senzorul corporativ de detectare a problemelor — QRadar. Acest sistem poate accepta jurnale prin protocolul syslog, preluându-le de pe FTP. Totuși, nu am reușit imediat să îl integrăm cu pluginul remote_syslog pentru fluentd. (așa cum s-a dovedit, ). Problemele cu configurarea QRadar s-au aflat de partea echipei de securitate a clientului.
Ca rezultat, o parte din jurnalele critice pentru afacere erau încărcate pe FTP QRadar, iar cealaltă parte era redirecționată direct de pe noduri prin remote syslog. Pentru asta, am scris chiar — poate că acesta va ajuta pe cineva să rezolve o problemă similară… Datorită schemei rezultate, clientul însuși primea și analiza jurnalele critice (folosind instrumentele preferate), iar noi am reușit să reducem costurile sistemului de jurnalizare, păstrând doar ultima lună.
Un alt exemplu este destul de elocvent în ceea ce privește ce nu ar trebui să facem. Unul dintre clienții noștri, pentru procesarea fiecare evenimentelor primite de la utilizator, genera un output multi-liniar nestructurat de informații în jurnal. După cum este ușor de ghicit, asemenea jurnale erau extrem de greu de citit și de păstrat.
Criterii pentru jurnale
Astfel de exemple ne conduc la concluzia că, pe lângă alegerea sistemului de colectare a jurnalelor, trebuie să proiectăm și jurnalele în sine! Care sunt cerințele aici?
- Jurnalele trebuie să fie în format machine-readable (de exemplu, JSON).
- Jurnalele trebuie să fie compacte și să permită modificarea gradului de jurnalizare, pentru a depista problemele posibile. În mediile de producție, sistemele ar trebui să fie lansate cu un nivel de jurnalizare de genul Atenție sau Error.
- Jurnalele trebuie să fie normalizate, adică în obiectul jurnalului toate liniile trebuie să aibă același tip de câmp.
Jurnalele nestrucurate pot provoca probleme la încărcarea jurnalelor în stocare și pot duce la oprirea completă a procesării acestora. Ca exemplu, iată un exemplu cu eroarea 400, cu care mulți s-au confruntat în jurnalele fluentd:
2019-10-29 13:10:43 +0000 [warn]: dump an error event: error_class=Fluent::Plugin::ElasticsearchErrorHandler::ElasticsearchError error="400 - Rejected by Elasticsearch"
Eroarea înseamnă că trimiteți într-un index cu un mapping pregătit un câmp a cărui tip este instabil. Cel mai simplu exemplu este câmpul din jurnal nginx cu variabila $upstream_status. Acesta poate fi fie un număr, fie un șir. De exemplu:
{ "ip": "1.2.3.4", "http_user": "-", "request_id": "17ee8a579e833b5ab9843a0aca10b941", "time": "29/Oct/2019:16:18:57 +0300", "method": "GET", "uri": "/staffs/265.png", "protocol": "HTTP/1.1", "status": "200", "body_size": "906", "referrer": "https://example.com/staff", "user_agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/78.0.3904.70 Safari/537.36", "request_time": "0.001", "cache_status": "-", "upstream_response_time": "0.001, 0.007", "upstream_addr": "127.0.0.1:9000", "upstream_status": "200", "upstream_response_length": "906", "location": "staff"}
 { "ip": "1.2.3.4", "http_user": "-", "request_id": "47fe42807f2a7d8d5467511d7d553a1b", "time": "29/Oct/2019:16:18:57 +0300", "method": "GET", "uri": "/staff", "protocol": "HTTP/1.1", "status": "200", "body_size": "2984", "referrer": "-", "user_agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/78.0.3904.70 Safari/537.36", "request_time": "0.010", "cache_status": "-", "upstream_response_time": "0.001, 0.007", "upstream_addr": "10.100.0.10:9000, 10.100.0.11:9000", "upstream_status": "404, 200", "upstream_response_length": "0, 2984", "location": "staff"}
În jurnale se observă că serverul 10.100.0.10 a răspuns cu eroarea 404 și cererea a fost redirecționată către un alt depozit de conținut. Ca rezultat, în jurnale valoarea a devenit astfel:
"upstream_response_time": "0.001, 0.007"
Această situație este atât de răspândită încât a meritat chiar o mențiune separată în .
Și ce este cu fiabilitatea?
Există cazuri în care toate jurnalele sunt absolut necesare fără excepție. Și cu schemele tipice de colectare a jurnalelor pentru K8s, menționate/considerate mai sus, există probleme.
De exemplu, fluentd nu poate colecta jurnale de la containere de scurtă durată. În unul dintre proiectele noastre, un container cu migrarea bazelor de date a trăit mai puțin de 4 secunde, după care a fost eliminat — conform adnotării corespunzătoare:
"helm.sh/hook-delete-policy": hook-succeeded
Din acest motiv, jurnalul de execuție a migrației nu a ajuns în stocare. O soluție în acest caz ar putea fi politica before-hook-creation.
Un alt exemplu este rotația jurnalelor Docker. Să presupunem că există o aplicație care scrie activ în jurnale. În condiții obișnuite reușim să procesăm toate jurnalele, dar când apare o problemă — de exemplu, cea descrisă mai sus cu un format incorect — procesarea se oprește și Docker rotește fișierul. Rezultatul este că pot fi pierdute jurnale critice pentru afacere.
Exact de aceea este important să separăm fluxurile de jurnale, integrând trimiterea celor mai valoroase direct în aplicație, pentru a le asigura securitatea. În plus, nu ar strica crearea unui fel de „acumulator” de jurnale, care poate supraviețui unei disponibilități scurte a stocării, păstrând mesajele critice.
În cele din urmă, nu trebuie să uităm că orice subsistem trebuie monitorizat de calitate. Altfel, este ușor să te confrunți cu o situație în care fluentd este într-o stare CrashLoopBackOff și nu trimite nimic, ceea ce amenință pierderea informațiilor importante.
Conclusions
În acest articol, nu discutăm soluțiile SaaS precum Datadog. Multe dintre problemele descrise aici sunt deja rezolvate de companii comerciale specializate în colectarea logurilor, dar nu toți pot folosi SaaS din diferite motive. (principalele fiind costul și respectarea Legii 152-FZ).
Colectarea centralizată a logurilor pare o sarcină simplă la început, dar nu este deloc așa. Este important să ne amintim că:
- Trebuie să loghezi detaliat doar componentele critice, iar pentru celelalte sisteme poți configura monitorizarea și colectarea erorilor.
- Logurile în producție ar trebui să fie minime, pentru a nu crea o sarcină suplimentară.
- Logurile trebuie să fie mașinabilă, normalizată, având un format strict.
- Logurile cu adevărat critice ar trebui trimise pe un flux separat, care să fie distinct de cele principale.
- Trebuie să iei în considerare un acumulator de loguri, care poate preveni vârfurile de sarcină mare și va face sarcina asupra stocării mai uniformă.
Aceste reguli simple, dacă sunt aplicate peste tot, ar permite funcționarea schemelor descrise anterior — chiar dacă acestea nu includ componente importante (acumulator). Dacă nu respecți astfel de principii, sarcina va conduce cu ușurință pe tine și infrastructura la un alt component sistemic cu încărcătură mare (și în același timp puțin eficient).
P.S.
Citiți și în blogul nostru:
- «»;
- «»;
- «».
Sursa: habr.com
