

În acest articol, vă prezint gândurile mele cu privire la istoria și perspectivele de dezvoltare ale internetului, rețelele centralizate și descentralizate și, ca rezultat, o posibilă arhitectură a rețelei descentralizate de nouă generație.
Ceva nu este în regulă cu internetul
Am avut prima întâlnire cu internetul în anul 2000. Sigur, aceasta nu este începutul său — rețeaua exista deja înainte, dar acea perioadă poate fi considerată ca începutul adevărat al internetului. World Wide Web — o invenție genială a lui Tim Berners-Lee, web1.0 în forma sa clasică canonică. O mulțime de site-uri și pagini, care se referă între ele prin hyperlink-uri. La prima vedere — o arhitectură simplă, ca toate invențiile geniale: descentralizată și liberă. Vreau — navighez pe site-urile altora, urmărind hyperlink-urile; vreau — îmi creez propriul site, pe care public ceea ce mă interesează — de exemplu, articolele mele, fotografii, programe, hyperlink-uri către site-uri interesante pentru mine. Iar alții îmi plasează link-uri către mine.
S-ar părea — o imagine idilică? Dar deja știți cum s-a terminat totul.
Numărul paginilor a crescut exponențial, iar căutarea informației a devenit o sarcină destul de complicată. Hyperlink-urile scrise de autori pur și simplu nu puteau structura acest volum imens de informații. La început au apărut cataloagele, completate manual, iar apoi uriașe motoare de căutare, care au început să folosească algoritmi heuristici ingenioși pentru indexare. Site-urile au fost create și abandonate, informațiile au fost duplicate și distorsionate. Internetul s-a comercializat rapid și s-a îndepărtat tot mai mult de rețeaua academică ideală. Limbajul de marcare s-a transformat rapid într-un limbaj de formatare. A apărut reclama, bannerele enervante și tehnologia de optimizare și înșelare a motoarelor de căutare — SEO. Rețeaua s-a umplut rapid de deșeuri informaționale. Hyperlink-urile au încetat să mai fie un instrument de legătură logică și s-au transformat în instrumente de promovare. Site-urile s-au închis, s-au izolat, devenind din „pagini” deschise în „aplicații” hermetice, transformându-se în simple mijloace de generare a venitului.
At that time, I had some thought that "something is off here". A bunch of different websites, from primitive homepages with gaudy designs to "megaportals" overloaded with flashing banners. Even if the sites are on the same topic — they are completely unrelated, each with its own design, structure, annoying banners, poorly functioning search, download issues (yes, I wanted offline access to information). Even then, the internet was starting to resemble a kind of television, where all sorts of trinkets were glued to useful content.
Decentralization turned into a nightmare.
What do I want?
Paradoxically, even then, unaware of web 2.0 or p2p, I as a user did not need decentralization! Reflecting on my unclouded thoughts from that time, I conclude that I needed... a single database! One that would return all results, not just those best suited for the ranking algorithm. One where all those results would be uniformly formatted and styled with my own unique design, not the gaudy DIY designs of numerous Vasya Pupkins. A database that could be saved offline without fearing that the site will disappear tomorrow and the information will be lost forever. One where I could enter my own information — for example, comments and tags. A database where I could perform searches, sorting, and filtering using my own algorithms.
Web 2.0 and social networks
Meanwhile, the concept of Web 2.0 came onto the scene. Formulated in 2005 by Tim O'Reilly as "a design methodology for systems that become better the more people use them by taking into account network interactions" — implying active user engagement in the collective creation and editing of web content. Without exaggeration, the pinnacle and triumph of this concept became Social Networks. Gigantic platforms that unite billions of users and store hundreds of petabytes of data.
What have we gained in social networks?
- unificarea interfeței; s-a dovedit că toate opțiunile pentru crearea unui design variat și strident nu sunt necesare utilizatorilor; toate paginile tuturor utilizatorilor au același design și acest lucru este convenabil pentru toată lumea; singura diferență este conținutul.
- unificarea funcționalității; toată diversitatea scripturilor s-a dovedit a fi, de asemenea, inutilă. „Feed”, prieteni, albume… în timp ce rețelele sociale au evoluat, funcționalitatea lor s-a stabilizat și este puțin probabil să se schimbe: funcționalitatea este determinată de tipurile de activitate ale oamenilor, iar oamenii nu se schimbă prea mult.
- o bază de date unificată; lucrul cu o astfel de bază de date s-a dovedit a fi mult mai convenabil decât cu multe site-uri disparate; căutarea a devenit mult mai simplă. În loc să scanezi continuu paginile diverselor site-uri slab corelate, să cache-ui totul și să o clasifici prin algoritmi heuristici complecși - o interogare relativ simplă către o bază unificată cu o structură cunoscută.
- interfața de feedback - like-uri și redistribuiri; în web-ul obișnuit, Google nu putea obține deloc feedback de la utilizatori după ce aceștia dădeau clic pe un link în rezultatele căutării. În rețelele sociale, acest feedback s-a dovedit a fi simplu și natural.
Ce am pierdut? Am pierdut descentralizarea, ceea ce înseamnă - libertate. Se consideră că acum datele noastre nu ne mai aparțin. Dacă înainte puteam să ne publicăm pagina personală chiar pe computerul nostru, acum ne predăm toate datele gigantilor din internet.
În plus, pe măsură ce Internetul s-a dezvoltat, guvernele și corporațiile s-au arătat interesate de el, ceea ce a dus la probleme de cenzură politică și restricții de copyright. Pagini noastre din rețelele sociale pot fi blocate și șterse dacă conținutul nu respectă anumite reguli ale rețelei sociale; un post necugetat poate atrage răspundere administrativă și chiar penală.
Și acum ne întrebăm din nou: oare nu ar trebui să ne întoarcem la descentralizare? Dar într-o formă diferită, lipsită de defectele primei încercări?
Rețele de tip peer-to-peer
Primele rețele p2p au apărut cu mult înainte de web 2.0 și s-au dezvoltat paralel cu evoluția webului. Principalul utilizare clasică a p2p este schimbul de fișiere; primele rețele au fost dezvoltate pentru a face schimb de muzică. Primele rețele (precum Napster) erau, de fapt, centralizate, așa că au fost rapid închise de deținătorii de drepturi. Următorii au urmat calea descentralizării. În 2000 au apărut protocoalele ED2K (primul client eDokney) și Gnutella, iar în 2001 - protocolul FastTrack (clientul KaZaA). Treptat, gradul de descentralizare a crescut, tehnologiile s-au îmbunătățit. În locul sistemelor cu „coadă de descărcare” au venit torrentele, iar conceptul de tabele hash distribuite DHT a apărut. Pe măsură ce statul a strâns din șuruburi, anonimatul participanților a devenit mai căutat. Din 2000 se dezvoltă rețeaua Freenet, din 2003 - I2P, iar în 2006 a început proiectul RetroShare. Se pot menționa numeroase rețele p2p, atât cele care au existat anterior și au dispărut, cât și cele care funcționează acum: WASTE, MUTE, TurtleF2F, RShare, PerfectDark, ARES, Gnutella2, GNUNet, IPFS, ZeroNet, Tribbler și multe altele. Există multe. Sunt diferite. Foarte diferite - atât în scop, cât și în structură... Probabil că nu toate aceste denumiri sunt cunoscute pentru mulți dintre voi. Și aceasta nu este tot.
Cu toate acestea, rețelele p2p au numeroase dezavantaje. Pe lângă dezavantajele tehnice specifice fiecărei implementări a protocolului și clientului, se poate observa o problemă generală - dificultatea de a căuta (adică tot ce a întâmpinat Web 1.0, dar într-o variantă și mai complexă). Aici nu există Google cu căutarea sa omniprezentă și instantanee. Și dacă pentru rețelele de schimb de fișiere se poate folosi căutarea după numele fișierului sau după metainformații, găsirea unor lucruri, de exemplu, în rețelele overlay onion sau i2p, este foarte complicată, dacă nu imposibilă.
În general, dacă facem analogii cu internetul clasic, majoritatea rețelelor descentralizate sunt blocate undeva la nivelul FTP. Imaginați-vă un internet în care nu există nimic altceva decât FTP: nici site-uri moderne, nici web2.0, nici Youtube... Așa se află rețelele descentralizate. Și în ciuda unor încercări de a schimba ceva, până acum modificările sunt puține.
Conținut
Să ne îndreptăm atenția către o altă parte importantă a acestui puzzle — conținutul. Conținutul este principala problemă a oricărui site de internet, în special a celor descentralizate. De unde să-l obținem? Sigur, putem conta pe un grup de entuziaști (precum se întâmplă cu rețelele P2P existente), dar atunci dezvoltarea rețelei va fi destul de lentă, iar conținutul va fi puțin.
Lucrul cu internetul obișnuit presupune căutarea și studierea conținutului. Uneori — salvarea (dacă conținutul este interesant și util, mulți, în special cei care au venit pe rețea în timpul dial-up — inclusiv eu — salvându-l cu înțelepciune offline, pentru a nu-l pierde; căci internetul este ceva ce nu putem controla, astăzi un site există, mâine nu, astăzi un videoclip pe YouTube — mâine va fi șters, și așa mai departe.
În ceea ce privește torrentele (pe care le percepem mai degrabă ca un simplu mijloc de livrare decât ca o rețea P2P), salvarea este de fapt implicită. Și, de altfel, aceasta este una dintre problemele torrentele: un fișier descărcat o dată este greu de mutat acolo unde ar fi mai convenabil de utilizat (de obicei, trebuie să regenerați manual distribuția) și nu poate fi redenumit deloc (se poate face un hardlink, dar despre aceasta știe foarte puțină lume).
În general, mulți păstrează conținutul într-un fel sau altul. Care este soarta lui ulterioară? De obicei, fișierele salvate se regăsesc undeva pe disc, într-un folder numit Descărcări, într-o masă comună, și stau acolo împreună cu alte mii de fișiere. Asta e rău — și chiar rău pentru utilizator. Dacă internetul are motoare de căutare, atunci computerul local al utilizatorului nu are nimic de genul acesta. E bine dacă utilizatorul este ordonat și obișnuit să sortimenteze fișierele descărcate. Dar nu toți sunt așa...
De fapt, acum există și mulți care nu salvează nimic, ci se bazează complet pe online. Dar în rețelele P2P se presupune că conținutul este stocat local pe dispozitivul utilizatorului și distribuit altor participanți. Este posibil să găsim o astfel de soluție care să permită implicarea ambelor categorii de utilizatori într-o rețea descentralizată, fără a le schimba obiceiurile și, mai mult, ușurându-le viața?
Ideea este destul de simplă: ce-ar fi să creăm un instrument care să permită utilizatorilor să salveze conținut din internetul obișnuit într-un mod convenabil și transparent, prin salvarea inteligentă - cu meta-informații semantice, nu într-un morman comun, ci într-o structură specifică cu posibilitatea de a fi reorganizată ulterior, și în același timp să distribuie conținutul salvat într-o rețea descentralizată?
Să începem cu salvarea
Nu ne vom concentra pe utilizarea utilitară a internetului pentru a verifica prognozele meteo sau orarele zborurilor. Ne interesează mai mult obiectele autosuficiente și mai mult sau mai puțin imuabile - articole (de la tweet-uri/postări pe rețelele sociale și până la articole mai mari, cum este acesta de pe Habr), cărți, imagini, programe, înregistrări audio și video. De unde provine, de obicei, informația? În mod obișnuit, aceasta este
- rețelele sociale (diverse știri, note scurte - „tweet-uri”, imagini, audio și video)
- articole pe site-uri tematice (de tip Habr); resurse bune nu sunt atât de multe, de obicei aceste resurse sunt de asemenea construite pe principiul rețelelor sociale
- site-uri de știri
Ca regulă generală, există funcții standard: „like”, „share”, „distribuie în rețelele sociale” etc.
Să ne imaginăm un plugin pentru browser, care va salva în mod special tot ce am dat like, am distribuit, am salvat în „favorit” (sau am apăsat un buton special al plugin-ului, afișat în meniul browser-ului - în caz că site-ul nu are funcția de like/share/adăugare în bookmarks). Ideea principală este că pur și simplu dai like - așa cum ai făcut de milioane de ori până acum, iar sistemul salvează articolul, imaginea sau videoclipul într-un depozit offline special, iar acest articol sau imagine devine disponibil - atât pentru vizionarea offline prin intermediul unei interfețe a clientului descentralizat, cât și în însăși rețeaua descentralizată! Din punctul meu de vedere, este foarte convenabil. Fără acțiuni suplimentare, și rezolvăm simultan o mulțime de sarcini:
- salvarea conținutului valoros care ar putea fi pierdut sau șters
- umplerea rapidă a rețelei descentralizate
- agregarea conținutului din diverse surse (poți fi înregistrat pe zeci de resurse de internet, iar toate like-urile/share-urile se vor aduna într-o bază locală unică)
- structurarea conținutului care te interesează după preferințele tale reguli
Este evident că extensia pentru browser trebuie să fie adaptată structurii fiecărui site (asta este cu adevărat realizabil — deja există extensii pentru salvarea conținutului din Youtube, Twitter, VK etc.). Există puține site-uri pentru care merită să se creeze extensii personalizate. De obicei, acestea sunt rețele sociale populare (nu cred că sunt mai mult de zece) și câteva site-uri tematice de înaltă calitate, cum ar fi Habra (acestea sunt foarte puține). Cu cod deschis și specificații disponibile, dezvoltarea unei noi extensii bazate pe un șablon nu ar trebui să dureze mult. Pentru celelalte site-uri, se poate utiliza un buton universal de salvare, care ar salva întreaga pagină în mhtml — poate, după ce a curățat pagina de reclame.
Acum despre structurare
Prin "salvare inteligentă" înțeleg cel puțin salvarea cu metainformații: sursa conținutului (URL), setul de like-uri anterioare, etichete, comentarii, identificatorii acestora etc. Căci, la salvarea obișnuită, această informație se pierde... Prin sursă se poate înțelege nu doar URL-ul direct, ci și componenta semantică: de exemplu, un grup pe o rețea socială sau utilizatorul care a distribuit postarea. Extensia poate fi suficient de inteligentă pentru a utiliza aceste informații pentru structurarea și etichetarea automată. De asemenea, trebuie să înțelegem că utilizatorul poate adăuga întotdeauna unele metainformații conținutului salvat, pentru care trebuie prevăzute instrumente de interfață cât mai convenabile (am multe idei despre cum să fac asta).
Astfel, se rezolvă problema structurării și organizării fișierelor locale ale utilizatorului. Aceasta este deja o utilitate pe care o putem folosi chiar și fără p2p. Pur și simplu o bază de date offline, care știe ce, de unde și în ce context am salvat, și permite realizarea unor mici cercetări. De exemplu, găsirea utilizatorilor de pe o rețea socială externă care au dat cele mai multe like-uri la aceleași posturi ca și tine. Oferă multe rețele sociale aceste informații în mod evident?
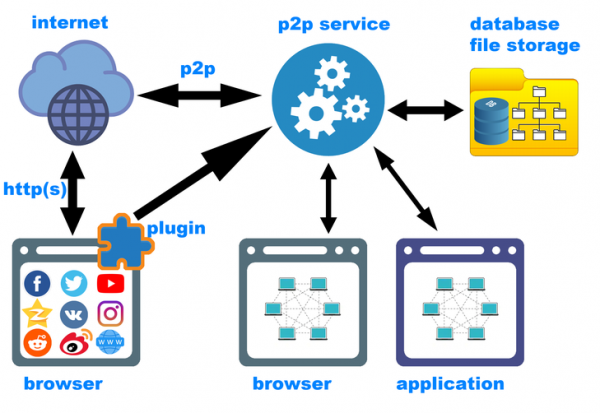
Aici trebuie menționat că un singur plugin de browser, desigur, nu este suficient. Al doilea component esențial al sistemului este un serviciu de rețea descentralizată, care funcționează în fundal și gestionează atât rețeaua p2p (cereri din rețea și cereri din partea clientului), cât și salvarea de nou conținut prin intermediul pluginului. Serviciul, lucrând împreună cu pluginul, va plasa conținutul în locul dorit, va calcula hash-urile (și poate determina că un astfel de conținut a fost deja salvat anterior), va adăuga informațiile meta necesare în baza de date locală.
Ceea ce este interesant este că sistemul ar fi util chiar și în această formă, fără p2p. Multe persoane folosesc clipere web care adaugă conținut interesant din internet, de exemplu, în Evernote. Arhitectura propusă este o variantă extinsă a unui astfel de clipper.
Și, în sfârșit, schimbul p2p
Cel mai plăcut lucru este că informația și meta-informația (atât capturate din web, cât și propriile mele) pot fi schimbate. Conceptul de rețea socială se transferă foarte bine pe arhitectura p2p. Se poate spune că rețeaua socială și p2p sunt făcute una pentru cealaltă. Orice rețea descentralizată, în ideal, ar trebui construită ca o rețea socială, doar așa va funcționa eficient. ‘Prietenii’, ‘Grupurile’ sunt aceleași noduri, cu care ar trebui să existe legături stabile, iar acestea se obțin dintr-o sursă naturală - interesele comune ale utilizatorilor.
Principiile salvării și distribuției de conținut într-o rețea descentralizată sunt complet identice cu principiile salvării (captării) conținutului din internetul obișnuit. Dacă folosiți un anumit conținut din rețea (așadar, l-ați salvat), oricine poate folosi resursele dumneavoastră (hard disk și lățimea de bandă), necesare pentru a obține acest conținut specific.
Like-uri — cel mai simplu instrument de salvare și partajare. Dacă am dat un like — nu contează, în internetul extern sau în rețeaua descentralizată — înseamnă că îmi place conținutul, iar dacă e așa — înseamnă că sunt dispus să-l păstrez local și să-l ofer altor participanți ai rețelei descentralizate.
- Conținutul nu se va ‘pierde’; acum este salvat local, pot reveni la el mai târziu, în orice moment, fără a mă preocupa că cineva l-ar putea șterge sau bloca.
- Pot să categorisez (imediat sau mai târziu) acest conținut, să-l etichetez, să-l comentez, să-l asociez cu alte materiale, în general să fac ceva semnificativ cu el - să-l numim „formarea meta-informației”
- Pot împărtăși această meta-informație cu ceilalți membri ai rețelei
- Pot sincroniza meta-informația mea cu meta-informația altor membri
Probabil că abandonarea opțiunii de dislike pare logică: dacă un conținut nu-mi place, este perfect rațional că nu vreau să-mi folosesc spațiul de pe disc pentru a-l stoca și banda mea de internet pentru a-l distribui. Deci, dislike-urile nu se integrează foarte bine în descentralizare (deși uneori, totuși, poate fi util) ).
Uneori trebuie să salvez și ceea ce „nu-mi place”. Există un cuvânt „trebuie” :)
«Bookmarks» (sau „Favorit”) - nu îmi exprim opinia despre conținut, dar îl salvez în baza mea locală de bookmarks. Cuvântul „favorit” nu este foarte potrivit din punct de vedere semantic (pentru asta există like-uri și ulterior categorisirea lor), dar „bookmarks” se potrivește perfect. Conținutul din „bookmarks” este de asemenea distribuit - dacă îți este „necesar” (adică îl „folosești” într-un fel), este logic că poate fi „necesar” și altora. De ce să nu-ți folosești resursele pentru asta?
Funcția „prieteni„ este destul de evidentă. Aceștia sunt cunoscuți, oameni cu interese similare, deci, cei care probabil vor avea conținut interesant. Într-o rețea descentralizată, asta înseamnă în primul rând abonamentul la feed-ul de știri de la prieteni și accesul la cataloagele lor (albumele) cu conținutul salvat.
Similar, funcția „grupuri„ este o formă de feeduri colective, sau forumuri, sau ceva de genul acesta, la care poți să te abonezi - și, prin urmare, să primești toate materialele grupului și să le distribui. Poate că „grupurile”, asemenea forumurilor mari, ar trebui să fie ierarhice - acest lucru ar permite o structurare mai bună a conținutului grupurilor, precum și să limiteze fluxul de informații și să nu primești/nu distribui ceea ce nu te interesează atât de mult.
Tot restul
Este important de menționat că arhitectura descentralizată este întotdeauna mai complexă decât cea centralizată. În resursele centralizate, există un dictat rigid al codului serverului. În cele descentralizate, este necesar să se negocieze între numeroși participanți egali. Desigur, nu se poate fără criptografie, blockchains și alte progrese, în mare parte dezvoltate pentru criptovalute.
Presupun că ar putea fi necesare anumite clasificări reciproce de încredere criptografică, formate de participanții rețelei pentru unii pentru alții. Arhitectura trebuie să permită o luptă eficientă împotriva botnet-urilor, care, existând în vreun cloud, pot de exemplu să-și manipuleze singure evaluările. Mi-ar plăcea ca corporațiile și fermele de botnet-uri, cu tot avansul lor tehnologic, să nu preia controlul asupra unei astfel de rețele descentralizate; să fie principala sa resursă oamenii reali, capabili să producă și să structureze conținut interesant și util pentru alți oameni.
De asemenea, mi-aș dori ca o astfel de rețea să avanseze civilizația spre progres. În această privință, am o mulțime de idei, care însă nu se încadrează în limitele acestui articol. Spun doar că, într-un anume mod, conținutul științific, tehnic, medical etc. ar trebui să aibă prioritate față de cel de divertisment, iar acest lucru va necesita o anumită moderare. Moderarea unei rețele descentralizate este o sarcină nonlineară, dar realizabilă (de fapt, cuvântul „moderare” aici este complet inadecvat și nu reflectă esența procesului - nici extern, nici intern... și nici nu am găsit o denumire pentru acest proces).
Probabil că ar fi inutil să menționez necesitatea asigurării anonimatului - atât prin mijloace încorporate (cum ar fi în i2p sau Retroshare), cât și prin redirecționarea întregului trafic prin TOR sau VPN.
Și în final, arhitectura software-ului (reprezentată schematic în imaginea din articol). Așa cum s-a menționat anterior, primul component al sistemului este un plugin pentru browser care capturează conținutul cu metainformații. Al doilea component important este un serviciu p2p care funcționează în fundal („backend”). Funcționarea rețelei nu ar trebui să depindă evident de faptul că browserul este deschis. Al treilea component este software-ul client — frontend. Acesta poate fi un serviciu web local (în acest caz, utilizatorul va putea lucra cu rețeaua descentralizată fără a ieși din browserul său preferat) sau o aplicație GUI separată specifică pentru un sistem de operare (Windows, Linux, MacOS, Android, iOS etc.). Îmi place ideea existenței simultane a tuturor variantelor de frontend. De asemenea, aceasta va impune o arhitectură mai strictă a backend-ului.
Există încă multe aspecte care nu au fost incluse în acest articol. Conectarea la distribuirea depozitelor existente de fișiere (adică atunci când ai deja câțiva terabaiți descărcați și oferi clientului să scaneze acest lucru, să obțină hash-urile, să le compare cu cele existente în Rețea și să se alăture distribuției, precum și să obțină din Rețea metainformații despre propriile fișiere — denumiri corecte, descrieri, evaluări, recenzii etc.), conectarea la surse externe de metainformație (precum bazele de date Libgen), utilizarea opțională a spațiului de stocare pentru a păstra conținut criptat al altora (ca în Freenet), arhitectura de integrare cu rețelele descentralizate existente (aici este cu adevărat o pădure întunecată), ideea de media hashing (utilizarea hash-urilor perceptrice speciale pentru conținutul media — imagini, audio și video, ceea ce va permite compararea fișierelor media cu același sens, de dimensiuni, rezoluție etc. diferite) și multe altele.
Rezumatul articolului
1. În rețelele descentralizate nu există Google cu căutarea și clasarea sa — dar există o Comunitate de oameni reali. O rețea socială cu mecanismele sale de feedback (like-uri, redistribuiri…) și graficul social (prieteni, comunități…) este modelul ideal de nivel aplicație pentru o rețea descentralizată.
2. Ideea principală pe care o aduc prin acest articol este salvarea automată a conținutului interesant din internetul obișnuit prin intermediul aprecierii/repartizării; acest lucru poate fi util și fără p2p, fiind vorba doar de gestionarea unui arhiv personal de informații interesante.
3. Acest conținut poate, de asemenea, să umple automat rețeaua descentralizată.
4. Principiul de salvare automată a conținutului interesant funcționează și atunci când se apreciază/repartizează în cadrul celei mai descentralizate rețele.
Sursa: habr.com
