

Artem Denisov ( , )
Badoo este cea mai mare platformă de întâlniri din lume. În prezent, avem aproximativ 330 de milioane de utilizatori în întreaga lume. Dar, ceea ce este mult mai important în contextul discuției noastre de astăzi, este faptul că stocăm aproximativ 3 petabai de fotografii ale utilizatorilor. În fiecare zi, utilizatorii noștri încarcă aproximativ 3,5 milioane de fotografii noi, iar încărcătura de citire este de aproximativ 80 de mii de cereri pe secundă. Asta este destul de mult pentru backend-ul nostru, iar uneori au fost dificultăți în gestionarea acesteia.
Voi vorbi despre designul acestui sistem, care stochează și livrez fotografiile în general, și voi oferi o privire asupra lui din perspectiva unui dezvoltator. Despre cum a evoluat, va exista o retrospectivă scurtă, unde voi marca principalele etape, dar voi discuta mai în detaliu doar despre soluțiile pe care le utilizăm acum.
Și acum să începem.
Așa cum am spus deja, aceasta va fi o retrospectivă, iar pentru a începe cu ceva, să luăm cel mai banal exemplu.
Avem o sarcină comună, trebuie să primim, să stocăm și să livrăm fotografiile utilizatorilor. În această formă, sarcina este generală, putem folosi orice:
- stocare cloud modernă,
- o soluție „cutie”, dintre care acum sunt foarte multe;
- putem seta câteva mașini în centrul nostru de date și să instalăm pe ele discuri dure mari pentru a stoca fotografiile acolo.
Badoo, istoric vorbind — și acum, și atunci (în perioada în care aceasta s-a născut) — funcționează pe servere proprii, în interiorul centrelor noastre de date. Prin urmare, pentru noi, această opțiune a fost optimă.
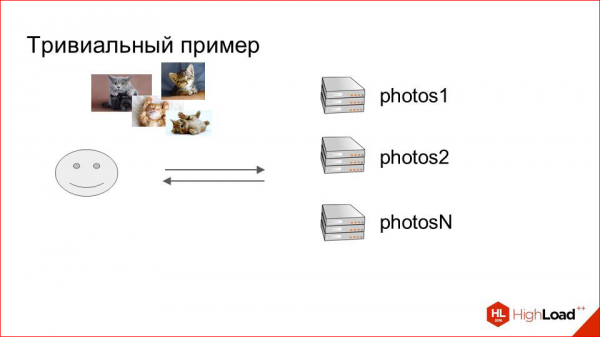
Am luat pur și simplu câteva mașini, le-am numit „photos”, iar noi am creat un cluster care stochează fotografiile. Dar, pare că ne lipsește ceva. Pentru ca toate acestea să funcționeze, trebuie să determinăm într-un fel pe ce mașină vom stoca ce fotografii. Și aici nu trebuie să descoperim America.
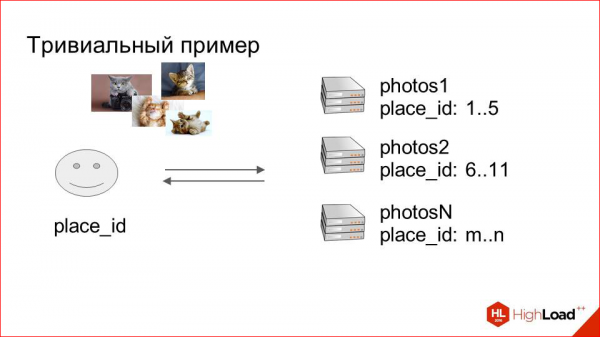
Adăugăm în stocarea noastră cu informații despre utilizatori un câmp. Acesta va fi cheia shard-ului. În cazul nostru, l-am numit place_id, iar acest id al locurilor indică locul în care sunt stocate fotografiile utilizatorilor. Ne facem hărți.
În prima etapă, acest lucru se poate face chiar manual — spunem că fotografia acestui utilizator cu un anumit loc va fi stocată pe un anumit server. Datorită acestei hărți, știm întotdeauna când utilizatorul încarcă o fotografie, unde să o salvăm și știm de unde să o livrăm.
Este o schemă absolut trivială, dar are suficiente avantaje semnificative. Primul — este simplă, cum am spus deja, iar al doilea — este că, cu această abordare, putem scala orizontal cu ușurință, pur și simplu livrând noi mașini și adăugându-le pe hartă. Nu este nevoie să facem altceva.
Așa a fost pentru o vreme.
Asta s-a întâmplat undeva în 2009. Livram mașini, livram...
Și într-un anumit moment am început să observăm că această schemă are anumite dezavantaje. Ce dezavantaje?
În primul rând, este capacitatea limitată. Pe un singur server fizic putem instala nu atât de multe hard disk-uri pe cât ne-am dori. Iar cu trecerea timpului și creșterea setului de date, aceasta a devenit o problemă.
Și al doilea. Aceasta este o configurație atipică a mașinilor, deoarece astfel de mașini sunt greu de reutilizat în alte clustere, sunt destul de specifice, adică trebuie să fie slabe din punct de vedere al performanței, dar totodată cu un hard disk mare.
Toate acestea erau valabile în 2009, dar, în principiu, aceste cerințe sunt actuale și astăzi. Avem o retrospectivă, așa că în 2009 lucrurile erau destul de slabe în această privință.
Și ultimul punct — este prețul.
Prețul era atunci foarte ridicat, și trebuia să căutăm alternative. Adică, trebuia să ne gestionăm mai bine spațiul în centrele de date și serverele fizice pe care era găzduit totul. Iar inginerii noștri de sistem au început o mare cercetare, în care au revizuit o mulțime de opțiuni diferite. Au analizat și sisteme de fișiere clusterizate, cum ar fi PolyCeph și Lustre. Au existat probleme de performanță și o utilizare destul de grea. Au renunțat. Au încercat să monteze întregul set de date prin NFS pe fiecare mașină, pentru a scalda astfel. Citirea a fost de asemenea slabă, au încercat diverse soluții de la diferiți furnizori.
Și, în final, ne-am oprit la ceea ce am început să folosim cunoscuta rețea de stocare.
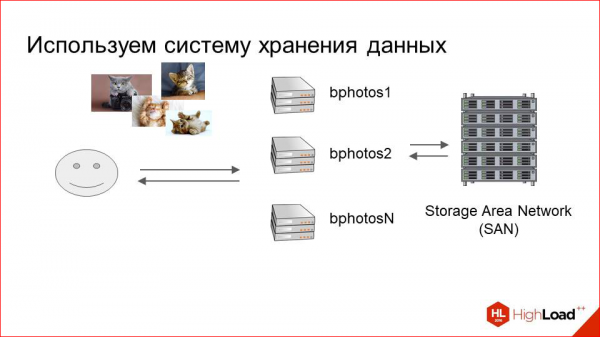
Acestea sunt SSD-uri mari, care sunt concepute pentru a stoca volume mari de date. Ele constau în rafturi cu discuri, care sunt montate pe mașini de livrare finale prin fibră optică. Astfel, avem un mic grup de mașini, iar aceste SSD-uri, care sunt transparente pentru logica noastră de livrare, adică pentru nginx-ul nostru sau altceva, răspund cererilor pentru aceste fotografii.
Această soluție a avut evident avantaje. Este un SSD. Este orientat pentru a stoca fotografii. Este mai ieftin decât atunci când configurăm pur și simplu mașini cu hard disk-uri.
Al doilea avantaj.
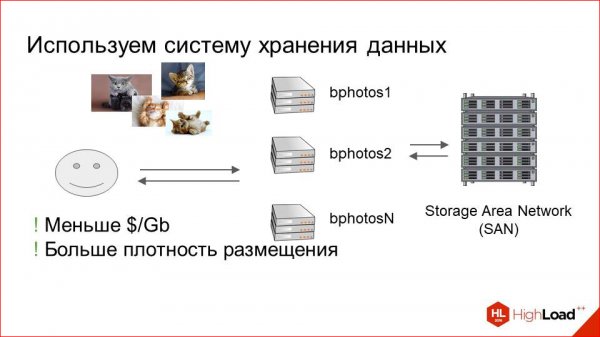
Este faptul că capacitatea a crescut semnificativ, adică putem încorpora mult mai mult storage într-un volum mult mai mic.
Dar au existat și dezavantaje, care s-au manifestat destul de repede. Cu creșterea numărului de utilizatori și a încărcării asupra acestui sistem, au început să apară probleme de performanță. Problema era destul de evidentă — orice SSD, destinat să stocheze multe fotografii într-un volum mic, de obicei suferă de solicitări intense de citire. Acest lucru este de fapt valabil și pentru orice storage în cloud, și pentru orice altceva. Acum nu există un storage perfect, care să fie scalabil infinit, în care să poți introduce orice, și care să suporte foarte bine citirile. În special citirile aleatoare.
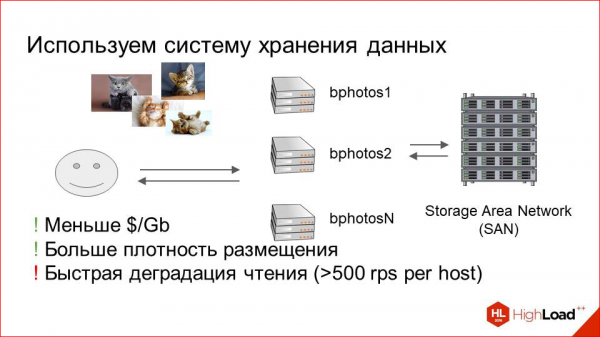
La fel ca în cazul fotografiilor noastre, pentru că fotografiile sunt solicitate necorespunzător, și acest lucru afectează foarte mult performanța lor.
Chiar și astăzi, dacă avem un volum mai mare de 500 de RPS pentru fotografii pe mașina la care este conectat storage-ul, deja încep problemele. Și acesta a fost destul de grav pentru noi, deoarece numărul utilizatorilor crește, iar totul ar trebui să devină din ce în ce mai rău. Trebuie să optimizăm acest lucru cumva.
Pentru a optimiza, am decis atunci, evident, să ne uităm la profilul de încărcare — ce se întâmplă, ce trebuie să optimizăm.
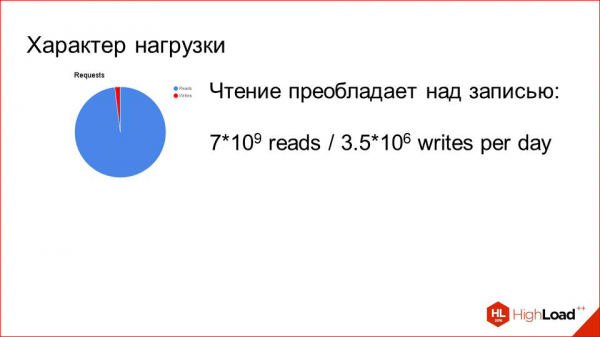
Și aici totul joacă în favoarea noastră.
În primul slide am spus deja: avem 80 de mii de cereri pe secundă pentru citire, cu doar 3,5 milioane de upload-uri pe zi. Asta este o diferență de trei ordini de măsură. Este evident că trebuie să optimizăm citirea și este practic clar cum.
Există încă un mic detaliu. Specificul serviciului este că utilizatorul se înregistrează, încarcă o fotografie, apoi începe să vizioneze activ alți oameni, îi dă like, și este expus activ altor utilizatori. Apoi, găsește o pereche sau nu, depinde de situație, și pentru o perioadă de timp încetează să folosească serviciul. În acel moment, când este activ, fotografiile sale sunt foarte căutate — sunt solicitate de foarte mulți oameni. Odată ce încetează, el este eliminat rapid din acele afișări intense către alți utilizatori, așa cum erau înainte, iar fotografiile sale practic nu mai sunt solicitate.
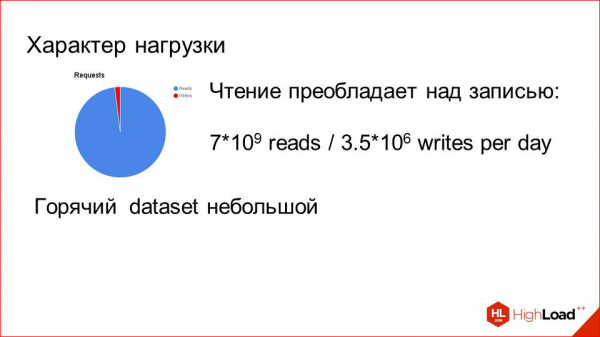
Adică, avem un set de date foarte mic, dar cu foarte multe solicitări. Și o soluție evidentă aici este să adăugăm un cache.
Cache-ul cu LRU ne va rezolva toate problemele. Ce facem?
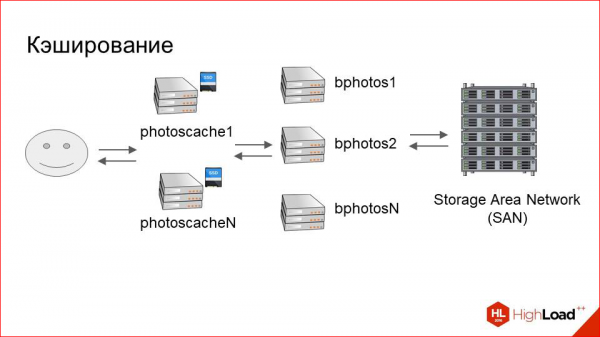
Adăugăm înaintea cluster-ului nostru mare cu storage un alt cluster relativ mic, numit photoscache. Acesta este, în esență, un proxy de caching.
Cum funcționează acest lucru din interior? Iată utilizatorul nostru, iată storage-ul. Totul e la fel ca înainte. Ce adăugăm între ele?
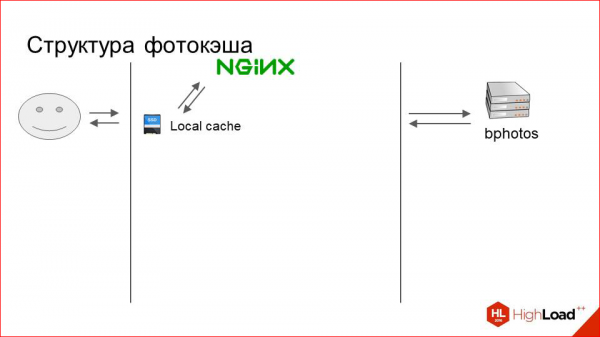
Este pur și simplu o mașină cu un disc local fizic, care este rapid. De exemplu, cu SSD. Și pe acest disc este stocat un anumit cache local.
Cum arată acest lucru? Utilizatorul trimite o solicitare pentru o fotografie. NGINX o caută mai întâi în cache-ul local. Dacă nu o găsește, folosește proxy_pass pentru storage-ul nostru, descarcă fotografia de acolo și o oferă utilizatorului.
Dar acest lucru este foarte banal și nu este clar ce se întâmplă în interior. Funcționează cam așa.
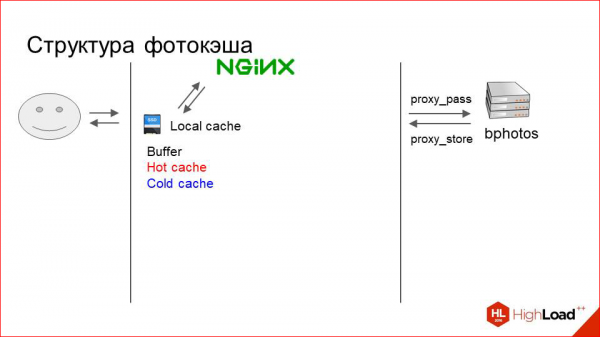
Cache-ul este logic împărțit în trei straturi. Când spun «trei straturi», nu înseamnă că este vreun sistem complicat. Nu, este pur și simplu trei directoare în sistemul de fișiere:
- Acesta este bufferul, unde ajung fotografiile proaspăt încărcate din proxy.
- Acesta este cache-ul fierbinte, unde sunt stocate fotografiile care sunt solicitate activ în prezent.
- Și cache-ul rece, unde fotografiile sunt împinse treptat din cache-ul fierbinte, atunci când primesc mai puține solicitări.
Pentru ca acest lucru să funcționeze, trebuie să gestionăm acest cache, trebuie să mutăm fotografiile în el etc. Acesta este, de asemenea, un proces foarte primitiv.
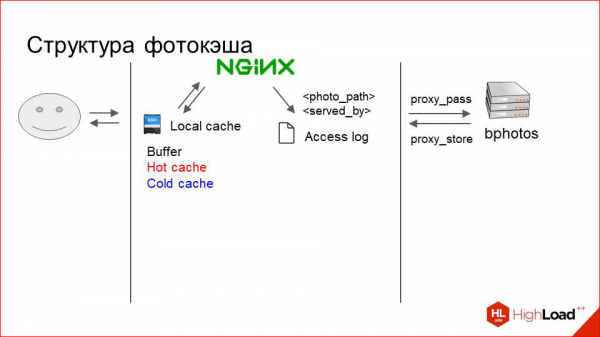
Nginx scrie pur și simplu pe fiecare cerere în RAMDisk access.log, unde indică calea către fotografia pe care o servește în acel moment (cale relativă, desigur), și modul în care a fost procesată. Adică, acolo poate fi scris „photo 1” și mai departe sau buffer, sau cache fierbinte, sau cache rece, sau proxy.
În funcție de aceasta, trebuie să luăm o decizie despre ce să facem cu fotografia.
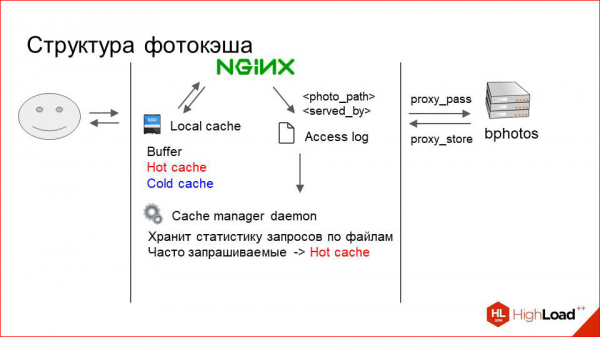
Fiecare mașină are un mic demon care citește constant acest log și își păstrează în memorie statistica utilizării anumitor fotografii.
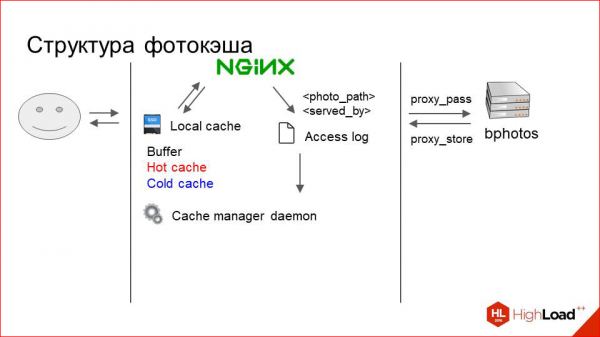
Acesta doar colectează, ține cont și face periodic următoarele. Fotografii solicitate activ, pentru care vin multe cereri, sunt mutate în cache-ul fierbinte, oriunde s-ar afla.
Fotografiile care sunt solicitate rar și au devenit și mai rare sunt împinse treptat din cache-ul fierbinte în cel rece.
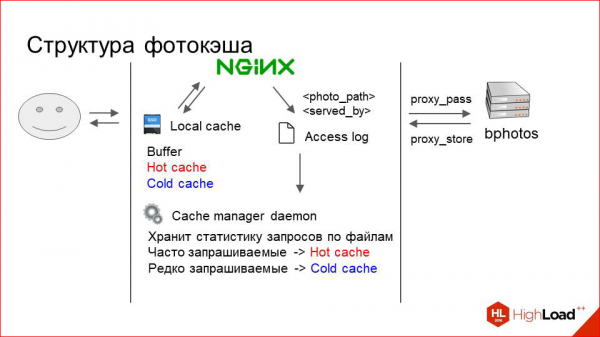
Și când nu mai avem loc în cache, începem pur și simplu să ștergem tot din cache-ul rece fără discernământ. Și, de altfel, funcționează foarte bine.
Pentru ca fotografia să fie salvată imediat la proxy-ing în buffer, folosim directiva proxy_store și bufferul — acesta este de asemenea RAMDisk, adică pentru utilizator funcționează foarte rapid. Aceasta este situația internă a serverului de caching.
Rămâne întrebarea despre cum să distribuim cererile între aceste servere.
Să spunem că avem un cluster format din douăzeci de mașini de stocare și trei servere de caching (asta s-a întâmplat).
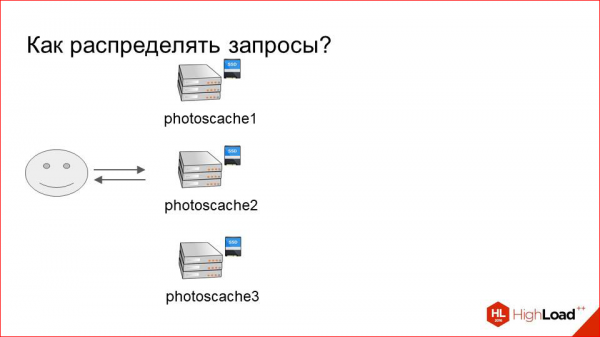
Trebuie să definim într-un fel ce cereri sunt pentru ce fotografii și unde să le direcționăm.
Cea mai banală opțiune este Round Robin. Sau ar trebui să facem întâi aleatoriu?
Este evident că acest lucru are o serie de dezavantaje, deoarece vom folosi foarte ineficient cache-ul în această situație. Cererile vor fi direcționate către mașini aleatorii: aici s-a cache-uit, pe mașina alăturată deja nu mai există. Și toate acestea, chiar și cu un număr mic de mașini în cluster, vor funcționa foarte prost.
Trebuie să definim într-un fel clar pe ce server să se direcționeze fiecare cerere.
Există o metodă simplă. Luăm hash-ul din URL sau hash-ul cheii noastre de shardare, care este în URL, și îl împărțim întreg la numărul de servere. Va funcționa? Da.
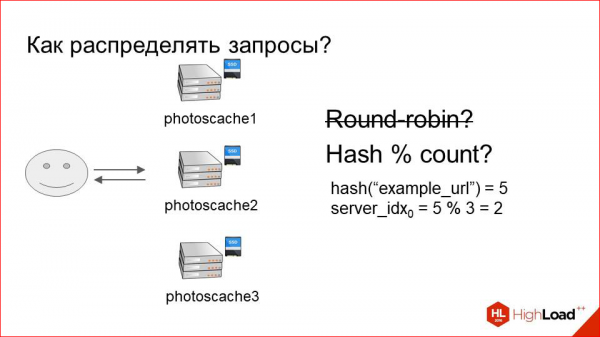
Adică, avem un request de sută la sută, de exemplu, pentru un „example_url” va ajunge întotdeauna pe serverul cu indexul „2”, iar cache-ul va fi utilizat cât mai eficient posibil.
Însă, apare o problemă cu resharding-ul în această schemă. Resharding — mă refer la schimbarea numărului de servere.
Să presupunem că clusterul nostru de caching a încetat să facă față, și am decis să adăugăm o mașină în plus.
Adăugăm.
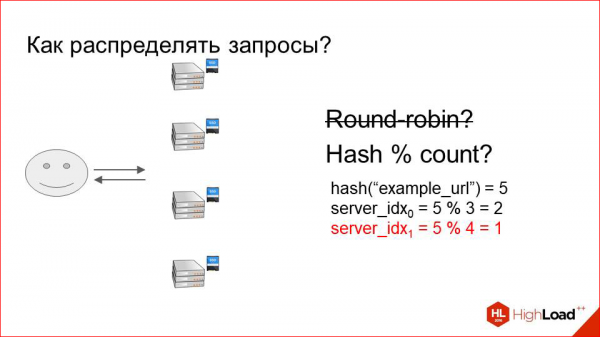
Acum totul se împarte pe întreg, nu în trei, ci în patru. Astfel, aproape toate cheile pe care le aveam, aproape toate URL-urile acum trăiesc pe alte servere. Tot cache-ul a fost invalidat instantaneu. Toate solicitările au ajuns pe clusterul nostru de stocare, a avut probleme, am avut o nefuncționare și utilizatori nemulțumiți. Nu ne dorim asta.
Această opțiune nu ne convine nici ea.
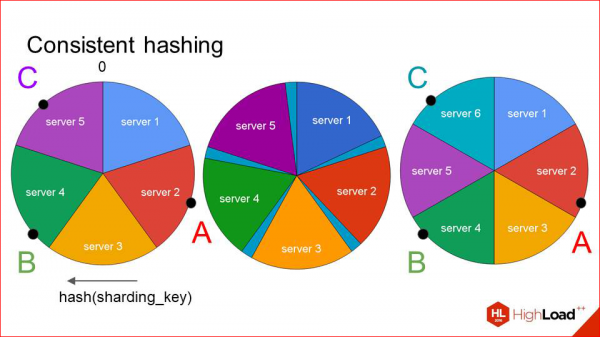
Deci, ce trebuie să facem? Trebuie cumva să utilizăm eficient cache-ul, să redirecționăm un request către același server, dar să fim în același timp rezistenți la resharding. Și există o astfel de soluție, nu este foarte complexă. Se numește hashing consistent.
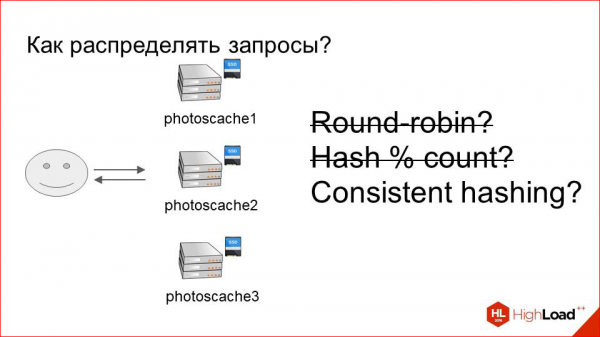
Cum arată aceasta?
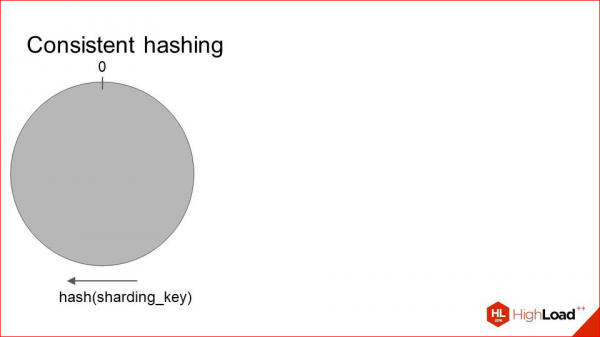
Luăm o funcție din cheia de sharding și o dispersăm pe cerc. Adică, la punctul 0 se întâlnesc valorile ei minime și maxime. Apoi, pe acelasi cerc, plasăm toate serverele noastre în mod aproximativ astfel:
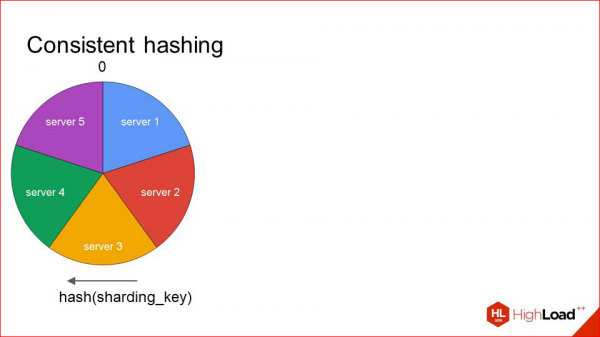
Fiecare server este definit de un punct, iar sectorul care merge până la el în sensul acelor de ceasornic, este gestionat de acel host. Când primim solicitări, vedem imediat că, de exemplu, solicitarea A — are un hash astfel — și este gestionată de serverul 2. Solicitarea B — de serverul 3. Și așa mai departe.
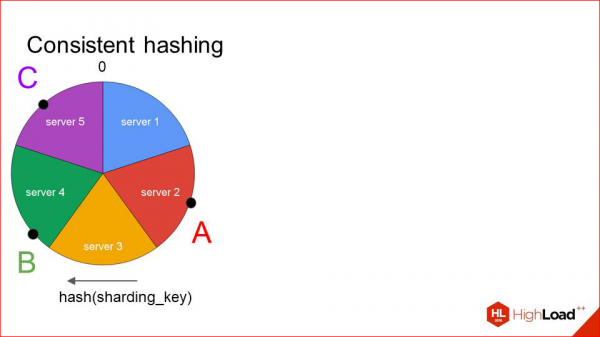
Ce se întâmplă în această situație în cazul resharding-ului?
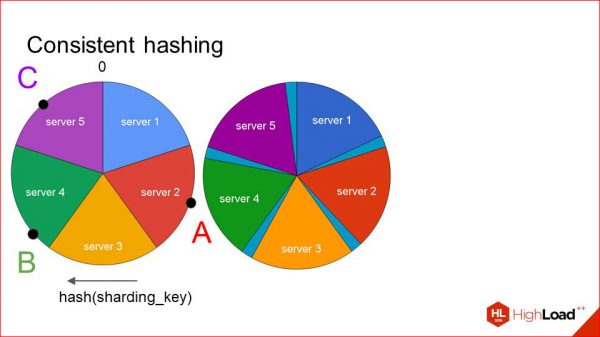
Nu invalidăm întregul cache, ca înainte, și nu mutăm toate cheile, ci mutăm fiecare sector pe o distanță mică astfel încât în spațiul eliberat, să încapă serverul nostru al șaselea, pe care dorim să-l adăugăm, și îl adăugăm acolo.
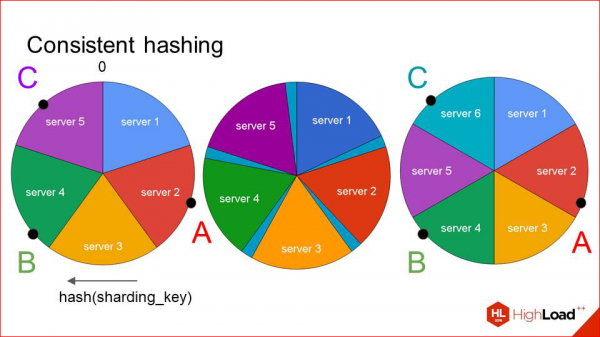
Desigur, în astfel de situații, cheile se deplasează și ele. Dar se deplasează mult mai puțin decât înainte. Și vedem că primele noastre două chei au rămas pe serverele lor, iar serverul de cache s-a schimbat doar pentru ultima cheie. Acest sistem funcționează destul de eficient, iar dacă adăugați noi gazde în mod incremental, nu există o mare problemă. Adăugați puțin câte puțin, așteptați să se umple din nou cache-ul și totul funcționează bine.
Singura întrebare care rămâne este în cazul eșecurilor. Să presupunem că avem o mașină care a ieșit din funcțiune.
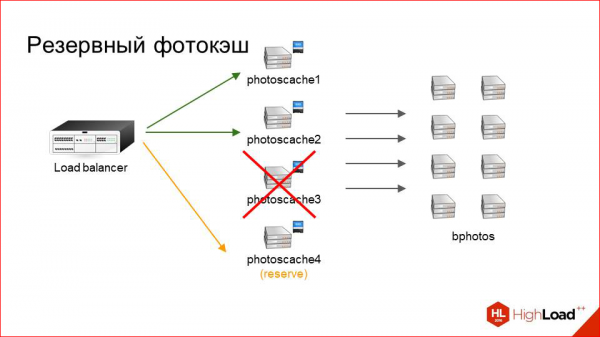
Și nu ne-ar plăcea deloc să regenerăm această hartă, să invalidăm o parte din cache și așa mai departe, dacă, de exemplu, mașina s-a repornit, iar noi trebuie cumva să gestionăm solicitările. Pur și simplu păstrăm pe fiecare site un fotocache de rezervă, care îndeplinește rolul de substitut pentru orice mașină care acum a ieșit din funcțiune. Și dacă dintr-o dată un server devine inaccesibil, traficul se îndreaptă acolo. Evident, nu avem niciun cache acolo, adică este rece, dar, cel puțin, solicitările utilizatorilor sunt procesate. Dacă acesta este un interval scurt, trecem peste asta fără probleme. Doar că crește încărcătura pe storage. Dacă intervalul este lung, putem lua decizia — să eliminăm acest server din hartă sau nu, sau poate să-l înlocuim cu altul.
Acesta este referitor la sistemul de caching. Să vedem rezultatele.
Ar părea că nu este nimic complicat aici. Dar această metodă de gestionare a cache-ului ne-a oferit o rată de succes de aproximativ 98%. Adică, din cele 80 de mii de solicitări pe secundă, doar 1600 ajung la storage-uri, și aceasta este o încărcătură absolut normală, ele suportă cu ușurință acest lucru, avem întotdeauna un rezervă.
Am instalat aceste servere în trei dintre centrele noastre de date, obținând astfel trei puncte de prezență — Praga, Miami și Hong Kong.
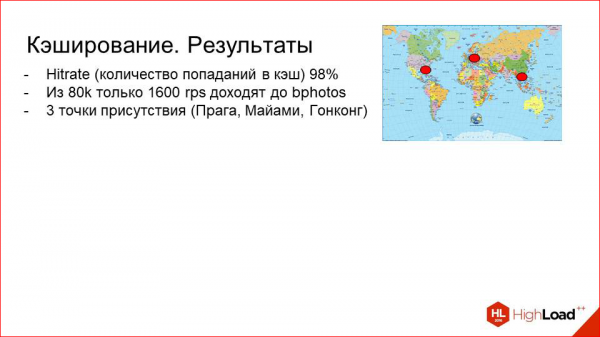
Așadar, acestea sunt situate relativ local față de fiecare dintre piețele noastre țintă.
Și ca un bonus plăcut, am obținut acest proxy de cache, pe care CPU în realitate stă degeaba, pentru că pentru livrarea conținutului nu este atât de necesar. Și acolo, cu ajutorul NGINX+ Lua, am implementat foarte multă logică utilitară.
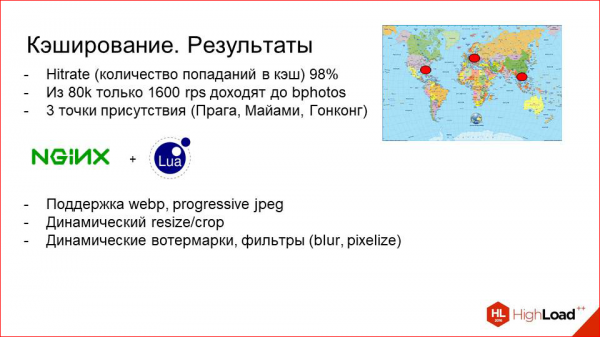
De exemplu, putem experimenta cu webp sau jpeg progresiv (acestea sunt formate moderne și eficiente), putem observa cum afectează traficul, putem lua anumite decizii, să activăm pentru anumite țări etc.; putem efectua redimensionări sau crop-uri dinamice ale fotografiilor în timp real.
Este un bun caz de utilizare, când de exemplu, aveți o aplicație mobilă care afișează fotografii, iar aplicația mobilă nu vrea să consume CPU-ul clientului pentru a solicita o fotografie mare și a o redimensiona apoi la o anumită dimensiune, astfel încât să o încadreze în vizualizare. Putem pur și simplu să specificăm dinamic în URL anumite parametrii în UPort, iar cache-ul foto se va redimensiona singur fotografia. De obicei, acesta alegerea dimensiunea care ne este fizic disponibilă pe disc, cât mai apropiată de cea solicitată, și o va scala în coordonatele specifice.
Apropo, am pus la dispoziție în mod public înregistrările video ale ultimilor cinci ani de conferințe pentru dezvoltatori de sisteme de înaltă sarcină. . Uitați-vă, explorați, împărtășiți și abonați-vă la .
De asemenea, putem adăuga multă logică de produs acolo. De exemplu, putem adăuga diferite watermark-uri pe baza parametrilor din URL, putem aplica blur fotografiilor, le putem estompa sau pixeliza. Acesta este momentul când dorim să arătăm fotografia unei persoane, dar nu dorim să-i arătăm fața, ceea ce funcționează bine, totul este implementat aici.
Ce am obținut? Am obținut trei puncte de prezență, un rate de succes bun, iar CPU-ul acestor mașini nu este acum inactiv. Acum este, desigur, mai important decât înainte. Trebuie să echipăm mașinile cu mai multă putere, dar merită.
Aceasta este viziunea în ceea ce privește livrarea fotografiilor. Aici totul este destul de clar și evident. Cred că nu am descoperit America, așa funcționează practic orice CDN.
Și, foarte probabil, ascultătorul experimentat s-ar putea întreba: de ce să nu schimbăm totul cu CDN-ul? Ar fi cam același lucru, toate CD-urile moderne pot face asta. Și aici sunt câteva motive.
Primul - acestea sunt fotografiile.
Este unul dintre aspectele cheie ale infrastructurii noastre și avem nevoie de cât mai mult control asupra lor. Dacă este o soluție de la un furnizor extern și nu aveți nici o autoritate asupra acesteia, va fi destul de greu să trăiți cu asta când aveți un dataset mare și când aveți un volum foarte mare de cereri din partea utilizatorilor.
Voi da un exemplu. Acum, pe infrastructura noastră, putem, de exemplu, în cazul unor probleme sau zgomote subterane, să intrăm pe mașină și să facem debugging acolo, așa, vorbind. Putem adăuga colectarea unor metrici care sunt doar pentru noi, putem experimenta într-un fel, vedem cum afectează graficele și așa mai departe. Acum se colectează foarte multe statistici despre acest cluster de cache. Și periodic ne uităm la ele și analizăm îndelung anumite anomalii. Dacă ar fi fost pe partea CDN, ar fi fost mult mai greu de controlat. Sau, de exemplu, în cazul unei avarii, știm ce s-a întâmplat, știm cum să trăim cu asta și cum să o depășim. Aceasta este prima concluzie.
A doua concluzie este mai degrabă istorică, deoarece sistemul evoluează de mult timp, iar multe cerințe de afaceri diferite au existat în diferite etape, și departe de a se încadra întotdeauna în conceptul CDN.
Și un punct care decurge din precedent –
Este că, pe fotocache-uri, avem multă logică specifică, pe care nu întotdeauna o putem adăuga la cerere. Este puțin probabil ca vreun CDN să adauge la cererea dvs. anumite lucruri personalizate. De exemplu, criptarea URL-urilor, dacă nu doriți ca clientul să poată schimba ceva. Doriți să schimbați URL-ul pe server și să-l criptați, iar apoi să furnizați aici anumite parametri dinamici.
Ce concluzie se impune? În cazul nostru, CDN-ul nu este o alternativă prea bună.
În cazul dvs., dacă aveți cerințe specifice de afaceri, puteți implementa fără probleme ceea ce v-am arătat. Și cu un profil de încărcare similar, va funcționa excelent.
Dar dacă aveți o soluție generală și sarcina nu este foarte specifică, puteți să folosiți cu încredere CDN. Sau dacă pentru dvs. timpul și resursele sunt mult mai importante decât controlul.
Și CDN-urile moderne au practic tot ceea ce v-am povestit acum. Cu excepția câtorva funcții mai mult sau mai puțin.
Aceasta este în legătură cu livrarea fotografiilor.
Acum să ne mutăm puțin mai departe în retrospectiva noastră și să vorbim despre stocare.
Anul 2013 a trecut.
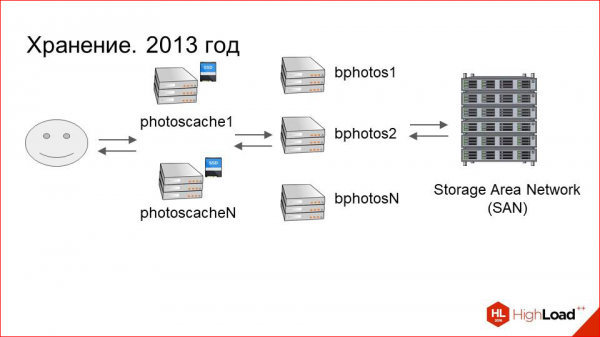
Serverele de caching s-au adăugat, problemele cu performanța au dispărut. Totul este bine. Datasetul crește. În anul 2013 aveam aproximativ 80 de servere conectate la stocări și aproximativ 40 de servere de caching în fiecare centru de date. Asta înseamnă 560 de terabytes de date în fiecare centru de date, adică în jur de un petabyte în total.
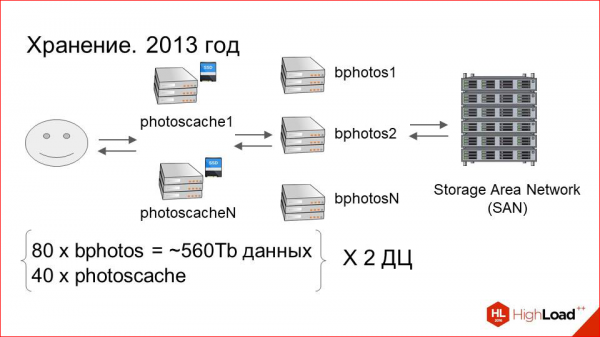
Odată cu creșterea datasetului, costurile operaționale au început să crească semnificativ. În ce a constat aceasta?
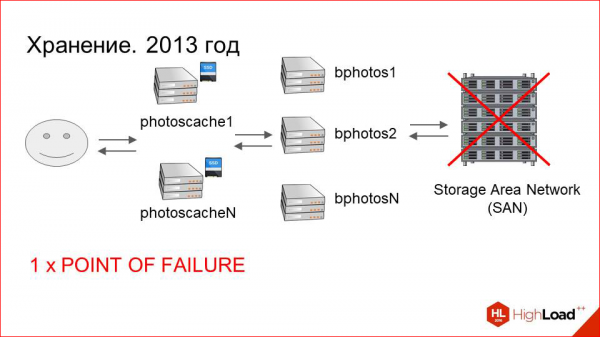
În această schemă, care este desenată – cu SAN, cu mașinile conectate la acesta și cu cache-urile – există foarte multe puncte de eșec. Dacă am gestionat anterior eșecurile serverelor de caching, acolo totul era mai mult sau mai puțin previzibil și clar, pe partea de stocare situația a fost mult mai gravă.
În primul rând, rețeaua de stocare SAN, care poate să cedeze.
În al doilea rând, este conectată prin fibră optică la mașinile finale. Pot exista probleme cu cardurile optice și întrerupătoarele.
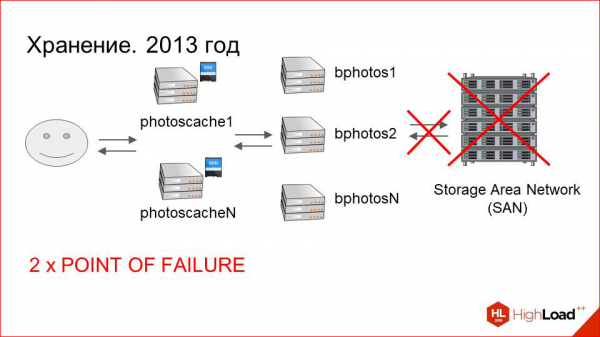
Desigur, acestea nu sunt atât de multe ca cele cu SAN, dar, cu toate acestea, sunt și ele puncte de eșec.
Apoi, mașina însăși, care este conectată la stocare. Ea poate, de asemenea, să iasă din funcțiune.
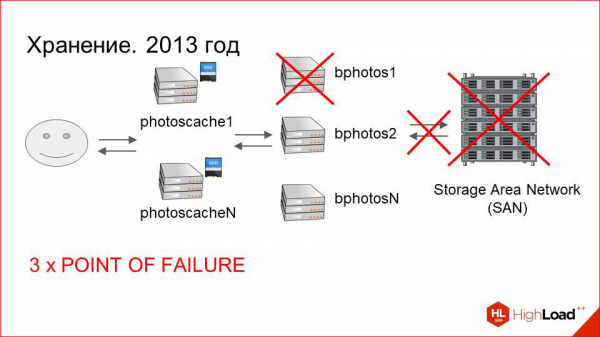
Deci avem trei puncte de eșec.
În plus, în afara punctelor de eșec, întreținerea sistemelor de stocare este greoaie.
Este un sistem complex, multi-component, și inginerii de sistem se confruntă uneori cu dificultăți în utilizarea acestuia.
Și ultimul, cel mai important punct. Dacă în oricare dintre aceste trei puncte apare un eșec, avem o probabilitate non-zero de a pierde datele utilizatorului, deoarece sistemul de fișiere poate fi corupt.
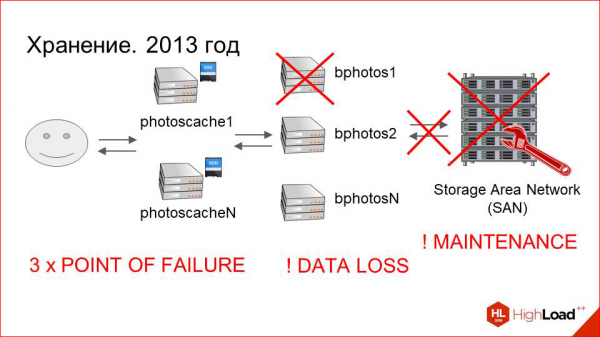
Să presupunem că sistemul de fișiere s-a corupt. Restaurarea acestuia durează, în primul rând, mult – poate dura o săptămână pentru un volum mare de date. În al doilea rând, cel mai probabil vom obține o mulțime de fișiere neclare, pe care va trebui să le potrivim într-un fel cu fotografiile utilizatorilor. Și riscăm să pierdem date. Riscurile sunt destul de mari. Și cu cât astfel de situații apar mai des și cu cât mai multe probleme apar în întreaga această lanț, cu atât riscurile cresc.
Trebuia să facem ceva în legătură cu asta. Și am decis că trebuie să rezervăm pur și simplu datele. Acesta este, de fapt, un solut evidenta și bună. Ce am făcut?
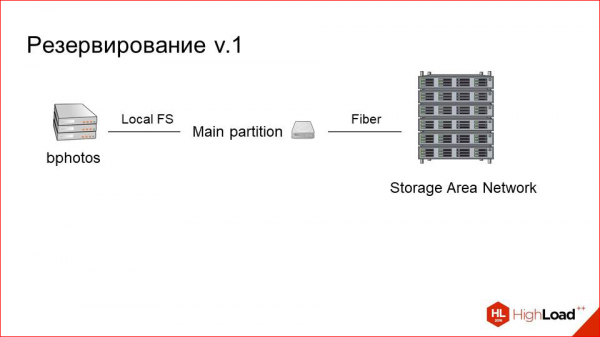
Așa arăta serverul nostru, care era conectat la stocare anterior. Acesta este o partajare principală, este practic un dispozitiv bloc care reprezintă un mount pentru stocare la distanță prin fibră optică.
Am adăugat pur și simplu o a doua partajare.
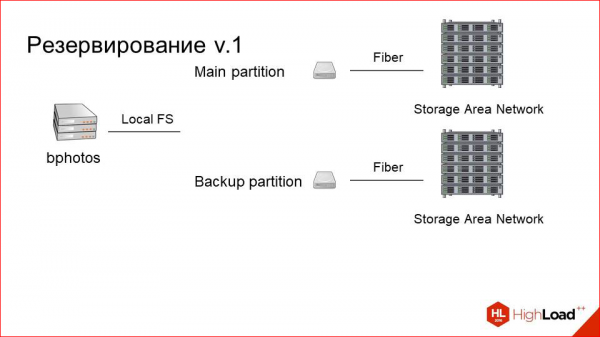
Am plasat un al doilea storage lângă acesta (din fericire, nu este atât de scump) și l-am numit sectiune de backup. Acesta este de asemenea conectat prin fibră optică și se află pe aceeași mașină. Dar trebuie să sincronizăm cumva datele între ele.
Aici facem doar o coadă asincronă.
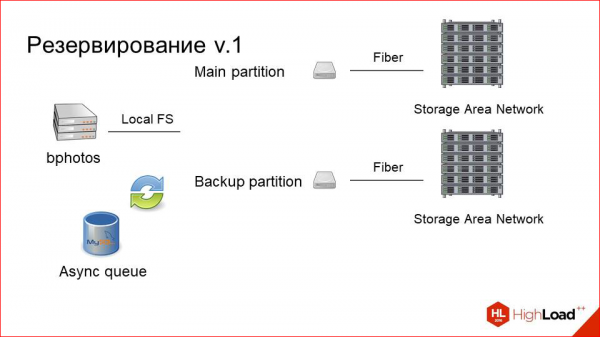
Nu este foarte aglomerată. Știm că avem puține înregistrări. Coada este pur și simplu un tabel în MySQL, în care se scriu rânduri de tipul "trebuie să fac backup pentru această fotografie". La orice modificare sau la upload, copiem din sectiunea principală pe backup printr-un worker asincron sau pur și simplu un background worker.
Și astfel avem întotdeauna două secțiuni consistente. Chiar dacă o parte a acestui sistem se defectează, putem schimba întotdeauna sectiunea principală cu backup-ul, iar totul va continua să funcționeze.
Dar din cauza aceasta, sarcina la citire crește semnificativ, deoarece, pe lângă clienții care citesc din sectiunea principală, pentru că ei se uită întâi la fotografie acolo (este mai recentă), apoi caută pe backup dacă nu au găsit (dar acesta se face pur și simplu prin NGINX), acum și sistemul nostru de backup citește din sectiunea principală. Nu că ar fi un punct critic, dar nu am vrut să creștem sarcina, practic, fără motiv.
Și am adăugat un al treilea disk, care este un SSD mic și l-am numit buffer.
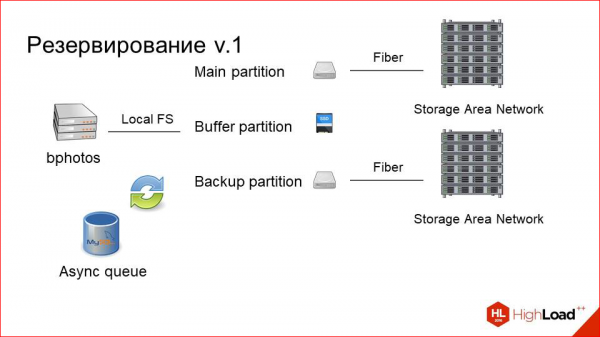
Cum funcționează acum.
Utilizatorul uploadează o fotografie pe buffer, apoi este trimis un eveniment în coadă că trebuie copiată în cele două sectiuni. Aceasta este copiată, iar fotografia rămâne un timp (să spunem, o zi) pe buffer, după care este purjată. Aceasta îmbunătățește foarte mult experiența utilizatorului, deoarece utilizatorul încarcă fotografia, iar, de obicei, imediat după, încep să vină cereri, sau el însuși își reîmprospătează pagina. Dar aceasta depinde de aplicația care face upload-ul.
Sau, de exemplu, alte persoane, cărora le-o arată, trimit imediat cereri pentru această fotografie. În cache încă nu este, prima cerere se întâmplă foarte repede. Practic, la fel ca în cazul cache-ului pentru fotografii. Storage-ul lent nu participă deloc în acest proces. Iar când după o zi va fi purjat, fie va fi deja în cache pe stratul nostru de caching, fie, cel mai probabil, nu va mai fi necesar. Așadar, experiența utilizatorului a crescut foarte mult datorită acestor manevre simple.
Ei bine, și cel mai important: am încetat să mai pierdem date.
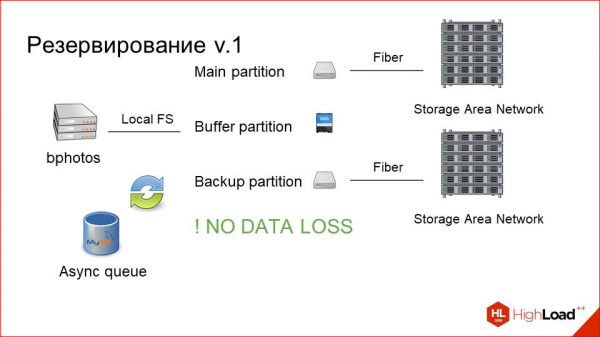
Am spus așa, am încetat potențial a pierde date, pentru că de fapt nu le-am pierdut niciodată. Dar pericolul a fost. Observăm că această soluție, desigur, este bună, dar seamănă puțin cu tratarea simptomelor problemei, în loc să o rezolvăm complet. Și unele probleme au rămas.
În primul rând, există un punct de eșec în formă de gazdă fizică, pe care întreaga mașinărie funcționează, iar aceasta nu a dispărut.
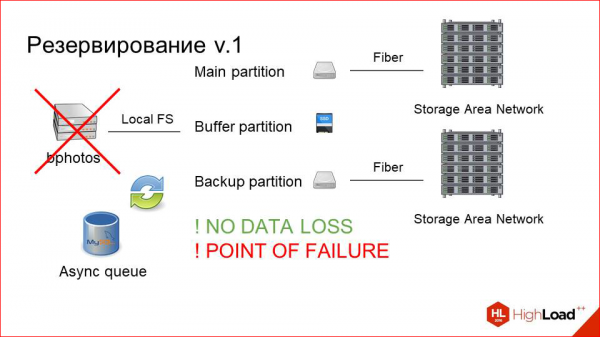
În al doilea rând, au rămas probleme cu SAN-urile, a rămas mentenanța lor complexă etc. Nu era neapărat un factor critic, dar am vrut să încercăm să trăim fără acestea.
Și am făcut o a treia versiune (de fapt, a doua în realitate) – versiunea de rezervare. Cum arăta aceasta?
Asta este ceea ce a fost –
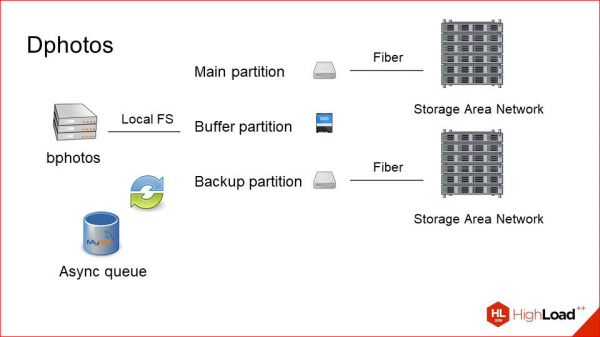
Principalele probleme pe care le avem sunt cu gazda fizică.
În primul rând, eliminăm SAN-urile, pentru că vrem să experimentăm, vrem să încercăm pur și simplu cu discuri locale.
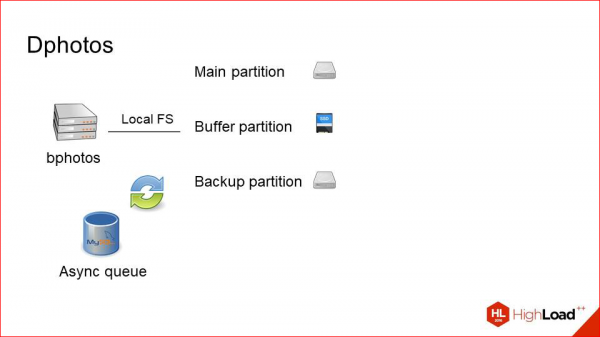
Este deja anul 2014-2015, iar în acel moment situația cu discurile și capacitatea lor pe o gazdă a devenit mult mai bună. Ne-am zis de ce să nu încercăm.
În continuare, pur și simplu luăm secțiunea noastră de backup și o mutăm fizic pe o mașină separată.
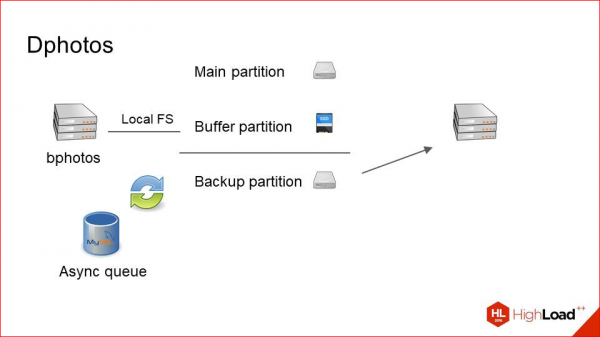
Astfel, obtinem o schemă de acest gen. Avem două mașini care stochează seturi de date identice. Ele se rezervă reciproc complet și sincronizează datele prin rețea printr-o coadă asincronă în același MySQL.
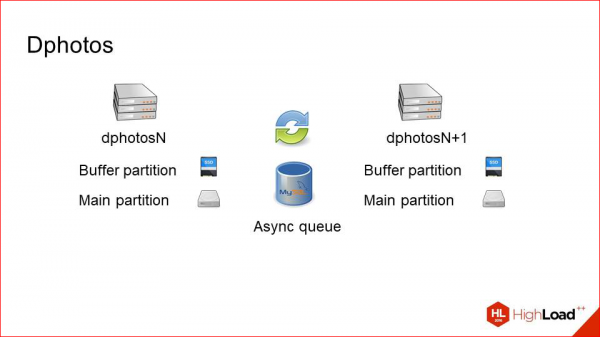
De ce funcționează bine - pentru că avem puține înregistrări. Adică, dacă înregistrările ar fi echivalente cu citirile, am putea avea un anumit overhead de rețea și probleme. Avem puține înregistrări, multe citiri - acest mod funcționează bine, adică copiem destul de rar fotografiile între aceste două servere.
Cum funcționează acest lucru, dacă ne uităm puțin mai în detaliu.
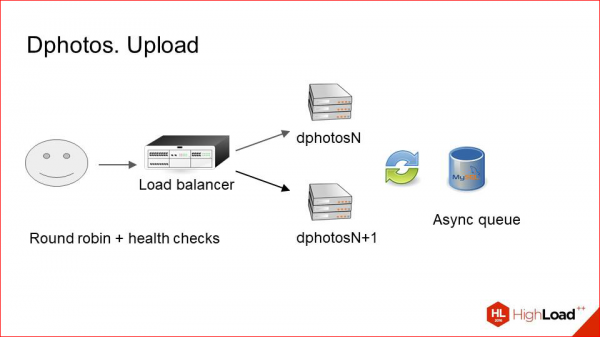
Upload. Balansatorul alegere pur și simplu gazde aleatorii cu o pereche și face upload pe acestea. În același timp, el face evident verificări de sănătate, se uită să nu cadă mașina. Adică, el face upload de poze doar pe serverul activ, iar apoi printr-o coadă asincronă, totul este copiat pe colegul său. Cu upload-ul totul este extrem de simplu.
Cu sarcina este puțin mai complicat.
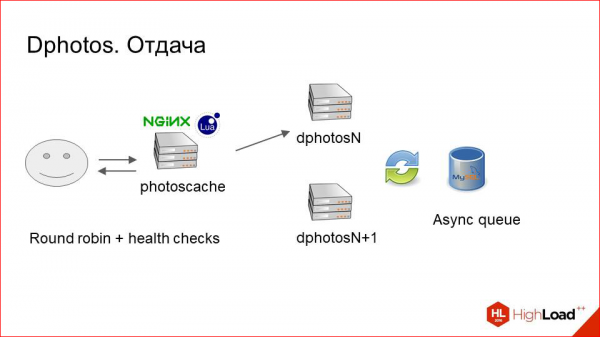
Aici ne-a ajutat Lua, deoarece pe NGINX-ul vanilla, uneori, este greu să implementăm o astfel de logică. Începem prin a face o cerere la primul server, verificăm dacă fotografia există acolo, deoarece aceasta ar putea fi încărcată, de exemplu, pe vecin, dar încă nu a ajuns aici. Dacă fotografia este acolo, este bine. O oferim imediat clientului și, posibil, o cache-uim.
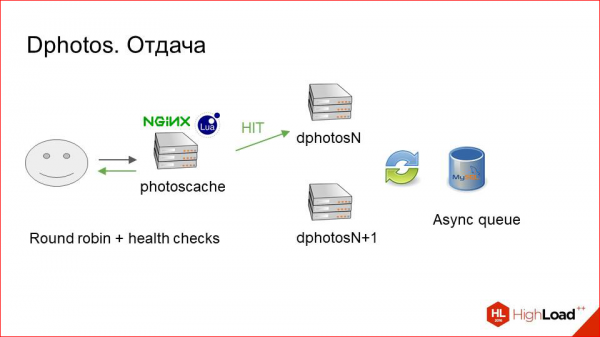
Dacă nu este, facem pur și simplu o cerere către vecin și o obținem garantat de acolo.
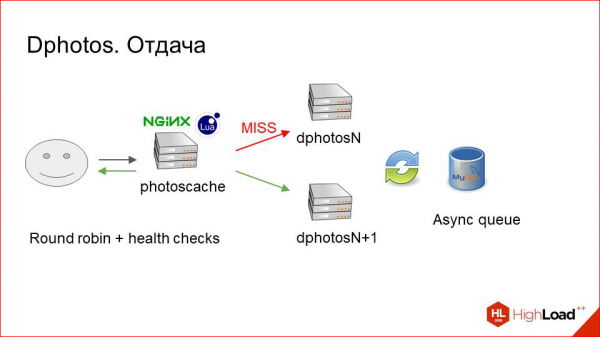
Așadar, încă o dată se poate spune: pot apărea probleme cu performanța, deoarece acestea sunt cereri de tip round trip constante - s-a încărcat fotografia, dar aici nu este, facem două cereri în loc de una, ceea ce ar trebui să funcționeze lent.
În situația noastră, nu funcționează lent.
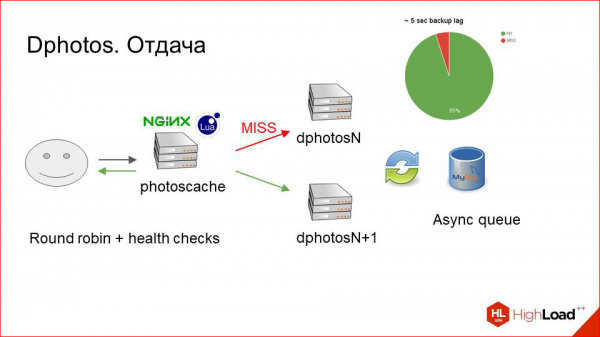
Colectăm o mulțime de metrici pentru acest sistem, iar rata de hit a acestui mecanism este de aproximativ 95%. Asta înseamnă că întârzierea acestui backup este mică și, datorită acestui fapt, practic garantat, după ce fotografia a fost încărcată, o obținem din prima și nu trebuie să facem două drumuri.
Astfel, ce altceva am obținut, și ce este foarte tare?
În trecut, aveam un singur volum principal de backup și citeam secvențial de pe acesta. Cu alte cuvinte, întotdeauna căutam mai întâi pe principal și apoi pe backup. Asta era o singură cerere.
Acum optimizăm citirea de pe două mașini în același timp. Distribuim cererile Round Robin. Într-un procent mic de cazuri, facem două cereri. Dar, în general, acum avem de două ori mai multă capacitate de citire decât aveam înainte. Și încărcătura a scăzut semnificativ atât pe mașinile de livrare, cât și pe stocurile pe care le aveam la momentul respectiv.
În ceea ce privește reziliența la defecțiuni. De fapt, pentru asta am luptat în principal. Aici, reziliența la defecțiuni s-a dovedit a fi fabuloasă.
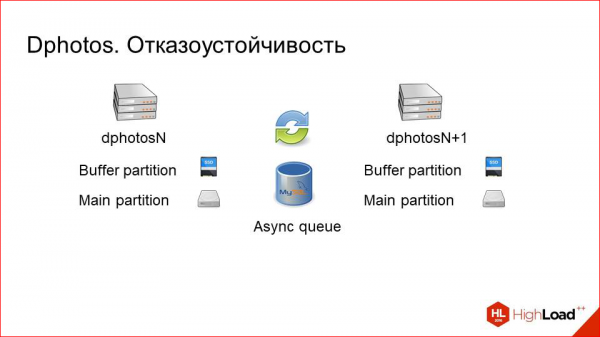
O mașină cedează.
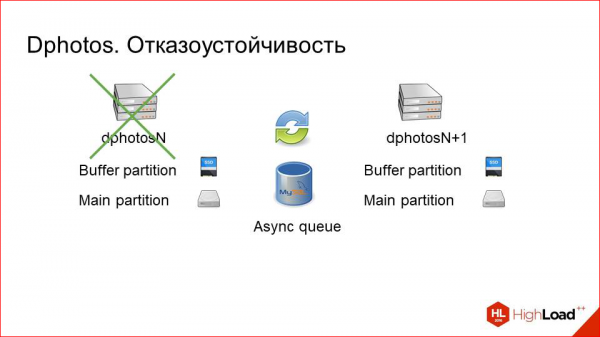
Nici o problemă! Inginerul de sistem poate chiar să nu se trezească noaptea, va aștepta până dimineața, nu va fi nimic grav.
Chiar și în cazul în care, odată cu eșecul acestei mașini, coada a cedat, nici o problemă, pur și simplu log-ul se va acumula mai întâi pe mașina activă, iar apoi se va reconstrui în coadă, și abia apoi pe acea mașină care va reintra în funcțiune după un timp.
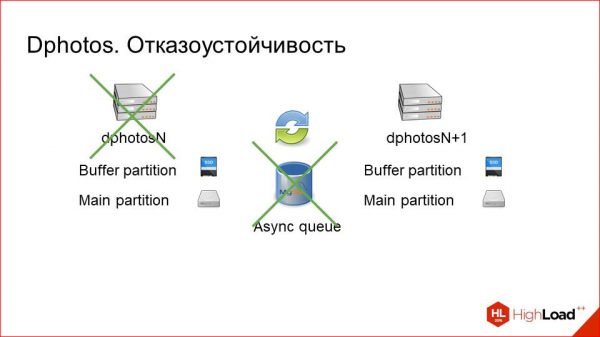
Același lucru se aplică și întreținerii. Pur și simplu oprim una dintre mașini, o scoatem din toate pool-urile, nu mai primește trafic, facem o întreținere, corectăm ceva, după care o readucem în operare, iar backup-ul este recuperat destul de rapid. Adică, după o zi de downtime pentru o mașină, se recuperează în câteva minute. Este realmente foarte puțin. Cu redundanța, repet, aici totul este grozav.
Ce concluzii putem trasa din acest schemă de rezervare?
Am obținut redundanță.
Exploatare simplă. Deoarece pe mașini avem hard disk-uri locale, este mult mai convenabil din punct de vedere al exploatării pentru inginerii care lucrează cu acestea.
Am obținut un dublu surplus în citiri.
Acesta este un bonus foarte bun pe lângă redundanță.
Dar există și probleme. Acum avem o dezvoltare mult mai complicată a unor funcții legate de asta, deoarece sistemul a devenit 100% consistent în mod eventual.
Trebuie să ne gândim, să spunem, în vreun background job: «Pe care server suntem acum?» «Este aici cu adevărat o fotografie actualizată?» etc. Acestea, desigur, sunt toate încapsulate, iar pentru programatorul care scrie logica de afaceri, este transparent. Dar, cu toate acestea, a apărut un strat complex mare. Însă suntem pregătiți să conviețuim cu asta în schimbul beneficiilor pe care le-am obținut.
Și aici din nou apare un conflict.
La început am spus că a păstra totul pe hard disk-uri locale este rău. Acum spun că ne-a plăcut.
Da, într-adevăr, de-a lungul timpului situația s-a schimbat mult, iar acum această abordare are multe avantaje. În primul rând, obținem o exploatare mult mai simplă.
În al doilea rând, este mai performant, deoarece nu mai avem acei controlere automate, conectări la unități de disc.
Acolo este o mașinărie uriașă, iar aici sunt doar câteva discuri, care sunt concret montate în RAID pe mașină.
Dar există și dezavantaje.
Este aproximativ de 1,5 ori mai scump decât utilizarea SAN-urilor chiar și la prețurile de astăzi. De aceea, am decis să nu convertim astfel fără ezitare tot marele nostru cluster în mașini cu hard disk-uri locale și am decis să păstrăm o soluție hibridă.
Jumătate dintre mașini funcționează cu hard disk-uri (de fapt, nu jumătate – cam 30%, probabil). Iar cealaltă parte sunt mașini vechi, pe care era implementat primul sistem de rezervare. Pur și simplu le-am remontat, deoarece nu avem nevoie de date noi sau alte lucruri, doar am schimbat montajele de pe un gazdă fizică pe două.
Și am obținut o capacitate mare de citire, și am consolidat resursele. Dacă înainte montam un storage pe o singură mașină, acum montăm patru pe o pereche, de exemplu. Și asta funcționează foarte bine.
Hai să facem un rezumat scurt al ceea ce am realizat, ce am luptat pentru, și dacă a funcționat.
Concluzii
Avem utilizatori — un total de 33 milioane.
Avem trei puncte de prezență — Praga, Miami, Hong Kong.
În acestea se află un strat de caching, care constă în mașini cu discuri locale rapide (SSD), pe care funcționează o infrastructură simplă bazată pe NGINX, cu access.log-uri și demoni pe Python care procesează și gestionează cache-ul.
Dacă doriți, puteți în proiectul dvs., dacă fotografiile nu sunt la fel de esențiale pentru dvs. ca pentru noi, sau dacă trade-off-ul între control și viteza dezvoltării și costurile resurselor se înclină în favoarea altor aspecte, atunci puteți cu ușurință să-l înlocuiți cu un CDN, deoarece CDN-urile moderne fac asta foarte bine.
Apoi urmează stratul de stocare, unde avem clustere de perechi de mașini care se rezervă între ele, copierea asynchronă a fișierelor de la unu la altul la orice modificare.
În același timp, o parte dintre aceste mașini funcționează cu hard disk-uri locale.
O parte dintre aceste mașini sunt conectate la SAN-uri.
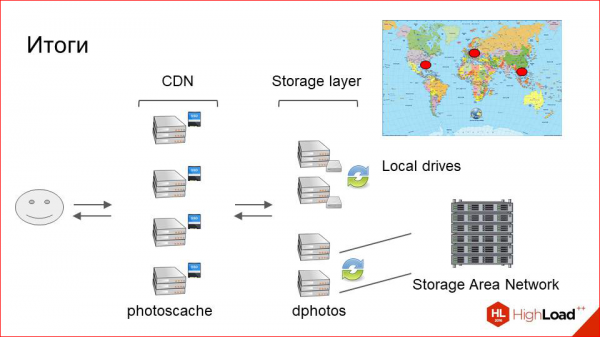
Și, pe de o parte, este mai convenabil din punct de vedere al exploatării și puțin mai performant, iar pe de altă parte, este convenabil din perspectiva densității de amplasare și prețului pe gigabyte.
Aceasta este o scurtă prezentare a arhitecturii pe care am realizat-o și cum s-a dezvoltat totul.
Încă câteva sfaturi simple de la cap, foarte simple.
În primul rând, dacă vă decideți că trebuie să îmbunătățiți urgent întreaga infrastructură a fotografiilor, măsurați mai întâi, deoarece, poate, nu este necesar să îmbunătățiți nimic.
Voi da un exemplu. Avem un cluster de mașini care furnizează fotografii din anexele de pe chat-uri, și acolo continuăm să folosim schema din 2009, și nimeni nu suferă de pe urma asta. Toată lumea este mulțumită, tuturor le place.
Pentru a măsura, mai întâi adăugați o mulțime de metrici, analizați-le și apoi decideți ce anume nu vă mulțumește și ce trebuie îmbunătățit. Pentru a măsura aceasta, avem un instrument grozav numit Pinba.
Acesta permite colectarea de statistici foarte detaliate de la NGINX pentru fiecare request, codurile de răspuns și distribuția timpilor — tot ce doriți. Are legături cu diferite sisteme de analiză, iar dumneavoastră puteți vizualiza totul frumos.
Mai întâi am măsurat — apoi am îmbunătățit.
În continuare. Optimizăm citirea cu cache-ul, iar scrierea — cu shardingul, dar acesta este un punct evident.
În continuare. Dacă abia acum începeți să construiți sistemul dumneavoastră, este mult mai bine să tratați fotografiile ca fișiere imutabile. Deoarece pierdeți imediat o întreagă categorie de probleme legate de invalidarea cache-ului, de logica necesară pentru a găsi versiunea corectă a fotografiei și așa mai departe.
Să presupunem că ați încărcat o sută, apoi ați rotit-o, asigurați-vă că este un fișier fizic diferit. Adică, nu trebuie să vă gândiți: acum economisesc puțin spațiu, voi scrie în același fișier, voi schimba versiunea. Aceasta nu funcționează bine, și ulterior apar multe dureri de cap.
Următorul punct. Despre redimensionarea în timpul execuției.
Anterior, când utilizatorii încărcau o fotografie, tăiam imediat o mulțime de dimensiuni pentru toate ocaziile, pentru diferiți clienți, și toate erau stocate pe disc. Acum am renunțat la aceasta.
Am păstrat doar trei dimensiuni de bază: mică, medie și mare. Tot restul îl redimensionăm din dimensiunea pe care o cere utilizatorul în Uport, pur și simplu facem downsizing și îl returnăm utilizatorului.
CPU-ul stratului de cache devine mult mai ieftin decât dacă am regenera constant aceste dimensiuni pe fiecare storage. Să presupunem că dorim să adăugăm un nou format, aceasta ar dura o lună — să rulăm un script peste tot pentru a face totul corect, fără a cădea clusterele. Adică, dacă avem opțiunea de a alege acum, este mai bine să facem cât mai puține dimensiuni fizice, dar să existe totuși o anumită distribuție, să zicem, trei. Iar restul să fie redimensionat în timp real cu ajutorul modulelor disponibile. Acum toate acestea sunt foarte simple și accesibile.
Și backup-ul incremental asincron este o idee bună.
Așa cum a arătat practica noastră, acest sistem funcționează foarte bine cu copierea întârzierilor fișierelor modificate.
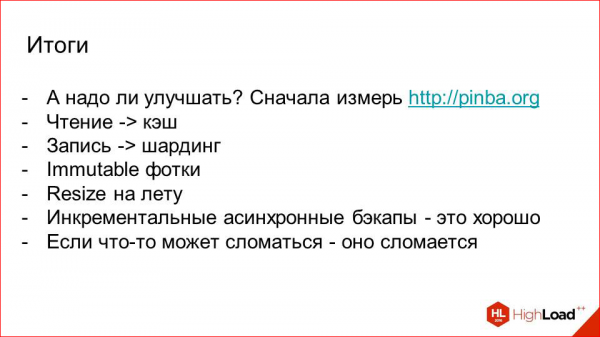
Ultimul punct este, de asemenea, evident. Dacă în infrastructura dumneavoastră nu există acum astfel de probleme, dar există ceva care ar putea să se defecteze, acesta se va defecta atunci când va fi supus unei presiuni suplimentare. Așadar, cel mai bine este să vă gândiți la asta din timp și să evitați astfel de probleme. Asta am avut de spus.
Contacte
»
»
Această prezentare este transcrierea uneia dintre cele mai bune prezentări de la conferința dezvoltatorilor de sisteme cu sarcini mari . Mai puțin de o lună până la conferința HighLoad++ 2017.
Avem deja pregătit , iar acum se elaborează activ programul.
Anul acesta continuăm să explorăm tema arhitecturilor și scalării:
- / Игорь Васильев
- / Дмитрий Егоров
- / Анатолий Пласковский
- / Роман Шеховцов, Алексей Громатчиков
- / Филипп Дельгядо
De asemenea, unele dintre aceste materiale sunt folosite de noi în cursul nostru online de formare pentru dezvoltarea sistemelor cu sarcini mari — este o serie de scrisori, articole, materiale și videoclipuri atent selectate. Deja avem în manualul nostru peste 30 de materiale unice. Alăturați-vă!
Sursa: habr.com
