

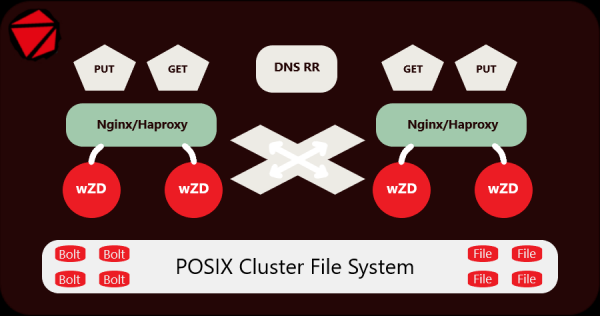
Stimată comunitate, acest articol va fi dedicat stocării eficiente și livrării a sute de milioane de fișiere mici. În această etapă, se propune o soluție finală pentru sistemele de fișiere compatibile POSIX, cu suport complet pentru blocări, inclusiv cele de tip cluster, și se pare că deja fără colțuri tăiate.
De aceea, pentru această scop, am scris propriul meu server specializat.
Pe parcursul implementării acestei sarcini, am reușit să rezolvăm problema principală, obținând în același timp economii de spațiu pe disc și memorie RAM, pe care sistemul nostru de fișiere în cluster o consuma fără milă. Această cantitate de fișiere este dăunătoare oricărui sistem de fișiere în cluster.
Ideea este următoarea:
Pe scurt, prin server sunt încărcate fișierele mici, acestea fiind salvate direct în arhivă și la fel citite din aceasta, iar fișierele mari sunt stocate separat. Schema: 1 folder = 1 arhivă, avem astfel câteva milioane de arhive cu fișiere mici, în loc de câteva sute de milioane de fișiere. Și totul este realizat complet, fără scripturi și fără a distribui fișiere în arhive tar/zip.
Voi încerca să fiu scurt, îmi cer scuze dinainte dacă articolul va fi dens.
A început totul cu faptul că nu am găsit un server potrivit în lume care să poată salva datele primite prin protocolul HTTP direct în arhive, astfel încât să nu existe dezavantajele asociate arhivelor obișnuite și stocării de obiecte. Iar cauzele căutărilor au fost un cluster Origin extins la scară mare din 10 servere, în care s-au adunat deja 250.000.000 de fișiere mici, iar tendința de creștere nu părea să se oprească.
Pentru cei care nu iubesc să citească articole și preferă o documentație mai succintă:
și .
Și docker, de asemenea, acum există o variantă doar împreună cu nginx în interior, pentru orice eventualitate:
docker run -d --restart=always -e host=localhost -e root=\/var\/storage
-v \/var\/storage:\/var\/storage --name wzd -p 80:80 eltaline\/wzd
Apoi:
Dacă există foarte multe fișiere, sunt necesare resurse semnificative, iar, din păcate, o parte din acestea se pierd în van. De exemplu, atunci când se utilizează un sistem de fișiere în cluster (în acest caz - MooseFS), un fișier, indiferent de dimensiunea reală, ocupă întotdeauna minimum 64 KB. Asta înseamnă că pentru fișiere de 3, 10 sau 30 KB pe disc sunt necesare 64 KB. Dacă sunt un sfert de miliard de fișiere, pierdem între 2 și 10 terabyte. Crearea de fișiere noi la nesfârșit nu este posibilă, deoarece în MooseFS există o limitare: nu mai mult de 1 miliard cu o replică pentru fiecare fișier.
Pe măsură ce numărul fișierelor crește, este nevoie de multă memorie RAM pentru metadate. De asemenea, dump-urile mari ale metadatelor contribuie la uzura SSD-urilor.
Server wZD. Facem ordine pe discuri.
Serverul este scris în limbajul Go. În primul rând, trebuia să reduc numărul fișierelor. Cum să fac asta? Prin arhivare, dar în acest caz fără compresie, deoarece fișierele mele sunt doar imagini comprimate. BoltDB a venit în ajutor, pe care a trebuit să o îmbunătățesc, ceea ce este reflectat în documentație.
Astfel, în loc de un sfert de miliard de fișiere, în cazul meu au rămas doar 10 milioane de arhive Bolt. Dacă aș fi avut ocazia să modific structura actuală de umplere a directorilor cu fișiere, ar fi fost posibil să reduc aproximativ la 1 milion de fișiere.
Toate fișierele mici sunt comprimate în arhive Bolt, care primesc automat numele directorilor în care se află, iar toate fișierele mari rămân alături de arhive; nu este sens să le comprimi, acest lucru este configurabil. Mici - arhivăm, mari - le lăsăm nemodificate. Serverul funcționează transparent atât cu acestea, cât și cu celelalte.
Arhitectura și caracteristicile serverului wZD.
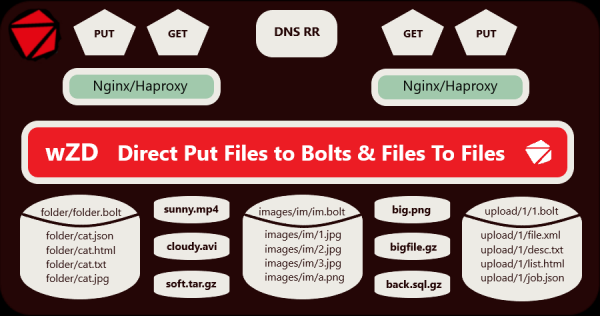
Serverul funcționează sub sistemele de operare Linux, BSD, Solaris și OSX. Am testat doar pentru arhitectura AMD64 sub Linux, dar ar trebui să fie compatibil și pentru ARM64, PPC64, MIPS64.
Caracteristicile principale:
- Multithreading;
- Multiserveritate, asigurând redundanță și echilibrarea încărcării;
- Transparență maximă pentru utilizator sau dezvoltator;
- Metode HTTP suportate: GET, HEAD, PUT și DELETE;
- Gestionarea comportamentului la citire și scriere prin antetele clientului;
- Suport pentru gazde virtuale configurabile flexibil;
- Suport pentru integritatea datelor CRC la scriere/lectură;
- Bufferi semi-dinamici pentru un consum minim de memorie și optimizarea performanței rețelei;
- Compacție a datelor întârziată;
- În plus, se oferă un arhivator multi-threaded wZA pentru migrarea fișierelor fără a opri serviciul.
Experiență reală:
Am dezvoltat și testat un server și un arhivator pe date live timp de o perioadă destul de îndelungată, acum acesta funcționează cu succes pe un cluster care include 250.000.000 de fișiere mici (imagini), situate în 15.000.000 de directoare pe discuri SATA separate. Clusterul format din 10 servere reprezintă un server Origin, situat în spatele unei rețele CDN. Pentru întreținerea acestuia se folosesc 2 servere Nginx + 2 servere wZD.
Celor care decid să folosească acest server, are sens să planifice structura directoarelor înainte de utilizare, dacă este cazul. Precizez că serverul nu este destinat pentru a împacheta totul într-un singur arhivă Bolt.
Testarea performanței:
Cu cât dimensiunea fișierului arhivat este mai mică, cu atât operațiile GET și PUT se execută mai repede. Să comparăm timpul total de scriere al clientului HTTP în fișierele obişnuite și în arhivele Bolt, de asemenea, și citirea. Se compară lucrul cu fișiere de dimensiuni de 32 KB, 256 KB, 1024 KB, 4096 KB și 32768 KB.
Atunci când lucrăm cu arhivele Bolt, se verifică integritatea datelor fiecărui fișier (se folosește CRC), înainte de scriere și de asemenea, după scriere se face citirea „la zbor” și recalcularea, acest lucru aduce, desigur, întârzieri, dar principalul este siguranța datelor.
Am efectuat teste de performanță pe unități SSD, deoarece testele pe discuri SATA nu arată o diferență clară.
Graficele rezultatelor testării:
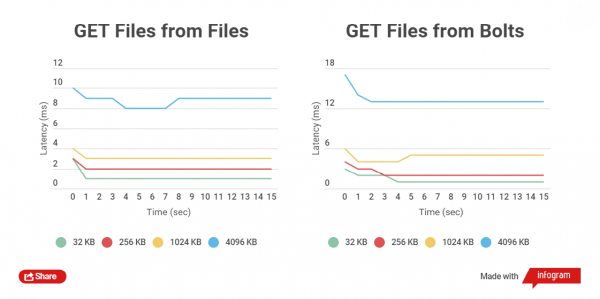
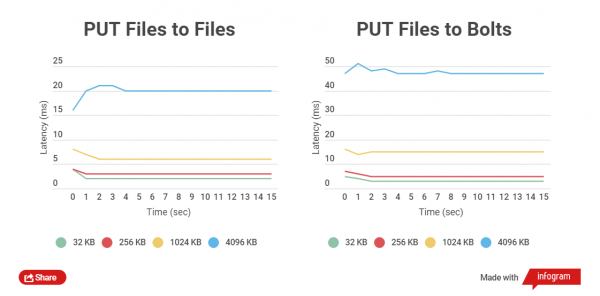
După cum se poate observa, pentru fișierele mici, diferența de timp de citire și scriere între fișierele arhivate și cele nearhivate este puțin semnificativă.
O imagine complet diferită va apărea în testul de citire și scriere a fișierelor de dimensiune 32 MB:
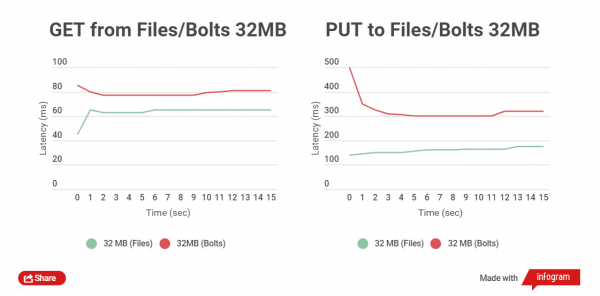
Diferența de timp între citirea fișierelor este de 5-25 ms. În ceea ce privește scrierea, situația este mai gravă, diferența este de aproximativ 150 ms. Dar în acest caz, nu este necesar să încărcați fișiere mari, pur și simplu nu are sens, ele pot trăi separat de arhive.
*Tehnic, acest server poate fi utilizat și pentru sarcini care necesită NoSQL.
Principalele metode de lucru cu serverul wZD:
Încărcarea unui fișier obișnuit:
curl -X PUT --data-binary @test.jpg http://localhost/test/test.jpgÎncărcarea unui fișier în arhiva Bolt (dacă nu este depășită parametrul serverului fmaxsize, care definește dimensiunea maximă a fișierului care poate fi inclus în arhivă, dacă este depășit, atunci fișierul se va încărca ca de obicei, lângă arhivă):
curl -X PUT -H "Archive: 1" --data-binary @test.jpg http://localhost/test/test.jpgDescărcarea fișierului (dacă pe disc și în arhivă există fișiere cu nume identice, în timpul descărcării prioritatea este dată de default fișierului nearchivat):
curl -o test.jpg http://localhost/test/test.jpgDescărcarea fișierului din arhiva Bolt (forțat):
curl -o test.jpg -H "FromArchive: 1" http://localhost/test/test.jpgDescrierea altor metode este disponibilă în documentație.
Serverul suportă în prezent doar protocolul HTTP, HTTPS nu funcționează încă. De asemenea, metoda POST nu este suportată (încă nu este decis dacă este necesară sau nu).
Cine se va uita în codul sursă va descoperi acolo un caramel, nu toată lumea îl îndrăgește, dar eu nu am legat codul principal de funcțiile framework-ului web, cu excepția handlerului de întreruperi, așa că în viitor pot să-l rescriu rapid pe aproape orice motor.
ToDo:
- Dezvoltarea unui replicator și distribuitor propriu + geo pentru a putea fi utilizat în sisteme mari fără FS-uri clusterizate (totul la un nivel profesional)
- Posibilitatea recuperării complete a metadatelor în caz de pierdere totală (în cazul utilizării distribuitorului)
- Protocol nativ pentru posibilitatea utilizării conexiunilor de rețea permanente și drivere pentru diferite limbaje de programare
- Funcționalități extinse de utilizare a componentei NoSQL
- Compresie de diferite tipuri (gzip, zstd, snappy) pentru fișiere sau valori din arhivele Bolt și pentru fișiere normale
- Criptare de diferite tipuri pentru fișiere sau valori din arhivele Bolt și pentru fișiere normale
- Conversie video server-side întârziată, inclusiv pe GPU
Asta e tot, sper că acest server va fi util cuiva, licența BSD-3, drepturi de autor duble, deoarece fără compania în care lucrez, nu aș fi scris acest server. Sunt singurul dezvoltator. Aș fi recunoscător pentru bug-urile găsite și cererile de funcții.
Sursa: habr.com
