

Toți vorbeau despre procesele de dezvoltare și testare, formarea personalului, creșterea motivației, dar aceste procese sunt puține când un minut de nefuncționare a serviciului costă o sumă exorbitantă. Ce să facem când efectuam tranzacții financiare cu un SLA strict? Cum putem îmbunătăți fiabilitatea și reziliența sistemelor noastre, excluzând dezvoltarea și testarea?
Următoarea conferință HighLoad++ va avea loc pe 6 și 7 aprilie 2020 în Sankt Petersburg. Detalii și bilete disponibile la . 9 noiembrie, 18:00. HighLoad++ Moscova 2018, sala „Delhi + Calcutta”. Teze și .
Evgheni Kuzovlev (următorul – EK): – Prieteni, salut! Mă numesc Kuzovlev Evgheni. Sunt din compania EcommPay, subdiviziunea specifică – IT EcommPay, divizia IT a grupului de companii. Astăzi vom discuta despre timpii de nefuncționare – despre cum să îi evităm și cum să minimizăm consecințele acestora, dacă nu putem să îi evităm. Tematica este declarată astfel: „Ce să facem când un minut de nefuncționare costă 100 000 de dolari”? Anticipând, cifrele sunt comparabile.
Cu ce se ocupă EcommPay IT?
Cine suntem noi? De ce sunt eu aici în fața voastră? De ce am dreptul să vă povestesc ceva? Și despre ce vom discuta aici în detaliu?
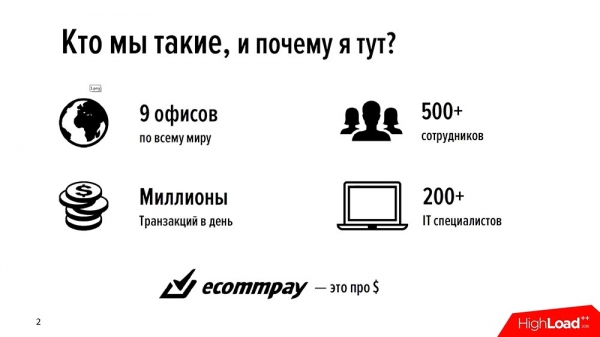
Grupul de companii EcommPay este un acquirer internațional. Procesăm plăți din întreaga lume – în Rusia, Europa, și în Sud-Estul Asiei (All Around the World). Avem 9 birouri, 500 de angajați în total, iar aproximativ puțin mai puțin de jumătate dintre ei sunt specialiști IT. Tot ceea ce facem, tot ce câștigăm, am realizat noi înșine.
Toate produsele noastre (iar acestea sunt destul de multe – în gama de mari produse IT avem aproximativ 16 componente diferite) le-am scris noi înșine; le dezvoltăm noi și în prezent procesăm aproximativ un milion de tranzacții pe zi (milioane – cred că așa va fi corect să spun). Suntem o companie destul de tânără – avem doar aproximativ șase ani.
Acum șase ani, acesta era un startup, când au venit băieții cu afacerea. Ei erau uniți de o idee (nu aveau nimic altceva în afară de idee), și am purces înainte. Ca orice startup, am alergat mai repede… Pentru noi a fost mai importantă viteza, nu calitatea.
Într-un anumit moment, ne-am oprit: ne-am dat seama că nu mai putem trăi cu aceeași viteză și calitate, și că trebuie, înainte de toate, să ne concentrăm pe calitate. Atunci am decis să scriem o nouă platformă, care să fie corectă, scalabilă și fiabilă. Am început să dezvoltăm această platformă (să investim, să dezvoltăm, să testăm), dar într-un moment am realizat că dezvoltarea și testarea nu ne permit să atingem un nou nivel de calitate a serviciului.
Creezi un produs nou, îl lansezi în producție, dar tot apare ceva care nu merge bine. Astăzi vom discuta despre cum să atingem un nou nivel calitativ (cum am reușit noi, despre experiența noastră), lăsând deoparte dezvoltarea și testarea; vom discuta despre ceea ce este disponibil pentru exploatare – ce poate face exploatarea singură, ce poate oferi testării pentru a influența calitatea.
Timpul de nefuncționare. Poruncile exploatării.
Întotdeauna, piatra de temelie despre care vom vorbi astăzi este timpul de nefuncționare. Un cuvânt teribil. Dacă avem un timp de nefuncționare – lucrurile nu merg bine. Ne grăbim să recuperăm, administratorii țin serverul – sperăm să nu cadă, așa cum se spune în acea melodie. Despre asta vom discuta astăzi.
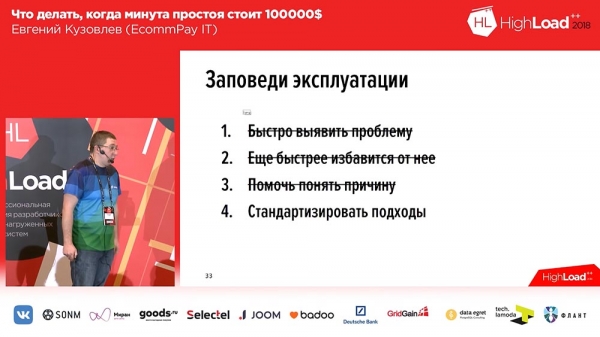
Când am început să ne schimbăm abordările, am formulat 4 porunci. Ele sunt prezentate pe slide-uri:
Aceste porunci sunt destul de simple:
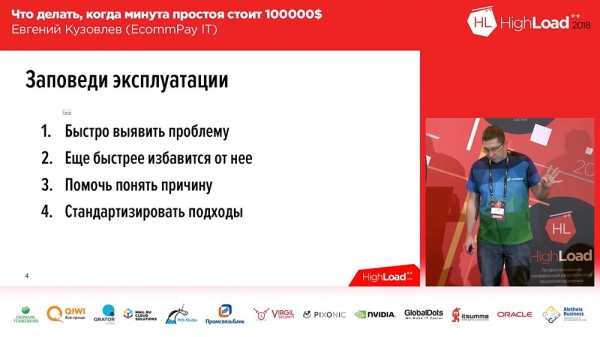
- Să identificăm rapid problema.
- Să scăpăm de ea și mai repede.
- Să ajutăm la înțelegerea cauzei (mai târziu, pentru dezvoltatori).
- Și să standardizăm abordările.
Vă atrag atenția asupra punctului nr. 2. Ne ocupăm de problemă, nu o rezolvăm. A rezolva este secundar. Pentru noi, important este ca utilizatorii să fie protejați de această problemă. Ea va exista într-un mediu izolat, dar acest mediu nu va interacționa cu ei în niciun fel. În esență, vom parcurge aceste patru grupuri de probleme (unele mai detaliat, altele mai puțin), voi povesti ce folosim și care este experiența noastră în soluții.
Rezolvarea problemelor: când apar și ce trebuie să facem cu ele?
Dar să începem nu în ordinea corectă, ci cu punctul nr. 2 – cum ne putem desfășura rapid problema? Există o problemă – trebuie să o rezolvăm. „Ce ar trebui să facem în acest caz?” – aceasta este întrebarea principală. Și când am început să ne gândim la cum să soluționăm problema, am formulat anumite cerințe pe care trebuie să le respecte soluționarea problemelor.
Pentru a formula aceste cerințe, ne-am pus întrebarea: „Când ne confruntăm cu probleme”? Și, după cum s-a dovedit, problemele apar în patru situații:
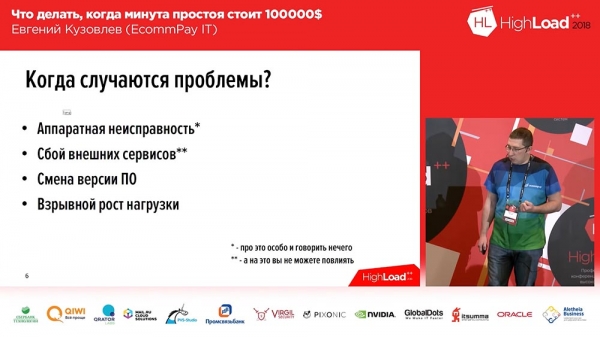
- Defecțiuni hardware.
- Probleme ale serviciilor externe.
- Schimbarea versiunii software (acel deployment).
- Creșterea bruscă a sarcinii.
Despre primele două nu vom discuta. Defecțiunile hardware se rezolvă destul de simplu: trebuie să aveți totul duplicat. Dacă sunt unități de disc – acestea trebuie să fie configurate în RAID, dacă este un server – serverul trebuie să fie duplicat, dacă aveți o infrastructură de rețea – trebuie să configurați o a doua copie a infrastructurii rețelei, adică să luați și să duplicați. Iar dacă ceva nu funcționează, comutați la sursele de rezervă. Este greu de spus mai mult despre acest subiect.
Al doilea – sunt problemele serviciilor externe. Pentru majoritatea sistemelor, aceasta nu reprezintă o problemă, dar nu și pentru noi. Deoarece procesăm plăți, suntem un agregator care stă între utilizator (care introduce datele cardului său) și bănci, sistemele de plată („Visa”, „MasterCard”, „Mir” etc.). Serviciile noastre externe (sistemele de plată, băncile) sunt predispuse la defectări. Nici noi, nici voi (dacă aveți astfel de servicii) nu putem influența acest lucru.
Ce ar trebui să facem atunci? Există două opțiuni. În primul rând, dacă este posibil, ar trebui să duplicați acest serviciu într-un fel sau altul. De exemplu, noi, dacă putem, redirecționăm traficul de la un serviciu la altul: procesând, de exemplu, carduri prin „Sberbank”, avem probleme cu „Sberbank” – redirecționăm traficul [în mod condiționat] către „Raiffeisen”. Al doilea lucru pe care îl putem face este să observăm foarte rapid defecțiunile serviciilor externe, așa că vom vorbi despre viteza de reacție în partea următoare a prezentării.
În realitate, din aceste patru probleme, putem influența în mod concret schimbarea versiunilor de software – să facem acțiuni care vor îmbunătăți situația în contextul desfășurărilor și al creșterii explozive a încărcării. Asta am și făcut. Iar aici, din nou, un mic comentariu…
Din aceste patru probleme, câteva se rezolvă imediat dacă aveți un mediu de cloud. Dacă utilizați „Microsoft Azure”, „Ozon”, sau cloud-urile noastre de la „Yandex” sau „Mail”, atunci cel puțin defecțiunea hardware devine problema lor și, în cel mai scurt timp, problema hardware este rezolvată.
Suntem o companie puțin atipică. Aici, toată lumea vorbește despre „Kubernetes”, despre clouduri – noi nu avem nici „Kubernetes”, nici clouduri. În schimb, avem rack-uri cu echipamente în numeroase centre de date, iar pe aceste echipamente trebuie să supraviețuim, trebuie să ne asumăm răspunderea pentru acestea. Așadar, în acest context, haideți să discutăm despre probleme. Primele două le-am exclus.
Schimbarea versiunii de software. Bazele
Dezvoltatorii noștri nu au acces la mediul de producție. De ce? Simplu, suntem certificați conform PCI DSS, iar dezvoltatorii nu au voie să intervină în mediul de producție. Atât. Deloc. Prin urmare, responsabilitatea dezvoltării se încheie exact în momentul în care dezvoltarea predă build-ul pentru lansare.
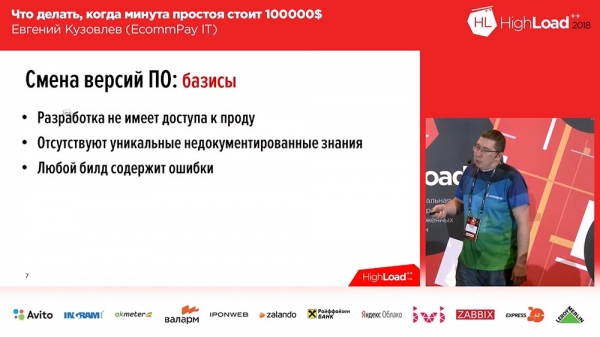
A doua noastră bază, pe care o avem și care ne ajută mult, este absența cunoștințelor unice nedocumentate. Sper că și la voi este la fel. Pentru că, dacă nu este, veți avea probleme. Problemele vor apărea atunci când aceste cunoștințe unice nedocumentate nu sunt disponibile la momentul și locul potrivit. De exemplu, dacă o persoană știe cum se desfășoară un component specific – iar acea persoană nu este disponibilă, este în concediu sau bolnavă – totul devine o problemă.
Și baza a treia pe care am ajuns-o. Am ajuns la ea prin durere, sânge și lacrimi – am realizat că orice build al nostru conține erori, chiar și atunci când nu există erori. Ne-am decis că atunci când desfășurăm ceva, când lansăm ceva în producție – build-ul nostru are erori. Am formulat cerințe pe care sistemul nostru trebuie să le îndeplinească.
Cerințele pentru schimbarea versiunii de software
Aceste cerințe sunt trei:
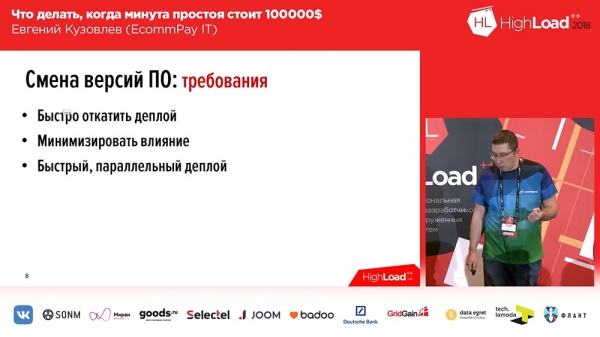
- Trebuie să putem reveni rapid de la desfășurare.
- Trebuie să minimizăm impactul desfășurării nereușite.
- Și trebuie să avem posibilitatea de a ne desfășura rapid în paralel.
Exact în această ordine! De ce? Pentru că, în primul rând, la desfășurarea unei noi versiuni, viteza nu este importantă, dar este esențial să poți reveni rapid dacă ceva nu merge bine, având un impact minim. Dar dacă ai un set de versiuni în producție, pentru care s-a descoperit că există o eroare (ca un fulger, nu a fost desfășurare, dar există o eroare) – atunci viteza desfășurării următoare devine relevantă. Ce am făcut pentru a satisface aceste cerințe? Am adoptat o metodologie de acest tip:
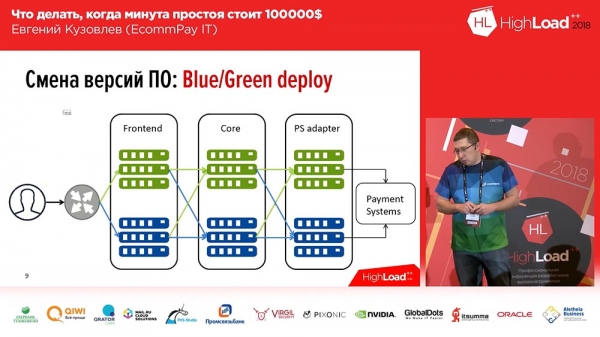
Este destul de cunoscută, nu am inventat nimic – este desfășurarea Blue/Green. Ce înseamnă asta? Pentru fiecare grup de servere pe care rulează aplicațiile tale, ar trebui să existe o copie. O copie 'caldă': pe ea nu există trafic, dar în orice moment poți direcționa acest trafic către acea copie. Această copie conține versiunea anterioară. Și în momentul desfășurării, lansezi codul pe copia inactivă. Apoi, dirijezi o parte din trafic (sau tot traficul) către noua versiune. Astfel, pentru a schimba fluxul de trafic de la versiunea veche la nouă, trebuie să faci doar o singură acțiune: trebuie să schimbi balancerul în upstream, să schimbi direcția – de la un upstream la celălalt. Este foarte convenabil și rezolvă problema schimbării rapide, a revenirii rapide.Aici avem și soluția pentru a doua întrebare – minimizarea: poți trimite la noua linie, la linia cu noul cod, doar o parte din traficul tău (să zicem, 2%). Și acele 2% – nu sunt 100%! Dacă ai pierdut 100% din trafic într-o desfășurare nereușită – este înfricoșător, dacă ai pierdut 2% din trafic – este neplăcut, dar nu este terifiant. Mai mult, utilizatorii probabil nici nu vor observa, deoarece în unele cazuri (nu în toate) același utilizator, apăsând F5, va ajunge la o altă versiune funcțională.
Desfășurarea Blue/Green. Rutare
Totuși, nu este atât de simplu cu 'Bule/Grene'... Toate componentele noastre pot fi împărțite în trei grupuri:
- aceasta este frontend-ul (pagini de plată pe care le văd clienții noștri);
- nucleul procesării;
- adaptoare pentru lucrul cu sistemele de plată (bănci, 'MasterCard', 'Visa'...).
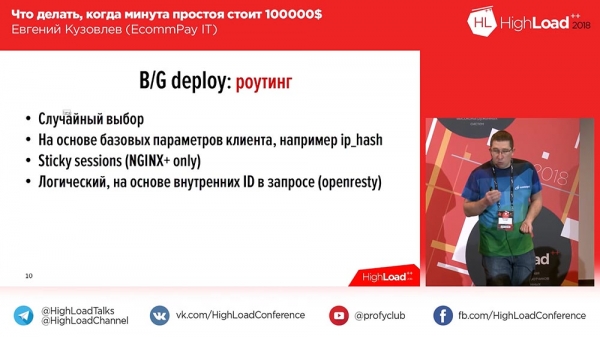
Și aici există o nuanță – nuanța constă în rutarea între linii. Dacă schimbi pur și simplu 100% din trafic, nu ai aceste probleme. Dar dacă vrei să schimbi 2%, apar întrebările: „Cum fac asta?” Cel mai simplu, în mod direct: poți seta o alegere aleatorie, Round Robin în nginx și ai 2% – la stânga, 98% – la dreapta. Dar nu întotdeauna este potrivit.
De exemplu, utilizatorul nostru interacționează cu sistemul nu printr-o singură solicitare. Este normal: 2, 3, 4, 5 solicitări – sistemele tale pot fi la fel. Și dacă este important pentru tine ca toate solicitările utilizatorului să ajungă la aceeași linie pe care a ajuns prima solicitare, sau (al doilea punct) toate solicitările utilizatorului să ajungă la o linie nouă după comutare (s-ar putea să fi început să lucreze cu sistemul înainte de comutare), – atunci această distribuție aleatorie nu îți va fi potrivită. Atunci există următoarele opțiuni:
Prima opțiune, cea mai simplă – pe baza parametrilor de bază ai clientului (IP Hash). Ai un IP, și împărțiți la dreapta-stânga pe baza acestuia. Atunci se va aplica cel de-al doilea caz descris de mine, când a avut loc un deploy, utilizatorul deja ar putea fi început să lucreze cu sistemul tău, și de la momentul deploy-ului toate solicitările vor merge pe linia nouă (sau pe aceeași, fără îndoială).Dacă din diverse motive aceasta nu îți este potrivit și trebuie neapărat să trimiți solicitările pe linia pe care a venit solicitarea inițială, atunci ai două opțiuni...
Prima opțiune: poți lua nginx+ plătit. Acolo există un mecanism de sesiuni persistente (Sticky sessions), care la solicitarea inițială a utilizatorului îi alocă o sesiune și o leagă de un anumit upstream. Toate solicitările ulterioare ale utilizatorului în perioada de viață a sesiunii vor fi trimise la același upstream la care a fost alocată sesiunea.Pentru noi, aceasta nu a fost potrivit, deoarece aveam deja nginx obișnuit. Trecerea la nginx+ – nu că ar fi fost scump, dar pur și simplu a fost un pic dureros și nu foarte corect pentru noi. „Sticky sessions” nu au funcționat pentru noi, de exemplu, din simplul motiv că „Sticky sessions” nu dau posibilitatea de aRuta pe criteriul „Ori-ori”. Acolo poți seta că facem „Sticky sessions” pe baza adresei IP sau pe baza adresei IP și a cookie-urilor sau pe baza parametrilor POST, dar pentru „Ori-ori” – deja devine mai complicat.
Așadar, am ajuns la a patra variantă. Am folosit nginx pe 'steroizi' (acesta este openresty) – este același nginx care suportă în plus integrarea scripturilor last. Puteți scrie un script last, pe care să-l furnizați acestui 'opernesti', iar acest lastscript va fi executat atunci când va veni o cerere de la utilizator.
Și am scris un asemenea script, am instalat 'opernesti' și în acest script parcurgem 6 parametri diferiți prin concatenarea 'sau'. În funcție de prezența acelui parametru sau nu, știm că utilizatorul a venit pe o pagină sau pe alta, pe o linie sau pe alta.
Deploy Blue/Green. Avantaje și dezavantaje
Desigur, probabil că am fi putut face lucrurile un pic mai simple (folosind aceleași 'Sticky sessions'), dar avem și un alt aspect: nu interacționează doar utilizatorul cu noi în cadrul unei singure procesări a unei tranzacții… Interacționează și sistemele de plată: noi, după ce procesăm tranzacția (trimițând cererea către sistemul de plată), primim un callback.
Și, să zicem, dacă în interiorul conturului nostru putem să transmitem adresa IP a utilizatorului în toate cererile și pe baza acestei adrese IP să facem separările, nu putem spune acelor 'Viza': 'Băieți, suntem o companie retro, aparent internațională (pe site și în Rusia)… Dar vă rugăm să ne transmiteți adresa IP a utilizatorului, suplimentar, în câmpul adițional, protocoalele voastre standardizate'! Evident că nu vor fi de acord.
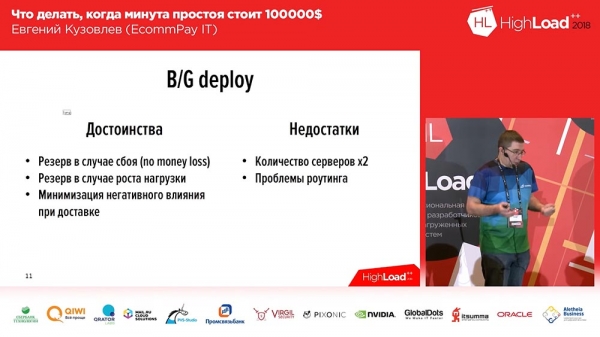
Așadar, aceasta nu a funcționat pentru noi - am creat openresty. În consecință, cu rutarea am realizat astfel:Deploy-ul 'Blue/Green' are, desigur, avantajele pe care le-am menționat și dezavantaje.
Există două dezavantaje:
- va trebui să vă ocupați de rutare;
- al doilea dezavantaj principal – sunt costurile.
Veți avea nevoie de de două ori mai multe servere, veți avea nevoie de de două ori mai multe resurse operaționale, va trebui să cheltuiți de două ori mai mult efort pentru a menține tot acest zoo.
Apropo, printre avantajele listate, mai este un lucru pe care nu l-am menționat anterior: aveți un rezervor în cazul unei creșteri a încărcării. Dacă aveți o creștere explozivă a încărcării, iar un număr mare de utilizatori vă inundă, pur și simplu activați o a doua linie în distribuție 50 la 50 – și aveți instantaneu x2 servere în clusterul vostru, până când rezolvați problema disponibilității serverelor.
Cum se face un deploy rapid?
Am discutat despre cum să rezolvăm problema minimizării și a revenirii rapide, dar întrebarea rămâne: „Cum se deployează rapid”?
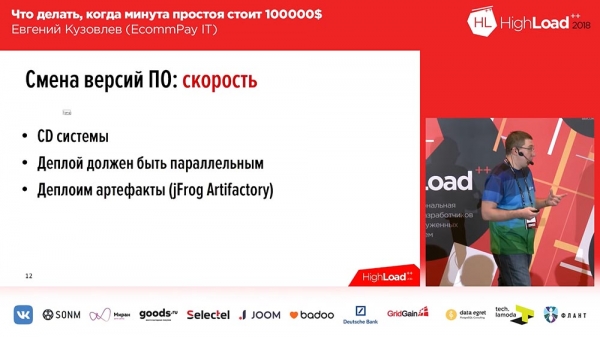
Aici, pe scurt, totul este simplu.- Trebuie să aveți un sistem CD (Continuous Delivery) – fără el nu merge. Dacă aveți un singur server, vă puteți desfășura manual. Noi avem aproximativ o mie și jumătate de servere și, evident, nu putem avea un departament atât de mare, nu putem avea un întreg salon pentru a desfășura.
- Deploy-ul trebuie să fie paralel. Dacă aveți un deploy secvențial, atunci totul este rău. Un server – e în regulă, dar o mie și jumătate de servere le veți desfășura toată ziua.
- Din nou, pentru accelerare, nu mai este absolut necesar, cred. Când se desfășoară un deploy, de obicei, se execută construcția proiectului. Dacă aveți un proiect web, aveți partea de front-end (faceți un webpack, adunați cu npm – ceva de genul acesta), iar acest proces, în principiu, nu durează mult – 5 minute, dar aceste 5 minute pot fi critice. De aceea, de exemplu, noi nu facem așa: am eliminat aceste 5 minute, desfășurăm artefactele.
Ce este un artefact? Un artefact este o construcție acumulată în care a fost realizată deja întreaga parte de construcție. Acest artefact îl păstrăm într-un depozit de artefacte. La un moment dat, am folosit două astfel de depozite – era Nexus și acum jFrog Artifactory. „Nexus” l-am utilizat inițial pentru că am început să aplicăm această abordare în aplicațiile java (se potrivea bine pentru aceasta). Apoi, am inclus și o parte din aplicații scrise în PHP; și „Nexus” nu se mai potrivea, așa că am ales jFrog Artifactory, care poate gestiona aproape orice. Am ajuns chiar la punctul în care în acest depozit de artefacte păstrăm pachetele noastre binare pe care le compilăm pentru servere.
Creștere explozivă a încărcării
Am discutat despre schimbarea versiunii software-ului. Următorul lucru pe care îl avem este creșterea explozivă a încărcării. Aici, probabil, înțeleg prin creștere explozivă a încărcării o idee nu tocmai corectă...
Am scris un nou sistem – este orientat pe servicii, elegant, frumos, cu lucrători peste tot, cozi pretutindeni, totul este asincron. În astfel de sisteme, datele pot circula pe fluxuri diferite. Pentru prima tranzacție pot fi implicați lucrătorii 1, 3, 10, iar pentru a doua tranzacție – lucrătorii 2, 4, 5. Și astăzi, de exemplu, dimineața aveți un flux de date care implică primii trei lucrători, iar seara se schimbă brusc și se implică ceilalți trei lucrători.
Și aici apare problema, că trebuie să scalăm lucrătorii, trebuie să scalăm serviciile, dar fără a duce la o creștere a resurselor.
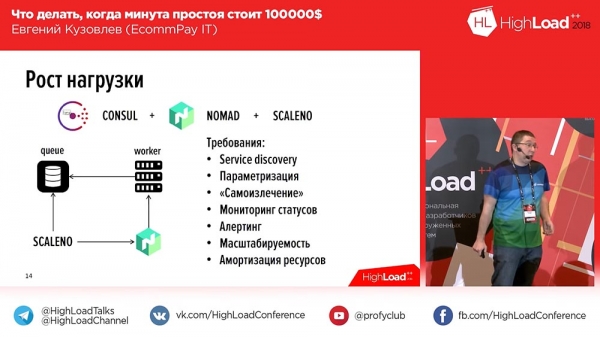
Am stabilit cerințele pentru noi. Aceste cerințe sunt destul de simple: să existe descoperire a serviciilor, parametrare – totul standard pentru construirea unor astfel de sisteme scalabile, cu o excepție – amortizarea resurselor. Am spus că nu suntem pregătiți să amortizăm resursele, astfel încât serverele să nu fie utilizate la maxim. Am adoptat „Consul”, am adoptat „Nomad”, care gestionează lucrătorii noștri.De ce este aceasta o problemă pentru noi? Haideți să ne întoarcem puțin. În prezent, avem aproximativ 70 de sisteme de plată. Dimineața, traficul trece prin „Sberbank”, apoi „Sberbank” cade, de exemplu, și trebuie să-l comutăm pe alt sistem de plată. Am avut 100 de lucrători înainte de „Sberbank”, iar după aceea trebuie să creștem brusc 100 de lucrători pentru un alt sistem de plată. Și aceasta ar trebui să se întâmple fără intervenția umană. Pentru că, dacă este implicată o persoană, atunci trebuie să existe un inginer care să stea 24/7 doar pentru a se ocupa de asta, deoarece astfel de defecțiuni, când 70 de sisteme depind de tine, apar frecvent.
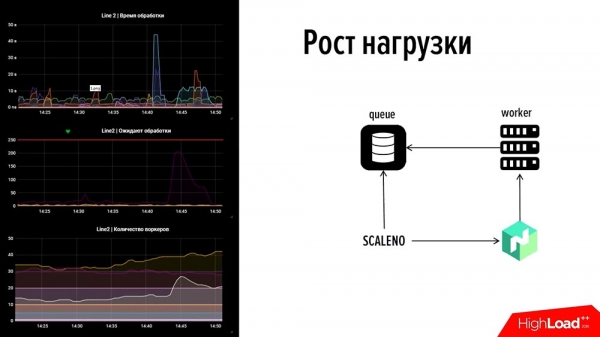
Așadar, ne-am uitat la „Nomad”, care are un IP deschis, și am scris propriul nostru instrument Scale-Nomad – ScaleNo, care face următoarele: monitorizează creșterea cozilor și ajustează numărul de lucrători în funcție de dinamica schimbării cozilor. Când l-am realizat, ne-am gândit: „Poate ar trebui să-l open-source-izăm?” Apoi, când ne-am uitat la el, s-a dovedit a fi simplu, ca două parale.
Până acum nu l-am open-source-izat, dar dacă, după acest raport, realizând că aveți nevoie de un astfel de instrument, apare o necesitate, în ultimul slide sunt contactele mele – vă rog să-mi scrieți. Dacă se strâng măcar 3-5 persoane – o vom open-source-i.
Cum funcționează? Să vedem! În avans: pe partea stângă avem o porțiune din monitorizarea noastră: aceasta este o linie, sus - timpul de procesare a evenimentelor, în mijloc - numărul de tranzacții, iar jos - numărul de lucrători.Dacă ne uităm, în această imagine există o defecțiune. Pe graficul de sus, unul dintre grafice a ieșit din parametri în 45 de secunde - unul dintre sistemele de plată a căzut. Imediat a fost prezentat traficul pentru 2 minute și a început creșterea cozii pe celălalt sistem de plată, unde nu erau lucrători (nu am utilizat resursele - dimpotrivă, am utilizat resursa corect). Nu am vrut să supraîncărcăm - erau acolo un număr minim, aproximativ 5-10 lucrători, dar nu făceau față.
Pe ultimul grafic se vede un „cordon” care exact arată că „Scaleno” a mărit această cantitate de două ori. Și apoi, când graficul a scăzut puțin, a redus ușor - numărul de lucrători a fost modificat automat. Așa funcționează acest sistem. Am discutat despre punctul nr. 2 - „Cum să ne desfășurăm rapid de cauze”.
Monitorizarea. Cum să identificăm rapid o problemă?
Acum, primul punct - „Cum să identificăm rapid o problemă?” Monitorizarea! Trebuie să înțelegem rapid anumite lucruri. Ce lucruri trebuie să înțelegem rapid?
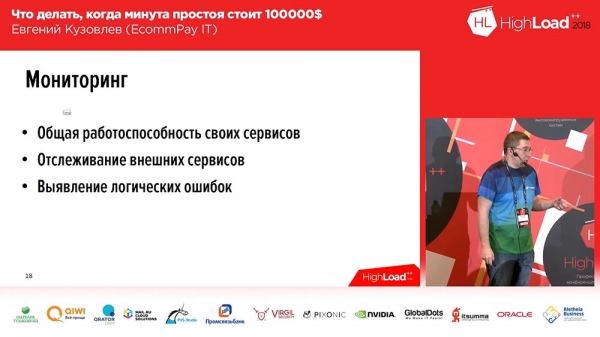
Trei lucruri!- Trebuie să înțelegem rapid și eficient funcționalitatea propriilor noastre resurse.
- Trebuie să înțelegem rapid defecțiunile, să monitorizăm funcționalitatea sistemelor care sunt externe pentru noi.
- Al treilea punct - identificarea erorilor logice. Este atunci când sistemul funcționează corect, toate indicatorii sunt normali, dar ceva nu merge bine.
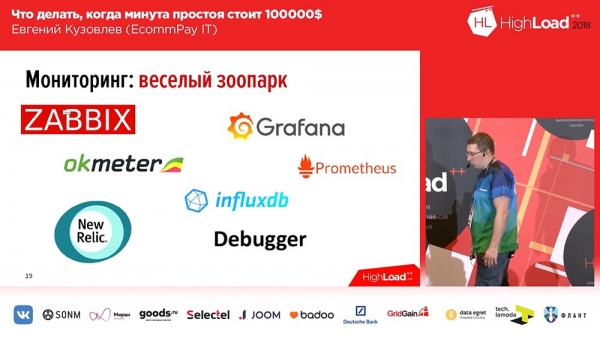
Aici, probabil, nu am multe lucruri grozave de spus. Voi fi căpitanul Ovidiu. Am căutat ce există pe piață. Ne-am creat un „zoo vesel”. Iată ce fel de zoo avem acum:
Avem „Zabbix” folosit pentru monitorizarea „hardului”, pentru monitorizarea principalelor indicatori ai serverelor. „Okmeter” îl folosim pentru baze de date. „Grafana” și „Prometheus” le folosim pentru toate celelalte indicatori care nu s-au încadra în primele două, parte - cu „Grafana” și „Prometheus”, parte - „Grafana” cu „Influx” și Telegraf.Acum un an am vrut să folosim New Relic. E un instrument grozav, care face totul. Dar, pe cât de mult face, pe atât de scumpă este. Când am crescut la un număr de 1.500 de servere, a venit la noi un furnizor și a spus: „Hai să semnăm un contract pentru anul următor”. Ne-am uitat la preț și am spus că nu, așa ceva nu facem. Acum ne desprindem de New Relic, ne-au mai rămas aproximativ 15 servere sub monitorizarea New Relic. Prețul a fost complet absurd.
Și există un instrument pe care l-am implementat noi înșine – se numește Debugger. La început l-am numit „Bagger”, dar apoi a venit un profesor de engleză la noi, a râs zdravăn și l-am redenumit „Debugger”. Ce este acesta? Este un instrument care, în 15-30 de secunde pe fiecare componentă, funcționează ca un „cufăr negru” al sistemului și rulează teste pentru a verifica funcționarea generală a componentei.
De exemplu, dacă este o pagină externă (pagina de plată) – pur și simplu o deschide și verifică cum ar trebui să arate. Dacă este un procesor, face o „tranzacție” de test și verifică dacă această „tranzacție” a ajuns. Dacă este o conexiune cu sistemele de plată – trimitem, de asemenea, o solicitare de test, unde putem, și verificăm că totul este bine.
Ce indicatori sunt importanți pentru monitorizare?
Ce monitorizăm în principal? Ce indicatori sunt importanți pentru noi?
- Timpul de răspuns / RPS pe frontend-uri – este un indicator foarte important. Acesta indică imediat că ceva nu este în regulă.
- Numărul de mesaje procesate în toate coada.
- Numărul de lucrători.
- Metrici de bază pentru corectitudine.
Ultimul punct – este un indicator „de afaceri”. Dacă dorești să monitorizezi același lucru, trebuie să stabilești una sau două metrici care sunt indicatorii tăi principali. La noi, acest indicator este rata de trecere (raportul dintre numărul tranzacțiilor reușite și fluxul total de tranzacții). Dacă ceva se schimbă în intervalul de 5-10-15 minute – înseamnă că avem probleme (dacă se schimbă semnificativ).
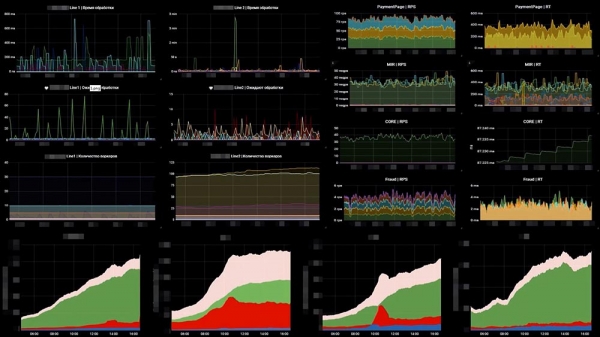
Cum arată asta la noi – un exemplu dintr-unul dintre tablouri:
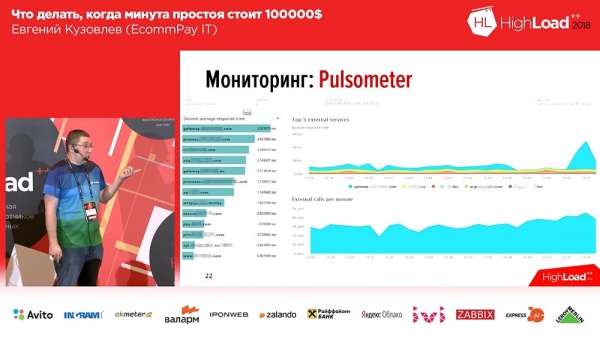
În partea stângă se află 6 grafice, corespunzătoare liniilor - numărul de lucrători și numărul de mesaje în cozi. În partea dreaptă se află RPS, RTS. În jos - acea metrică «de afaceri». Și pe metrică «de afaceri» vedem imediat că ceva nu a mers bine pe cele două grafice medii... Aceasta este exact când a căzut un alt sistem care ne susținea.Al doilea lucru pe care trebuia să-l facem a fost să monitorizăm căderea sistemelor externe de plată. Aici am folosit OpenTracing - un mecanism, un standard, o paradigmă care permite trasarea sistemelor distribuite; și l-am modificat puțin. Paradigma standard OpenTracing spune că construim trasarea fiecărei cereri individuale. Asta nu ne era necesar, așa că am învelit-o într-o trasare sumară, de agregare. Am creat un instrument care ne permite să urmărim viteza sistemelor care ne susțin.
Graficul ne arată că unul dintre sistemele de plată a început să răspundă în 3 secunde - au apărut probleme. În plus, acest sistem va reacționa atunci când problemele au început, într-un interval de 20-30 de secunde.Și a treia categorie de erori de monitorizare existente este monitorizarea logică.
Sincer, nu am știut ce să desenez pe această diapozitivă, pentru că am căutat mult pe piață ceea ce ne-ar fi fost util. Nu am găsit nimic, așa că a trebuit să facem noi înșine.
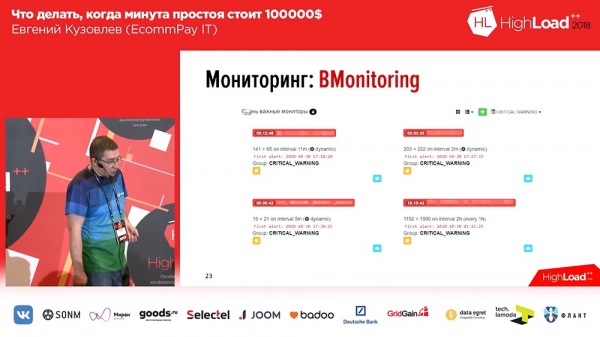
Ce înțeleg prin monitorizare logică? Ei bine, imaginați-vă: vă creați un sistem (de exemplu, un clon al «Tinder»); l-ați realizat, l-ați lansat. Managerul de succes Vasia Pupkin l-a instalat pe telefonul său, vede o fată, o dă like... dar like-ul nu ajunge la fată - like-ul ajunge la paznicul Mihalyc din același centru de afaceri. Managerul coboară și se întreabă: «De ce îi zâmbește atât de plăcut acest paznic Mihalyc?»În astfel de situații... pentru noi, această situație sună un pic diferit, deoarece (am scris) este o pierdere reputațională, care duce indirect la pierderi financiare. La noi, situația este inversă: putem suferi pierderi financiare directe – de exemplu, dacă am realizat o tranzacție ca fiind reușită, iar aceasta a fost de fapt nereușită (sau invers). A trebuit să dezvolt un instrument propriu care să urmărească, pe baza indicatorilor de afaceri, numărul de tranzacții reușite în dinamică pe un interval de timp. Nu am găsit nimic pe piață! Exact această idee voiam să o transmit. Pentru a rezolva acest tip de sarcină, pe piață nu există nimic.
Asta a fost cu privire la cum să identificăm rapid o problemă.
Cum să determinăm motivele implementării
Grupul trei de sarcini pe care le rezolvăm – este după ce am depistat problema, după ce ne-am debarasat de ea, ar fi bine să înțelegem cauza pentru dezvoltare, pentru testare și să facem ceva în legătură cu asta. Prin urmare, trebuie să cercetăm, trebuie să ridicăm logurile.
Dacă vorbim despre loguri (principala cauză – logurile), cea mai mare parte a logurilor noastre se află în ELK Stack – practic toată lumea așa face. La unii, poate, nu în ELK, dar dacă scrieți loguri cu gigabytes, în cele din urmă veți ajunge la ELK. Noi le scriem cu terabytes.
Aici există o problemă. Am reparat, am corectat o eroare pentru utilizator, am început să săpăm, ce a fost acolo, am intrat în Kibana, am introdus id-ul tranzacției și am obținut un astfel de raport (arată mult). Și în acest raport nu se înțelege nimic. De ce? Pentru că nu este clar ce parte aparține carei unități de lucru, ce parte aparține carei componente. Și în acel moment, ne-am dat seama că avem nevoie de trasabilitate – aceeași OpenTracing despre care am vorbit.Ne-am gândit la asta acum un an, ne-am îndreptat privirea spre piață, și acolo s-au dovedit a fi două instrumente – Zipkin și Jaeger. Jaeger este de fapt un urmaș ideologic, un continuator ideologic al Zipkin. În Zipkin, totul este bun, în afară de faptul că nu poate agrega, nu poate include logurile în trasabilitate, doar trasabilitatea timpului. Iar Jaeger a suportat acest lucru.
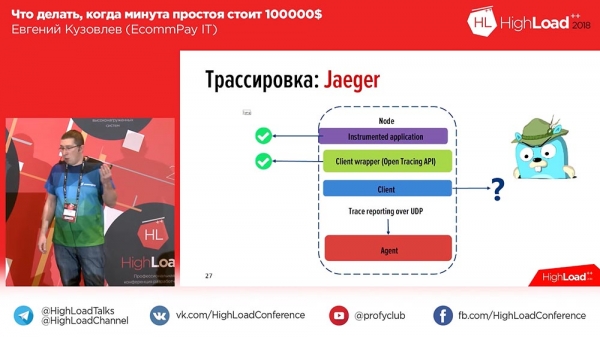
Am privit la «Eger»; se poate instrumenta aplicații, se pot scrie în API (standardul API pentru PHP, la acel moment, de fapt, nu fusese aprobat – acum un an, dar acum a fost aprobat), iar clientul nu exista deloc. „Bine”, ne-am gândit noi, și am scris propriul client. Ce am obținut? Iată cum arată aproximativ:
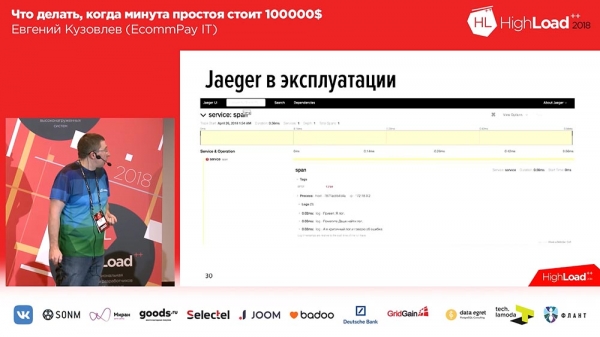
În „Eger”, pentru fiecare mesaj se creează span-uri. Adică, atunci când utilizatorul deschide sistemul, el vede unul sau două blocuri pentru fiecare cerere primită (1-2-3 – câte cereri primite de la utilizator au fost, atâtea blocuri sunt). Pentru a-i face mai ușor utilizatorului, am adăugat etichete la jurnale și la urmărirea temporală. Prin urmare, în cazul unei erori, aplicația noastră va marca jurnalul cu eticheta corespunzătoare Error. Poți filtra după eticheta Error și vor apărea doar span-urile care conțin acel bloc cu eroare. Iată cum arată, dacă desfășurăm span:
În interiorul span-ului există un set de trace-uri. În acest caz, sunt trei trace-uri de test, iar al treilea trace ne spune că a apărut o eroare. De asemenea, aici vedem și urmărirea temporală: în partea de sus – o scară temporală, și vedem pe ce interval de timp a fost înregistrat un anumit jurnal.Prin urmare, ne-a ieșit excelent. Am scris propriul nostru extensie și l-am open-sourcit. Dacă doriți să lucrați cu urmărirea, dacă doriți să lucrați cu „Eger” în limbajul PHP – avem extensia noastră, bine ați venit să o folosiți, cum se spune:
Extensia noastră – este un client pentru a lucra cu OpenTracing API, realizat ca un php-extention, adică va trebui să-l construiți și să-l integrați în sistem. Acum un an nu exista nimic altceva. Acum au apărut și alți clienți, culcați ca componente. Aici este alegerea ta: fie descărcați componentele cu composer, fie folosiți extensia, alegerea este a ta.Standarde corporative
Am discutat despre cele trei porunci. A patra poruncă este standardizarea abordărilor. Despre ce este vorba? Este cam așa:
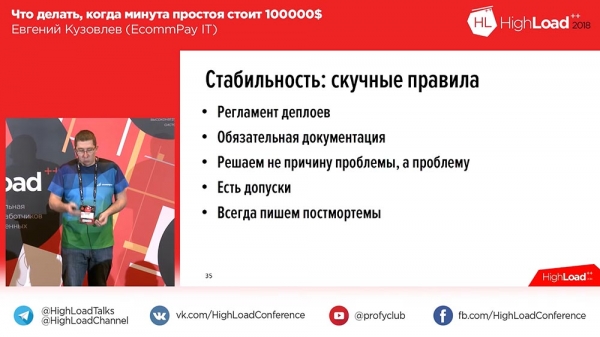
De ce apare aici cuvântul „corporative”? Nu pentru că suntem o companie mare sau birocratică, nu! Cuvântul „corporativ” l-am vrut folosit în contextul în care fiecare companie, fiecare produs ar trebui să aibă propriile standarde, iar voi la fel. Ce standarde avem noi?- Avem un regulament pentru desfășurarea de activități. Fără el, nu putem progresa. Ne desfășurăm activitățile de aproximativ 60 de ori pe săptămână, ceea ce înseamnă că desfășurările au loc practic constant. De exemplu, regulamentul nostru interzice desfășurările vinerea – în principiu, nu desfășurăm.
- Documentația este obligatorie pentru noi. Niciun nou component nu ajunge în producție fără documentație, chiar dacă este creat de echipa noastră de R&D. Cerem de la ei un ghid pentru desfășurare, o hartă de monitorizare și o descriere generală (așa cum pot scrie programatorii) despre modul în care funcționează acest component, cum se poate face depanarea lui.
- Noi rezolvăm nu cauza problemei, ci problema în sine – așa cum am menționat deja. Este important pentru noi să protejăm utilizatorul de probleme.
- Avem toleranțe. De exemplu, nu considerăm downtime dacă pierdem 2 % din trafic timp de două minute. Aceasta nu intră în statistica noastră. Dacă procentajul sau timpul depășesc aceste valori, atunci începem să considerăm.
- Și întotdeauna scriem post-mortemuri. Indiferent ce se întâmplă, orice situație în care sistemul a avut un comportament neobișnuit în producție va fi reflectată în post-mortem. Un post-mortem este un document în care scrieți ce s-a întâmplat, un cronologic detaliat, ce ați făcut pentru a remedia situația și (acesta este un bloc obligatoriu!) ce veți face pentru a preveni repetarea în viitor. Este obligatoriu, necesar pentru analizele următoare.
Ce considerăm downtime?
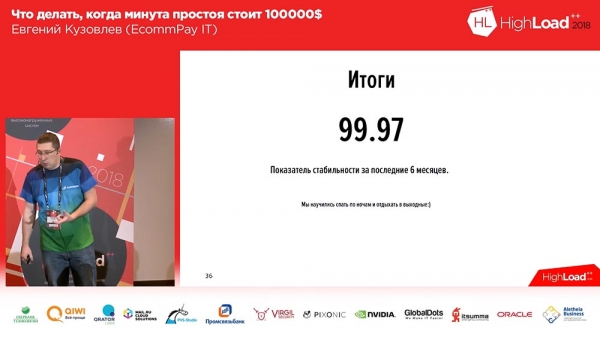
La ce a dus totul aceasta?A dus la faptul că (am avut anumite probleme cu stabilitatea, ceea ce nu a fost acceptabil nici pentru clienți, nici pentru noi) în ultimele 6 luni, indicele nostru de stabilitate a fost de 99,97. Se poate spune că nu este foarte mult. Da, avem lucruri la care să ne străduim. Aproximativ jumătate din acest indice este datorată stabilității furnizorului nostru de firewall pentru aplicații web, care ne protejează și care este utilizat ca un serviciu, dar clienții nu țin cont de acest lucru.
Am învățat să dormim liniștiți noaptea. În sfârșit! Acum șase luni, nu reușeam. Și în această notă, cu privire la concluzii, vreau să fac o observație. Ieri seară a avut loc o prezentare minunată despre sistemul de control al unui reactor nuclear. Dacă mă aud acei oameni care au scris acest sistem – vă rog, uitați ce am spus despre „2% - acesta nu este downtime”. Pentru voi, 2% reprezintă downtime, chiar dacă doar pentru două minute!
Asta este tot! Întrebările voastre.
Despre balansatoare și migrarea din baza de date
Întrebare din audiență (în continuare – I): – Bună seara. Vă mulțumesc foarte mult pentru acest raport administrativ! Întrebarea este scurtă, pe tema balansatoarelor dumneavoastră. Ați menționat că aveți WAF, adică, după cum înțeleg, utilizați un fel de exterior ca balansator...
EK: – Nu, ca balansator utilizăm serviciile noastre. În acest caz, WAF este pentru noi exclusiv un instrument de protecție împotriva DDoS.
M: – Puteți să ne spuneți câteva cuvinte despre balansatoare?
EK: – Așa cum am spus, este vorba despre un grup de servere în openresty. Avem acum 5 grupuri rezervate, care răspund exclusiv... adică serverul pe care este exclusiv openresty, el doar proxy-izează traficul. În consecință, pentru a înțelege câte avem: avem acum un flux normal de trafic – câteva sute de megabiți. Ele fac față, le merge bine, chiar nu se stresează.
M: – O altă întrebare simplă. Există Blue/Green deployment. Ce faceți, de exemplu, cu migrațiile din baza de date?
EK: – Întrebare bună! Uitați, în Blue/Green deployment, avem cozi separate pentru fiecare linie. Adică, dacă vorbim despre cozile de evenimente care sunt transmise de la un worker la altul, există cozi separate pentru linia albastră și pentru linia verde. Dacă vorbim despre baza de date însăși, noi am îngustat-o intenționat cât am putut, am mutat totul practic în cozi, în baza de date păstrăm doar stiva de tranzacții. Și stiva de tranzacții este unică pentru toate liniile. În acest context al bazei de date: nu o împărțim în blue și green, deoarece ambele variante de cod ar trebui să știe ce se întâmplă cu tranzacția.
Prietenii, am o mică recompensă pentru a vă stimula – o carte. Și trebuie să o înmânez pentru cea mai bună întrebare.
M: – Bună ziua. Vă mulțumesc pentru prezentare. Întrebarea este aceasta. Monitorizați plățile, monitorizați serviciile cu care interacționați... Dar cum monitorizați faptul că o persoană a ajuns cumva pe pagina de plată, a efectuat plata, iar proiectul i-a acreditat banii? Adică, cum monitorizați că merchantul este disponibil și a acceptat callback-ul vostru?
EK: – «Merchant» pentru noi în acest caz este exact același serviciu extern ca și sistemul de plată. Monitorizăm viteza de răspuns a merchantului.
Despre criptarea bazei de date
M: – Bună ziua. Am o întrebare rapidă. Aveți date sensibile conform PCI DSS. Aș dori să știu cum stocați PAN-urile în cozi, care trebuie să fie transmise? Folosiți vreo criptare? Și deci, o a doua întrebare: conform PCI DSS, este necesar să recriptografați periodic baza de date în caz de modificări (de exemplu, în cazul concedierii administratorilor) – cum se procedează în acest caz cu disponibilitatea?
EK: – O întrebare excelentă! În primul rând, nu stocăm PAN-uri în cozi. Nu avem dreptul de a stoca PAN-uri în mod deschis, de fapt, așa că utilizăm un serviciu special (îl numim „Keydemon”) – acesta este un serviciu care face un singur lucru: primește un mesaj și îl returnează criptat. Și noi stocăm toate mesajele criptate. În consecință, lungimea cheia noastră este de aproape un kilobit pentru a fi serioasă și sigură.M: – Este acum nevoie de 2 kilobiti?
EK: – Parcă ieri era 256… Încotro mai putem merge?!
În consecință, aceasta este prima parte. Și în al doilea rând, soluția existentă suportă procedura de recriptare – există două perechi de „KEK-uri” (chei) care generează „DEK-uri” care criptează (key – sunt cheile, dek – sunt derivate din chei care criptează). Și în cazul inițierii procedurii (se desfășoară regulat, de la 3 luni până la ± anumite) încărcăm o nouă pereche de „KEK-uri” și are loc recriptarea datelor. Avem servicii separate care extrag toate datele, le criptează din nou; pentru date, lângă acestea se păstrează un identificator al cheii cu care au fost criptate. În consecință, de îndată ce datelor le sunt aplicate noile chei, ștergem cheile vechi.
Uneori plățile trebuie efectuate manual…
M: – Deci, dacă a venit o returnare pentru o operațiune, veți decripta temporar cu cheia veche?
EK: – Da.
M: – Atunci, încă o întrebare mică. Când are loc o eroare, o cădere, un incident, este necesar să împingeți tranzacția manual. Apar astfel de situații.
EK: – Da, apar.
M: – De unde obțineți aceste date? Sau mergeți voi în mod manual în acel depozit?
EK: – Nu, e clar – avem un fel de sistem de back-office care conține o interfață pentru suportul nostru. Dacă nu știm în ce stare se află tranzacția (de exemplu, până când sistemul de plată nu răspunde din cauza unui timeout) – nu știm prima dată, adică atribuim starea finală doar când suntem complet siguri. În acest caz, clasificăm tranzacția într-o stare specială pentru procesare manuală. Dimineața, în ziua următoare, imediat ce suportul primește informații că în sistemul de plată au rămas anumite tranzacții, acestea sunt procesate manual în această interfață.
M: – Am câteva întrebări. Una dintre ele este despre continuarea zonei PCI DSS: cum extrageti jurnalele din conturul lor? Întreb acest lucru deoarece dezvoltatorul ar fi putut să pună orice în jurnale! A doua întrebare: cum implementați hotfix-urile? Manual în baza de date – acesta este un mod, dar ar putea exista hotfix-uri gratuite – care este procedura pentru acestea? Și a treia întrebare, probabil, se leagă de RTO, RPO. Ați avut o disponibilitate de 99,97, aproape patru nouă, dar înțeleg că aveți și al doilea centru de date, și al treilea centru de date, și al cincilea centru de date… Cum vă ocupați de sincronizarea, replicarea și toate celelalte?EK: – Să începem cu prima. Prima întrebare a fost despre jurnale? Atunci când se scriu jurnale, avem un strat care maschează toate datele sensibile. Acesta verifică conform unor măști și câmpuri adiționale. Prin urmare, jurnalele noastre ies cu datele deja mascate și conform zonei PCI DSS. Aceasta este una dintre sarcinile regulate care revine departamentului de testare. Ei trebuie să verifice fiecare sarcină și în ceea ce privește jurnalele pe care le scriu, iar aceasta este una dintre sarcinile regulate în cadrul revizuirii codului, pentru a controla că dezvoltatorul nu a înregistrat ceva. Verificarea ulterioară a acestora este realizată regulat de departamentul de securitate a informațiilor, aproximativ o dată pe săptămână: se iau aleatoriu jurnalele din ultima zi și acestea sunt trecute printr-un scanner-analyzer special de pe serverele de testare, pentru a verifica totul.
Despre hot-fix-uri. Acestea sunt incluse în reglementările noastre pentru desfășurarea activităților. Avem un punct separat despre hotfix-uri. Considerăm că implementăm hotfix-uri 24 de ore din 24, ori de câte ori este necesar. De îndată ce versiunea este compilată, odată ce a fost testată și odată ce avem artefactul – un administrator de sistem de gardă este contactat de suport și implementează aceasta în momentul în care este necesar.Despre «cele patru nouă». Numărul pe care îl avem acum a fost într-adevăr atins, și ne-am străduit să ajungem la el încă într-un alt centru de date. Acum avem un al doilea centru de date și începem să rutăm între ele, iar problema replicării între centrele de date este cu adevărat una complexă. Am încercat să o rezolvăm la vremea respectivă prin diverse mijloace: am încercat să folosim același «Tarantool» – dar nu a funcționat, spun din start. Așadar, am ajuns la concluzia că facem comenzi pentru «Sensa» manual. Fiecare aplicație, de fapt, rulează în mod asincron sincronizarea necesară «change – done» între centrele de date.
M: – Dacă ați avut un al doilea, de ce nu a apărut un al treilea? Pentru că Split-brain nu a fost rezolvat de nimeni...
EK: – La noi nu există «Split-brain». Deoarece fiecare aplicație folosește multi-master, nu ne pasă în ce centru a venit cererea. Suntem pregătiți ca, în cazul în care un centru de date cedează (la asta ne așteptăm) și în mijlocul cererii utilizatorului să se comute pe al doilea centru de date, suntem pregătiți să pierdem acel utilizator, de fapt; dar vor fi doar câțiva, cu adevărat câțiva.
M: – Bună seara. Mulțumesc pentru prezentare. Ați vorbit despre debugger-ul vostru, care rulează anumite tranzacții de test în producție. Dar spuneți-ne despre tranzacțiile de test! Cât de adânc coboară?
EK: – Acesta parcurge întregul ciclu al componentei. Pentru componentă nu există diferențe între tranzacția de test și cea de producție. Din punct de vedere al logicii, este pur și simplu un proiect separat în sistem, pe care se rulează doar tranzacții de test.
M: – Unde o filtrați? Core a trimis...
EK: – Noi urmărim «Core» în acest caz pentru tranzacțiile de test... Avem un concept numit rutare: «Core» știe în ce sistem de plăți trebuie să trimită – noi trimitem într-un sistem de plată fals care oferă doar un răspuns http și atât.
M: – Vă rog, spuneți-mi, aplicația dvs. este scrisă ca un monolit uriaș sau ați împărțit-o în servicii sau chiar microservicii?
EK: – Nu este un monolit, desigur, este o aplicație orientată pe servicii. Glumim că avem un serviciu din monolite – ele sunt cu adevărat destul de mari. Nu putem să le numim microservicii, dar sunt într-adevăr servicii în care funcționează lucrători distribuiți.
Dacă un serviciu de pe server este compromis…
M: – Atunci am următoarea întrebare. Chiar dacă ar fi fost un monolit, ați spus că aveți multe dintre aceste servere instant, toate acestea, în principiu, procesează date, iar întrebarea este: „În caz de compromitere a unuia dintre serverele instant sau a aplicației, a unei părți separate, există un control al accesului? Cine dintre ele poate face ce? La cine se poate apela pentru ce date?
EK: – Da, fără îndoială. Cerințele de securitate sunt destul de severe. În primul rând, avem mișcări de date deschise, iar porturile sunt doar cele pe care ne așteptăm în prealabil să existe trafic. Dacă un component comunică cu baza de date (să spunem, cu «MySQL») pe 5-4-3-2, acesta va avea deschise doar 5-4-3-2, iar alte porturi și alte direcții de trafic nu vor fi accesibile. În plus, trebuie să înțelegem că în producție există aproximativ 10 contururi de securitate diferite. Și chiar dacă aplicația a fost compromisă în vreun fel, Doamne ferește, atacatorul nu va putea accesa consola de gestionare a serverului, deoarece aceasta face parte dintr-o altă zonă de securitate.M: – În acest context, ceea ce mă interesează mai mult este că aveți anumite contracte cu serviciile – ce pot face ele, prin ce „acțiuni” pot comunica între ele… Și într-un flux normal, anumite servicii cer o serie definită de „acțiuni” de la alt serviciu. Cu altele, în mod normal, ele nu interacționează și au alte zone de responsabilitate. Dacă unul dintre ele este compromis, va putea acesta să acceseze „acțiunile” acelui serviciu?
EK: – Înțeleg. Dacă într-o situație normală cu alt server comunicarea a fost de fapt permisă, atunci – da. Conform contractului SLA, nu monitorizăm că îți sunt permise doar primele 3 „acțiuni”, iar a 4-a „acțiune” nu îți este permisă. Asta este poate prea mult pentru noi, pentru că avem totuși un sistem de protecție pe 4 niveluri pentru contururi. Preferăm să ne protejăm prin contururi, nu la nivel de interior.
Cum funcționează Visa, MasterCard și „Sberbank”
M: – Vreau să clarific un aspect referitor la schimbarea utilizatorului de la un centru de date la altul. După cum știu, „Visa” și „MasterCard” operează pe un protocol sincron binar 8583, acolo sunt mixuri. Și aș vrea să știu, acum se referă la schimbare – este vorba de „Visa” și „MasterCard” direct sau până la sistemele de plată, până la procesare?
EK: – Este până la mixuri. Mixurile noastre sunt într-un singur centru de date.
M: – Deci, în mare, aveți un singur punct de conectare?
EK: – Pentru „Visa” și „MasterCard” – da. Pur și simplu pentru că „Visa” și „MasterCard” necesită investiții serioase în infrastructură pentru a încheia contracte separate pentru obținerea unei a doua perechi de mixuri, de exemplu. Ele sunt rezervate în cadrul unui singur centru de date, dar dacă, Doamne ferește, moare centrul nostru de date unde sunt mixurile pentru conectarea la „Visa” și „MasterCard”, atunci legătura cu „Visa” și „MasterCard” va fi pierdută...
M: – Cum pot fi rezervate? Știu că „Visa” permite să ai de fapt doar o singură conexiune!
EK: – Ele furnizează singure echipamentele. Oricum, ne-a venit un echipament care este rezervat la nivel de hardware.
M: – Adică rack-ul de la Connects Orange?
EK: – Da.
M: – Și ce se întâmplă în acest caz: dacă centrul vostru de date dispare, cum să-l folosiți mai departe? Sau pur și simplu traficul se oprește?
EK: – Nu. În acest caz, doar vom schimba traficul pe un alt canal, care, evident, va fi mai scump pentru noi, mai scump pentru clienți. Dar traficul va merge nu prin conexiunea noastră directă cu „Visa”, „MasterCard”, ci printr-un „Sberbank” condiționat (foarte exagerat).
Îmi cer scuze dacă am deranjat angajații „Sberbank”. Dar conform statisticilor noastre, dintre băncile rusești, „Sberbank” se supune cel mai frecvent. Nu trece o lună fără ca „Sberbank” să nu aibă vreo problemă.

Puțin publicitate 🙂
Mulțumim că rămâneți cu noi. Vă plac articolele noastre? Doriți să vedeți mai multe materiale interesante? Susțineți-ne, efectuând o comandă sau recomandându-ne prietenilor, , un echivalent unic pentru serverele entry-level, care a fost creat de noi pentru voi: (sunt disponibile opțiuni cu RAID1 și RAID10, până la 24 nuclee și până la 40GB DDR4).
Dell R730xd la jumătate de preț în centrul de date Equinix Tier IV din Amsterdam? Numai la noi în Olanda! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — de la 99 $! Citiți despre
Sursa: habr.com
