

Principiul incertitudinii lui Heisenberg afirmă că nu se poate măsura simultan atât poziția unui obiect, cât și viteza acestuia. Dacă obiectul se mișcă, atunci acesta nu are o locație. Și dacă există o locație, atunci nu are viteză.
În ceea ce privește microserviciile pe platforma Red Hat OpenShift (și gestionate de Kubernetes), datorită software-ului open-source adecvat, acestea pot raporta simultan atât performanța, cât și starea lor de funcționare. Acest lucru nu contrazice, desigur, pe bătrânul Heisenberg, dar elimină incertitudinea în lucrul cu aplicațiile cloud. Istio facilitează organizarea ușoară a urmăririi (tracing) și monitorizării acestor aplicații pentru a menține totul sub control.
Să ne stabilim terminologia
Sub tracing (Tracing) înțelegem logarea activității sistemului. Sună destul de generic, dar de fapt, una dintre regulile de bază aici este de a trimite datele de tracing către un stocare adecvată, fără a ne preocupa de formatul acestora. Toată munca de căutare și analiză a datelor este încredințată consumatorului acestora. În Istio, se folosește sistemul de tracing Jaeger, care implementează modelul de date OpenTracing.
Traces (Traces, iar cuvântul «traces» este folosit aici în sensul de «urme», cum ar fi în expertiza balistică) ne referim la datele care descriu complet parcursul unei cereri sau al unei unități de lucru, așa cum se spune, «de la început până la sfârșit». De exemplu, tot ce se întâmplă de la momentul în care utilizatorul apasă un buton pe pagina web și până în momentul returnării datelor, inclusiv toate microserviciile implicate. Se poate spune că o trasă descrie complet (sau modelează) parcursul cererii dus-întors. În interfața Jaeger, trasele sunt desfăcute în componente pe axa timpului, la fel cum o lanț poate fi desfăcut în verigi separate. Doar că, în loc de verigi, o trasă este formată din așa-numitele span-uri.
Span – este intervalul dintre începutul executării unei unități de lucru și finalizarea acesteia. Continuând analogia, se poate spune că fiecare span reprezintă o verigă distinctă a lanțului. Un span poate avea (sau nu) unul sau mai multe span-uri copil. Ca urmare, span-ul de nivel superior (root span) va avea aceeași durată totală ca și trasă la care se referă.
Monitorizare – aceasta este, de fapt, observația sistemului dumneavoastră – prin ochi, prin intermediul interfeței utilizatorului sau al instrumentelor de automatizare. Monitorizarea se bazează pe datele de trasare. În Istio, monitorizarea este implementată folosind Prometheus și are o interfață corespunzătoare. Prometheus suportă monitorizarea automată utilizând alertele Alerts și Alert Managers.
Lăsăm semne
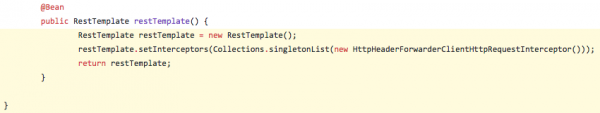
Pentru ca trasarea să fie posibilă, aplicația trebuie să creeze o colecție de span-uri. Apoi, acestea trebuie exportate către Jaeger, astfel încât să creeze o reprezentare vizuală a trasării. Printre altele, aceste span-uri marchează numele operației, precum și timpii de început și sfârșit. Transmiterea span-urilor se efectuează prin redirecționarea antetelor HTTP destinate pentru Jaeger de la cererile de intrare la cele de ieșire. În funcție de limbajul de programare utilizat, poate fi necesară o mică modificare a codului sursă al aplicațiilor. Iată un exemplu de cod în Java (utilizând framework-ul Spring Boot) care adaugă antetele B3 (Zipkin-style) cererii dumneavoastră în clasa de configurare Spring:
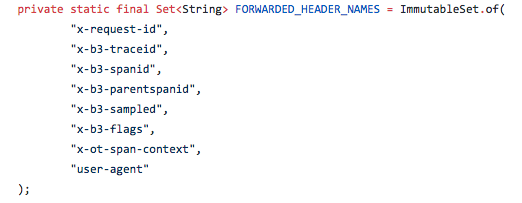
Se folosesc următoarele setări ale antetelor:
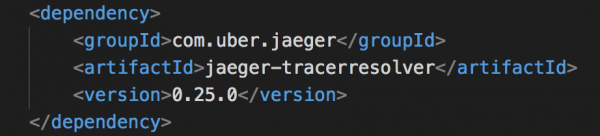
Dacă folosiți Java, codul poate fi lăsat neschimbat, iar în schimb, puteți adăuga câteva linii în fișierul POM al Maven și să setați variabilele de mediu. Iată ce linii trebuie să adăugați în fișierul POM.XML pentru a implementa Jaeger Tracer Resolver:
Iar variabilele de mediu corespunzătoare sunt setate în Dockerfile:
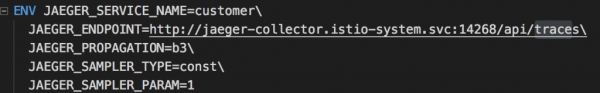
Totul este configurat acum și microserviciile noastre vor începe să genereze date de trasare.
Privim în linii mari
Istio include un panou de control simplu bazat pe Grafana. Când totul este configurat și funcționează pe platforma Red Hat OpenShift PaaS (în exemplul nostru, Red Hat OpenShift și Kubernetes sunt desfășurate pe minishift), acest panou se lansează cu următoarea comandă:
open "$(minishift openshift service grafana -u)\/d\/1\/istio-dashboard?refresh=5⩝Id=1"
Panoul Grafana permite o evaluare rapidă a performanței sistemului. Un fragment din acest panou este arătat în imaginea de mai jos:
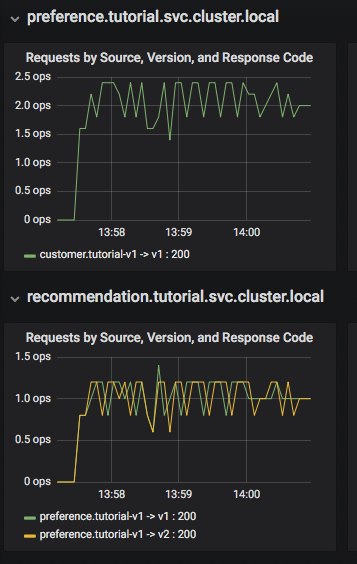
Aici se poate observa că microserviciul customer apelează microserviciul preference v1, care la rândul său apelează microserviciile recommendation v1 și v2. Pe panoul Grafana există un bloc Dashboard Row pentru metricile de înalt nivel, cum ar fi volumul total de cereri (Global Request Volume), rata cererilor reușite (success rates), erorile 4xx. În plus, există o reprezentare Server Mesh cu grafice pentru fiecare serviciu și un bloc Services Row pentru a vizualiza detaliile fiecărui container pentru fiecare serviciu.
Acum să aprofundăm subiectul
Cu o trasare Istio bine configurată, care, așa cum se spune, vine direct din cutie, permite aprofundarea analizei performanței sistemului. În UI-ul Jaeger, se pot vizualiza trasările și observa cât de departe și în adâncime se duc, precum și localiza vizual punctele de congestie în performanță. Atunci când folosiți Red Hat OpenShift pe platforma minishift, lansarea UI-ului Jaeger se face cu comanda următoare:
minishift openshift service jaeger-query --in-browser
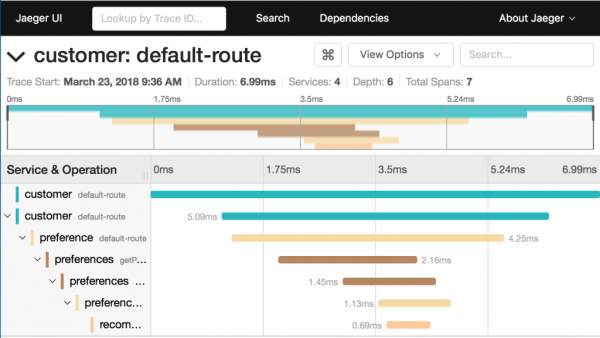
Ce se poate spune despre trasarea de pe acest screenshot:
- Se împarte în 7 span-uri.
- Timpul total de execuție este de 6.99 ms.
- Microserviciul recommendation, care este ultimul din lanț, consumă 0.69 ms.
Diagramelor de acest tip le permite să înțeleagă rapid situația în care performanța întregului sistem este afectată din cauza unui singur serviciu care nu funcționează corect.
Și acum să complicăm puțin sarcina și să lansăm două instanțe ale microserviciului recommendation:v2 cu comanda oc scale --replicas=2 deployment/recommendation-v2. Iată ce pod-uri vom avea după aceasta:
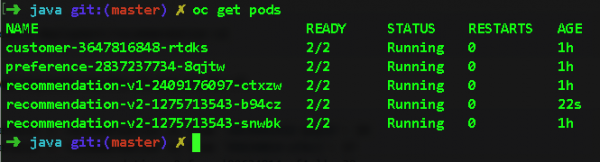
Dacă acum revenim în Jaeger și extindem span-ul pentru serviciul recommendation, vom vedea pe ce pod sunt rute cererile. Astfel, putem localiza cu ușurință întârzierile la nivel de pod specific. Trebuie să ne uităm la câmpul node_id:
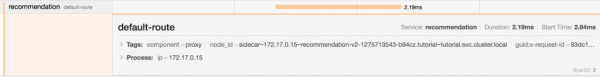
Unde și cum circulă totul
Acum ne îndreptăm spre interfața Prometheus și, după cum era de așteptat, vedem acolo că cererile între versiunea a doua și prima a serviciului recommendation sunt împărțite în proporție de 2:1, strict în funcție de numărul de pod-uri active. Această diagramă se va schimba dinamic atunci când pod-urile sunt scalate în sus sau în jos, ceea ce va fi deosebit de util în cadrul Canary Deployment (vom analiza mai detaliat această schemă de desfășurare data viitoare).
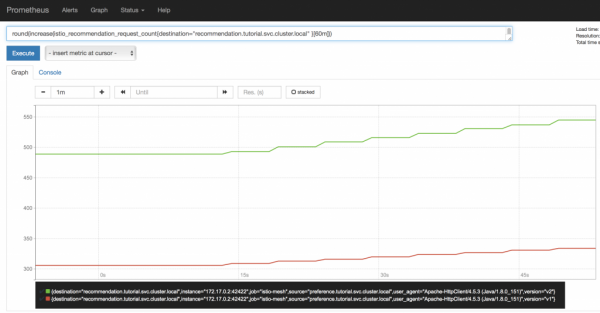
Totul abia începe
De fapt, astăzi am abordat, așa cum se spune, doar puțin din tezaurul de informații utile despre Jaeger, Grafana și Prometheus. Acesta a și fost obiectivul nostru – să vă îndrumăm în direcția corectă și să deschidem perspectivele Istio.
Și nu uitați, toate acestea sunt deja integrate în Istio. Atunci când utilizați anumite limbaje de programare (de exemplu, Java) și cadre (de exemplu, Spring Boot), toate acestea pot fi implementate fără a atinge efectiv codul aplicațiilor. Da, codul va trebui să fie ușor modificat dacă utilizați alte limbaje, având în vedere în special Nodejs sau C#. Dar deoarece trasabilitatea (citiți, „traseizarea”) este una dintre cerințele esențiale în crearea de sisteme cloud fiabile, va trebui oricum să modificați codul, indiferent dacă aveți Istio sau nu. Așadar, de ce să nu investiți efortul cu mai multă înțelepciune?
Cel puțin pentru a răspunde întotdeauna la întrebările „unde?” și „cât de repede?” cu 100% certitudine.
Ingineria haosului în Istio: așa a fost conceput
Abilitatea de a strica lucrurile ajută la asigurarea că ele nu se strică.
Testarea software-ului este nu doar complicată, ci și importantă. În același timp, testarea corectitudinii (de exemplu, dacă o funcție returnează rezultatul corect) este una, iar testarea în condiții de rețea nesigură este o cu totul altă sarcină (se presupune adesea că rețeaua funcționează întotdeauna fără erori, iar aceasta este prima dintre cele opt mituri referitoare la calculul distribuit). Una dintre dificultățile în rezolvarea acestei probleme constă în modul de a simula defecțiuni în sistem sau de a le introduce intenționat, realizând ceea ce se numește injecție de erori. Acest lucru poate fi realizat prin modificarea codului sursă al aplicației. Dar în acest caz, veți testa nu codul dumneavoastră inițial, ci o versiune special construită pentru a simula erorile. Ca rezultat, riscați să cădeți în capcanele injecției de erori și să vă confruntați cu gremlini – erori care dispar atunci când încercați să le detectați.
Acum, vă vom arăta cum vă ajută Istio să faceți față acestor dificultăți rapid și eficient.
Cum arată totul atunci când totul funcționează perfect.
Să luăm în considerare următorul scenariu: avem două poduri pentru microservicul nostru de recomandare, pe care l-am luat dintr-un ghid despre Istio. Un pod este marcat ca v1, iar celălalt ca v2. Așa cum putem observa, până acum totul funcționează perfect:
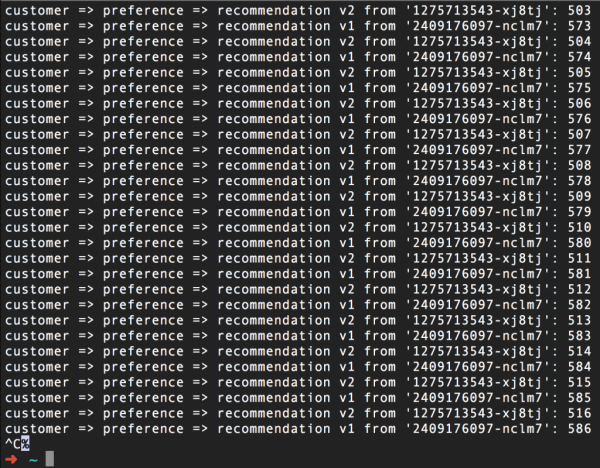
(Apropo, numărul din dreapta este pur și simplu un contor al apelurilor pentru fiecare pod)
Dar nu avem nevoie de asta, corect? Ei bine, să încercăm să distrugem totul, fără a atinge codul sursă.
Causăm întreruperi în funcționarea microserviciului
Mai jos este fișierul yaml pentru regula de rutare Istio, care va eșua (va genera eroare) în jumătate din cazuri server 503):
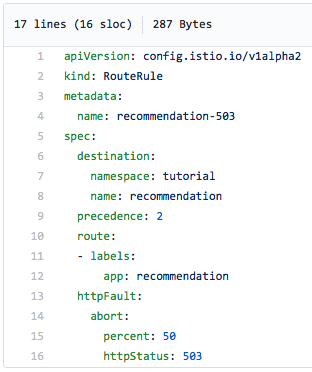
Observați, scriem clar că în jumătate din cazuri trebuie să se returneze eroarea 503.
Iată cum va arăta captura de ecran a comenzii curl rulată în buclă după ce activăm această regulă pentru a simula eșecurile. Așa cum vedem, jumătate dintre cereri returnează eroarea 503, indiferent de podul pe care le trimitem – v1 sau v2:
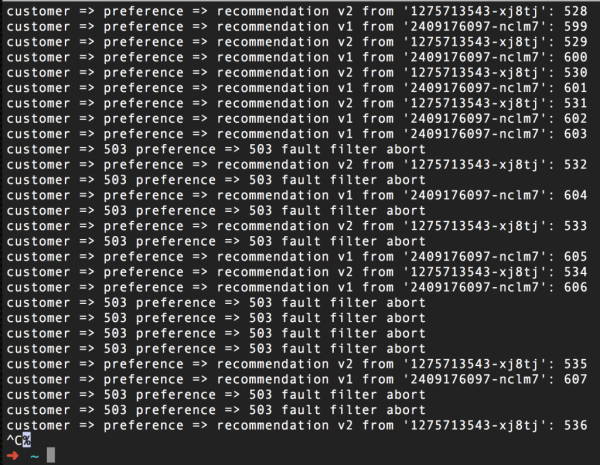
Pentru a restabili funcționalitatea normală, este suficient să ștergem această regulă, în cazul nostru folosind comanda istioctl delete routerule recommendation-503 -n tutorial. Aici Tutorial este numele proiectului Red Hat OpenShift în care rulează tutorialul nostru pentru Istio.
Introducem întârzieri artificiale
Erorile artificiale 503 ajută la testarea sistemului pentru rezistența la eșecuri, dar capacitatea de a prezice și gestiona întârzierile ar trebui să vă impresioneze și mai mult. De fapt, întârzierile în viața reală se întâmplă mai frecvent decât eșecurile. Un microserviciu care funcționează lent este un cancer care afectează întregul sistem. Datorită Istio, putem testa codul legat de gestionarea întârzierilor fără a-l modifica. La început, vă vom arăta cum să faceți acest lucru în cazul întârzierilor artificiale de rețea.
Rețineți că, după un astfel de test, s-ar putea să fie necesar (sau să doriți) să vă îmbunătățiți codul. Vestea bună este că, în acest caz, veți acționa proactiv, nu reactiv. Așa ar trebui să fie construit ciclul de dezvoltare: codare-testare-feedback-codare-testare…
Iată cum arată regula, care… De fapt, știți ce? Istio este atât de simplu, iar acest fișier yaml este atât de clar, încât totul în acest exemplu se explică de la sine, doar priviți:
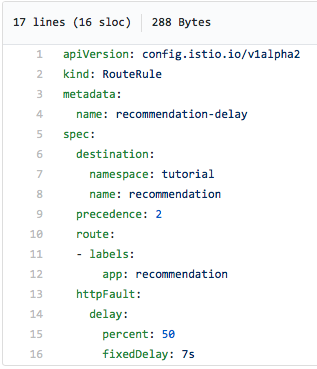
În jumătate din cazuri, vom avea o întârziere de 7 secunde. Și nu este deloc același lucru ca și cum am fi introdus în codul sursă comanda sleep, deoarece Istio efectiv întârzie cererea cu 7 secunde. Deoarece Istio suportă trimiterea de date Jaeger, această întârziere este bine observabilă în UI-ul Jaeger, așa cum se vede în captura de ecran de mai jos. Observați cererea lungă din colțul din dreapta sus al diagramei - durata acesteia este de 7.02 secunde:
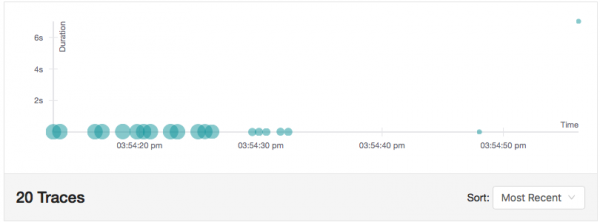
Acest scenariu permite testarea codului în condiții de întârzieri în rețea. Și este clar că, dacă eliminăm această regulă, vom elimina întârzierea artificială. Reiterăm, dar din nou am făcut totul fără a modifica codul sursă.
Nu ne dăm bătuți.
O altă funcție utilă pentru ingineria haosului în Istio este retrimiterea solicitărilor către serviciu de un număr specificat de ori. Scopul aici este de a nu renunța la încercări atunci când prima solicitare se încheie cu o eroare 503 - și de aceea, poate, la a N-a încercare am avea noroc. Poate că serviciul a fost pur și simplu inactiv pentru un timp din diverse motive. Da, această cauză ar trebui investigată și rezolvată. Dar asta mai târziu, acum să vedem cum putem face sistemul să continue să funcționeze.
Deci, vrem ca serviciul să returneze din când în când o eroare 503, iar Istio să încerce din nou să se conecteze. Și aici avem nevoie de un mod de a genera o eroare 503, fără a atinge efectiv codul...
Stop, așteptați! Tocmai am făcut asta.
Acest fișier va face ca serviciul recommendation-v2 să returneze o eroare 503 în jumătate din cazuri:
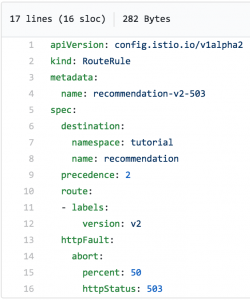
Este evident că o parte din cereri vor eșua:
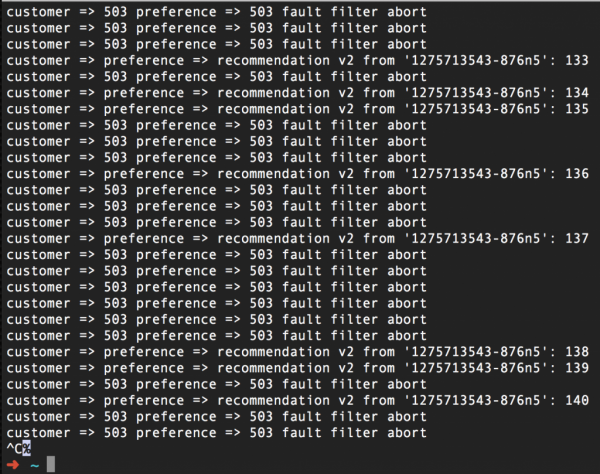
Acum să activăm funcția Retry din Istio:
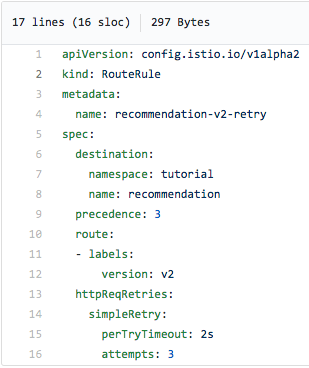
Această regulă de rutare face trei încercări la intervale de două secunde și ar trebui să reducă (iar în ideal, să elimine complet) erorile 503:
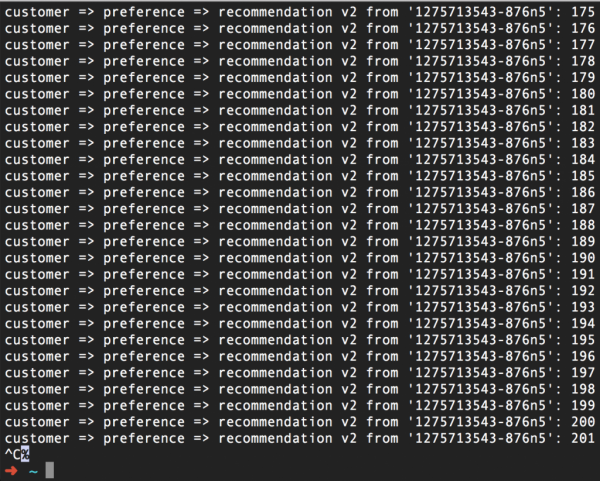
În concluzie: am făcut astfel încât Istio, pe de o parte, să genereze o eroare 503 pentru jumătate din cereri. Și, pe de altă parte, același Istio efectuează trei încercări de a se reconecta la serviciu în caz de eroare 503. Ca rezultat, totul funcționează foarte bine. Astfel, folosind funcția Retry, ne-am îndeplinit promisiunea de a nu ne da bătuți.
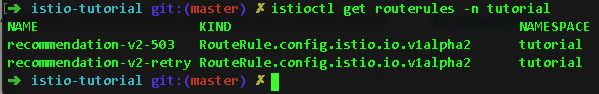
Și da, am făcut din nou acest lucru, fără a atinge codul. Tot ce am avut nevoie au fost două reguli de rutare Istio:
Cum să nu dezamăgești utilizatorul sau șapte nu așteaptă pe unul
Și acum să întoarcem situația pe dos și să analizăm scenariul în care merită să nu ne retragem și să nu ne predăm doar pentru o perioadă fixă. Apoi, trebuie pur și simplu să renunțăm la încercările de a procesa solicitarea, pentru a nu-i face pe toți să aștepte un singur serviciu care încetinește. Cu alte cuvinte, nu vom proteja o poziție pierdută, ci ne vom retrage pe o linie de rezervă, pentru a nu dezamăgi utilizatorul și a nu-l lăsa în incertitudine.
În Istio, se poate seta un timeout pentru execuția cererii. Dacă serviciul depășește acest timeout, se returnează o eroare 504 (Gateway Timeout) – din nou, totul se face prin configurația Istio. Dar va trebui să adăugăm în codul sursă al serviciului comanda sleep (și apoi, desigur, să facem rebuild și redeploy), pentru a simula o funcționare lentă a serviciului. Din păcate, altfel nu se va putea.
Așadar, am introdus un sleep de trei secunde în codul serviciului recommendation v2, am recompilat imaginea corespunzătoare și am făcut redeploy-ul containerului, iar acum adăugăm timeout-ul folosind următoarea regulă de rutare Istio:
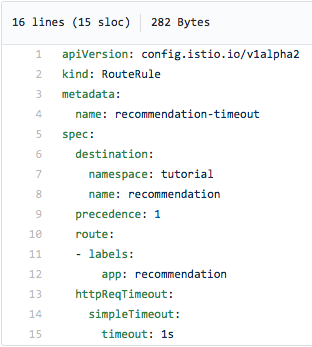
În captura de mai sus, se poate vedea că renunțăm la încercările de a ne conecta la serviciul recommendation dacă nu primim un răspuns în termen de o secundă, adică chiar înainte de a aparea eroarea 504. După aplicarea acestei reguli de rutare (și adăugarea sleep-ului de trei secunde în codul serviciului recommendation:v2), vom obține următoarele:
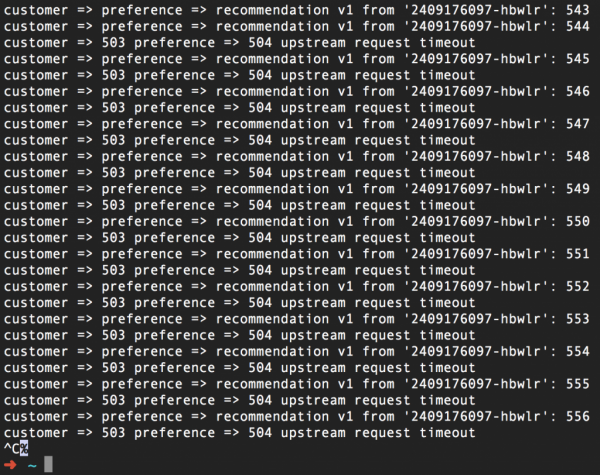
Încă o dată, spunem că timeout-ul poate fi setat fără a atinge codul sursă. Un bonus suplimentar aici este că acum puteți să vă modificați codul astfel încât să reacționeze la timeout, și să testați ușor aceste îmbunătățiri cu ajutorul Istio.
Și acum totul împreună
Introducerea unui pic de haos cu ajutorul Istio este o modalitate excelentă de a testa codul dvs. și fiabilitatea sistemului în ansamblu. Modelele fallback, bulkhead și circuit breaker, mecanismele de generare a defecțiunilor artificiale și a întârzierilor, precum și apelurile repetate și timeout-urile, vor fi extrem de utile în construirea de sisteme cloud rezistente la defecțiuni. În combinație cu Kubernetes și Red Hat OpenShift, aceste instrumente vor ajuta la pregătirea încrezătoare pentru viitor.
Sursa: habr.com
