

Aceasta este o traducere a articolului meu de pe medium — , care s-a dovedit a fi destul de popular, probabil din cauza simplității sale. Așadar, am decis să o scriu în limba română și să o completez puțin, astfel încât o persoană obișnuită, care nu este specialist în domeniul datelor, să înțeleagă ce este un depozit de date (DW), ce este un lac de date (Data Lake) și cum coexistă acestea.
De ce am vrut să scriu despre lacul de date? Lucrez cu date și analiză de peste 10 ani, iar acum lucrez cu date mari la Amazon Alexa AI în Cambridge, care este în Boston, deși locuiesc în Victoria, pe insula Vancouver, și sunt adesea în Boston, Seattle și Vancouver, iar uneori chiar și în Moscova, prezentând la conferințe. De asemenea, din când în când scriu, dar scriu în principal în engleză, și am scris deja , de asemenea, am nevoia de a împărtăși tendințele analitice din America de Nord, și uneori scriu în .
Întotdeauna am lucrat cu depozitele de date, și din 2015 am început să lucrez intens cu Amazon Web Services, și în general am trecut la analiza în cloud (AWS, Azure, GCP). Am observat evoluția soluțiilor de analiză din 2007 și chiar am lucrat pentru vendorul de depozite de date Teradata, implementându-le la Sberbank, atunci a apărut Big Data cu Hadoop. Toată lumea vorbea că era depozitelor a trecut și acum totul era pe Hadoop, iar apoi au început să vorbească despre Data Lake, spunând din nou că acum depozitul de date și-a încheiat existența. Dar, din fericire (poate pentru unii din nefericire, care câștigau mulți bani din configurarea Hadoop), depozitul de date nu a dispărut.
În acest articol vom examina ce este un lac de date. Articolul este destinat persoanelor care au puțină experiență cu depozitele de date sau poate chiar deloc.
În imagine este lacul Bled, acesta este unul dintre lacurile mele favorite, deși am fost acolo doar o dată, dar l-am ținut minte toată viața. Dar vom vorbi despre un alt tip de lac — lacul de date. Probabil mulți dintre voi ați auzit deja acest termen, dar o altă definiție nu strică.
În primul rând, iată cele mai populare definiții ale Lacului de Date:
„un sistem de stocare a tuturor tipurilor de date brute, care sunt disponibile pentru analiză de către oricine din organizație” — Martin Fowler.
«Dacă credeți că un lac de date este o sticlă de apă — purificată, ambalată și porționată pentru un consum convenabil, atunci lacul de date este un rezervor imens cu apă în forma sa naturală. Utilizatorii pot umple apă pentru ei înșiși, pot să sape la adâncime, să exploreze» — James Dickson.
Acum știm exact că lacul de date se referă la analitică, el ne permite să stocăm volume mari de date în forma lor inițială și avem accesul necesar și convenabil la date.
Îmi place adesea să simplific lucrurile, dacă pot să explic un termen complex în cuvinte simple, înseamnă că am înțeles cum funcționează și pentru ce este nevoie. Ca atunci când am fost pe iPhone în galeria foto și mi-a venit ideea, e ca un lac de date real, am creat chiar un slide pentru conferințe:
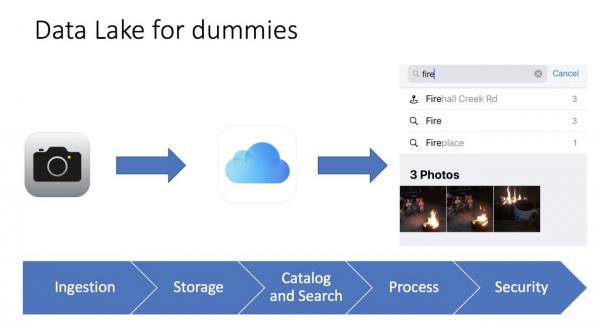
Totul este foarte simplu. Facem o fotografie cu telefonul, fotografia este salvată pe telefon și poate fi salvată în iCloud (stocare de fișiere în cloud). De asemenea, telefonul colectează meta-date despre fotografie: ce este reprezentat, geoeticheta, ora. Ca rezultat, putem folosi interfața convenabilă a iPhone-ului pentru a găsi fotografia noastră și în plus, vedem indicatori, de exemplu, când caut fotografii cu cuvântul foc (fire), găsesc 3 fotografii cu imaginea unui foc de tabără. Pentru mine, este ca un instrument de Business Intelligence, care funcționează foarte repede și precis.
Și, desigur, nu putem uita de securitate (autorizare și autentificare), altfel datele noastre ar putea ajunge cu ușurință în acces deschis. Există foarte multe știri despre mari corporații și startup-uri ale căror date au ajuns în acces deschis din cauza neglijenței dezvoltatorilor și neaplicarea unor reguli simple.
Chiar și o imagine simplă ne ajută să înțelegem ce este un lac de date, diferențele sale față de un depozit de date tradițional și principalele sale elemente:
- Încărcarea datelor (Ingestion) — componenta cheie a lacului de date. Datele pot ajunge în depozitul de date în două moduri — batch (încărcare cu intervale) și streaming (flux de date).
- Stocare de fișiere (Storage) — componenta principală a Lacului de Date. Este necesar ca depozitul să fie ușor scalabil, extrem de fiabil și să aibă un cost scăzut. De exemplu, în AWS este S3.
- Catalog și Căutare (Catalog and Search) — pentru a evita Mlaștina de Date (atunci când înghesuim toate datele într-un singur loc și apoi devine imposibil să lucrăm cu ele), trebuie să creăm un strat de metadate pentru clasificarea datelor, astfel încât utilizatorii să poată găsi ușor informațiile necesare pentru analiză. În plus, se pot utiliza soluții suplimentare pentru căutare, cum ar fi ElasticSearch. Căutarea ajută utilizatorul să găsească datele necesare printr-o interfață prietenoasă.
- Prelucrare (Process) — acest pas răspunde de prelucrarea și transformarea datelor. Putem transforma datele, modifica structurile acestora, curăța și multe altele.
- Securitate (Security) — este important să alocăm timp pentru designul soluției de securitate. De exemplu, criptarea datelor în timpul stocării, prelucrării și încărcării. Este important să folosim metode de autentificare și autorizare. În concluzie, este nevoie de un instrument de audit.
Din punct de vedere practic, putem caracteriza lacul de date prin trei atribute:
- Colectați și stocați orice. — lacul de date conține toate informațiile, atât date brute și neprelucrate pe orice perioadă de timp, cât și date prelucrate/curățate.
- Analiză profundă — lacul de date permite utilizatorilor să exploreze și să analizeze datele.
- Acces flexibil — lacul de date oferă un acces flexibil pentru diverse tipuri de date și pentru diferite scenarii.
Acum putem discuta despre diferența dintre un depozit de date și un lac de date. De obicei, oamenii întreabă:
- Dar ce face depozitul de date?
- Înlocuim depozitul de date cu lacul de date sau îl extindem?
- Putem totuși să ne descurcăm fără lacul de date?
În scurt, nu există un răspuns clar. Totul depinde de situația concretă, abilitățile din echipă și buget. De exemplu, migrarea unui depozit de date pe Oracle în AWS și crearea unui lac de date de către filiala Amazon — Woot — .
Pe de altă parte, furnizorul Snowflake afirmă că nu mai trebuie să te gândești la lacul de date, deoarece platforma lor de date (până în 2020 era depozit de date) îți permite să combini atât lacul de date, cât și depozitul de date. Am lucrat puțin cu Snowflake, și este într-adevăr un produs unic care poate face asta. Prețul este o altă problemă.
În concluzie, opinia mea personală este că avem în continuare nevoie de un depozit de date ca sursă principală pentru raportarea noastră, iar tot ce nu se încadrează este păstrat în lacul de date. Toată rolul analiticii este de a oferi acces ușor afacerii pentru luarea deciziilor. Indiferent cum ar fi, utilizatorii de business lucrează mai eficient cu un depozit de date decât cu un lac de date; de exemplu, în Amazon există Redshift (depozit de date analitic) și există Redshift Spectrum/Athena (interfața SQL pentru lacul de date din S3 bazat pe Hive/Presto). Aceleași lucruri se aplică și altor depozite de date analitice moderne.
Să analizăm arhitectura tipică a unui depozit de date:
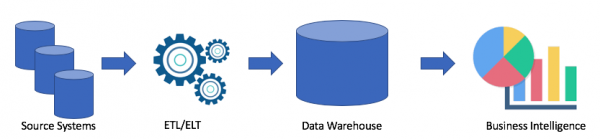
Aceasta este o soluție clasică. Avem surse de date, iar prin ETL/ELT copiem datele în depozitul de date analitic și le conectăm la soluția de Business Intelligence (preferata mea este Tableau, dar care este a ta?).
Această soluție are următoarele dezavantaje:
- Operațiile ETL/ELT necesită timp și resurse.
- În general, memoria pentru stocarea datelor în depozitul de date analitic nu este ieftină (de exemplu, Redshift, BigQuery, Teradata), deoarece trebuie să achiziționăm un întreg cluster.
- Utilizatorii de business au acces la datele curate și adesea agregate și nu au posibilitatea de a obține date brute.
Desigur, totul depinde de cazul dumneavoastră. Dacă nu aveți probleme cu depozitul de date, atunci nu aveți nevoie de un lac de date. Dar când apar probleme cu lipsa de spațiu, putere sau costul devine un factor cheie, atunci se poate lua în considerare opțiunea unui lac de date. De aceea, lacul de date este foarte popular. Iată un exemplu de arhitectură a lacului de date:
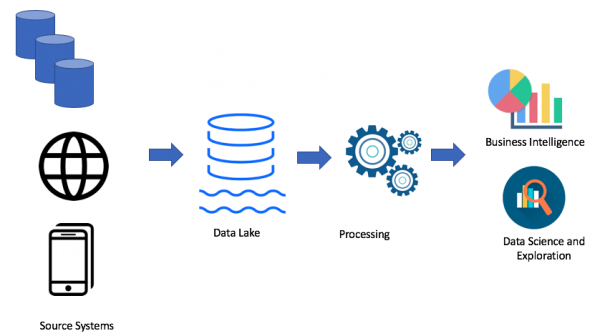
Folosind abordarea lacului de date, încărcăm datele brute în lacul nostru de date (batch sau streaming), apoi procesăm datele după necesitate. Lacul de date permite utilizatorilor de business să își creeze propriile transformări de date (ETL/ELT) sau să analizeze datele în soluțiile de Business Intelligence (dacă există driverul necesar).
Scopul oricărei soluții analitice este de a servi utilizatorilor de business. Prin urmare, trebuie întotdeauna să lucrăm în funcție de cerințele afacerii. (La Amazon, acesta este unul dintre principiile — working backwards).
Lucrând atât cu depozitul de date, cât și cu lacul de date, putem compara cele două soluții:
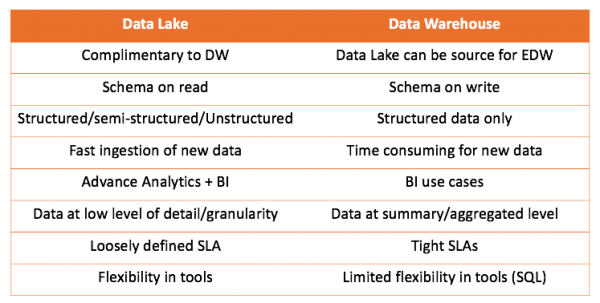
Concluzia principală este că stocarea datelor nu concurează în niciun fel cu lacul de date, ci mai degrabă îl completează. Dar este decizia dumneavoastră să determinați ce se potrivește cel mai bine în cazul dumneavoastră. Întotdeauna este interesant să încercați personal și să trasați concluzii corecte.
Aș dori, de asemenea, să vorbesc despre unul dintre cazurile în care am început să folosesc abordarea lacului de date. Totul este destul de banal, am încercat să folosesc un instrument ELT (avem Matillion ETL) și Amazon Redshift, soluția mea a funcționat, dar nu se încadra în cerințe.
A trebuit să iau jurnalele web, să le transform și să le agreg, pentru a oferi date pentru două cazuri:
- Echipa de marketing dorea să analizeze activitatea roboților pentru SEO
- IT-ul dorea să urmărească metricile de funcționare ale site-urilor
Foarte simple, niște jurnale foarte simple. Iată un exemplu:
https 2018-07-02T22:23:00.186641Z app/my-loadbalancer/50dc6c495c0c9188
192.168.131.39:2817 10.0.0.1:80 0.086 0.048 0.037 200 200 0 57
"GET https://www.example.com:443/ HTTP/1.1" "curl/7.46.0" ECDHE-RSA-AES128-GCM-SHA256 TLSv1.2
arn:aws:elasticloadbalancing:us-east-2:123456789012:targetgroup/my-targets/73e2d6bc24d8a067
"Root=1-58337281-1d84f3d73c47ec4e58577259" "www.example.com" "arn:aws:acm:us-east-2:123456789012:certificate/12345678-1234-1234-1234-123456789012"
1 2018-07-02T22:22:48.364000Z "authenticate,forward" "-" "-"
Un fișier cântărea între 1-4 megabytes.
Dar a fost o dificultate. Aveam 7 domenii în întreaga lume și, într-o zi, se creau 7000 de fișiere. Acesta nu este un volum foarte mare, în total 50 de gigabytes. Dar dimensiunea cluster-ului nostru Redshift era, de asemenea, mică (4 noduri). Încărcarea tradițională a unui fișier dura aproximativ un minut. Așadar, problema nu se rezolva direct. Și aceasta a fost ocazia când am decis să folosesc abordarea lacului de date. Soluția arăta aproximativ așa:
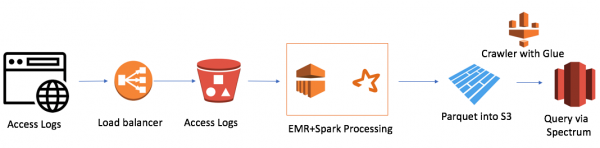
Este destul de simplă (vreau să subliniez că avantajul lucrului în cloud este simplitatea). Am folosit:
- AWS Elastic Map Reduce (Hadoop) ca putere de calcul
- AWS S3 ca stocare de fișiere cu posibilitatea de criptare a datelor și restricționarea accesului
- Spark ca putere de calcul InMemory și PySpark pentru logică și transformarea datelor
- Parquet ca rezultat al muncii Spark
- AWS Glue Crawler ca colector de metadate despre noile date și partiții
- Redshift Spectrum ca interfață SQL pentru lacul de date pentru utilizatorii existenți Redshift
Cel mai mic cluster EMR+Spark a procesat întreaga serie de fișiere în 30 de minute. Există și alte cazuri pentru AWS, în special multe legate de Alexa, unde există o cantitate foarte mare de date.
Recent am aflat un dezavantaj al lacului de date - acesta este GDPR. Problema este că, atunci când clientul cere ștergerea acestuia, iar datele se află într-unul dintre fișiere, nu putem folosi Data Manipulation Language și operația DELETE ca în baza de date.
Sper că articolul a clarificat diferența dintre un depozit de date și un lac de date. Dacă ți-a fost interesant, pot traduce și alte articole de-ale mele sau articolele unor profesioniști pe care îi citesc. De asemenea, pot vorbi despre soluțiile cu care lucrez și arhitectura acestora.
Sursa: habr.com
