

Pentru o stăpânire completă a Kubernetes, este necesar să cunoaștem diverse metode de scalare a resurselor clusterului: după , aceasta este una dintre principalele sarcini ale Kubernetes. Am pregătit un rezumat la nivel înalt al mecanismelor de autoscalare orizontală și verticală și al redimensionării clusterelor, precum și recomandări despre cum să le utilizăm eficient.
Articolul a fost tradus de echipa care a implementat autoscalarea în .
De ce este important să ne gândim la scalare
— un instrument pentru gestionarea resurselor și orchestrare. Desigur, este bine să experimentăm cu funcțiile interesante de implementare, monitorizare și gestionare a pod-urilor (modulul pod — un grup de containere care sunt lansate ca răspuns la o cerere).
Cu toate acestea, trebuie să ne gândim și la următoarele întrebări:
- Cum se scalazează modulele și aplicațiile?
- Cum se mențin containerele în stare operativă și eficientă?
- Cum se răspunde la schimbările constante din cod și la sarcinile de lucru ale utilizatorilor?
Configurarea clusterelor Kubernetes pentru echilibrarea resurselor și a performanței poate fi o sarcină complexă, necesitând cunoștințe experte despre funcționarea internă a Kubernetes. Sarcina de lucru a aplicației sau serviciilor dumneavoastră poate fluctua pe parcursul zilei sau chiar într-o singură oră, așa că echilibrarea ar trebui considerată un proces continuu.
Nivelurile de autoscalare Kubernetes
Autoscalarea eficientă necesită coordonare între două niveluri:
- Nivelul pod-urilor, care include autoscalarea orizontală (Horizontal Pod Autoscaler, HPA) și autoscalarea verticală (Vertical Pod Autoscaler, VPA). Aceasta se referă la scalarea resurselor existente pentru containerele dumneavoastră.
- Nivelul clusterului, gestionat de sistemul de autoscalare a clusterului (Cluster Autoscaler, CA), care crește sau scade numărul de noduri din interiorul clusterului.
Modulul de autoscalare orizontală (HPA)
Așa cum sugerează numele, HPA scalazează numărul de replici ale pod-urilor. Ca trigger pentru schimbarea numărului de replici, majoritatea devops-ilor folosesc sarcina CPU și memoria. Cu toate acestea, sistemul poate fi scalat pe baza , combinația lor sau chiar .
Schema de funcționare de nivel înalt HPA:
- HPA verifică în mod constant valorile metricale specificate la instalare, cu un interval implicit de 30 de secunde.
- HPA încearcă să crească numărul de module dacă pragul specificat este atins.
- HPA actualizează numărul de replici în cadrul controlerului de desfășurare/relicare.
- Controlerul de desfășurare/relicare desfășoară apoi toate modulele suplimentare necesare.
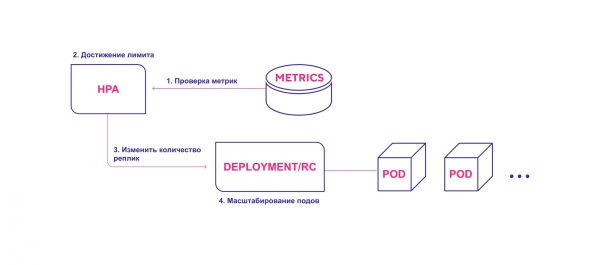
HPA inițiază procesul de desfășurare a modulelor când se atinge valoarea prag.
Când folosiți HPA, luați în considerare următoarele:
- Intervalul de verificare implicit al HPA este de 30 de secunde. Acesta se stabilește printr-un flag. horizontal-pod-autoscaler-sync-period în managerul de controlere.
- Precizia relativă implicită este de 10%.
- După ultima creștere a numărului de module, HPA așteaptă stabilizarea metricelor timp de trei minute. Acest interval se stabilește printr-un flag. horizontal-pod-autoscaler-upscale-delay.
- După ultima scădere a numărului de module, HPA așteaptă stabilizarea timp de cinci minute. Acest interval se stabilește printr-un flag. horizontal-pod-autoscaler-downscale-delay.
- HPA funcționează cel mai bine cu obiecte de desfășurare, nu cu controlere de replicare. Scalarea automată orizontală nu este compatibilă cu actualizarea secvențială (rolling update), care manipulează direct controlerele de replicare. La desfășurare, numărul de replici depinde direct de obiectele de desfășurare.
Scalarea verticală a pod-urilor
Scalarea verticală (VPA) alocă mai mult (sau mai puțin) timp de procesare sau memorie pentru pod-urile existente. Se potrivește pentru pod-uri cu stocare de stare (stateful) sau fără (stateless), dar este în principal destinată serviciilor stateful. Totuși, puteți aplica VPA și pentru module fără stocare de stare, dacă este nevoie să ajustați automat volumul resurselor inițial alocate.
VPA răspunde, de asemenea, la evenimente OOM (out of memory, fără memorie). Pentru a modifica timpul de procesare și volumul de memorie, este necesar să se repornească pod-urile. La repornire, VPA respectă bugetul de distribuție (), pentru a garanta numărul minim necesar de module.
Puteți stabili o capacitate minimă și maximă de resurse pentru fiecare modul. Astfel, puteți limita capacitatea maximă de memorie alocată la 8 GB. Acest lucru este util, dacă nodurile actuale nu pot aloca mai mult de 8 GB de memorie pe container. Specificații detaliate și mecanismul de funcționare sunt descrise în .
În plus, VPA dispune de o funcție interesantă de recomandări (VPA Recommender). Aceasta urmărește utilizarea resurselor și evenimentele OOM ale tuturor modulelor, pentru a sugera noi valori pentru memorie și timp de procesare, bazându-se pe un algoritm inteligent care ia în considerare metricile istorice. De asemenea, există o interfață API care primește descriptorul pod-ului și returnează valorile de resurse recomandate.
Este important de menționat că VPA Recommender nu urmărește "limita" resurselor. Acest lucru poate duce la monopolizarea resurselor de către un modul în interiorul nodurilor. Este mai bine să stabiliți o limită la nivel de spațiu de nume pentru a evita un consum excesiv de memorie sau timp de procesare.
Schema de funcționare la un nivel înalt a VPA:
- VPA verifică continuu valorile metricilor specificate la instalare, cu un interval implicit de 10 secunde.
- Dacă se atinge pragul stabilit, VPA încearcă să modifice cantitatea de resurse alocate.
- VPA actualizează cantitatea de resurse în cadrul controller-ului de implementare/replicare.
- La repornirea modulelor, toate noile resurse se aplică instanțelor create.
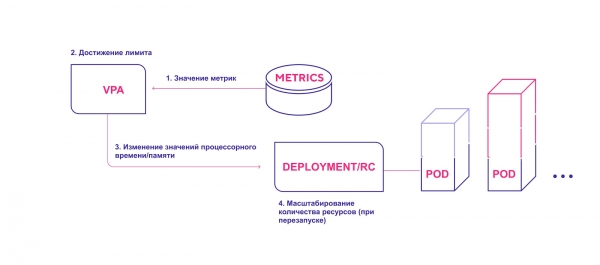
VPA adaugă cantitatea necesară de resurse
Țineți cont de următoarele aspecte atunci când utilizați VPA:
- Scalarea necesită repornirea obligatorie a pod-ului. Acest lucru este necesar pentru a evita funcționarea instabilă după efectuarea modificărilor. Pentru fiabilitate, modulele sunt repornite și distribuite pe noduri pe baza noilor resurse alocate.
- VPA și HPA nu sunt compatibile între ele și nu pot funcționa pe aceleași pod-uri. Dacă aplicați ambele mecanisme de scalare într-un singur cluster, asigurați-vă că setările nu le permit activarea pe aceleași obiecte.
- VPA configurează cererile containerelor pentru resurse, bazându-se doar pe utilizarea lor anterioară și actuală. Nu stabilesc limite de utilizare a resurselor. Pot apărea probleme cu funcționarea incorectă a aplicațiilor care vor începe să consume tot mai multe resurse, ceea ce va duce la deconectarea acestui pod de către Kubernetes.
- VPA este încă într-o etapă timpurie de dezvoltare. Fiți pregătiți că în curând sistemul poate suferi unele modificări. Puteți citi despre și . Astfel, planurile includ implementarea colaborării între VPA și HPA, precum și desfășurarea modulelor împreună cu politicile de scalare verticală automată pentru acestea (de exemplu, o etichetă specială 'requires VPA').
Scalarea automată a clusterului Kubernetes
Scalarea automată a clusterului (Cluster Autoscaler, CA) modifică numărul de noduri în funcție de numărul de module pod în așteptare. Sistemul verifică periodic existența modulelor în așteptare și crește dimensiunea clusterului dacă sunt necesare mai multe resurse și dacă clusterul respectă limitele stabilite. CA interacționează cu furnizorul de servicii cloud, solicitând noduri suplimentare sau eliberându-le pe cele inactive. Prima versiune publică a CA a fost lansată în Kubernetes 1.8.
Schema de funcționare la nivel înalt a CA:
- CA verifică existența modulelor în stare de așteptare la un interval implicit de 10 secunde.
- Dacă unul sau mai multe module sunt în așteptare deoarece nu sunt suficiente resurse disponibile în cluster pentru a le aloca, încearcă să pregătească unul sau mai multe noduri suplimentare.
- Când furnizorul de servicii cloud alocă nodul necesar, acesta se alătură clusterului și este gata să servească modulele pod.
- Planificatorul Kubernetes alocă modulele în așteptare pe un nou nod. Dacă după aceasta unele module rămân în continuare în așteptare, procesul se repetă - iar noduri noi sunt adăugate în cluster.
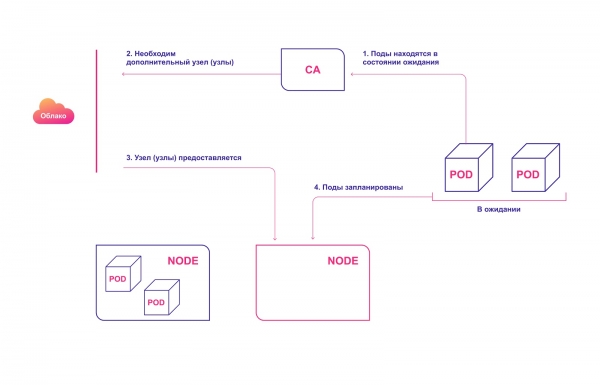
Alocarea automată a nodurilor în cluster în cloud
Luați în considerare următoarele atunci când utilizați CA:
- CA garantează că toate modulele din cluster au loc pentru a rula, indiferent de nivelul de încărcare a procesorului. În plus, acesta încearcă să garanteze că în cluster nu există noduri inutile.
- CA înregistrează necesitatea de scalare la aproximativ 30 de secunde.
- După ce un nod devine inutil, CA așteaptă în mod implicit 10 minute înainte de a scala sistemul.
- În sistemul de autoscalare există conceptul de extensori (expanders). Acestea sunt diferite strategii pentru a alege grupul de noduri în care vor fi adăugate noi.
- Aplicați în mod responsabil opțiunea cluster-autoscaler.kubernetes.io/safe-to-evict (true). Dacă sunt setate multe pod-uri sau dacă multe dintre ele sunt dispersate pe toate nodurile, veți pierde semnificativ capacitatea de a reduce dimensiunea cluster-ului.
- Windows VPS pentru lucru la distanță , pentru a preveni eliminarea pod-urilor, ceea ce ar putea duce la oprirea completă a unei părți a aplicației dvs.
Cum interacționează sistemele de autoscalare Kubernetes între ele
Pentru o armonie ideală, ar trebui aplicat autoscalarea atât la nivelul pod-urilor (HPA/VPA), cât și la nivelul cluster-ului. Acestea interacționează relativ ușor între ele:
- HPA sau VPA actualizează replicile pod-urilor sau resursele alocate pentru pod-urile existente.
- Dacă nu sunt suficiente noduri pentru scalarea planificată, CA observă existența pod-urilor în stare de așteptare.
- CA alocă noduri noi.
- Modulele sunt distribuite pe noduri noi.
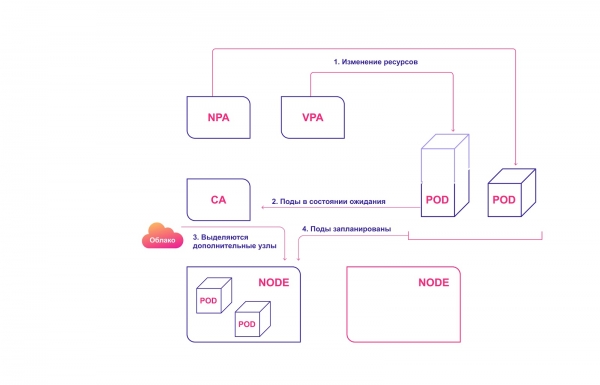
Un sistem comun de scale în sistemele Kubernetes
Erori tipice în autoscalarea Kubernetes
Există câteva probleme tipice cu care se confruntă DevOps atunci când încearcă să aplice autoscalarea.
HPA și VPA depind de metrici și de anumite date istorice. Dacă resursele alocate sunt insuficiente, modulele vor fi restrânse și nu vor putea genera metrici. În acest caz, autoscalarea nu va avea loc niciodată.
Însăși operațiunea de scalare este sensibilă la timp. Dorim ca modulele și cluster-ul să se scaleze rapid — înainte ca utilizatorii să observați vreo problemă sau defecțiune. Prin urmare, ar trebui să luați în considerare timpul mediu de scalare a pod-urilor și a cluster-ului.
Scenariul ideal — 4 minute:
- 30 de secunde. Actualizarea metricilor țintă: 30-60 de secunde.
- 30 de secunde. HPA verifică valorile metricilor: 30 de secunde.
- Mai puțin de 2 secunde. Modulele pod sunt create și trec în stare de așteptare: 1 secundă.
- Mai puțin de 2 secunde. CA vede modulele în așteptare și trimite apeluri pentru pregătirea nodurilor: 1 secundă.
- 3 minute. Providerul de cloud alocă noduri. K8s așteaptă până când acestea sunt gata: până la 10 minute (depinde de mai mulți factori).
Cel mai rău (mai realist) scenariu — 12 minute:
- 30 de secunde. Actualizarea metricilor țintă.
- 30 de secunde. HPA verifică valorile metricalor.
- Mai puțin de 2 secunde. Modulele pod sunt create și trec în stare de așteptare.
- Mai puțin de 2 secunde. CA vede modulele în așteptare și trimite solicitări pentru pregătirea nodurilor.
- 10 minute. Providerul de cloud alocă noduri. K8s așteaptă până când acestea sunt gata. Timpul de așteptare depinde de mai mulți factori, cum ar fi întârzierea providerului, întârzierea OS, activitatea instrumentelor auxiliare.
Nu confundați mecanismele de scalare ale providerilor de cloud cu CA noastră. Aceasta din urmă funcționează în cadrul clusterului Kubernetes, în timp ce mecanismul providerului de cloud funcționează pe baza distribuirii nodurilor. Acesta nu știe ce se întâmplă cu podurile sau aplicația dumneavoastră. Aceste sisteme funcționează în paralel.
Cum să gestionați scalarea în Kubernetes
- Kubernetes este un instrument de gestionare a resurselor și orchestrare. Operațiunile de gestionare a podurilor și resurselor clusterului sunt puncte cheie în stăpânirea Kubernetes.
- Învățați logica scalabilității podurilor cu HPA și VPA.
- CA ar trebui folosit doar dacă înțelegeți bine nevoile podurilor și containerelor dumneavoastră.
- Pentru o configurare optimă a clusterului, trebuie să înțelegeți cum funcționează împreună diferitele sisteme de scalare.
- Atunci când evaluați timpul de scalare, aveți în vedere cele mai rele și cele mai bune scenarii.
Sursa: habr.com
