

Pe baza discuțiilor din chat
În ultima vreme se desfășoară adevărate bătălii în ceea ce privește definirea conceptului de DevOps și SRE.
Cu toate că discuțiile pe această temă au devenit oarecum obositoare, inclusiv pentru mine, am decis să îmi expun perspectiva în fața comunității Habr. Cei interesați sunt bineveniți sub cat. Și să înceapă totul din nou!
Povestea
Așadar, în vremurile de demult, existau echipe separate de dezvoltatori de software și administratori de servere. Primii scriau cod fără probleme, iar ceilalți, folosind diverse cuvinte calde și blânde despre primii, configurau serverele, venind periodic la dezvoltatori și primind în schimb un răspuns lămuritor: „La mine pe mașină funcționează tot.” Afacerea a așteptat software-ul, totul stagna, se defecta periodic, iar toată lumea era nervoasă. În special cel care plătea pentru toată această dezordine. O epocă splendidă. Dar, probabil, știți deja de unde vine conceptul de DevOps.
Nașterea practicilor DevOps
Apoi, au venit niște oameni serioși și au spus - aceasta nu este o industrie, așa nu se poate lucra. Și au adus modele de ciclu de viață. Iată, de exemplu, modelul în V.
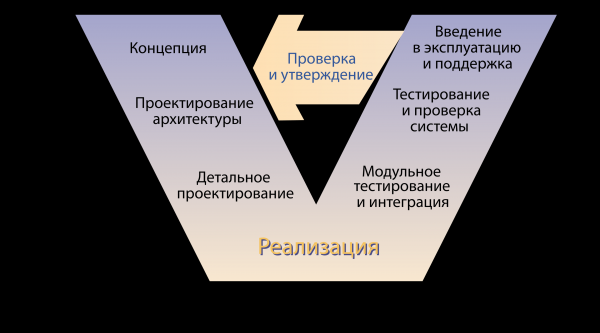
Așadar, ce vedem? Afacerea vine cu o idee, arhitecții concep soluții, dezvoltatorii scriu cod, apoi – un eșec. Cineva cumva testează produsul, cineva cumva îl livrează utilizatorului final și undeva, la ieșirea acestui model miraculos, stă un client de afaceri singuratic așteptând vremea bună. S-a ajuns la concluzia că sunt necesare metode care să permită îmbunătățirea acestui proces. Și s-a decis să se creeze practici care să le implementeze.
O digresiune lirică cu privire la ce este practica
Prin practică, eu înțeleg o legătură între tehnologie și disciplină. Un exemplu - practica descrierii infrastructurii prin cod pe terraform. Disciplina este modul în care descriem infrastructura prin cod, aceasta se află în mintea dezvoltatorului, iar tehnologia este, de fapt, terraform.
Și au decis să le numească practici DevOps — cred că se refereau la tranziția de la dezvoltare la operațiuni. Au inventat tot felul de lucruri complicate — practici CI/CD, practici bazate pe principiul IaC, mii de astfel de abordări. Și au început să scrie cod, inginerii DevOps transformând descrierea sistemului în cod în sisteme funcționale (da, din păcate, codul este doar o descriere, nu o manifestare a sistemului), livrarea a început să se desfășoare, și așa mai departe. Administratorii de ieri, după ce au învățat noile practici, s-au recalificat cu mândrie în ingineri DevOps, și totul a început. Și a fost seară, și a fost dimineață... scuze, nu de acolo.
Toate din nou, nu-i așa?
Doar ce s-a liniștit totul, și diversi "metodiști" au început să scrie cărți groase despre practicile DevOps, disputele au început să se dezvolte în liniște, cine este de fapt binecunoscuta persoană DevOps și că DevOps este o cultură a producției, nemulțumirea a reapărut. A devenit evident că livrarea software-ului este o sarcină absolut netreviată. Fiecare infrastructură de dezvoltare are propriul ei stack, unele trebuie să fie compilate, altele trebuie să aibă un mediu livrat, aici este nevoie de tomcat, iar aici de o metodă complicată de lansare — în general, capul îți explodează. Și din păcate, problema s-a dovedit a fi, în primul rând, organizarea proceselor — această funcție de livrare a început să blocheze procesele, ca un gât de sticlă. În plus, operațiunile (Operations) nu au fost anulate. Ele nu sunt vizibile în modelul V, iar acolo este întreg ciclul de viață pe dreapta. În cele din urmă, trebuie să menții infrastructura, să te uiți la monitorizare, să rezolvi incidentele și să te ocupi și de livrare. Adică, să stai cu o picior în dezvoltare și cu celălalt în operațiuni — și astfel a apărut această combinație de Development & Operations. Apoi, a venit și un val uriaș de hype pe microservicii. Iar cu ele, dezvoltarea a început să semute în cloud — încearcă să depanezi ceva local, când ai zeci sau sute de microservicii, livrarea continuă devine un mijloc de supraviețuire. Pentru o „mică companie modestă” mai merge, dar totuși? Dar Google?
SRE de la Google
Google a venit, a mâncat cei mai mari cactuși și a zis - nu avem nevoie de așa ceva, ne trebuie fiabilitate. Și trebuie să gestionăm această fiabilitate. A decis că avem nevoie de specialiști care să se ocupe de gestionarea fiabilității. I-a numit ingineri SR și a spus, iată totul, faceți cum știți, bine. Iată SLI, iată SLO, iată monitorizarea. Și a arătat către operațiuni. Și și-a numit „DevOps-ul fiabil” SRE. Totul părea bine, dar există un hack murdar pe care Google și-l putea permite - la poziția de ingineri SR angajau oameni cu calificări de dezvoltatori și care aveau puțină experiență în funcționarea sistemelor în activitate. În plus, Google avea probleme cu angajarea acestor oameni - în principal pentru că el însuși concură cu sine - trebuie totuși să descrie cineva logica de afaceri. Livrarea a fost delegată inginerilor de release, inginerii SR gestionează fiabilitatea (desigur, nu direct, ci influențând infrastructura, schimbând arhitectura, urmărind modificările și indicatorii, rezolvând incidentele). E frumos, se poate . Și ce să faci dacă nu ești Google, dar fiabilitatea totuși te îngrijorează?
Dezvoltarea ideilor DevOps
Aici a venit la momentul potrivit Docker, crescut din lxc, apoi diferite sisteme de orchestrare, precum Docker Swarm și Kubernetes, iar inginerii DevOps au respirat ușurați - unificarea practicilor a simplificat livrarea. A simplificat atât de mult încât a devenit chiar posibil să predăm livrarea dezvoltatorilor - ce este acel deployment.yaml. Containerele rezolvă problema. Iar maturitatea sistemelor CI/CD este deja la nivelul în care ai scris un singur fișier și totul a început - dezvoltatorii se descurcă singuri. Și aici începem să discutăm cum să ne facem propriul SRE, cu... oricine.
SRE nu este în Google
Bine, am finalizat livrarea, cred că putem respira ușurați și reveni la vremurile bune de altădată, când administratorii urmăreau încărcarea procesoarelor, optimizau sistemele și sorbeau din căni ceva misterios în liniște și calm... Stai puțin. Nu asta era intenția noastră (ar fi fost păcat!). Dintr-o dată, se dovedește că, în abordarea Google, putem aplica practici excelente — nu încărcarea procesoarelor este importantă, nu cât de des schimbăm discurile, sau cum optimizăm costurile în cloud, ci metricile de afaceri — aceleași binecunoscute SLx. Și nimeni nu a scos managementul infrastructurii de aici, trebuie să gestionăm incidentele, trebuie să fim de serviciu periodic și, în general, să fim la curent cu procesele de afaceri. Și, băieți, începeți să programați puțin mai bine, Google v-așteaptă deja.
În rezumat. Dintr-o dată, dar deja sunteți obosiți să citiți și sunteți nerăbdători să-i scrieți autorului un comentariu la articol. DevOps ca practică de livrare a fost, este și va fi. Și nu va dispărea nicăieri. SRE ca set de practici de operare face ca această livrare să fie de succes.
Sursa: habr.com
