

Periodic apare sarcina de a căuta date corelate după un set de chei, până nu vom acumula numărul dorit de înregistrări.
Cel mai „viețuit” exemplu – a afișa 20 cele mai vechi sarcini, aflate pe lista angajaților (de exemplu, în cadrul aceleași subdiviziuni). Pentru diferite „dashboarduri” de management cu sinteze scurte asupra domeniilor de activitate, o temă similară este necesară destul de frecvent.
În articol vom analiza implementarea pe PostgreSQL a unei variante „naive” de soluționare a unei astfel de sarcini, o variantă „mai inteligentă” și un algoritm complet complex al unui „ciclu” în SQL cu condiția de ieșire din datele găsite, care poate fi util atât pentru dezvoltare generală, cât și pentru aplicarea în alte cazuri similare.
Să luăm un set de date de test din . Pentru ca înregistrările afișate să nu „sară” de la o dată la alta în caz de coincidență a valorilor sortate, vom extinde indexul tematic prin adăugarea unei chei primare. Acest lucru îi va oferi imediat unicitate și va garanta ordinea clară de sortare:
CREATE INDEX ON task(owner_id, task_date, id);
-- iar cel vechi - îl eliminăm
DROP INDEX task_owner_id_task_date_idx;
Cum se aude, așa se scrie
Mai întâi vom schița cea mai simplă variantă a interogării, transmițând ID-urile executanților :
SELECT
  *
FROM
  task
WHERE
  owner_id = ANY('{1,2,4,8,16,32,64,128,256,512}'::integer[])
ORDER BY
  task_date, id
LIMIT 20; 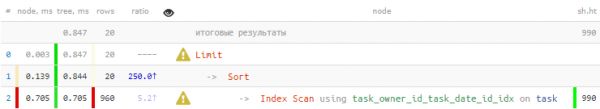
Puțin trist – am cerut doar 20 de înregistrări, iar Index Scan ne-a returnat 960 rânduri, care apoi a trebuit să fie încă sortate... Hai să încercăm să citim mai puțin.
unnest + ARRAY
Prima idee care ne va ajuta – dacă avem nevoie de doar 20 de înregistrări sortate, este suficient să citim nu mai mult de 20 de înregistrări sortate în aceeași ordine pentru fiecare cheie. Din fericire, indexul potrivit (owner_id, task_date, id) îl avem. Vom folosi același mecanism de extragere și „transformare în coloane”
a înregistrării întregi a tabelului , la fel ca în. De asemenea, vom aplica compunerea într-un array cu ajutorul funcției ARRAY() WITH T AS ( SELECT unnest(ARRAY( SELECT t FROM task t WHERE owner_id = unnest ORDER BY task_date, id LIMIT 20 -- limităm aici... )) r FROM unnest('{1,2,4,8,16,32,64,128,256,512}'::integer[]) ) SELECT (r).* FROM T ORDER BY (r).task_date, (r).id LIMIT 20; -- ... și aici - la fel:
O, deja mult mai bine! 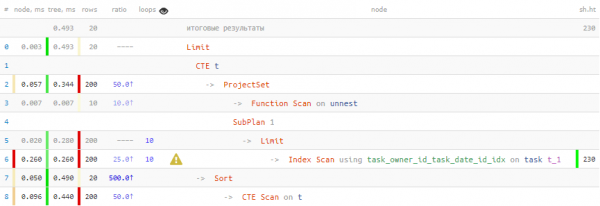
Cu 40% mai repede și cu date mai puține citite de 4.5 ori. Materializarea înregistrărilor de tabele prin CTE
Materializarea înregistrărilor din tabele prin CTEVoi atrage atenția că în unele cazuri încercarea de a lucra direct cu câmpurile înregistrării după ce a fost căutată în subinterogare, fără a fi "împachetate" într-un CTE, poate duce la "multiplicarea" InitPlan proporțional cu numărul acestor câmpuri:
SELECT
  ((
    SELECT
      t
    FROM
      task t
    WHERE
      owner_id = 1
    ORDER BY
      task_date, id
    LIMIT 1
  ).*);
Rezultatul (cost=4.77..4.78 rânduri=1 lățime=16) (timp real=0.063..0.063 rânduri=1 bucle=1)
Buffere: hit partajat=16
InitPlan 1 (returnează $0)
-> Limit (cost=0.42..1.19 rânduri=1 lățime=48) (timp real=0.031..0.032 rânduri=1 bucle=1)
Buffere: hit partajat=4
-> Scanare Index folosind task_owner_id_task_date_id_idx pe task t (cost=0.42..387.57 rânduri=500 lățime=48) (timp real=0.030..0.030 rânduri=1 bucle=1)
Conditie Index: (owner_id = 1)
Buffere: hit partajat=4
InitPlan 2 (returnează $1)
-> Limit (cost=0.42..1.19 rânduri=1 lățime=48) (timp real=0.008..0.009 rânduri=1 bucle=1)
Buffere: hit partajat=4
-> Scanare Index folosind task_owner_id_task_date_id_idx pe task t_1 (cost=0.42..387.57 rânduri=500 lățime=48) (timp real=0.008..0.008 rânduri=1 bucle=1)
Conditie Index: (owner_id = 1)
Buffere: hit partajat=4
InitPlan 3 (returnează $2)
-> Limit (cost=0.42..1.19 rânduri=1 lățime=48) (timp real=0.008..0.008 rânduri=1 bucle=1)
Buffere: hit partajat=4
-> Scanare Index folosind task_owner_id_task_date_id_idx pe task t_2 (cost=0.42..387.57 rânduri=500 lățime=48) (timp real=0.008..0.008 rânduri=1 bucle=1)
Conditie Index: (owner_id = 1)
Buffere: hit partajat=4
InitPlan 4 (returnează $3)
-> Limit (cost=0.42..1.19 rânduri=1 lățime=48) (timp real=0.009..0.009 rânduri=1 bucle=1)
Buffere: hit partajat=4
-> Scanare Index folosind task_owner_id_task_date_id_idx pe task t_3 (cost=0.42..387.57 rânduri=500 lățime=48) (timp real=0.009..0.009 rânduri=1 bucle=1)
Conditie Index: (owner_id = 1)
Buffere: hit partajat=4
Aceeași înregistrare a fost "căutată" de 4 ori... Până la PostgreSQL 11, un astfel de comportament a fost întâlnit frecvent, și soluția este "împachetarea" într-un CTE, ceea ce reprezintă o limită absolută pentru optimizator în aceste versiuni.
Acumulatoare recursive
În varianta anterioară, am citit în total 200 de rânduri pentru cele necesare 20. Nu mai sunt 960, dar în continuare mai puține — este posibil?
Hai să încercăm să folosim cunoștințele că avem nevoie de doar 20 de înregistrări. Adică vom itera citirea datelor doar până la atingerea numărului dorit.
Pasul 1: lista inițială
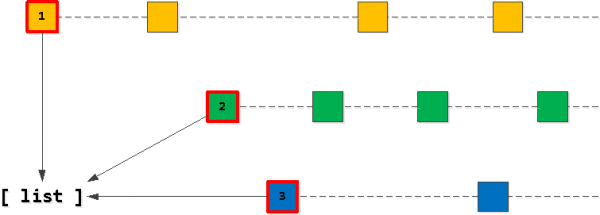
Este evident că lista noastră „țintă” de 20 de înregistrări ar trebui să înceapă cu „primele” înregistrări pe baza uneia dintre cheile noastre owner_id. Așadar, mai întâi să găsim astfel de „cele mai timpurii” pentru fiecare dintre chei și le vom adăuga în listă, sortându-le în ordinea dorită — (task_date, id).
Pasul 2: găsim „următoarele” înregistrări
Acum, dacă luăm prima înregistrare din lista noastră și începem să „avansăm” pe index. cu păstrarea cheii owner_id, toate înregistrările găsite sunt exact cele următoare în selecția rezultată. Sigur, doar până nu vom intersecta cheia aplicativă a două înregistrări din listă.
Dacă s-a întâmplat să «intersectăm» a doua înregistrare, atunci ultima înregistrare citită trebuie să fie adăugată în listă în locul primei (cu același owner_id), după care lista este reordonată din nou.
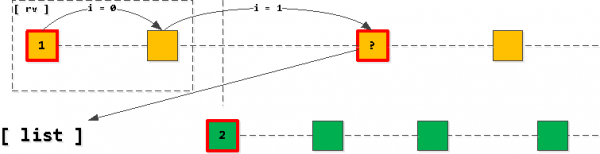
Asta înseamnă că avem tot timpul în listă nu mai mult de o înregistrare pentru fiecare cheie (dacă înregistrările s-au terminat, iar noi nu «am intersectat», prima înregistrare din listă pur și simplu va dispărea și nimic nu se va adăuga), și acestea sunt întotdeauna sortate în ordine crescătoare a cheii aplicative (task_date, id).
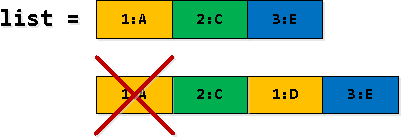
Pasul 3: filtrăm și „desfacem” înregistrările
În unele rânduri ale selecției noastre recursive, unele înregistrări rv se duplică — mai întâi găsim cele care «intersectează granița celei de-a 2-a înregistrări din listă», iar apoi le substituim ca prima din listă. Așadar, prima apariție trebuie filtrată.
Cererea finală îngrozitoare
CU RECURSIV T AS (
  -- #1 : introducem în listă înregistrările "principale" pentru fiecare dintre cheile setului
  CU wrap AS ( -- "materializăm" înregistrările, astfel încât accesul la câmpuri să nu ducă la multiplicarea InitPlan/SubPlan
    CU T AS (
      SELECT
        (
          SELECT
            r
          FROM
            task r
          WHERE
            owner_id = unnest
          ORDER BY
            task_date, id
          LIMIT 1
        ) r
      FROM
        unnest('{1,2,4,8,16,32,64,128,256,512}'::integer[])
    )
    SELECT
      array_agg(r ORDER BY (r).task_date, (r).id) list -- sortăm lista în ordinea dorită
    FROM
      T
  )
  SELECT
    list
  , list[1] rv
  , FALSE not_cross
  , 0 size
  FROM
    wrap
UNION ALL
  -- #2 : citim înregistrările pentru prima cheie în ordine, până când depășim înregistrarea celei de-a doua
  SELECT
    CASE
      -- dacă nu s-a găsit nimic pentru cheia primei înregistrări
      WHEN X._r IS NOT DISTINCT FROM NULL THEN
        T.list[2:] -- o eliminăm din listă
      -- dacă NU am intersectat cheia aplicativă a celei de-a doua înregistrări
      WHEN X.not_cross THEN
        T.list -- pur și simplu prelungim aceeași listă fără modificări
      -- dacă în listă nu mai există a doua înregistrare
      WHEN T.list[2] IS NULL THEN
        -- returnăm pur și simplu o listă goală
        '{}'
      -- reorganizăm dicționarul, eliminând prima înregistrare și adăugând ultima găsită
      ELSE (
        SELECT
          coalesce(T.list[2] || array_agg(r ORDER BY (r).task_date, (r).id), '{}')
        FROM
          unnest(T.list[3:] || X._r) r
      )
    END
  , X._r
  , X.not_cross
  , T.size + X.not_cross::integer
  FROM
    T
  , LATERAL(
      CU wrap AS ( -- "materializăm" înregistrarea
        SELECT
          CASE
            -- dacă totuși am "depășit" a doua înregistrare
            WHEN NOT T.not_cross
              -- atunci înregistrarea dorită este prima din listă
              THEN T.list[1]
            ELSE ( -- dacă nu am intersectat, cheia a rămas ca în înregistrarea precedentă - ne ancorăm de la aceasta
              SELECT
                _r
              FROM
                task _r
              WHERE
                owner_id = (rv).owner_id AND
                (task_date, id) > ((rv).task_date, (rv).id)
              ORDER BY
                task_date, id
              LIMIT 1
            )
          END _r
      )
      SELECT
        _r
      , CASE
          -- dacă a doua înregistrare nu mai este în listă, dar am găsit totuși ceva
          WHEN list[2] IS NULL AND _r IS DISTINCT FROM NULL THEN
            TRUE
          ELSE -- nu am găsit nimic sau am "depășit"
            coalesce(((_r).task_date, (_r).id) < ((list[2]).task_date, (list[2]).id), FALSE)
        END not_cross
      FROM
        wrap
    ) X
  WHERE
    T.size < 20 AND -- limităm aici numărul
    T.list IS DISTINCT FROM '{}' -- sau până când lista nu s-a epuizat
)
-- #3 : "desfacem" înregistrările - ordinea este garantată prin construcție
SELECT
  (rv).*
FROM
  T
WHERE
not_cross; -- luăm doar înregistrările "neintersectante" 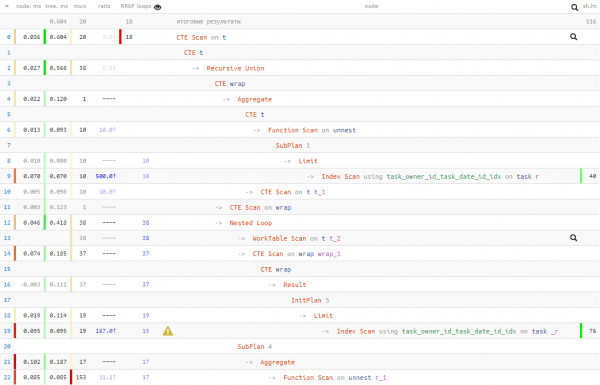
Astfel, noi am schimbat 50% din citirile de date pe 20% din timpul de execuțieAdică, dacă aveți motive să credeți că citirea ar putea dura mult (de exemplu, datele nu sunt de obicei în cache și trebuie să le căutăm pe disc), atunci în acest mod puteți depinde mai puțin de citire.
Oricum, timpul de execuție a fost mai bun decât în prima variantă «naivă». Dar care dintre aceste 3 variante să folosiți — decideți dvs.
Sursa: habr.com
