

Conferința HighLoad++ va avea loc pe 6 și 7 aprilie 2020 în Sankt Petersburg. Detalii și bilete . HighLoad++ Moscova 2018. Sala „Moscova”. 9 noiembrie, 15:00. Teze și .
* Monitorizare — online și analiză.
* Principalele limitări ale platformei ZABBIX.
* Soluție pentru scalarea depozitului de analize.
* Optimizarea serverului ZABBIX.
* Optimizarea UI.
* Experiența în exploatarea sistemului sub încărcări de peste 40k NVPS.
* Pe scurt, concluzii.
Mihail Makurov (în continuare – MM): – Bună ziua tuturor!
Maxim Cernețov (în continuare – MC): – Bună ziua!
MM: – Permiteți-mi să-l prezint pe Maxim. Max este un inginer talentat, cel mai bun specialist în rețele pe care îl cunosc. Maxim se ocupă de rețele și servicii, dezvoltarea și exploatarea acestora.
MC: – Aș dori să vorbesc despre Mihail. Mihail este dezvoltator C. A scris câteva soluții cu încărcare mare pentru procesarea traficului pentru compania noastră. Locuim și lucrăm în Urali, în orașul dur al bărbaților, Celiabinsk, în compania „Intersvyaz”. Compania noastră este un furnizor de servicii de internet și televiziune prin cablu pentru un milion de oameni în 16 orașe.
MM: – Și trebuie să spun că „Intersvyaz” este mult mai mult decât un simplu provider, este o companie IT. Majoritatea soluțiilor noastre sunt realizate de echipa noastră IT.
A: de la servere care procesează traficul, până la call-center și aplicații mobile. În echipa IT sunt acum aproximativ 80 de oameni cu competențe foarte diverse.
Despre Zabbix și arhitectura sa
MC: – Acum voi încerca să-mi stabilesc un record personal și în mai puțin de un minut să explic ce este Zabbix (în continuare – „Zabbix”).
„Zabbix” se poziționează ca un sistem de monitorizare „pront de utilizare” la nivel de întreprindere. Are multe funcții care simplifică viața: reguli avansate de escaladare, API pentru integrare, grupare și descoperire automată a gazdelor și metricelor. „Zabbix” dispune de așa-numitele instrumente de scalare – proxy-uri. „Zabbix” este un sistem open-source.
Pe scurt, despre arhitectură. Se poate spune că aceasta constă din trei componente:
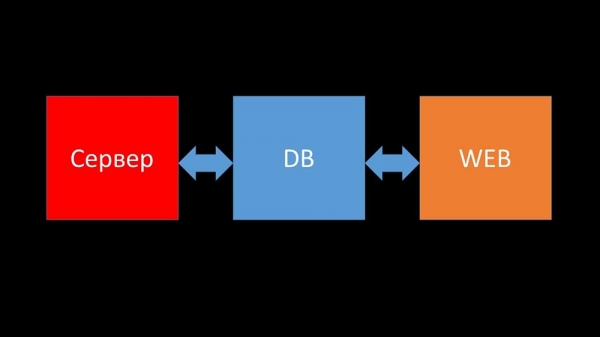
- Server. Scris în C. Cu un proces complex de prelucrare și transmitere a informațiilor între fire. Toată prelucrarea are loc în acesta: de la recepție până la salvarea în baza de date.
- Toate datele sunt stocate în bază. „Zabbix” suportă MySQL, PostgreSQL și Oracle.
- Interfața web este scrisă în PHP. În majoritatea sistemelor vine cu serverul Apache, dar funcționează mai eficient în combinație cu nginx + php.
Astăzi dorim să împărtășim o poveste din viața companiei noastre, legată de „Zabbix”…
O poveste din viața companiei „Intersvyaz”. Ce avem și ce avem nevoie?
Acum 5 sau 6 luni. Odată, după muncă…
MC: – Misha, salut! Mă bucur că te-am prins – am nevoie să discutăm. Din nou am avut probleme cu monitorizarea. În timpul unei mari avarii, totul era lent și nu aveam nicio informație despre starea rețelei. Din păcate, aceasta se repetă deja pentru a nu știu câta oară. Am nevoie de ajutorul tău. Haide să ne asigurăm că monitorizarea noastră va funcționa în orice circumstanță!
MM: – Dar să ne sincronizăm mai întâi. Nu am mai verificat acolo de vreo doi ani. După cât îmi amintesc, am renunțat la Nagios și am trecut la „Zabbix” acum aproximativ 8 ani. Și acum, cred că avem 6 servere puternice și în jur de zece proxy-uri. Nu mă înșel?
MC: – Aproape. 15 servere, dintre care unele sunt mașini virtuale. Cel mai important este că asta nu ne salvează în momentul în care avem cea mai mare nevoie. Când apare o avarie – serverele devin lente și nimic nu se vede. Am încercat să optimizăm configurația, dar nu a adus un câștig optim de performanță.
MM: – Înțeleg. Ați investigat ceva, ați adunat date din diagnosticare?
MC: – Primul lucru de care ne ocupăm este baza de date. MySQL este constant aglomerat, salvând noile metrici, iar când „Zabbix” începe să genereze o mulțime de evenimente – baza intră în panică timp de câteva ore. Ți-am vorbit deja despre optimizarea configurației, iar anul acesta am actualizat echipamentul: serverele au peste o sută de giga de memorie și array-uri de discuri SSD RAID – nu are sens să creștem capacitatea linear. Ce vom face?
MM: – Înțeleg. În general, MySQL este o bază de date LTP. Se pare că nu mai este potrivită pentru stocarea arhivelor metricilor noastre. Haide să ne ocupăm de asta.
MC: – Haide!
Integrarea Zabbix și Clickhouse ca rezultat al hackathon-ului
După un timp, am obținut date interesante:
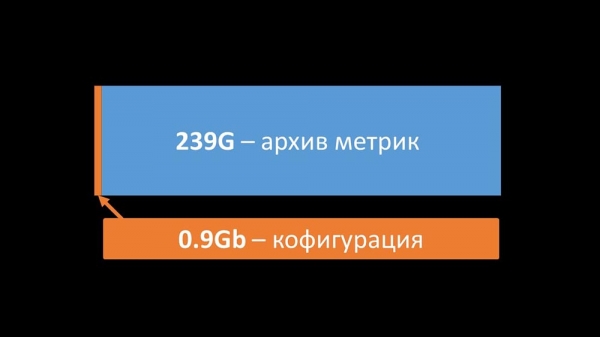
Cea mai mare parte a spațiului din baza noastră a fost ocupată de arhiva metodelor, iar mai puțin de 1% a fost folosit pentru configurații, șabloane și setări. La acel moment, exploatăm soluția Big Data bazată pe Clickhouse de mai bine de un an. Direcția de mișcare era evidentă pentru noi. La „Hackathon”-ul nostru de primăvară, am scris o integrare a „Zabbix” cu „Clickhouse” pentru server și frontend. La acel moment, „Zabbix” avea deja suport pentru ElasticSearch și am decis să le comparăm.
Compararea Clickhouse și Elasticsearch
MM: – Pentru comparație, am generat o încărcătură similară celei furnizate de serverul „Zabbix” și am observat cum se comportă sistemele. Am scris datele în loturi de 1000 de rânduri, folosind CURL. Am anticipat că „Clickhouse” va fi mai eficient pentru profilul de încărcare pe care îl generează „Zabbix”. Rezultatele ne-au depășit așteptările:
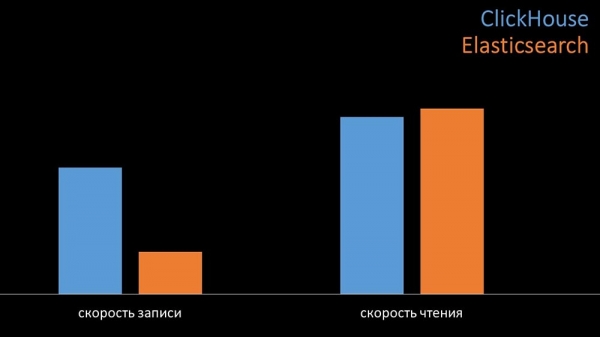
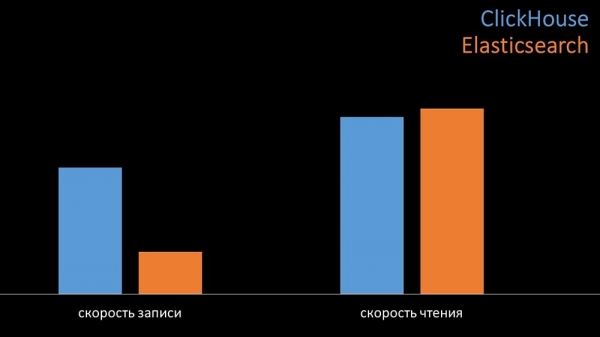
În condiții identice, în teste, „Clickhouse” a scris de trei ori mai multe date. În același timp, ambele sisteme au consumat foarte eficient (puține resurse) citind datele. Însă „ElasticSearch” a necesitat un consum mare de procesor la scriere:
În ansamblu, „Clickhouse” a depășit semnificativ „ElasticSearch” în ceea ce privește consumul de procesor și viteza. Datorită compresiei datelor, „Clickhouse” folosește de 11 ori mai puțin pe disc și realizează aproximativ de 30 de ori mai puține operații de disc:
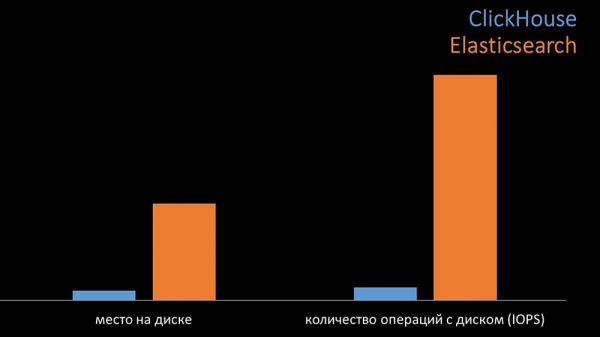
MC: – Da, lucrul cu subsistemul de discuri la „Clickhouse” este realizat foarte eficient. Pentru baze de date pot fi folosite discuri SATA enorme, obținând viteze de scriere de sute de mii de rânduri pe secundă. Sistemul suportă „din cutie” sharding, replicare și este foarte simplu de configurat. Suntem mai mult decât mulțumiți de exploatarea sa timp de un an.
Pentru a optimiza resursele, se poate instala „Clickhouse” lângă baza principală existentă, economisind astfel o mulțime de timp de procesor și operații de disc. Am mutat arhiva metodelor pe clusterele „Clickhouse” deja existente:
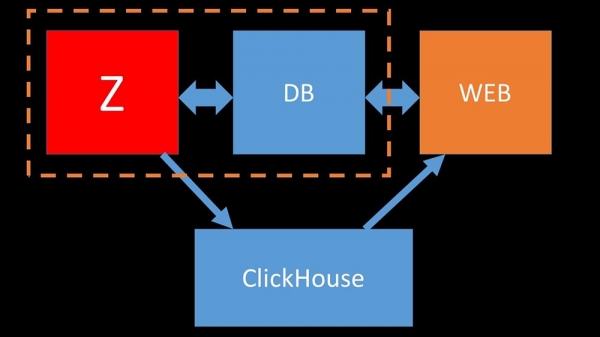
Am descărcat baza principală MySQL atât de mult, încât am putut să o combinăm pe aceeași mașină cu serverul „Zabbix” și să renunțăm la un server dedicat pentru MySQL.
Cum funcționează polling-ul în Zabbix?
acum 4 luni
MM: – Ei bine, putem uita de problemele cu baza de date?
MC: – Așa este! O altă problemă pe care trebuie să o rezolvăm este colectarea lentă a datelor. Acum, toți cei 15 servere proxy sunt supraîncărcate cu procese SNMP și polling. Și nu avem altceva de făcut decât să mai adăugăm noi servere.
MM: – Excelent. Dar spune-mi mai întâi cum funcționează polling-ul în „Zabbix”?
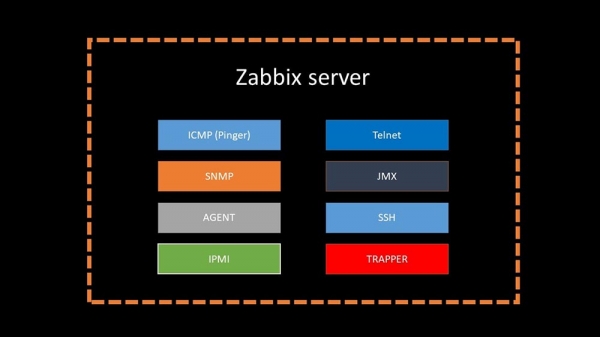
MC: – Pe scurt, există 20 de tipuri de metrici și zeci de modalități de a le obține. „Zabbix” poate colecta date fie în modul „cerere – răspuns”, fie așteptând date noi prin „Interfața Trapper”.
Merită menționat că în „Zabbix”-ul original acest mod (Trapper) este cel mai rapid.
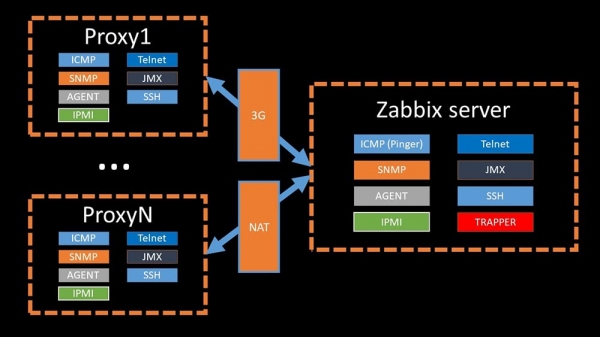
Există servere proxy pentru distribuirea încărcăturii:
Proxile pot îndeplini aceleași funcții de colectare ca și serverul „Zabbix”, primind sarcini de la acesta și trimițând metricile colectate prin intermediul interfeței Trapper. Aceasta este metoda oficial recomandată pentru distribuirea încărcăturii. De asemenea, proxile sunt utile pentru monitorizarea infrastructurii la distanță, care funcționează prin NAT sau canale lente:
MM: – Totul e clar cu arhitectura. Trebuie să ne uităm la sursa...
Câteva zile mai târziu
Povestea despre cum nmap fping a învins
MM: – Se pare că am găsit ceva.
MC: – Povestește!
MM: – Am descoperit că în timpul verificărilor de disponibilitate „Zabbix” verifică maximum 128 de gazde simultan. Am încercat să cresc acest număr la 500 și am eliminat intervalul de timp între pachete în ping-ul lor – aceasta a crescut performanța de două ori. Dar aș dori cifre și mai mari.
MC: – În practica mea, uneori trebuie să verific disponibilitatea a mii de gazde și nu am întâlnit nimic mai rapid decât nmap pentru acest lucru. Sunt sigur că acesta este cel mai rapid mod. Haide să-l încercăm! Trebuie să creștem semnificativ numărul de gazde într-o singură iterație.
MM: – Să verificăm mai mult de cinci sute? 600?
MC: – Cel puțin câteva mii.
MM: – Ok. Cel mai important lucru pe care voiam să-l spun: am descoperit că majoritatea polling-ului în „Zabbix” este făcută sincron. Trebuie neapărat să-l transformăm în modul asincron. Atunci vom putea crește radical numărul de metrici colectate de pollere, mai ales dacă creștem numărul de metrici într-o singură iterație.
MC: – Grozav! Când?
MM: – Ca de obicei, ieri.
MC: – Am comparat ambele versiuni fping și nmap:
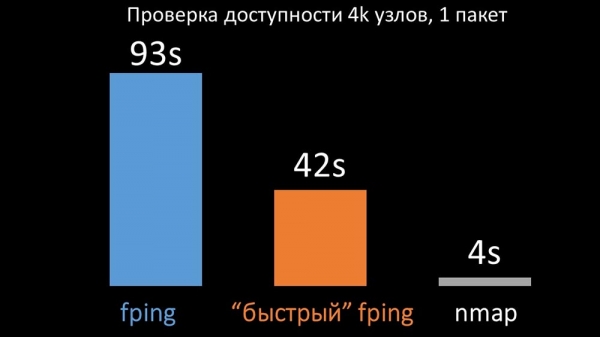
Pe un număr mare de gazde, nmap a fost, așa cum era de așteptat, de până la cinci ori mai eficient. Deoarece nmap verifică doar disponibilitatea și timpul de răspuns, am mutat numărarea pierderilor în declanșatoare și am redus semnificativ intervalele de verificare a disponibilității. Am descoperit că numărul optim de gazde pentru nmap este în jur de 4.000 pe o iterație. Nmap ne-a permis să reducere de trei ori costurile CPU pentru verificările de disponibilitate și să scurtăm intervalul de la 120 de secunde la 10.
Optimizarea polling-ului
MM: – Apoi ne-am ocupat de pollere. În principal, ne-a interesat să colectăm SNMP și agendele. În «Zabbix», polling-ul este realizat sincron și au fost luate măsuri speciale pentru a crește eficiența sistemului. în modul sincron, indisponibilitatea gazdelor provoacă o degradare semnificativă a polling-ului. Există un întreg sistem de stări, există procese speciale – așa-numitele pollere unreachable, care lucrează doar cu gazde indisponibile:

Aceasta este un comentariu care demonstrează matricea stărilor, toată complexitatea sistemului de tranziții necesar pentru a menține sistemul eficient. În plus, polling-ul sincron este destul de lent:
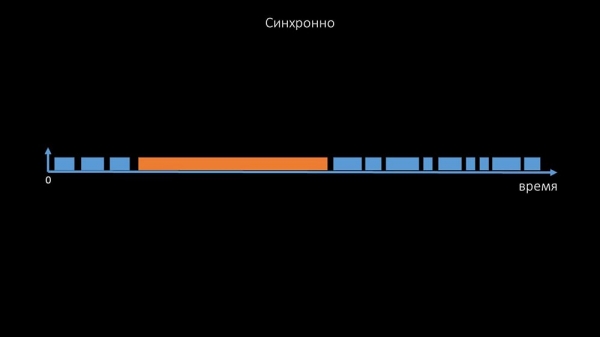
De aceea, mii de fire de pollere pe zece proxy-uri nu puteau colecta pentru noi cantitatea necesară de date. Implementarea asincronă nu a rezolvat doar problemele cu numărul de fire, ci a simplificat semnificativ sistemul de stări ale gazdelor indisponibile, deoarece, indiferent de numărul verificat într-o singură iterație a polling-ului, timpul maxim de așteptare era de 1 timeout:
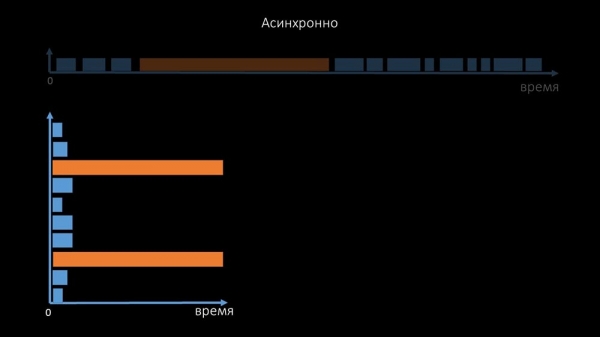
În plus, am modificat și îmbunătățit sistemul de polling pentru cererile SNMP. Problema este că majoritatea nu pot răspunde la mai multe cereri SNMP simultan. Așadar, am creat un mod hibrid, în care polling-ul SNMP al aceleași gazde se face asincron:
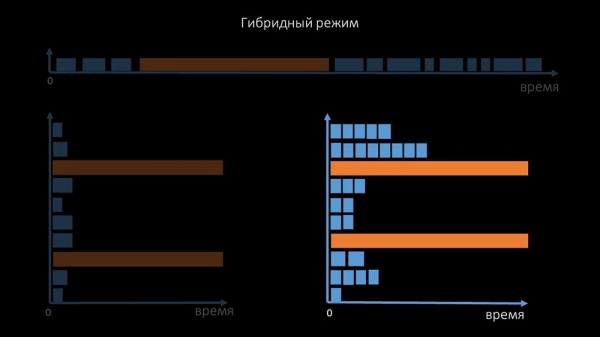
Aceasta se face pentru întreaga grupare de gazde. Acest mod nu este, în final, mai lent decât cel complet asincron, deoarece interogarea a unei sute cincizeci de valori SNMP este tot mult mai rapidă decât 1 timeout.
Experimentele noastre au arătat că numărul optim de cereri într-o singură iterație este de aproximativ 8.000 în cadrul polling-ului SNMP. Trecerea la modul asincron a permis, în total, să accelerăm performanța polling-ului de 200 de ori, de câteva sute de ori.
MC: – Optimizările obținute pentru polling au arătat că nu doar că putem scăpa de toate proxy-urile, dar putem reduce și intervalele pentru multe verificări, iar proxy-urile devin inutile ca metodă de distribuire a încărcăturii.
Aproximativ acum trei luni
Schimbă arhitectura – crește încărcătura!
MM: – Ei bine, Max, e timpul să trecem la producție? Am nevoie de un server puternic și un inginer bun.
MC: – Bine, vom planifica. Era timpul să ne mișcăm de la cele 5000 de metrici pe secundă.
Dimineața după upgrade
MC: – Misha, ne-am actualizat, dar până dimineață ne-am întors la vechea versiune… Ghicește ce viteză am reușit să atingem?
MM: – Maximum 20 de mii.
MC: – Aha, 25! Din păcate, suntem tot acolo de unde am început.
MM: – De ce așa? Ați realizat vreo diagnosticare?
MC: – Da, bineînțeles! Iată, de exemplu, un top interesant:
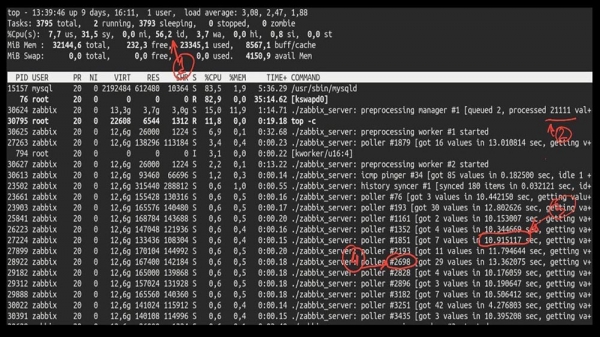
MM: – Hai să vedem. Văd că am încercat o mulțime de fire de polling:
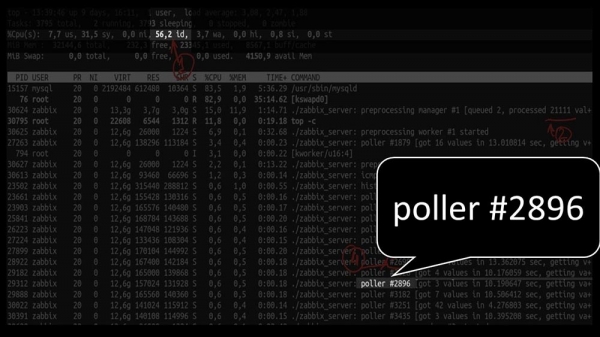
Dar nu am putut să utilizăm sistemul nici măcar pe jumătate:
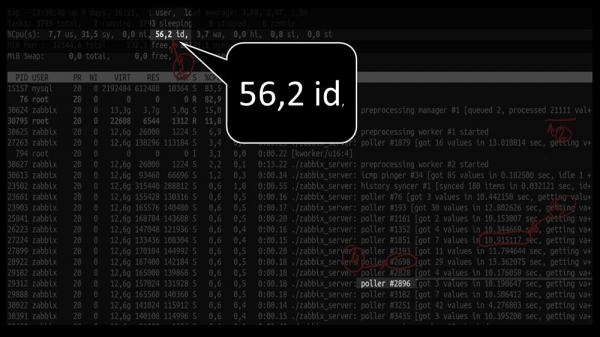
Și performanța generală este destul de mică, aproximativ 4000 de metrici pe secundă:
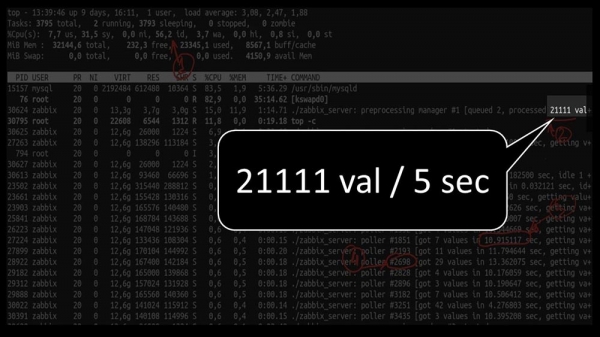
Mai este ceva?
MC: – Da, strace-ul unuia dintre pollere:
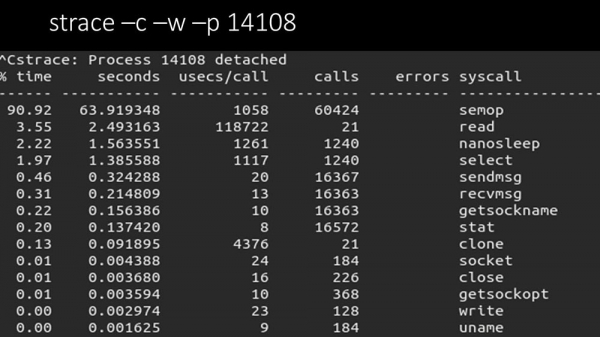
MM: – Aici se vede clar că procesul de polling așteaptă ‘semafoare’. Acestea sunt blocări:
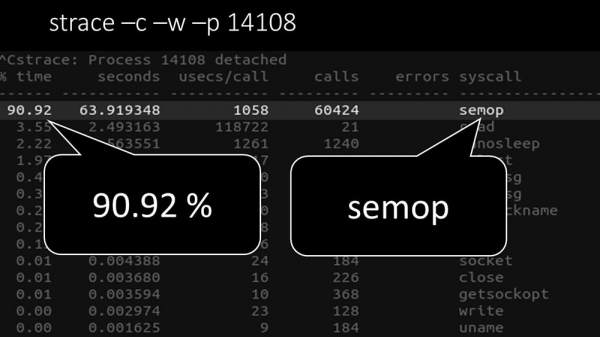
MC: – Nu înțeleg.
MM: – Uite, pare a fi o situație în care o mulțime de fire încearcă să lucreze cu un resursă, cu care poate lucra un singur fir simultan. Atunci tot ceea ce pot face este să împartă această resursă pe timp:
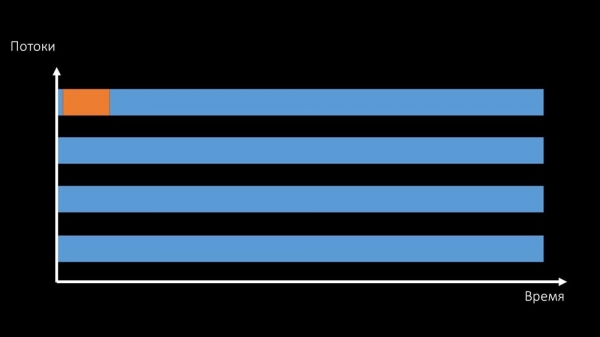
Și performanța totală a muncii cu o astfel de resursă este limitată de viteza unui singur nucleu:
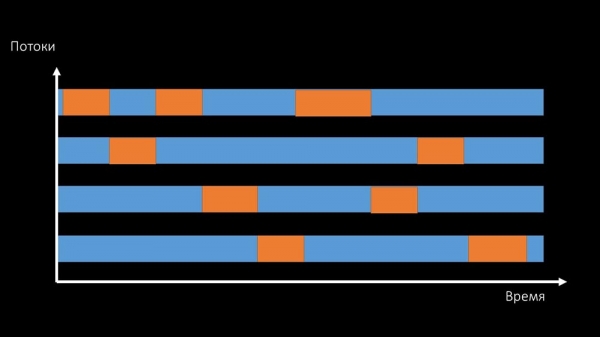
O astfel de problemă poate fi rezolvată în două moduri.
Să upgradezi hardware-ul mașinii, trecând la nuclee mai rapide:
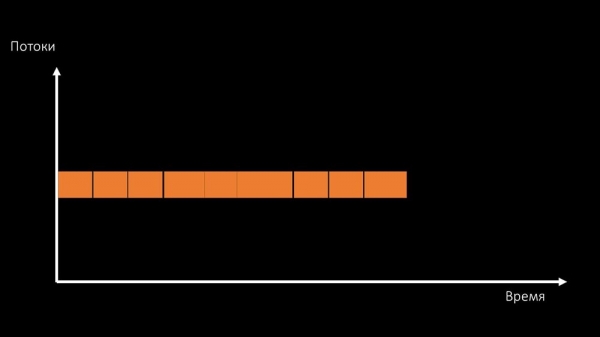
Sau să schimbi arhitectura și, simultan, încărcătura:
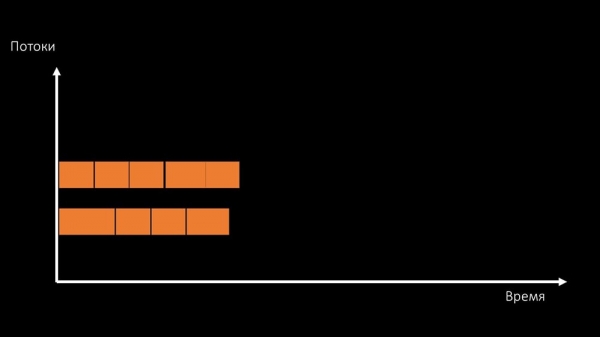
MC: – Apropo, pe mașina de testare folosim un număr mai mic de nuclee decât pe cea de producție, dar acestea sunt cu 1,5 ori mai rapide în frecvență pe nucleu!
MM: – Clar? Trebuie să ne uităm la codul serverului.
Calea datelor în serverul Zabbix
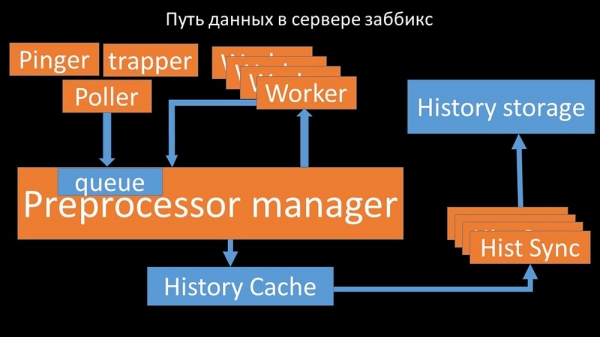
MC: – Pentru a înțelege, am început să analizăm cum sunt transmise datele în interiorul serverului ‘Zabbix’:
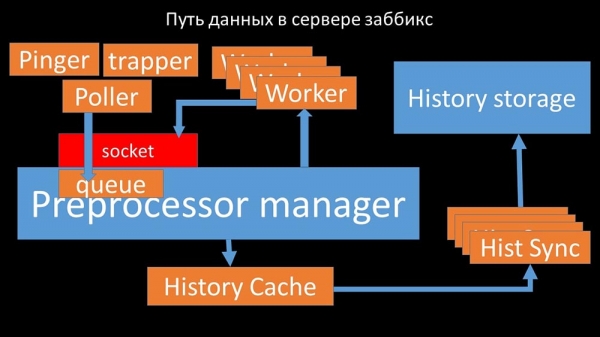
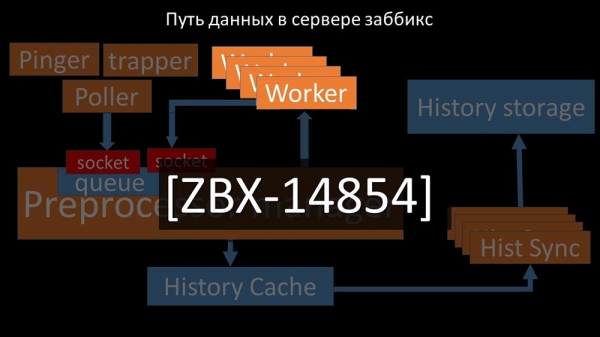
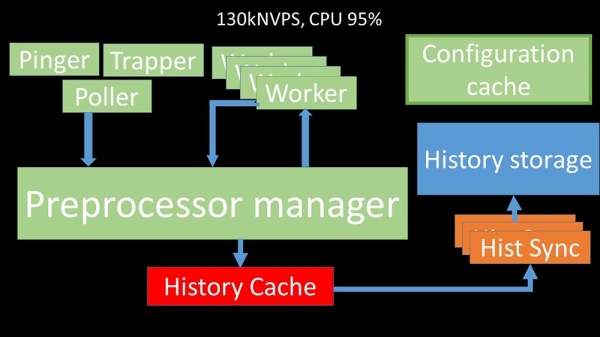
O imagine grozavă, nu-i așa? Hai să trecem prin ea pas cu pas, pentru a clarifica lucrurile. Există fire și servicii responsabile pentru colectarea datelor:
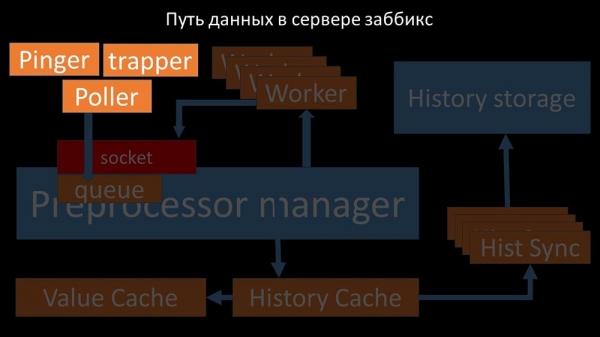
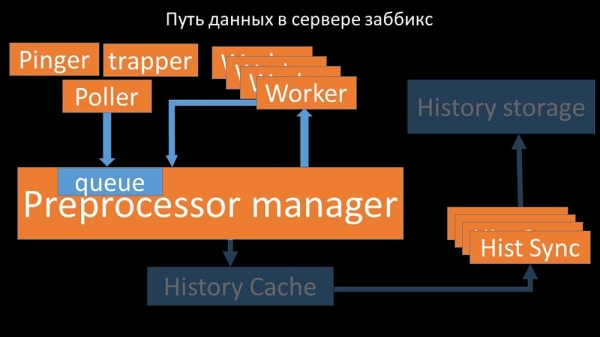
Metricile colectate sunt transmise printr-un socket în Preprocessor manager, unde sunt salvate într-o coadă:
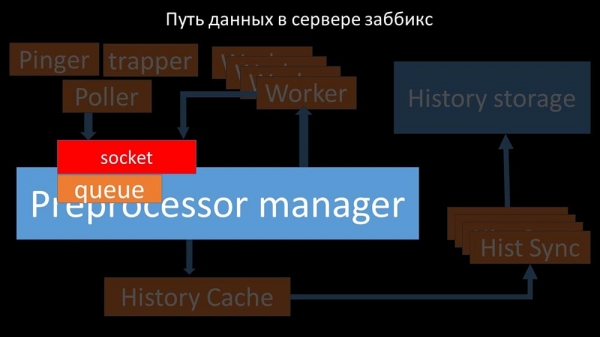
Preprocessor manager-ul transferă datele către lucrătorii săi, care execută instrucțiunile de preprocesare și le returnează înapoi prin același socket:
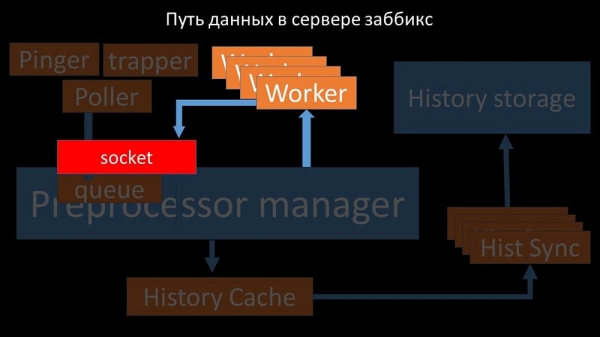
După aceasta, managerul de preprocesare le salvează în cache-ul istoriei:
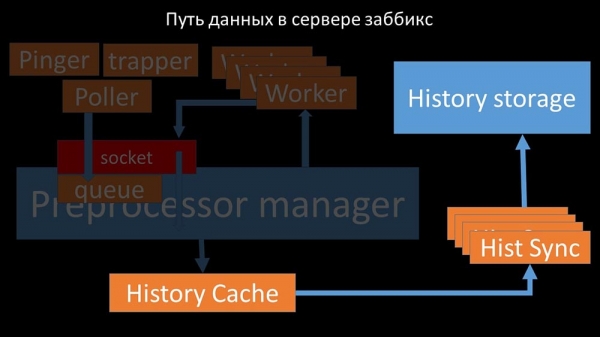
De acolo, ele sunt preluate de către sincroniștii de istorie, care îndeplinesc o mulțime de funcții: de exemplu, calcularea triggerelor, completarea cache-ului de valori și, cel mai important, salvarea metricelor în depozitul de istorie. În general, procesul este complex și destul de confuz.
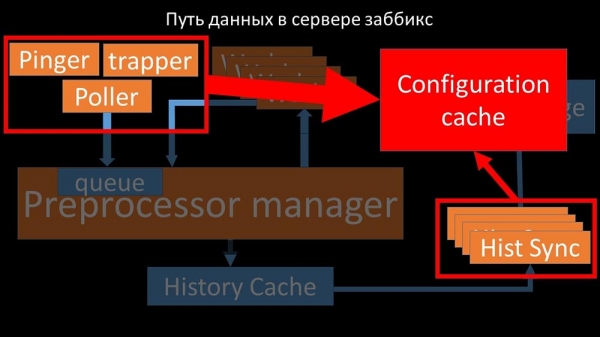
MM: – Primul lucru pe care l-am observat a fost că majoritatea firelor concurează pentru așa-numitul "cache de configurare" (memorie unde sunt stocate toate configurațiile serverului). În special, multe blocări sunt generate de firele responsabile de colectarea datelor:
…deoarece în configurație sunt stocate nu doar metricile cu parametrii lor, ci și cozi din care pollerele iau informații despre ce să facă mai departe. Când sunt multe pollere și unul blochează configurația, ceilalți așteaptă cereri:
Pollerele nu ar trebui să concureze
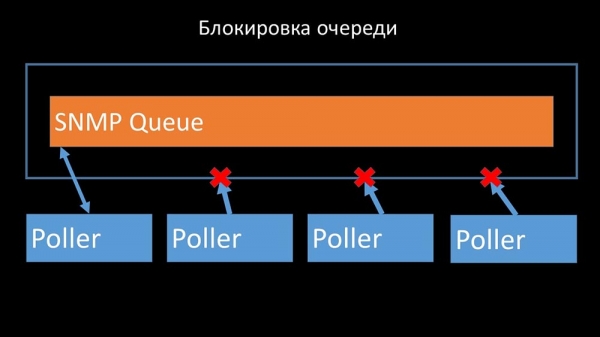
Așa că primul lucru pe care l-am făcut a fost să împărțim coada în 4 părți și să permitem pollerelor să blocheze aceste cozi, aceste părți simultan, în condiții sigure:
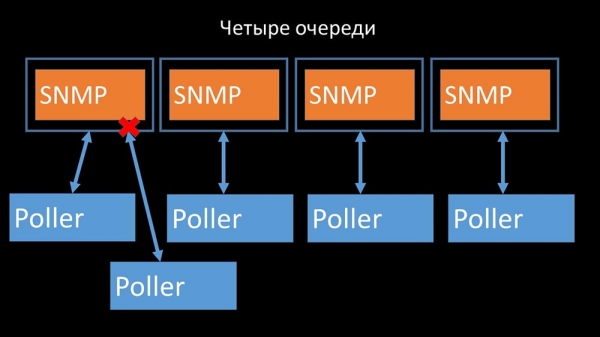
Aceasta a eliminat competiția pentru cache-ul de configurare, iar viteza de funcționare a pollerelor a crescut semnificativ. Dar apoi ne-am confruntat cu faptul că managerul de preprocesare a început să acumuleze o coadă de sarcini:
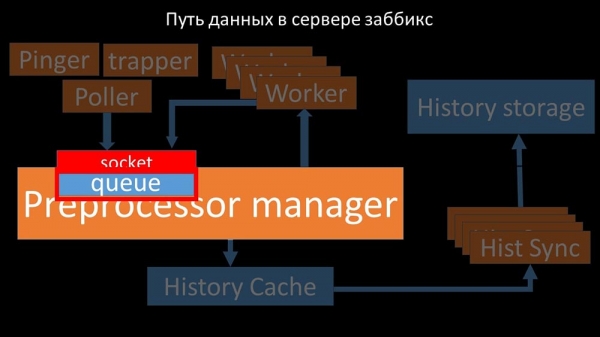
Managerul de preprocesare trebuie să fie capabil să prioritizeze
Acest lucru s-a întâmplat în cazurile în care nu avea suficientă performanță. Atunci, tot ce putea face era să acumuleze cererile din procesele de colectare a datelor și să le stocheze în buffer până când ocupa toată memoria și cădea:
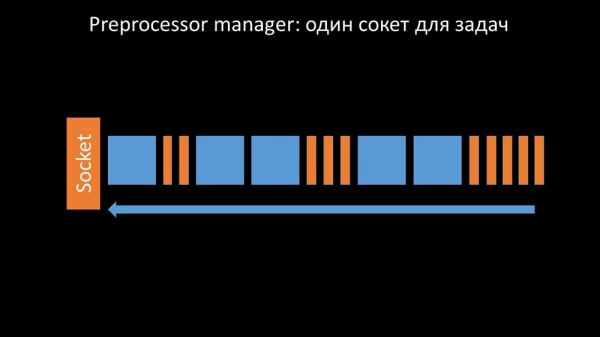
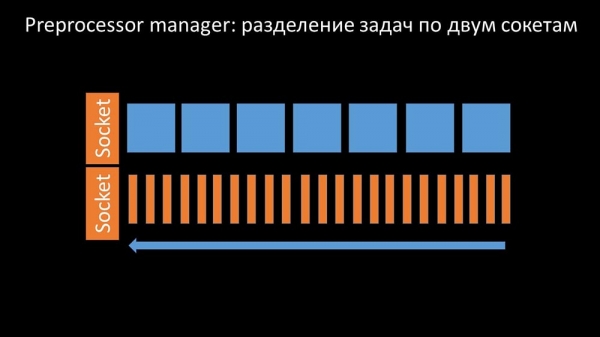
Pentru a rezolva această problemă, am adăugat un al doilea socket, care a fost dedicat special worker-ilor:
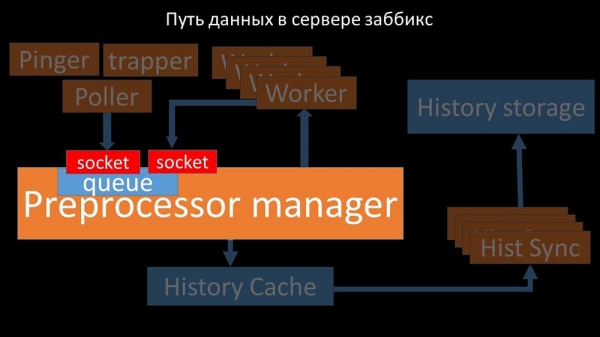
Astfel, managerul de preprocesare a obținut posibilitatea de a-și prioritiza activitatea și, în cazul extinderii buffer-ului, sarcina de a încetini colectarea, oferind worker-ilor oportunitatea de a prelua acest buffer:
Apoi am descoperit că una dintre cauzele încetinirii erau chiar worker-ii, deoarece concurau pentru o resursă complet neimportantă pentru activitatea lor. Această problemă a fost rezolvată printr-un bug-fix, iar în noile versiuni ale "Zabbix" aceasta este deja soluționată:
Creștem numărul de sockets – obținem rezultate
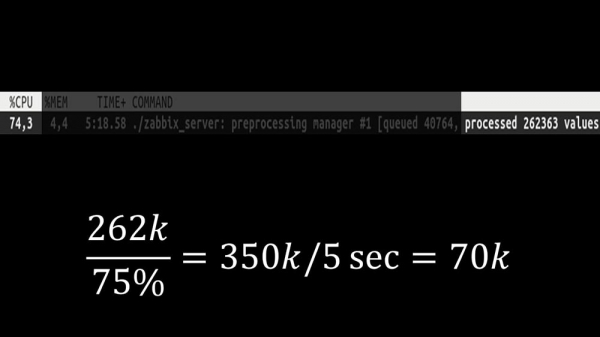
Apoi, managerul de preprocesare a devenit punctul slab, deoarece acesta este un singur fir. Se împotmolea în viteza nucleului, oferind o viteză maximă de aproximativ 70 de mii de metrici pe secundă:
De aceea am făcut patru, cu patru seturi de socket-uri, lucrători:
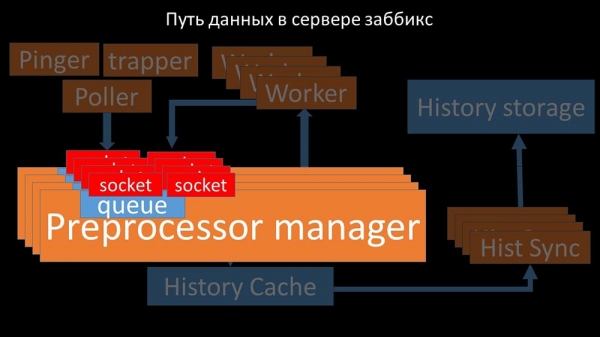
Și acest lucru a permis creșterea vitezei la aproximativ 130.000 de metrici:
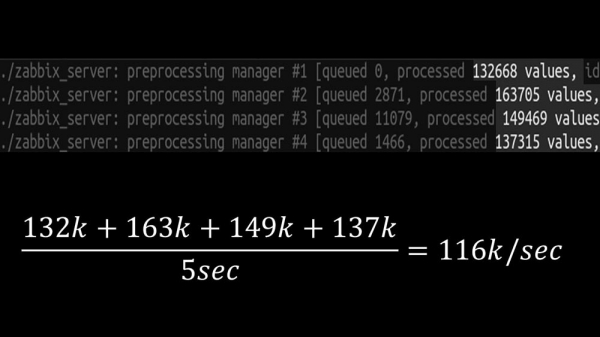
Neliniaritatea creșterii se explică prin faptul că a apărut competiția pentru cache-ul istoric. Patru manageri de preprocesare și sync-erii de istoric concurează pentru el. Până în acel moment, obțineam pe mașina de testare aproximativ 130.000 de metrici pe secundă, utilizând-o cam 95% din capacitatea procesorului:
Aproximativ acum 2,5 luni
Renunțarea la snmp-community a crescut NVP-urile cu o dată și jumătate
MM: – Max, am nevoie de o nouă mașină de testare! Nu mai încapem în cea actuală.
MC: – Ce avem acum?
MM: – Acum avem – 130k NVP-uri și procesorul "în raft".
MC: – Wow! Super! Așteaptă, am două întrebări. Conform calculelor mele, nevoia noastră este undeva în jur de 15-20.000 de metrici pe secundă. De ce ne trebuie mai mult?
MM: – Vrem să terminăm ceea ce am început. Vrem să vedem cât putem extrage din acest sistem.
MC: – Dar…
MM: – Dar pentru afacere este inutil.
MC: – Înțeleg. Și a doua întrebare: putem să întreținem ceea ce avem acum, fără ajutorul unui dezvoltator?
MM: – Nu cred. Modificarea modului de lucru cu cache-ul de configurare este o problemă. Se referă la modificări în majoritatea fluxurilor și este destul de complicat de întreținut. Cel mai probabil, va fi foarte greu să o întreținem.
MC: – Atunci avem nevoie de o alternativă.
MM: – Există o astfel de opțiune. Putem trece la nuclee rapide, renunțând la noul sistem de blocare. Tot vom obține o performanță de 60-80.000 de metrici. De asemenea, vom putea păstra tot restul codului. "Clickhouse", polling-ul asincron vor funcționa. Și va fi ușor de întreținut.
MC: – Minunat! Propun să ne oprim aici.
După optimizarea părții serverului, în sfârșit am reușit să lansăm noul cod în producție. Am renunțat la o parte din modificări în favoarea trecerii pe o mașină cu nuclee rapide și minimizării numărului de modificări în cod. De asemenea, am simplificat configurația și am renunțat la macro-uri în elementele de date, în măsura posibilului, deoarece acestea reprezintă sursa blocajelor suplimentare.
De exemplu, renunțarea la macro-ul snmp-community, care apare frecvent în documentație și exemple, în cazul nostru a permis să accelerăm suplimentar NVP-urile cu aproximativ 1,5 ori.
După două zile în producție
Eliminăm feroneria feroneriilor incidentelor
MC: – Misha, folosim sistemul de două zile și totul funcționează. Numai că funcționează doar atunci când totul merge bine! Am avut lucrări planificate de migrare a unui segment destul de mare din rețea și am verificat manual din nou ce a funcționat și ce nu.
MM: – Nu se poate! Am verificat totul de 10 ori. Serverul gestionează chiar și indisponibilitatea totală a rețelei instantaneu.
MC: – Înțeleg totul: server, bază, top, austat, loguri – totul rapid… Dar ne uităm la interfața web și acolo – procesorul este „pe raft” pe server și asta:
MM: – Am înțeles. Hai să ne uităm la web. Am descoperit că, în situația în care erau multe incidente active, majoritatea widgeturilor operaționale începeau să funcționeze foarte lent:
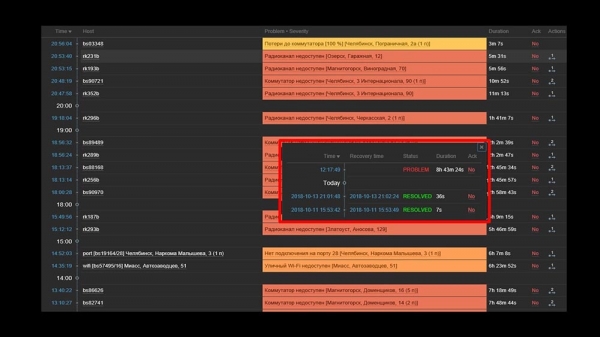
Cauza a fost generația de feronerie pop-up cu istoricul incidentelor, care sunt generate pentru fiecare element din listă. Astfel, am renunțat la generarea acestor feronerie (am comentat 5 linii în cod) și acest lucru ne-a rezolvat problemele.
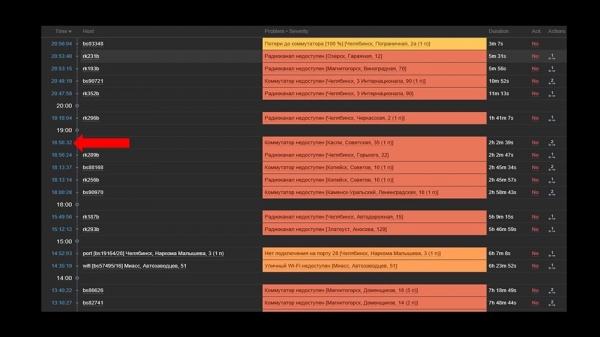
Timpul de încărcare al widgeturilor, chiar și în cazul indisponibilității totale, a fost redus de la câteva minute la 10-15 secunde, acceptabile pentru noi, iar istoricul poate fi în continuare vizualizat printr-un clic pe timp:
După muncă. Acum 2 luni
MC: – Misha, pleci? Am nevoie să vorbim.
MM: – Nu aveam de gând. Din nou ceva cu „Zabbix”?
MC: – Nu, destinde-te! Voiam doar să spun: totul funcționează, mulțumesc! La mine berea.
Zabbix este eficient
„Zabbix” este un sistem și funcționalitate destul de versatilă și bogată. Poate fi utilizat cu ușurință pentru instalări mici „din cutie”, dar pe măsură ce nevoile cresc, trebuie optimizat. Pentru a stoca un arhivă mare de metrici, utilizați un depozit adecvat:
- puteți folosi instrumentele încorporate prin integrarea cu „Elasticsearch” sau exportarea istoricului în fișiere text (disponibil din versiunea a patra);
- puteți beneficia de experiența noastră și integrarea cu „ClickHouse”.
Pentru a crește radical viteza de colectare a metricilor, colectați-le prin metode asincrone și transmiteți-le prin interfața trapper către serverul „Zabbix”; altfel, puteți folosi un patch pentru asincronicitatea pollerelor din Zabbix.
Zabbix este scris în C și este destul de eficient. Soluția, deși are câteva locuri arhitecturale înguste, permite creșterea suplimentară a performanței și, din experiența noastră, obținerea a peste 100 de mii de metrici pe o mașină cu un singur procesor.
Patch-ul Zabbix
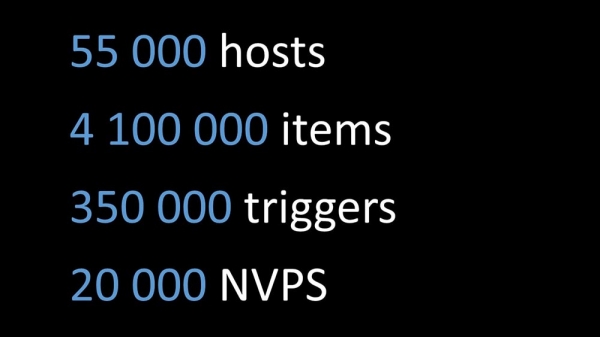
MM: – Vreau să adaug câteva puncte. Întregul raport curent, toate testele, cifrele sunt prezentate pentru configurația pe care o folosim noi. De la aceasta, acum obținem aproximativ 20 de mii de metrici pe secundă. Dacă încercați să înțelegeți dacă va funcționa pentru voi – puteți compara. Ceea ce am prezentat astăzi este disponibil pe GitHub sub formă de patch:
Patch-ul include:
- integrări complete cu ClickHouse (atât serverele Zabbix, cât și frontend-ul);
- rezolvarea problemelor cu managerul de preprocesare;
- polling asincron.
Patch-ul este compatibil cu toată versiunea 4, inclusiv cu lts. Cel mai probabil, cu modificări minime, va funcționa și pe versiunea 3.4.
Vă mulțumesc pentru atenție.
Întrebări
Întrebare din public (A): – Bună ziua! Vă rog să-mi spuneți, aveți planuri de interacțiune intensivă cu echipa Zabbix sau ei cu voi, astfel încât să nu fie un patch, ci un comportament normal al Zabbix?
MM: – Da, unele modificări le vom înregistra cu siguranță. Unele vor rămâne în patch.
A: – Vă mulțumesc foarte mult pentru prezentarea excelentă! Vă rog, după aplicarea patch-ului, va mai rămâne suport din partea Zabbix și cum vom putea să ne actualizăm la versiuni mai mari? Va exista posibilitatea de a actualiza Zabbix după patch-ul vostru până la 4.2, 5.0?
MM: – Nu pot spune nimic despre suport. Dacă aș fi suport tehnic pentru Zabbix, probabil că aș spune nu, deoarece este cod străin. În ceea ce privește baza de cod 4.2, poziția noastră este următoarea: "Vom merge cu timpul și ne vom actualiza la următoarea versiune". Prin urmare, pentru o perioadă de timp vom publica patch-uri pentru versiunile actualizate. Am spus deja în raport: numărul modificărilor între versiuni este încă destul de mic. Cred că trecerea de la 3.4 la 4 ne-a durat, pare să fie, vreo 15 minute. S-au schimbat unele lucruri, dar nu foarte importante.
A: – Deci, plănuiești să menții patch-ul tău și se poate instala liniștit în producție, primind mai departe actualizări într-un fel?
MM: – Recomandăm cu tărie. Acest lucru ne rezolvă foarte multe probleme.
MC: – Aș dori să subliniez încă o dată că modificările care nu țin de arhitectură și nu implică blocaje sau cozi sunt modulare, ele pot fi gestionate în module separate. Chiar și pentru modificări minore, acestea pot fi întreținute destul de ușor.
MM: – Dacă te interesează detaliile, „ClickHouse” utilizează așa numita bibliotecă a istoricului. Aceasta este decuplată – este o copie a suportului pentru „Elasticsearch”, adică poate fi modificată prin configurație. Polling-ul schimbă doar pollerii. Considerăm că va funcționa mult timp.
A: – Mulțumesc mult. Îmi poți spune dacă există vreo documentație a modificărilor efectuate?
MM: – Documentația este un patch. Evident, odată cu introducerea „ClickHouse”, apar noi opțiuni de configurare cu noi tipuri de polleri. La linkul din ultima diapozitiv este o descriere scurtă despre cum să folosești asta.
Despre înlocuirea fping cu nmap
A: – Cum ați implementat aceasta? Poți da exemple concrete: aveți strappers și un script extern? Ce verifică atât de repede o cantitate atât de mare de hosts? Cum obțineți acești hosts? Trebuie să-i alimentați pe nmap, să-i obțineți cumva, să-i plasați, să rulați ceva?
MM: – Super. O întrebare foarte corectă! Esența este aceasta. Am modificat biblioteca (ICMP ping, parte a „Zabbix”) pentru verificările ICMP, în care este specificat numărul de pachete – o unitate (1), iar codul încearcă să folosească nmap. Asta înseamnă că este o muncă internă a „Zabbix”, a devenit o muncă internă a ping-erului. Prin urmare, nu este necesară sincronizarea sau utilizarea trapper-ului. Acest lucru a fost făcut conștient pentru a menține sistemul integru și a nu ne preocupa de sincronizarea a două sisteme de baze: ce să verificăm, să încarcăm prin polling, și dacă nu s-a stricat încarcăciunea?... Este mult mai simplu.
A: – Funcționează și pentru proxy-uri?
MM: – Da, dar nu am verificat. Codul de polling este același în „Zabbix” și pe server. Ar trebui să funcționeze. Reiterez: performanța sistemului este astfel încât nu avem nevoie de proxy.
MC: – Răspunsul corect la întrebare este: „De ce aveți nevoie de proxy într-un astfel de sistem?” Numai din cauza NAT-ului sau pentru a monitoriza printr-un canal lent?
A: – Și folosiți „Zabbix” ca alertor, dacă am înțeles corect. Sau graficele (unde stratul arhivistic) le-ați mutat într-un alt sistem, cum ar fi Grafana? Sau nu folosiți această funcționalitate?
MM: – Reiterez că am realizat o integrare completă. Transferăm istoria în «ClickHouse», dar am modificat frontendul PHP. Frontendul PHP accesează «ClickHouse» și creează toate graficele de acolo. De fapt, avem o parte care generează date în alte sisteme de vizualizare grafică din aceleași date din «ClickHouse» și din «Zabbix».
MC: – Inclusiv în «Grafana».
Cum a fost luată decizia de a aloca resurse?
A: – Împărtășiți-ne puțin din culisele interne. Cum a fost luată decizia că este necesar să alocăm resurse pentru o reproiectare serioasă a produsului? Acest lucru, în general, implică anumite riscuri. Și vă rog, în contextul în care doriți să susțineți versiuni noi: cum este justificată această decizie din perspectiva managementului?
MM: – Se pare că narațiunea noastră nu a fost foarte bine spusă. Ne-am aflat într-o situație în care trebuia să facem ceva și am mers în esență cu două echipe paralele:
- Una s-a ocupat de lansarea sistemului de monitorizare pe noi metode: monitorizare ca serviciu, un set standard de soluții open-source pe care le combinăm și apoi încercăm să schimbăm procesele de afaceri pentru a lucra cu noul sistem de monitorizare.
- În paralel, am avut un programator entuziast care s-a ocupat de acest lucru (vorbind despre sine). Așa s-a întâmplat că el a câștigat.
A: – Și care este dimensiunea echipei?
MC: – Ei sunt în fața dumneavoastră.
A: – Deci, ca de obicei, este nevoie de un pasionar?
MM: – Nu știu ce înseamnă pasionar.
A: – În acest caz, probabil, sunteți dumneavoastră. Vă mulțumim mult, sunteți grozavi.
MM: – Mulțumesc.
Despre patch-uri pentru Zabbix
A: – Pentru un sistem care folosește proxy (de exemplu, în anumite sisteme distribuite), este posibil să adaptați soluția dumneavoastră și să patch-uiți, să zicem, pollerele, proxy-urile și parțial preprocesorul propriu-zis al «Zabbix»-ului; și interacțiunea lor? Este posibil să optimizați soluțiile existente pentru un sistem cu mai multe proxy-uri?
MM: – Știu că serverul «Zabbix» este construit cu ajutorul proxy-urilor (se compilează și rezultă un cod). Nu am verificat acest lucru în producție. Nu sunt sigur de aceasta, dar, din câte știu, preprocesorul-manager nu este folosit în proxy. Sarcina proxy-ului este de a prelua un set de metrici din «Zabbix», a le einternaliza (scrie de asemenea configurația, baza de date locală) și a le trimite înapoi serverului «Zabbix». Preprocesarea va fi realizată ulterior de serverul însuși, atunci când le va primi.
Interesul pentru proxy este evident. Vom verifica asta. Este o temă interesantă.
A: – Ideea era aceasta: dacă putem patch-ui pollere, putem patch-ui pe proxy și adapta interacțiunea cu serverul, iar preprocesorul pentru aceste scopuri să fie adaptat doar pe server.
MM: – Cred că este chiar mai simplu. Luați codul, aplicați patch-ul, apoi configurați-l așa cum aveți nevoie – construiți proxy-uri (de exemplu, cu ODBC) și distribuiți codul patch-uit în sisteme. Acolo unde e nevoie – construiți proxy, unde e nevoie – server.
A: – Nu va fi necesar să patch-uiți suplimentar transferul proxy către server, cel mai probabil?
MC: – Nu, este standard.
MM: – De fapt, nu a fost menționată una dintre idei. Am respectat întotdeauna un echilibru între explozia ideilor și numărul de modificări, ușurința de suport.
Puțin publicitate 🙂
Mulțumim că rămâneți cu noi. Vă plac articolele noastre? Doriți să vedeți mai multe materiale interesante? Susțineți-ne, efectuând o comandă sau recomandându-ne prietenilor, , un echivalent unic pentru serverele entry-level, care a fost creat de noi pentru voi: (sunt disponibile opțiuni cu RAID1 și RAID10, până la 24 nuclee și până la 40GB DDR4).
Dell R730xd la jumătate de preț în centrul de date Equinix Tier IV din Amsterdam? Numai la noi în Olanda! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — de la 99 $! Citiți despre
Sursa: habr.com
