

În pragul lansării unui nou curs am pregătit traducerea unui material interesant.
Prezentare generală
Vom discuta despre un pattern destul de popular, prin care aplicațiile utilizează mai multe stocări de date, fiecare dintre acestea având scopuri specifice, de exemplu, pentru stocarea formei canonice a datelor (MySQL etc.), asigurarea unor capacități extinse de căutare (ElasticSearch etc.), caching (Memcached etc.) și altele. De obicei, atunci când se folosesc mai multe stocări de date, una dintre ele funcționează ca stocare principală, iar celelalte ca stocări derivate. Problema unică constă în modul de sincronizare a acestor stocări de date.
Am analizat o serie de patternuri diferite care au încercat să rezolve problema sincronizării mai multor stocări, cum ar fi scrierea dublă, tranzacțiile distribuite etc. Cu toate acestea, aceste abordări au limitări semnificative în ceea ce privește utilizarea în viața reală, fiabilitatea și întreținerea tehnică. Pe lângă sincronizarea datelor, unele aplicații trebuie, de asemenea, să îmbogățească datele, apelând la servicii externe.
Pentru a rezolva aceste probleme, a fost dezvoltat Delta. Delta reprezintă, în cele din urmă, o platformă coerentă, gestionată de evenimente pentru sincronizarea și îmbogățirea datelor.
Soluțiile existente
Scrierea dublă
Pentru a sincroniza două stocări de date, se poate utiliza scrierea dublă, care efectuează o scriere într-o stocare, apoi imediat după aceea face o scriere în cealaltă. Prima scriere poate fi repetată, iar a doua poate fi întreruptă, dacă prima eșuează după o anumită număr de încercări. Cu toate acestea, cele două stocări de date pot înceta să se sincronizeze dacă scrierea în a doua stocare eșuează. Această problemă este de obicei rezolvată prin crearea unei proceduri de recuperare, care poate relua periodic datele din prima stocare în a doua sau o face doar dacă se descoperă diferențe în date.
Probleme:
Executarea procedurii de restaurare este o muncă specifică, care nu poate fi reutilizată. În plus, datele între stocuri rămân nesincronizate până când procedura de restaurare este finalizată. Soluția devine mai complicată dacă se utilizează mai mult de două stocuri de date. Și, în cele din urmă, procedura de restaurare poate adăuga o sarcină suplimentară pe sursa inițială de date.
Tabelul apelurilor de modificare
Când se produc modificări în setul de tabele (de exemplu, inserarea, actualizarea și ștergerea înregistrărilor), înregistrările de modificare sunt adăugate în tabelul apelurilor de modificare, ca parte a aceleași tranzacții. Un alt fir sau proces solicită constant evenimente din tabelul apelurilor de modificare și le scrie într-unul sau mai multe stocuri de date, ștergând evenimentele din tabelul apelurilor de modificare după confirmarea înregistrării de către toate stocurile.
Probleme:
Acest pattern ar trebui să fie implementat ca o bibliotecă și, ideal, fără a modifica codul aplicației care o folosește. Într-un mediu poliglot, implementarea unei astfel de biblioteci ar trebui să existe în orice limbaj necesar, dar asigurarea consistenței funcțiilor și comportamentului între limbaje este foarte complicată.
O altă problemă constă în obținerea modificărilor schemei, în sistemele care nu suportă modificările tranzacționale ale schemei [1][2], cum ar fi MySQL. Prin urmare, șablonul pentru execuția modificării (de exemplu, modificarea schemei) și înregistrarea tranzacțională a acesteia în tabelul apelurilor de modificare nu va funcționa întotdeauna.
Tranzacții Distribuite
Tranzacțiile distribuite pot fi utilizate pentru a separa o tranzacție între mai multe stocuri de date heterogene, astfel încât operația să fie fie înregistrată în toate stocurile folosite, fie să nu fie înregistrată în niciunul dintre ele.
Probleme:
Transacțiile distribuite reprezintă o problemă foarte mare pentru stocările de date eterogene. Prin natura lor, acestea se pot baza doar pe cel mai mic numitor comun al sistemelor participante. De exemplu, tranzacțiile XA blochează executarea dacă un eșec apare în timpul aplicației în etapa de pregătire. În plus, XA nu oferă detectarea blocajelor și nu susține schemele optimiste de gestionare a paralelismului. În plus, unele sisteme, cum ar fi ElasticSearch, nu acceptă XA sau orice alt model heterogen de tranzacții. Astfel, asigurarea atomicității scrierii în diverse tehnologii de stocare a datelor rămâne o sarcină destul de complexă pentru aplicații [3].
Delta
Delta a fost dezvoltată pentru a elimina restricțiile soluțiilor existente de sincronizare a datelor, de asemenea, permite îmbogățirea datelor în timp real. Obiectivul nostru a fost să abstrahem toate aceste aspecte complexe de dezvoltatorii de aplicații, astfel încât aceștia să se poată concentra pe realizarea funcționalităților de business. În continuare, vom descrie „Căutarea filmelor”, un caz de utilizare real al Delta de la Netflix.
Netflix utilizează pe scară largă arhitectura de microservicii, iar fiecare microserviciu gestionează de obicei un singur tip de date. Informațiile de bază despre film sunt extrase într-un microserviciu numit Movie Service, iar datele asociate, cum ar fi informațiile despre producători, actori, furnizori și așa mai departe, sunt gestionate de mai multe alte microservicii (anume Deal Service, Talent Service și Vendor Service).
Utilizatorii de business din Netflix Studios au adesea nevoie să caute filme pe baza diverselor criterii, de aceea este foarte important pentru ei să aibă posibilitatea de a căuta toate datele legate de filme.
Înainte de Delta, echipa de căutare a filmelor trebuia să obțină date din mai multe microservicii înainte de a indexa datele filmelor. În plus, echipa trebuia să dezvolte un sistem care să actualizeze periodic indexul de căutare, solicitând modificări de la alte microservicii, chiar și în absența modificărilor. Acest sistem s-a complicat foarte repede și a devenit dificil de menținut.
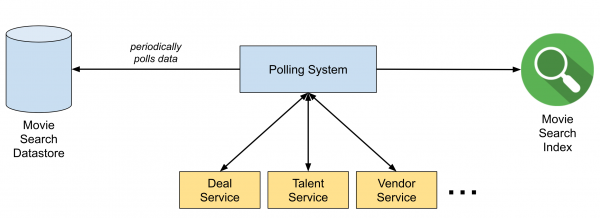
Figura 1. Sistemul de polling înainte de Delta
După începerea utilizării Delta, sistemul a fost simplificat la un sistem bazat pe evenimente, așa cum este arătat în figura următoare. Evenimentele CDC (Change-Data-Capture) sunt trimise în topicurile Keystone Kafka prin intermediul Delta-Connector. Aplicația Delta, construită folosind Delta Stream Processing Framework (bazat pe Flink), primește evenimentele CDC din topic, le îmbogățește, invocând alte microservicii, și, în final, transmite datele îmbogățite în indexul de căutare din Elasticsearch. Întreaga procesare se desfășoară aproape în timp real, adică, deîndată ce modificările sunt înregistrate în stocarea de date, indexurile de căutare se actualizează.
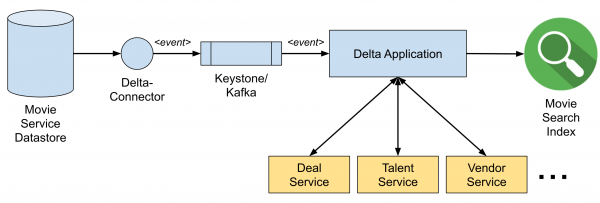
Figura 2. Pipeline-ul de date cu Delta
În secțiunile următoare, vom descrie funcționarea Delta-Connector, care se conectează la stocare și publică evenimentele CDC la nivelul de transport, care reprezintă infrastructura de transmisie a datelor în timp real, direcționând evenimentele CDC către topicurile Kafka. La final, vom discuta despre structura procesării fluxurilor Delta, pe care dezvoltatorii de aplicații o pot folosi pentru logica de procesare și îmbogățire a datelor.
CDC (Change-Data-Capture)
Am dezvoltat un serviciu CDC numit Delta-Connector, care poate înregistra modificările comise din stocarea de date în timp real și le scrie într-un flux. Modificările în timp real sunt preluate din jurnalul de tranzacții și din dump-urile stocării. Dump-urile sunt utilizate deoarece jurnalele de tranzacții de obicei nu păstrează toată istoricul modificărilor. Modificările sunt de obicei serializate ca evenimente Delta, astfel încât receptorul să nu fie nevoit să se îngrijoreze de sursa modificării.
Delta-Connector suportă câteva funcții suplimentare, cum ar fi:
- Capacitatea de a scrie în date de ieșire personalizate fără Kafka.
- Capacitatea de a activa dump-uri manuale în orice moment pentru toate tabelele, pentru o anumită tabelă sau pentru anumite chei primare.
- Dump-urile pot fi preluate în bucăți, deci nu este necesar să începem totul de la început în cazul unei erori.
- Nu este necesară blocarea tabelelor, ceea ce este foarte important pentru ca traficul de scriere în baza de date să nu fie niciodată blocat de serviciul nostru.
- Disponibilitate ridicată datorită replicatelor de rezervă în AWS Availability Zones.
În prezent, suportăm MySQL și Postgres, inclusiv la desfășurarea în AWS RDS și Aurora. De asemenea, suportăm Cassandra (multi-master). Mai multe detalii despre Delta-Connector puteți afla în acest .
Kafka și nivelul de transport
Nivelul de transport al evenimentelor Delta este construit pe serviciul de mesagerie al platformei .
Istoric, publicarea mesajelor în Netflix a fost optimizată pentru a spori disponibilitatea, nu durabilitatea (vezi ). Compromisul a fost o potențială nepotrivire a datelor brokerului în diverse scenarii marginale. De exemplu, unclean leader election responsabil pentru faptul că destinatarul poate dubla sau pierde evenimente.
Cu Delta, ne-am dorit să obținem garanții mai puternice de durabilitate pentru a asigura livrarea evenimentelor CDC către depozitele derivate. Pentru aceasta, am propus un cluster Kafka proiectat special ca obiect de primă clasă. Puteți consulta unele configurații ale brokerului în tabelul de mai jos:
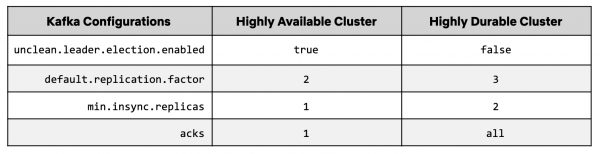
În clusterele Keystone Kafka, unclean leader election de obicei, este activat pentru a asigura disponibilitatea editorului. Acest lucru poate duce la pierderea mesajelor în cazul în care o replică nesincronizată este aleasă ca lider. Pentru un nou cluster Kafka de înaltă fiabilitate, parametrul unclean leader election este dezactivat, pentru a preveni pierderea mesajelor.
De asemenea, am crescut factorul de replicare de la 2 la 3 și replicile minime în sincronizare de la 1 la 2. Publicatorii care scriu în acest cluster cer acks de la toate celelalte, garantând că 2 din 3 replici vor avea cele mai recente mesaje trimise de publicator.
Când o instanță broker se închide, o nouă instanță o înlocuiește pe cea veche. Cu toate acestea, noul broker va trebui să recupereze replicile nesincronizate, ceea ce poate dura câteva ore. Pentru a reduce timpul de recuperare al acestui scenariu, am început să folosim stocarea de blocuri de date (Amazon Elastic Block Store) în loc de discurile locale ale brokerilor. Atunci când o nouă instanță înlocuiește instanța brokerului închis, aceasta se alătură volumului EBS, care a fost al instanței închise, și începe să recupereze mesajele noi. Acest proces reduce timpul de eliminare a întârzierii de la câteva ore la câteva minute, deoarece noii brokeri nu mai trebuie să reproducă dintr-o stare goală. În general, ciclurile de viață separate ale stocării și brokerului reduc semnificativ impactul efectului de schimbare a brokerului.
Pentru a crește și mai mult garanția livrării datelor, am folosit pentru a detecta orice pierdere de mesaje în condiții extreme (de exemplu, desincronizarea ceasurilor în liderul secțiunii).
Stream Processing Framework
Nivelul de procesare din Delta este construit pe baza platformei Netflix SPaaS, care asigură integrarea Apache Flink cu ecosistemul Netflix. Platforma oferă o interfață utilizator care gestionează desfășurarea sarcinilor Flink și orchestrarea clusterelor Flink deasupra platformei noastre de gestionare a containerelor Titus. Interfața gestionează, de asemenea, configurațiile sarcinilor și permite utilizatorilor să facă modificări în configurație dinamic, fără a fi nevoie să recompilieze sarcinile Flink.
Delta oferă un cadru de procesare a fluxurilor de date bazat pe Flink și SPaaS, care utilizează un DSL (Domain Specific Language) bazat pe anotații, pentru a abstractiza detaliile tehnice. De exemplu, pentru a defini pasul cu care vor fi îmbogățite evenimentele, apelând servicii externe, utilizatorii trebuie să scrie următorul DSL, iar cadrul va crea pe baza lui un model care va fi executat de Flink. Figura 3. Exemplu de îmbogățire folosind DSL în Delta
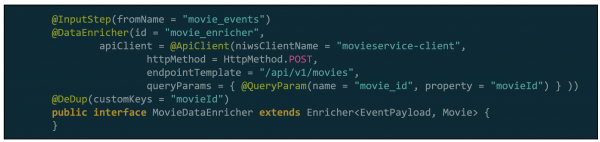
Cadrul de procesare nu doar că reduce curba de învățare, dar oferă și funcții comune de procesare a fluxului, cum ar fi deduplicarea, schematizarea, precum și flexibilitate și reziliență pentru a rezolva problemele comune în operare.
Framework-ul de procesare nu doar că reduce curba de învățare, dar oferă și funcții comune de procesare a fluxului, cum ar fi deduplicarea, schematizarea, precum și flexibilitate și reziliență pentru a rezolva problemele comune în activitate.
Delta Stream Processing Framework este compus din două module cheie, modulul DSL & API și modulul Runtime. Modulul DSL & API oferă DSL și UDF (User-Defined Function) API, astfel încât utilizatorii să poată scrie propria logică de procesare (de exemplu, filtrare sau transformări). Modulul Runtime oferă o implementare a parser-ului DSL, care construiește o reprezentare internă a pașilor de procesare în modele DAG. Componenta Execution interpretează modelele DAG pentru a inițializa operatorii Flink efectivi și, în cele din urmă, pentru a lansa aplicația Flink. Arhitectura framework-ului este ilustrată în figura următoare.
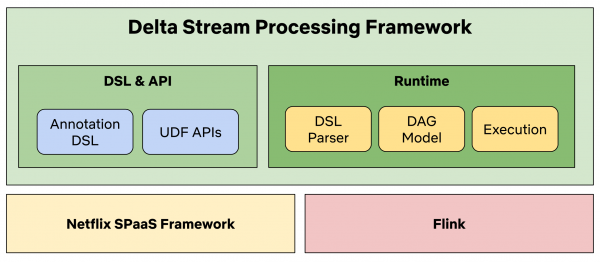
Figura 4. Arhitectura Delta Stream Processing Framework
Această abordare are mai multe avantaje:
- Utilizatorii se pot concentra pe logica de afaceri fără a fi necesar să se aprofundeze în specificul Flink sau în structura SPaaS.
- Optimizarea poate fi efectuată într-un mod transparent pentru utilizatori, iar erorile pot fi corectate fără a necesita modificări ale codului utilizatorului (UDF).
- Funcționarea aplicațiilor Delta este simplificată pentru utilizatori, deoarece platforma oferă flexibilitate și reziliență din sistem și colectează o mulțime de metrici detaliate care pot fi utilizate pentru alerte.
Utilizarea în producție
Delta funcționează în producție de mai bine de un an și joacă un rol cheie în multe aplicații Netflix Studio. A ajutat echipele să implementeze cazuri de utilizare precum indexarea căutărilor, stocarea datelor și fluxurile de lucru gestionate prin evenimente. Mai jos este prezentat un rezumat al arhitecturii de nivel înalt a platformei Delta.
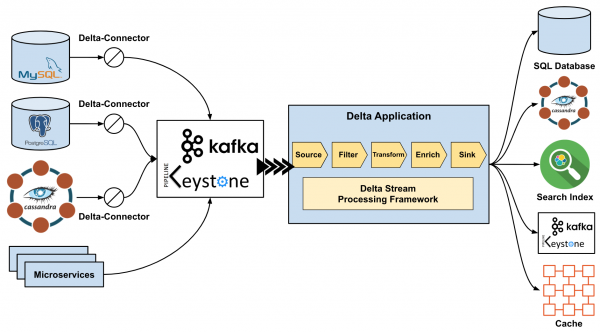
Figura 5. Arhitectura de nivel înalt a Delta.
Mulțumiri
Dorim să le mulțumim următorilor oameni care au participat la crearea și dezvoltarea Delta la Netflix: Allen Wang, Charles Zhao, Jaebin Yoon, Josh Snyder, Kasturi Chatterjee, Mark Cho, Olof Johansson, Piyush Goyal, Prashanth Ramdas, Raghuram Onti Srinivasan, Sandeep Gupta, Steven Wu, Tharanga Gamaethige, Yun Wang și Zhenzhong Xu.
Surse
- Martin Kleppmann, Alastair R. Beresford, Boerge Svingen: Online event processing. Commun. ACM 62(5): 43–49 (2019). DOI:
: „Data Build Tool pentru stocarea Amazon Redshift”.
Sursa: habr.com
