

Următoarea conferință HighLoad++ va avea loc pe 6 și 7 aprilie 2020 în Sankt Petersburg.
Detalii și bilete . HighLoad++ Siberia 2019. Sala „Krasnoyarsk”. 25 iunie, 12:00. Teze și .
Se întâmplă ca cerințele practice să intre în conflict cu teoria, unde nu sunt luate în considerare aspecte importante pentru un produs comercial. În această prezentare este prezentat procesul de selecție și combinare a diferitelor abordări pentru crearea componentelor Causal consistency, bazat pe cercetări academice, în funcție de cerințele unui produs comercial. Ascultătorii vor afla despre abordările teoretice existente pentru logical clocks, dependency tracking, system security, clock synchronization și de ce MongoDB a optat pentru anumite soluții.
Mikhail Tyulenyev (în continuare – MT): – Voi vorbi despre Causal consistency – este o caracteristică pe care am dezvoltat-o în MongoDB. Lucrez în grupul de sisteme distribuite, am realizat-o acum aproximativ doi ani.
În proces, a fost necesar să ne familiarizăm cu o cantitate mare de cercetări academice, deoarece această caracteristică este destul de bine studiată. S-a constatat că niciun articol nu se potrivește perfect cu ceea ce este necesar în producție, așa cum baza de date are cerințe destul de specifice care sunt, cred, valabile pentru orice aplicație de producție.
Voi vorbi despre cum, fiind consumatori ai cercetării academice, pregătim din aceasta ceva ce putem oferi utilizatorilor noștri ca un fel de preparat gata, de care este ușor și sigur de folosit.
Causal consistency. Să stabilim conceptele
Pentru început, vreau să spun, în linii mari, ce este Causal consistency. Sunt două personaje – Leonard și Penny (serialul „Teoria Big Bang”):
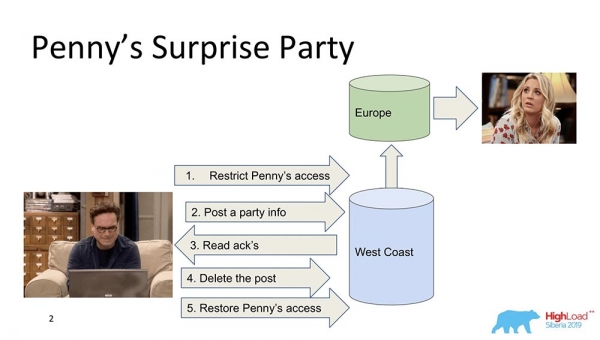
Să presupunem că Penny se află în Europa, iar Leonard vrea să-i facă o surpriză, o petrecere. Și el nu găsește altceva mai bun decât să o scoată din lista de prieteni, să trimită tuturor prietenilor o actualizare pe feed: „Hai să o surprindem pe Penny!” (ea este în Europa, dormind, nu vede nimic din toate acestea și nu poate vedea, pentru că nu este acolo). Într-un moment final, șterge această postare, o elimină din „Feed” și restabilește accesul, astfel încât ea să nu observe nimic și să nu fie un scandal.
Este totul foarte frumos, dar să presupunem că sistemul este distribuit și evenimentele nu au decurs exact așa. Poate, de exemplu, să se întâmple ca restricția access a lui Penny să fi avut loc după ce acest post a apărut, dacă evenimentele nu sunt legate între ele prin relații cauzale. În esență, acesta este un exemplu de când este necesară o consistență cauzală pentru a îndeplini o funcție de afaceri (în acest caz).
De fapt, acestea sunt proprietăți destul de netriviale ale bazelor de date – foarte puține dintre ele le susțin. Să trecem la modele.
Modelele de consistență (Consistency Models)
Ce este, de fapt, un model de consistență în bazele de date? Acesta sunt anumite garanții pe care un sistem distribuit le oferă cu privire la ce date și în ce ordine clientul poate obține.
Practic, toate modelele de consistență se reduc la cât de mult un sistem distribuit seamănă cu un sistem care funcționează, de exemplu, pe un singur nod pe un laptop. Și cât de mult un sistem care funcționează pe mii de "noduri" geo-distribuite seamănă cu laptopul în care toate aceste proprietăți sunt îndeplinite practic automat.
De aceea, modelele de consistență se aplică doar sistemelor distribuite. Toate sistemele care existau anterior și funcționau pe o scalare verticală nu întâmpinau astfel de probleme. Aveau un singur Buffer Cache și din el se citea întotdeauna totul.
Modelul Strong
Practic, cel mai vechi model este Strong (sau linia de rise ability, cum este adesea numit). Este un model de consistență care garantează că fiecare modificare, imediat ce se primește confirmarea că a avut loc, devine vizibilă pentru toți utilizatorii sistemului.
Acest lucru creează o ordine globală a tuturor evenimentelor în Baza de Date. Aceasta este o proprietate de consistență foarte puternică și, în general, foarte costisitoare. Totuși, este foarte bine susținută. Este pur și simplu foarte costisitoare și lentă – folosită rar. Se numește rise ability.
Există o altă proprietate, mai puternică, care este susținută în „Spanner” – numită Consistență Externă. Vom vorbi despre ea puțin mai târziu.
Causal
Următoarele sunt Causal, exact despre ce vorbeam. Între Strong și Causal există încă câteva subniveluri despre care nu voi discuta, dar toate se reduc la Causal. Este un model important, deoarece este cel mai puternic dintre toate modelele, cea mai puternică consistență în prezența unei rețele sau a partitionării.
Causal este situația în care evenimentele sunt legate printr-o relație de cauzalitate. Adesea, acestea sunt percepute ca Read your rights din perspectiva clientului. Dacă clientul a observat anumite valori, el nu poate vedea valorile care au fost în trecut. Încep să observe citirile prefixed. Totul se reduce la același lucru.
Causal ca model de consistență reprezintă o ordonare parțială a evenimentelor pe server, în care evenimentele din toate clienții sunt observate în aceeași secvență. În acest caz – Leonard și Penny.
Eventual
Al treilea model este Eventual Consistency. Acesta este ceea ce susține toate sistemele distribuite, modelul minim care are sens. Aceasta înseamnă următoarele: atunci când avem anumite modificări în date, ele devin consistente la un moment dat.
În acel moment, nu spune nimic, altfel ar deveni External Consistency – ar fi o poveste complet diferită. Cu toate acestea, este un model foarte popular, cel mai răspândit. În mod implicit, toți utilizatorii sistemelor distribuite utilizează Eventual Consistency.
Vreau să aduc câteva exemple comparative:
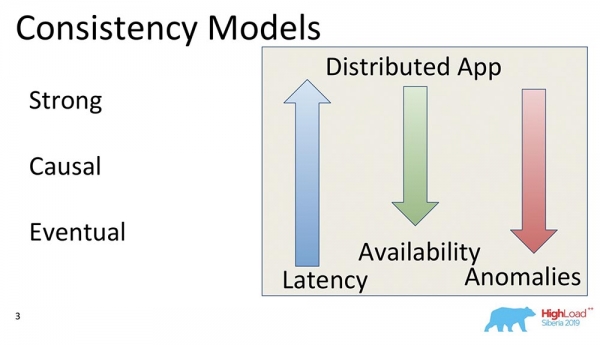
Ce înseamnă săgețile acestea?
- Latencă. Pe măsură ce puterea consistenței crește, aceasta devine mai mare din motive evidente: trebuie să facem mai multe înregistrări, să primim confirmări de la toate gazdele și nodurile implicate în cluster, că datele sunt deja acolo. Prin urmare, în Eventual Consistency, răspunsul este cel mai rapid, deoarece de obicei se poate chiar comite în memorie și acest lucru ar fi suficient.
- Disponibilitate. Dacă înțelegem asta ca pe capacitatea sistemului de a răspunde în cazul întreruperilor de rețea, partitionări sau diverse defecțiuni – reziliența crește odată cu reducerea modelului de consistență, deoarece este suficient să existe o gazdă activă care să ofere anumite date. Eventual Consistency nu garantează nimic în legătură cu datele – acestea pot fi orice.
- Anomalii. În acest context, cu siguranță, numărul anomaliilor crește. În cazul Consistenței Puternice, acestea ar trebui să fie practic inexistente, în timp ce în Consistența Finală, ele pot apărea în diverse forme. Se ridică întrebarea: de ce aleg oamenii Consistența Finală, dacă aceasta conține anomalii? Răspunsul este că modelele de Consistență Finală sunt aplicabile, iar anomaliile există, de exemplu, pentru o scurtă perioadă de timp; există posibilitatea de a folosi un master pentru citire și a citi date consistente mai mult sau mai puțin; adesea există posibilitatea de a utiliza modele puternice de consistență. Practic, acest lucru funcționează, iar de multe ori numărul anomaliilor este limitat în timp.
Teorema CAP
Când auzi cuvintele consistență, disponibilitate - ce îți vine în minte? Corect - Teorema CAP! Acum vreau să demontez un mit… Nu sunt eu, ci Martin Kleppmann, care a scris un articol minunat, o carte minunată.
Teorema CAP este un principiu formulat în anii 2000, referitor la Consistență, Disponibilitate, Partiții: ia oricare două, iar nu poți alege trei. A fost un principiu general. A fost dovedit ca teoremă câțiva ani mai târziu, de către Gilbert și Lynch. Apoi a început să fie folosit ca o mantră - sistemele au început să se împartă în CA, CP, AP și așa mai departe.
Această teoremă a fost dovedită de fapt în următoarele cazuri… În primul rând, Disponibilitatea nu a fost considerată ca o valoare continuă de la zero la o sută (0 - sistemul este «mort», 100 - răspunde rapid; așa suntem obișnuiți să o considerăm), ci ca o proprietate a algoritmului care garantează că în toate execuțiile sale, acesta returnează date.
Nu există nicio mențiune despre timpul de răspuns! Există un algoritm care returnează date după 100 de ani - un algoritm disponibil complet splendid, care face parte din teorema CAP.
În al doilea rând: teorema a fost dovedită pentru modificările valorilor aceleași chei, sub condția că aceste modificări sunt o linie redimensionabilă. Aceasta înseamnă că, de fapt, ele sunt practic inutilizate, deoarece modelele sunt diferite: Consistența Finală, Consistența Puternică (posibil).
Cu ce se termină toată asta? Cu faptul că teorema CAP, exact în forma în care a fost dovedită, este practic inapplicabilă, utilizată rar. În forma teoretică, somehow restricționează totul. Rezultă un principiu, care este intuitiv adevărat, dar nici cum, în general, nu este dovedit.
Consistența cauzală este cel mai puternic model
Ceea ce se întâmplă acum este că poți obține toate cele trei lucruri: Consistență, Disponibilitate prin intermediul Partitions. În special, consistența cauzală – este cea mai puternică model de consistență, care funcționează chiar și în prezența partition-urilor (discontinuări în rețea). De aceea reprezintă un interes atât de mare, de aceea ne ocupăm de ea.
În primul rând, simplifică munca dezvoltatorilor de aplicații. În special, există un suport mare din partea serverului: când toate înregistrările care se efectuează în cadrul unui client ajung garantat în aceeași ordine la celălalt client. În al doilea rând, rezistă partition-urilor.
Bucătăria internă a MongoDB
Ținând cont de faptul că este prânz, ne mutăm în bucătărie. Voi vorbi despre modelul sistemului, și anume – ce este MongoDB pentru cei care aud pentru prima dată despre o astfel de bază de date.
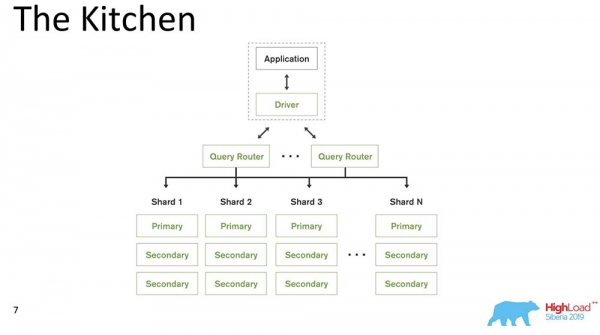
MongoDB (denumită în continuare «MongoDB») este un sistem distribuit care suportă scalarea orizontală, adică sharding; și în interiorul fiecărui shard, de asemenea, suportă redundanța datelor, adică replicarea.
Sharding-ul în «MongoDB» (o bază de date non-relațională) efectuează o echilibrare automată, adică fiecare colecție de documente (sau «tabel» în termeni de date relaționale) este împărțită în bucăți, iar serverul le mută automat între shard-uri.
Query Router, care distribuie cererile, este un fel de client pentru client, prin care interacționează. Acesta deja știe unde și ce date se află, îndreptând toate cererile către shard-ul corect.
Un alt aspect important: MongoDB este un singur master. Există un Primary – acesta poate prelua înregistrări care susțin cheile pe care le conține. Nu se poate face scriere multi-master.
Am lansat versiunea 4.2 – au apărut lucruri noi și interesante. În special, am integrat Lucene – căutare – difuzând direct java executabil pe «Mongo», și acum este posibil să efectuezi căutări prin Lucene, la fel ca în «Elastic».
Și am creat un produs nou – Charts, care este de asemenea disponibil pe «Atlas» (Cloud-ul propriu al „Mongo”). Au un Free Tier – poți experimenta cu acesta. Charts mi-a plăcut foarte mult – vizualizare de date, foarte intuitivă.
Ingredientele consistenței cauzale
Am numărat aproximativ 230 de articole care au fost publicate pe această temă – de Leslie Lampert. Acum, din memorie, vă voi transmite câteva părți din aceste materiale.
Totul a început cu un articol scris de Leslie Lampert în anii '70. După cum puteți observa, cercetările în acest domeniu continuă și astăzi. În prezent, coerența cauzală suscită interes datorită dezvoltării sistemelor distribuite.
Limitări
Ce limitări există? Acesta este, de fapt, unul dintre cele mai importante aspecte, deoarece limitele impuse de sistemele de producție sunt foarte diferite de cele menționate în articolele academice. Frecvent, acestea sunt destul de artificiale.
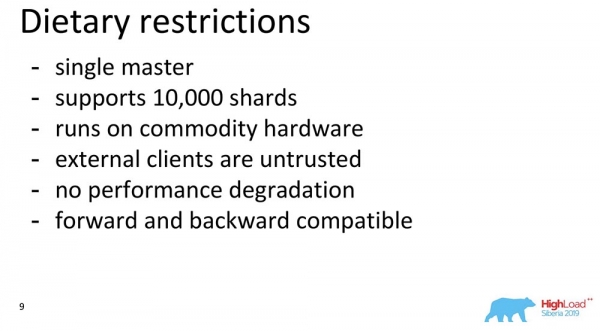
- În primul rând, MongoDB este un sistem cu master unic, după cum am menționat (acest lucru simplifică mult lucrurile).
- Considerăm că sistemul ar trebui să suporte aproximativ 10.000 de șarduri. Nu putem lua decizii arhitecturale care să limiteze clar această valoare.
- Avem un serviciu cloud, dar considerăm că utilizatorul ar trebui să aibă posibilitatea, atunci când descarcă binary-ul, să-l ruleze pe laptop-ul său și totul să funcționeze perfect.
- Ne așteptăm la ceea ce este rar utilizat în cercetare: clienții externi pot face orice. MongoDB este open-source. Prin urmare, clienții pot fi atât de inteligenți, dar și răi – ar putea dori să strice totul. Ne așteptăm la o apariție a 'trădătorilor bizantini'.
- Pentru clienții externi, care sunt în afara perimetrului, o limitare importantă este: dacă această funcționalitate este dezactivată, atunci nu ar trebui să existe nicio degradare a performanței observată.
- Un alt aspect – complet anti-academic: compatibilitatea versiunilor anterioare și viitoare. Driverele vechi ar trebui să suporte noile actualizări, iar baza de date ar trebui să suporte driverele vechi.
În general, toate acestea impun limitări.
Componentele coerenței cauzale
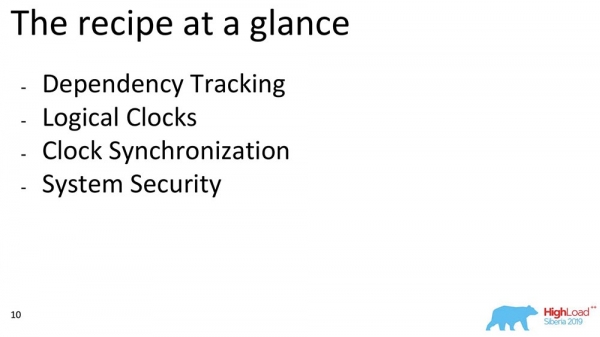
Acum voi vorbi despre câteva componente. Dacă luăm în considerare coerența cauzală în general, putem distinge blocuri. Am ales din lucrările care se referă la un anumit bloc: Urmărirea dependențelor, alegerea orelor, cum pot fi sincronizate aceste ore între ele și cum asigurăm securitatea – aceasta este o schiță aproximativă a ceea ce voi discuta:
Urmărirea completă a dependențelor
De ce este necesar? Pentru a se asigura că atunci când datele sunt replicate, fiecare înregistrare și fiecare modificare a datelor conțin informații despre ce modificări depind. Cea mai simplă și naivă modificare este când fiecare mesaj care conține o înregistrare, conține informații despre mesajele anterioare:
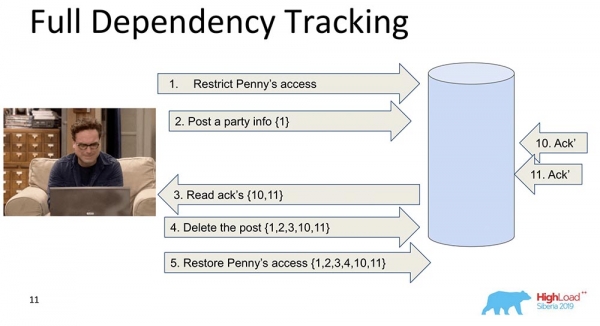
În acest exemplu, numărul din acolade reprezintă numerele înregistrărilor. Uneori, aceste înregistrări cu valori sunt transmise chiar în întregime, alteori sunt transmise anumite versiuni. Ideea este că fiecare modificare conține informații despre anterioara (de obicei le poartă în sine).
De ce am decis să nu folosim această abordare (urmărire completă)? Evident, deoarece această abordare este impracticabilă: orice modificare într-o rețea socială depinde de toate modificările anterioare în acea rețea, transmitând, să zicem, „Facebook” sau „Vkontakte” în fiecare actualizare. Cu toate acestea, există multe studii despre Full Dependency Tracking – aceste rețele sociale, pentru anumite situații, funcționează într-adevăr.
Urmărirea explicită a dependențelor (Explicit Dependency Tracking)
Următorul este mai restricționat. De asemenea, se analizează transmiterea informațiilor, dar doar a celor care depind în mod explicit. Ce depinde de ce, de obicei, este determinat deja de Aplicație. Când datele sunt replicate, la solicitate sunt oferite doar răspunsurile când dependențele anterioare au fost satisfăcute, adică au fost prezentate. Acesta este principiul conform căruia funcționează consistența cauzală.
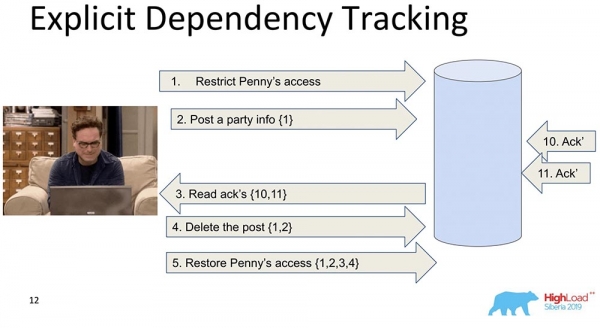
Ea vede că înregistrarea 5 depinde de înregistrările 1, 2, 3, 4 – prin urmare, așteaptă înainte ca clientul să aibă acces la modificările făcute de decizia de acces a Penny, când toate modificările anterioare au trecut deja în baza de date.
Aceasta ne deranjează, deoarece informația este tot prea multă și va încetini. Există o altă abordare…
Ceasurile lui Lamport (Lamport Clock)
Sunt foarte vechi. Ceasul Lamport presupune că aceste dependențe se reduc la o funcție scalară, care se numește Ceas Lamport.
Funcția scalară este un număr abstract. Adesea este numit timp logic. La fiecare eveniment, acest counter crește. Counter-ul cunoscut în prezent procesului trimite fiecare mesaj. Este clar că procesele pot fi desincronizate, având momente complet diferite. Totuși, printr-un asemenea schimb de mesaje, sistemul reușește cumva să echilibreze ceasurile. Ce se întâmplă în acest caz?
Am împărțit acel shard mare în două, pentru a fi clar: Friends pot trăi într-un nod care conține o parte din colecție, iar Feed – într-un nod complet diferit, care conține o porțiune din această colecție. Este clar cum pot să nu ajungă în coadă? Mai întâi, Feed va spune: „A fost replicat”, iar apoi – Friends. Dacă sistemul nu oferă anumite garanții că Feed-ul nu va fi afișat până când dependențele Friends din colecția Friends nu vor fi livrate, atunci avem exact situația despre care am menționat.
Vezi cum crește timpul logic al counter-ului pe Feed:
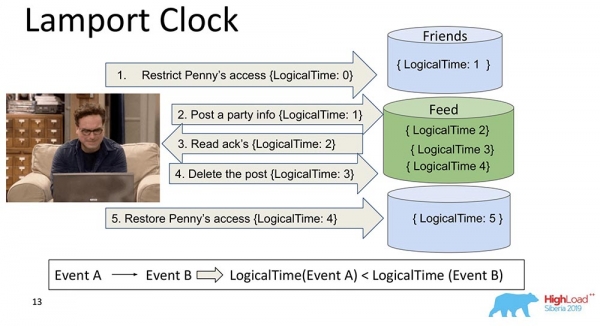
Astfel, proprietatea principală a acestui Ceas Lamport și a consistenței cauzale (explicată prin Ceas Lamport) este următoarea: dacă avem evenimentele A și B, iar evenimentul B depinde de evenimentul A *, atunci rezultă că LogicalTime al evenimentului A este mai mic decât LogicalTime al evenimentului B.
* Uneori se mai spune și că A a avut loc înainte de B, adică A s-a întâmplat înainte de B – aceasta este o relație care parțial ordonează întreaga multitudine de evenimente care au avut loc.
Inversa nu este adevărată. Aceasta este de fapt una dintre principalele dezavantaje ale Ceasului Lamport – ordinea parțială. Acolo există noțiunea de evenimente concomitente, adică evenimente în care nici (A a avut loc înainte de B), nici (A a avut loc după B). Un exemplu poate fi adăugarea simultană de către Leonard a cuiva pe lista de prieteni (chiar și nu de Leonard, ci de Sheldon, de exemplu).
Aceasta este proprietatea care este adesea utilizată când se lucrează cu ceasurile Lamport: se analizează exact funcția și de aici se concluzionează – poate că aceste evenimente depind. Pentru că în una dintre direcții este adevărat: dacă LogicalTime A este mai mic decât LogicalTime B, atunci B nu poate avea loc înainte de A; iar dacă este mai mare, atunci poate fi.
Ceasuri vectoriale (Vector Clock)
Evoluția logică a ceasurilor Lamport este ceasul vectorial. Acestea se disting prin faptul că fiecare nod prezent conține propriile ceasuri separate, care sunt transmise ca un vector.
În acest caz, observați că indexul zero al vectorului corespunde Feed-ului, iar primul index al vectorului corespunde Friends-ului (fiecare dintre aceste noduri). Și acum ele vor crește: indexul zero al «Feed-ului» crește cu 1, 2, 3.
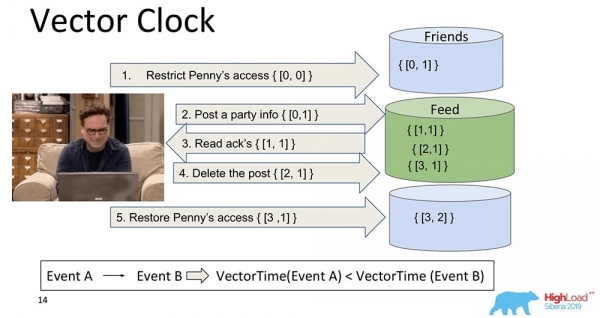
Ce avantaje au ceasurile vectoriale? Ele permit identificarea momentelor în care evenimentele sunt simultane și când acestea apar pe diferite noduri. Acest lucru este foarte important pentru sistemul de sharding, cum ar fi «MongoDB». Cu toate acestea, nu l-am ales, deși este o soluție excelentă, care funcționează bine și care ne-ar fi fost, probabil, utilă...
Dacă avem 10.000 de sharduri, nu putem transmite 10.000 de componente, chiar dacă comprimăm sau găsim alte soluții – totuși, încărcătura utilă va fi de câteva ori mai mică decât volumul întregului vector. Așadar, cu durere în suflet și cu dinții scrâșnind, am renunțat la această abordare și am trecut la alta.
Spanner TrueTime. Ceasuri atomice.
Am spus că va fi o poveste despre «Spanner». Este o soluție grozavă, direct din secolul XXI: ceasuri atomice, sincronizare GPS.
Care este ideea? «Spanner» este sistemul Google care recent a devenit disponibil și pentru oameni (l-au echipat cu SQL). Fiecare tranzacție are un timestamp. Deoarece timpul este sincronizat*, fiecărui eveniment i se poate atribui un anumit timp – ceasurile atomice au un timp de așteptare, după care timpul se schimbă garantat.
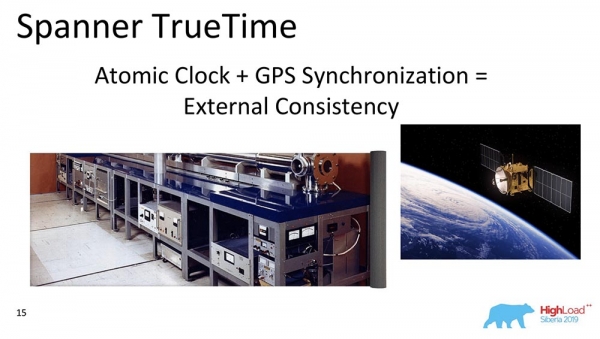
Astfel, pur și simplu înregistrând în baza de date și așteptând o anumită perioadă de timp, se garantează automat serializabilitatea evenimentului. Are cel mai puternic model de coerență, care poate fi imaginat – aceasta este coerența externă.
* Aceasta este principala problemă a ceasurilor Lamport – ele nu sunt niciodată sincronizate în sistemele distribuite. Ele pot diverge, chiar și în prezența NTP nu funcționează foarte bine. «Spanner» are ceasuri atomice și sincronizare, pare a fi de ordinul microsecundelor.
De ce nu l-am ales? Nu presupunem că utilizatorii noștri au ceasuri atomice integrate. Când vor deveni disponibile, fiind integrate în fiecare laptop, va exista o sincronizare GPS super avansată – atunci, da... Până atunci, ce este mai bun este «Amazon», stații de bază – pentru pasionați... Așadar, am folosit alte ceasuri.
Ceasuri hibride (Hybrid Clock)
Aceasta este, de fapt, ceea ce ticăie în „MongoDB” pentru a asigura consistența cauzală. În ce constă hibriditatea? Hibridul este o valoare scalară, dar aceasta constă din două componente:
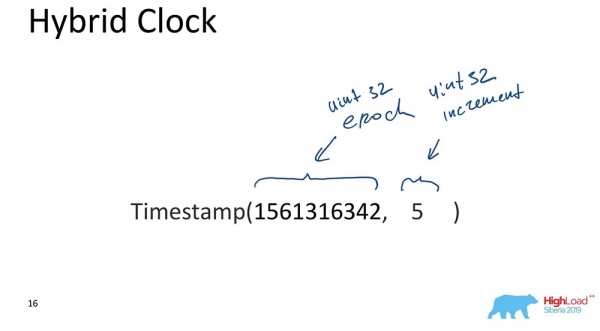
- Prima este epoca Unix (câte secunde au trecut de la „începutul lumii computerizate”).
- A doua este un anumit increment, tot un int nesemnat de 32 de biți.
Aceasta este, de fapt, tot. Există o abordare: partea care răspunde de timp este constant sincronizată cu ceasurile; de fiecare dată când are loc o actualizare, această parte se sincronizează cu ceasurile, iar rezultatul este că timpul este mereu mai mult sau mai puțin corect, iar incrementul permite deosebirea între evenimentele care au avut loc în același moment.
De ce este important pentru „MongoDB”? Pentru că permite realizarea unor backup-uri-restaurări la un anumit moment în timp, adică evenimentul este indexat în funcție de timp. Acest lucru este important atunci când sunt necesare anumite evenimente; pentru Baze de Date, evenimentele sunt modificările din Bază de Date care au avut loc în anumite intervale de timp.
Voi spune doar cea mai importantă cauză (vă rog, nu spuneți nimănui altcuiva)! Am făcut asta deoarece așa arată datele ordonate, indexate în MongoDB OpLog. OpLog-ul este o structură de date care conține absolut toate modificările din bază: acestea ajung întâi în OpLog, iar apoi sunt aplicate efectiv în Storage atunci când este vorba despre date replicate sau sharduite.
Aceasta a fost motivul principal. Totuși, există și cerințe practice pentru dezvoltarea bazei, ceea ce înseamnă că trebuie să fie simplu – cât mai puțin cod, cât mai puține lucruri care trebuie rescrise și testate. Faptul că op-log-urile noastre au fost indexate cu ceasuri hibride a ajutat foarte mult și a permis o alegere corectă. A fost într-adevăr justificat și a funcționat magic, în primul prototip. A fost super tare!
Sincronizarea ceasurilor
Există mai multe metode de sincronizare descrise în literatura de specialitate. Vorbesc despre sincronizare atunci când avem două sharde diferite. Dacă avem un replica set, atunci nu este necesară nicio sincronizare: este un «singl-master»; avem un OpLog în care toate modificările sunt înregistrate – în acest caz, totul este deja ordonat secvențial în «OpLog». Dar dacă avem două sharde diferite, sincronizarea timpului devine importantă. Aici, ceasurile vectoriale au ajutat mai mult! Dar nu le avem.
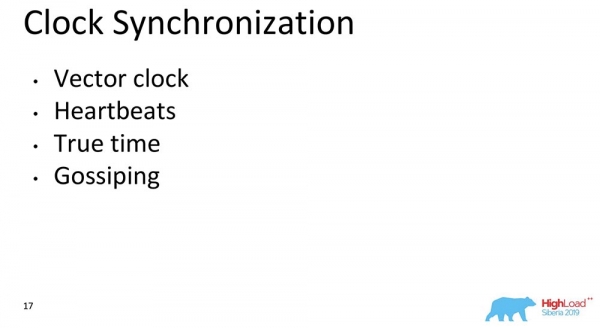
Al doilea mod este «Heartbeats». Se pot schimba unele semnale care apar la fiecare unitate de timp. Dar «Heartbeats» sunt prea lente, nu putem asigura latența dorită clientului nostru.
Timpul adevărat – desigur, este o idee minunată. Dar, din nou, cred că este, probabil, viitorul… Deși în «Atlas» este deja posibil, există deja sincronizatoare rapide de timp «amazoniste». Dar nu vor fi disponibile pentru toată lumea.
Gossiping – aceasta este atunci când toate mesajele includ timpul. Este cam ceea ce folosim noi. Fiecare mesaj între noduri, driver, router date noduri, absolut tot pentru «MongoDB» – sunt anumite elemente, componente ale bazei de date, care conțin ceasuri care curg. Toate au o valoare a timpului hibrid, care este transmisă. 64 de biți? Este permis, este posibil.
Cum funcționează totul împreună?
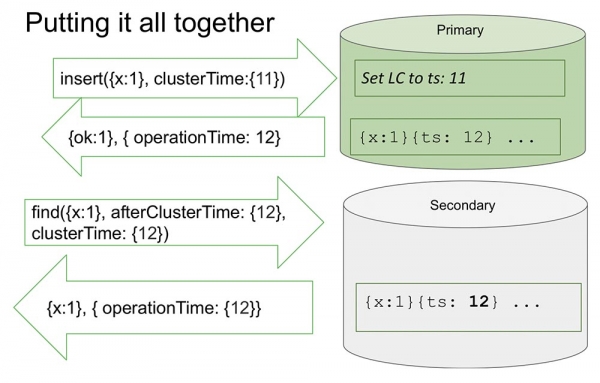
Aici analizez un replica set pentru a fi puțin mai simplu. Există un Primary și un Secondary. Secondary efectuează replicarea și nu este întotdeauna complet sincronizat cu Primary.
Se realizează o inserție (insert) în «Primary» cu o anumită valoare a timpului. Această inserție crește contorul intern cu 11, dacă este maxim. Sau va verifica valorile ceasurilor și se va sincroniza după ceasuri, dacă valorile ceasurilor sunt mai mari. Acest lucru permite ordonarea în funcție de timp.
După ce face înregistrarea, intervine un moment important. Ceasurile în «MongoDB» se incrementează doar în cazul în care have loc o înregistrare în «OpLog». Acesta este evenimentul care schimbă starea sistemului. În toate articolele clasice, un eveniment este considerat a fi primirea unui mesaj de către nod: mesajul a sosit – înseamnă că sistemul și-a schimbat starea.
Aceasta se datorează faptului că, în cadrul cercetării, nu este întotdeauna clar cum va fi interpretat acest mesaj. Știm cu siguranță că, dacă nu este reflectat în „OpLog”, atunci nu va fi interpretat deloc, iar schimbarea stării sistemului constă doar în înregistrarea în „OpLog”. Aceasta ne simplifică totul: și modelul este simplificat, și permite ordonarea în cadrul unui singur set de replici, și multe alte lucruri utile.
Se returnează o valoare care este deja înregistrată în „OpLog” – știm că în „OpLog” se află deja această valoare și timpul ei este 12. Acum, să spunem că citirea începe de la un alt nod (Secondary), iar acesta transmite deja afterClusterTime în mesajul său. El spune: „Am nevoie de tot ce s-a întâmplat cel puțin după 12 sau în timpul celor doisprezece” (vezi figura de mai sus).
Aceasta este ceea ce se numește Causal and consistent (CAT). Există un astfel de concept în teorie, care reprezintă o anumită fereastră de timp care este consistentă în sine. În acest caz, putem spune că acesta este starea sistemului care a fost observată la momentul 12.
Acum, aici nu este nimic pentru că, într-un fel, imită situația în care Secondary trebuie să replică datele cu Primary. Așteaptă... Și iată că datele au sosit – returnează înapoi aceste valori.
Așa funcționează totul, cam așa.
Ce înseamnă „cam așa”? Să presupunem că există o persoană care a citit și a înțeles cum funcționează totul. A înțeles că fiecare dată se produce ClusterTime, își actualizează ceasurile logice interne, iar apoi următoarea înregistrare crește cu o unitate. Această funcție ocupă 20 de linii. Să spunem că această persoană transmite un număr 64-bit maxim, minus unu.
De ce „minus unu”? Pentru că ceasurile interne se vor substitui în această valoare (evident, acesta este cel mai mare posibil și mai mare decât timpul actual), apoi se va produce înregistrarea în „OpLog”, iar ceasurile se vor incrementa cu încă o unitate – și va fi deja valoarea maximă (toate unitățile, nu mai este niciunde de ajuns, unsaint int’uri).
Este evident că după aceasta sistemul devine absolut inaccesibil pentru orice. Poate fi doar descărcat, curățat – multă muncă manuală. Disponibilitate completă:
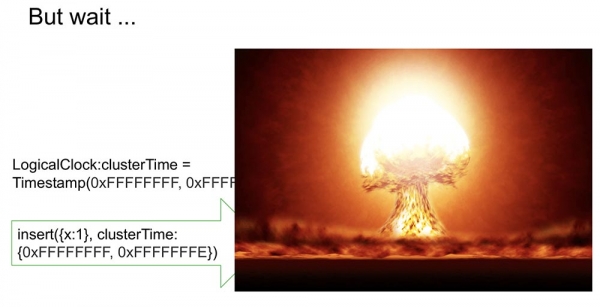
Mai mult, dacă acest lucru se replică în altă parte, atunci întregul cluster se va prăbuși. O situație complet inacceptabilă, pe care oricine poate organiza foarte repede și simplu! De aceea, am considerat acest aspect ca fiind unul dintre cele mai importante. Cum putem preveni asta?
Calea noastră – să semnăm clusterTime
Așa se transmite în mesaj (până la textul albastru). Dar acum generăm și semnătura (textul albastru):
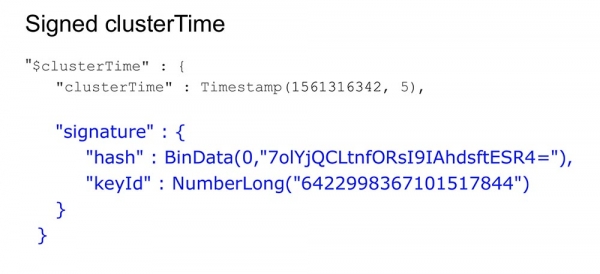
Semnătura este generată cu o cheie care este stocată în baza de date, în interiorul perimetrului protejat; este generată și actualizată (utilizatorii nu văd acest lucru). Se generează un hash, iar fiecare mesaj este semnat la crearea sa, iar la primire – validat.
Probabil că se ridică întrebarea oamenilor: „Cât de mult încetinește tot asta?” Am spus că trebuie să funcționeze rapid, mai ales în absența acestei funcții.
Ce înseamnă să folosești Coerența cauzală în acest caz? Asta înseamnă să arăți parametrul afterClusterTime. Fără acesta, el va transmite pur și simplu valori în orice caz. Gossiping, începând cu versiunea 3.6, funcționează întotdeauna.
Dacă lăsăm generarea constantă a semnăturilor, acest lucru va încetini sistemul chiar și în absența funcției, ceea ce nu se aliniază cu abordările și cerințele noastre. Și ce am făcut?
Fă-o rapid!
Este un lucru destul de simplu, dar trucul este interesant – voi împărtăși, poate va fi interesant pentru cineva.
Avem un hash în care sunt stocate datele semnate. Toate datele trec prin cache. Cache-ul nu semnează în mod specific timpul, ci un Range. Când vine o valoare, generăm un Range, mascăm ultimele 16 biți, iar această valoare o semnăm:
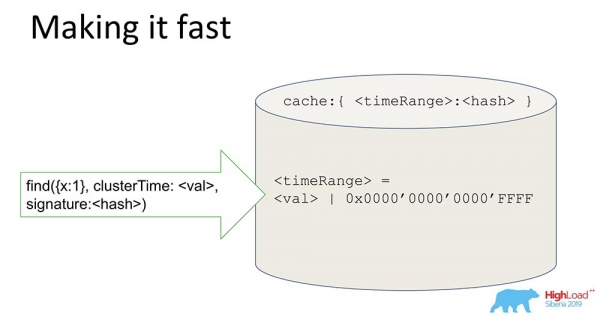
Obținând o astfel de semnătură, accelerăm sistemul (teoretic) de 65 de mii de ori. Funcționează minunat: când am realizat experimentele – timpul s-a redus în realitate de 10 mii de ori când am avut un update secvențial. Evident, când sunt în dezordine, asta nu funcționează. Dar în majoritatea cazurilor practice, acest lucru funcționează. Combinația dintre semnătura Range și semnătura a permis rezolvarea problemei de securitate.
Ce am învățat?
Lectiile pe care le-am învățat din aceasta:
- Trebuie să citim materiale, povești, articole, pentru că avem multe lucruri interesante de împărtășit. Când lucrăm la o anumită funcționalitate (mai ales acum, când am realizat tranzacții etc.), trebuie să citim și să înțelegem. Asta ne ia timp, dar este de fapt foarte util, deoarece devine clar unde ne aflăm. Nu am inventat nimic nou – doar am luat ingredientele.
În general, există o diferență vizibilă în gândire atunci când se desfășoară o conferință academică (de exemplu, „SigMon”) – acolo, toată lumea se concentrează pe idei noi. În ce constă noutatea algoritmului nostru? Aici nu este nimic deosebit. Noutatea constă mai mult în modul în care am combinat abordările existente. Așadar, prima regulă este să citim clasici, începând cu Lamport.
- În producție, cerințele sunt complet diferite. Sunt sigur că mulți dintre voi nu se confruntă cu „baze de date sferice” în absență abstractă, ci cu lucruri normale, reale, care au probleme legate de disponibilitate, latență și toleranță la erori.
- În cele din urmă, a fost necesar să luăm în considerare diferite idei și să combinăm mai multe articole complet diferite într-o singură abordare. Ideea despre semnătura, de exemplu, a venit dintr-un articol care examina protocolul Paxos, care se ocupă de erorile non-bizantine în cadrul protocolului de autorizare, pentru erorile bizantine – în afara protocolului de autorizare… În general, exact asta am realizat la final.
Nu este nimic nou aici! Dar de îndată ce am amestecat totul împreună… Asta ar fi ca și cum ai spune că rețeta salatei Olivier este o prostie, deoarece ouăle, maioneza și castraveții au fost deja inventate… Este cam aceeași poveste.
Închei aici. Mulțumesc!
Întrebări
Întrebare din sală (ulterior – Î): – Mulțumesc, Mihail, pentru prezentare! Tema despre timp este interesantă. Folosiți Gossiping. Ați spus că toți au timpul lor, toți știu timpul lor local. Am înțeles că avem un driver – pot exista mulți clienți cu drivere, mulți planificatori de interogări, mulți shard-uri… Ce se va întâmpla cu sistemul dacă apare o neconcordanță: cineva decide că este cu un minut înainte, cineva – cu un minut în urmă? Unde ne vom afla?
MT: – O întrebare excelentă, de fapt! Voi vorbi despre sharde. Dacă înțeleg corect întrebarea, avem situația următoare: există shard 1 și shard 2, iar citirea are loc din aceste două sharde – acestea sunt divergente, nu interacționează între ele, deoarece timpul de care sunt conștiente este diferit, în special timpul pe care îl dețin în loguri.
Să presupunem că shard 1 a făcut un milion de înregistrări, iar shard 2 – nimic, și o interogare a venit la cele două sharde. Și shard-ul 1 are afterClusterTime mai mare de un milion. În această situație, așa cum am explicat, shard 2 nu va răspunde niciodată.
M: – Voiam să știu cum se sincronizează și aleg un singur timp logic?
MT: – Se sincronizează foarte simplu. Shard-ul, când primește afterClusterTime și nu găsește timpul în „OpLog” – inițiază no approved. Asta înseamnă că își crește manual timpul la acea valoare. Aceasta este o indicare că nu există evenimente care să corespundă acestei interogări. Creează acest eveniment artificial și devine astfel Causal Consistent.
M: – Și dacă ulterior vor veni și alte evenimente, care s-au pierdut în rețea?
MT: – Shard-ul este construit astfel încât acestea nu vor mai veni, deoarece este un master unic. Dacă a înregistrat deja, atunci nu vor mai veni, ci vor fi ulterior. Nu poate apărea o situație în care ceva s-a blocat undeva, apoi el va face no write, iar apoi aceste evenimente au venit – și s-a încălcat Causal consistency. Când face no write, toate trebuie să vină mai departe (le va aștepta).
M: – Am câteva întrebări cu privire la cozi. Causal consistency presupune că există o anumită coadă de acțiuni care trebuie executate. Ce se va întâmpla dacă un pachet dispare? Să presupunem că a mers 10, 11… al 12-lea a dispărut, iar toate celelalte așteaptă să fie executat. Și brusc, mășina a murit, nu putem face nimic. Există o lungime maximă a cozii care se acumulează, înainte de a fi executată? Ce fel de eșec fatal are loc în cazul pierderii unui singur stadiu? Mai ales, dacă înregistrăm că există un anumit stadiu anterior, de la care ar trebui să ne bazăm? Și de la el nu ne-am bazat!
MT: – O întrebare și mai bună! Ce facem? În MongoDB există conceptul de înregistrări de quorum, citire de quorum. În ce situații un mesaj poate dispărea? Când înregistrarea nu este de quorum sau când citirea nu este de quorum (de asemenea, poate aduce niște garbage).
Referitor la consistența cauzală, am efectuat un studiu experimental extins, a cărui concluzie a fost că, în cazul în care scrierile și citirile nu sunt cu quorum, apar încălcări ale consistenței cauzale. Exact ceea ce spui!
Sfatul nostru: folosiți cel puțin citiri cu quorum atunci când utilizați consistența cauzală. În acest caz, nu se va pierde nimic, chiar dacă o scriere cu quorum dispare... Aceasta este o situație ortogonală: dacă utilizatorul nu vrea ca datele să dispară, trebuie să folosească scrierea cu quorum. Consistența cauzală nu oferă nicio garanție de durabilitate. Garanția de durabilitate este oferită de replicare și mecanismele asociate cu replicarea.
M: – Când creăm o instanță care face shard (nu master, ci slave în consecință), se bazează pe timpul unix al propriei mașini sau pe timpul «master»-ului; este sincronizată prima dată sau periodic?
MT: – Acum voi clarifica. Shardul (adică partitia orizontală) are întotdeauna un Primary. Și în shard poate fi un «master» și pot exista replici. Dar shardul susține întotdeauna scrierea, deoarece trebuie să susțină un anumit domeniu (în shard se află Primary).
M: – Deci totul depinde exclusiv de «master»? Se folosește întotdeauna timpul «master»-ului?
MT: – Da. Se poate spune că: ceasurile ticăie atunci când are loc o scriere în «master», în «Oplog».
M: – Avem un client care se conectează și nu are nevoie să știe nimic despre timp?
MT: – Deloc nu trebuie să știe nimic! Dacă vorbim despre cum funcționează la client: clientul, atunci când dorește să folosească consistența cauzală, trebuie să deschidă o sesiune. Acum este totul acolo: și tranzacțiile în sesiune, și a obține drepturi... Sesiunea este o ordonare a evenimentelor logice care se întâmplă cu clientul.
Dacă deschide această sesiune și spune că dorește consistență cauzală (dacă, în mod implicit, sesiunea susține consistența cauzală), totul funcționează automat. Driverul își amintește acest timp și îl crește atunci când primește un mesaj nou. Își amintește ce răspuns a returnat anterior serverul, care a returnat date. Următoarea cerere va conține afterCluster («timp mai mare decât acesta»).
Clientul nu trebuie să știe nimic concret! Este complet opac pentru el. Dacă oamenii folosesc aceste funcții, ce se poate realiza? În primul rând, se poate citi în siguranță din secondaries: se poate scrie pe Primary și citi de la secondary-uri replicate geografic și să fii sigur că funcționează. În plus, sesiuni scrise pe Primary pot fi transferate chiar și către Secondary, adică se pot folosi nu o sesiune, ci mai multe.
M: – Tema coerenței eventuale este strâns legată de o nouă ramură a științei calculatoarelor – tipuri de date CRDT (Conflict-free Replicated Data Types). Ați luat în considerare integrarea acestor tipuri de date în bază și ce puteți spune despre acest lucru?
MT: – O întrebare bună! CRDT are sens pentru conflictele la scriere: în MongoDB – un singur master.
M: – Am o întrebare din partea devops-ilor. În lumea reală, apar situații ispititoare în care apare o eșec bizantin și persoane malefice din interiorul perimetrului securizat încep să se bage în protocol, trimițând pachete special modificate?
MT: – Persoanele malefice din interiorul perimetrului sunt ca un cal troian! Aceste persoane pot face multe lucruri rele.
M: – Este evident că a lăsa în server, ca să zicem așa, o „fereastră” prin care se poate introduce un zoo de elefanți și prăbuși întregul cluster pentru totdeauna… Va dura timp pentru o recuperare manuală… Asta, încet spus, nu este corect. Pe de altă parte, este interesant: în viața reală, în practică, întâlniți astfel de situații în care atacurile interne naturale au loc?
MT: – Deoarece nu mă întâlnesc frecvent cu breșe de securitate în viața reală, nu pot spune – poate că au loc. Dar dacă este să vorbim despre filosofia de dezvoltare, considerăm că: avem un perimetru care asigură echipa care se ocupă de securitate – este un lacăt, un zid; iar în interiorul perimetrului putem face tot ce dorim. Este clar că sunt utilizatori care pot vedea doar, și utilizatori care pot șterge catalogul.
În funcție de permisiuni, daunele pe care utilizatorii le pot produce pot varia de la a fi simple ca o pisică, până la a fi devastatoare ca un elefant. Este clar că un utilizator cu drepturi complete poate face orice. Un utilizator cu permisiuni limitate poate provoca daune considerabil mai mici. În special, nu poate distruge sistemul.
M: – În perimetrul protejat, cineva s-a gândit să formeze protocoale neașteptate pentru server, pentru a compromite serverul, iar, dacă are noroc, întregul cluster... Este posibil să fie atât de „bine”?
MT: – Nu am auzit niciodată de astfel de lucruri. Faptul că se poate compromite un server în acest fel nu este un secret. A compromite din interior, fiind pe protocol, fiind un utilizator autorizat, care poate scrie în mesaj ceva... De fapt, nu este posibil, pentru că oricum va trece printr-o verificare. Există posibilitatea de a dezactiva această autentificare pentru utilizatorii care nu doresc – aceasta devine problema lor; ei, pe scurt, și-au distrus singuri zidurile și pot aduce un elefant care să calce... În general, poți să te îmbraci ca un tehnician, să vii și să-l scoți!
M: – Mulțumesc pentru prezentare. Sergey („Yandex”). În „Mongo” există o constantă care limitează numărul de membri votanți în Replica Set, iar această constantă este 7 (șapte). De ce este aceasta o constantă? De ce nu este un parametru oarecare?
MT: – Replica Set-ul nostru poate avea și 40 de noduri. Acolo este întotdeauna majoritatea. Nu știu ce versiune este...
M: – În Replica Set poți lansa membri ne-votanți, dar votanți – maxim 7. Cum gestionăm situația dacă avem Replica Set pe 3 centre de date? Un centru de date poate fi oprit ușor, iar încă o mașină ar putea ieși din funcțiune.
MT: – Aceasta este deja puțin dincolo de prezentare. Este o întrebare generală. Poate, mai târziu pot să îi povestesc.
Puțin publicitate 🙂
Mulțumim că rămâneți cu noi. Vă plac articolele noastre? Doriți să vedeți mai multe materiale interesante? Susțineți-ne, efectuând o comandă sau recomandându-ne prietenilor, , un echivalent unic pentru serverele entry-level, care a fost creat de noi pentru voi: (sunt disponibile opțiuni cu RAID1 și RAID10, până la 24 nuclee și până la 40GB DDR4).
Dell R730xd la jumătate de preț în centrul de date Equinix Tier IV din Amsterdam? Numai la noi în Olanda! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — de la 99 $! Citiți despre
Sursa: habr.com
