

Procesul de actualizare pentru clusterul dvs. Kubernetes
La un moment dat, utilizând un cluster Kubernetes, apare necesitatea de a actualiza nodurile funcționale. Aceasta poate include actualizări ale pachetelor, actualizarea nucleului sau desfășurarea de noi imagini ale mașinilor virtuale. În terminologia Kubernetes, aceasta se numește .
Această postare face parte dintr-un ciclu de 4 postări:
- Această postare.
- Finalizarea corectă a pod-urilor în clusterul Kubernetes
- Finalizarea amânată a pod-ului la ștergerea acestuia
- Cum să evitați timpilor de nefuncționare în clusterul Kubernetes cu ajutorul PodDisruptionBudgets
(nota traducătorului: așteptați traducerile celorlalte articole din ciclu în curând)
În acest articol, vom descrie toate instrumentele pe care Kubernetes le oferă pentru a obține un timp de nefuncționare zero pentru nodurile active din clusterul dvs.
Definirea problemei
La început, vom folosi o abordare naivă, definind problemele și evaluând riscurile potențiale ale acestei abordări, acumulând astfel cunoștințe pentru a rezolva fiecare dintre problemele pe care le întâlnim pe parcursul întregului ciclu. Drept rezultat, vom obține o configurație care utilizează lifecycle hooks, readiness probes și Pod disruption budgets pentru a atinge timpul nostru zero de nefuncționare.
Pentru a începe călătoria noastră, să luăm un exemplu concret. Să presupunem că avem un cluster Kubernetes format din două noduri, în care rulează o aplicație cu două pod-uri, situate în spatele Serviciu:
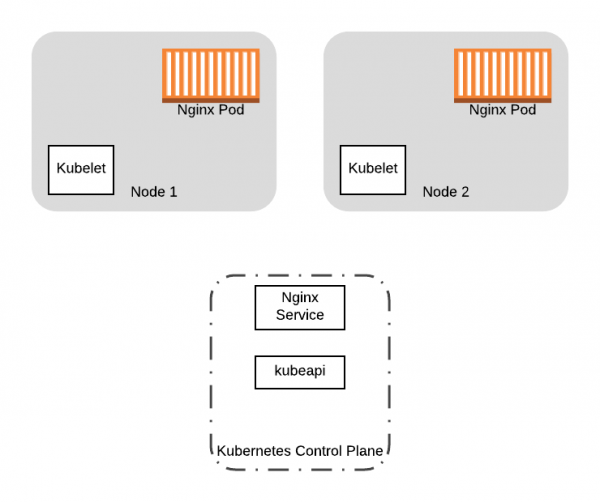
Să începem cu două pod-uri cu Nginx și un serviciu rulate pe cele două noduri ale clusterului nostru Kubernetes.
Dorim să actualizăm versiunea nucleului celor două noduri de lucru din clusterul nostru. Cum o vom face? O soluție simplă ar fi să încărcăm noduri noi cu configurația actualizată și apoi să oprim nodurile vechi, în timp ce pornim cele noi. Deși aceasta va funcționa, vor apărea câteva probleme cu această abordare:
- Când opriți nodurile vechi, pod-urile rulate pe acestea vor fi de asemenea oprite. Ce se întâmplă dacă pod-urile trebuie curățate pentru o deconectare corectă? Sistemul de virtualizare pe care îl utilizați poate să nu aștepte finalizarea procesului de curățare.
- Ce se întâmplă dacă opriți toate nodurile simultan? Veți experimenta un timp considerabil de nefuncționare în timp ce pod-urile sunt mutate pe noile noduri.
Avem nevoie de un mod corect de migrare a pod-urilor de pe noduri vechi și, de asemenea, trebuie să ne asigurăm că niciunul dintre procesele noastre de lucru nu este în execuție în timp ce facem modificări la nod. Sau când facem o înlocuire completă a cluster-ului, ca în exemplul acesta (adică înlocuind imaginile VM), dorim să transferăm aplicațiile funcționale de pe nodurile vechi pe cele noi. În ambele cazuri, dorim să prevenim programarea unor noi pod-uri pe nodurile vechi pentru a evacua toate pod-urile în execuție de pe acestea. Pentru a atinge aceste obiective, putem folosi comanda kubectl drain.
Repartizarea tuturor pod-urilor de pe nod
Operațiunea drain permite repartizarea tuturor pod-urilor de pe nod. În timpul execuției drain, nodul este marcat ca neschedulabil (flagra NoSchedule). Aceasta împiedică apariția de noi pod-uri pe acesta. Apoi, drain începe să evacueze pod-urile de pe nod, oprind containerele care sunt în prezent în execuție pe nod, trimițând semnalul TERM la containerele din pod.
Deși kubectl drain Deși reușește bine în evacuarea pod-urilor, există încă două factoare care ar putea cauza eșecul operațiunii drain:
- Aplicația dvs. trebuie să fie capabilă să se oprească corect atunci când primește
TERMun semnal. Când pod-urile sunt evacuate, Kubernetes trimite semnalulTERMla containere și așteaptă să se oprească pentru o perioadă de timp definită, după care, dacă nu s-au oprit, le finalizează forțat. În orice caz, dacă containerul dvs. nu răspunde corect la semnal, este posibil să închideți pod-urile incorect, dacă acestea sunt în execuție în acel moment (de exemplu, o tranzacție în baza de date). - Veți pierde toate pod-urile care conțin aplicația dvs. Aceasta poate fi inaccesibilă în momentul lansării noilor containere pe noile noduri sau, dacă pod-urile dvs. sunt desfășurate fără controllere, acestea ar putea să nu se repornească deloc.
Evitarea timpului de inactivitate
Pentru a minimiza timpul de inactivitate cauzat de întreruperea voluntară, cum ar fi operațiunea drain pentru un nod, Kubernetes oferă următoarele opțiuni de gestionare a eșecurilor:
În celelalte părți ale ciclului, vom folosi aceste funcții Kubernetes pentru a atenua impactul transferului pod-urilor. Pentru a urmări mai ușor ideea principală, vom folosi exemplul nostru de mai sus cu următoarea configurație de resurse:
---
apiVersion: apps/v1
kind: Deployment
metadata:
 name: nginx-deployment
 labels:
   app: nginx
spec:
 replicas: 2
 selector:
   matchLabels:
     app: nginx
 template:
   metadata:
     labels:
       app: nginx
   spec:
     containers:
     - name: nginx
       image: nginx:1.15
       ports:
       - containerPort: 80
---
kind: Service
apiVersion: v1
metadata:
 name: nginx-service
spec:
 selector:
   app: nginx
 ports:
 - protocol: TCP
   targetPort: 80
   port: 80
Această configurație este un exemplu minim Deployment, care gestionează pod-urile nginx în cluster. De asemenea, configurația descrie resursa Serviciu, care poate fi folosită pentru a accesa pod-urile nginx în cluster.
Pe parcursul întregului ciclu, vom extinde iterativ această configurație, astfel încât, la final, să includă toate funcționalitățile oferite de Kubernetes pentru a reduce timpul de nefuncționare.
Pentru a obține o versiune complet implementată și testată a actualizărilor clusterului Kubernetes care asigură zero timp de nefuncționare pe AWS și alte resurse, vizitați .
Citiți și alte articole de pe blogul nostru:
Sursa: habr.com
