

Nota traducătorului.: În acest articol, compania Banzai Cloud împărtășește un exemplu de utilizare a utilitarelor sale speciale pentru a facilita operarea Kafka în cadrul Kubernetes. Instrucțiunile prezentate ilustrează cum se poate determina dimensiunea optimă a infrastructurii și configura Kafka pentru a atinge capacitatea de livrare dorită.
Apache Kafka este o platformă de streaming distribuită pentru crearea de sisteme de streaming de realitate fiabile, scalabile și cu performanțe ridicate. Capabilitățile sale impresionante pot fi extinse cu ajutorul Kubernetes. Pentru aceasta, am dezvoltat și un instrument numit . Acestea permit rularea Kafka în Kubernetes și utilizarea diverselor sale funcții, cum ar fi configurarea fină a brokerului, scalarea pe baza metricilor cu rebalansare, rack awareness (conștientizarea resurselor hardware), actualizări cu (graceful) și multe altele.
Încercați Supertubes în clusterul dumneavoastră:
curl https://getsupertubes.sh | sh și supertubes install -a --no-democluster --kubeconfigSau contactați . De asemenea, puteți citi despre unele dintre funcționalitățile Kafka, a căror operare este automatizată cu ajutorul Supertubes și al operatorului Kafka. Despre acestea am scris deja în blog:
- ;
- ;
- ;
- ;
- ;
- ;
- .
Deci, dacă ați decis să dezvăluiți un cluster Kafka în Kubernetes, cu siguranță veți întâmpina problema determinării dimensiunii optime a infrastructurii de bază și a necesității unei configurări fine a Kafka pentru a satisface cerințele de capacitate. Performanța maximă a fiecărui broker este determinată de performanța componentelor infrastructurii pe care se bazează, cum ar fi memorie, procesor, viteză a discului, lățimea de bandă a rețelei etc.
În ideal, configurația brokerului ar trebui să fie astfel încât toate elementele infrastructurii să fie utilizate la maximum capacității lor. Totuși, în viața reală, o astfel de setare este destul de complicată. Mai probabil, utilizatorii vor configura brokerii pentru a maximiza utilizarea unuia sau două componente (discuri, memorie sau procesor). În general, brokerul arată cea mai bună performanță atunci când configurația sa permite utilizarea completă a celui mai lent component. Astfel, putem obține o idee aproximativă despre sarcina pe care un broker o poate gestiona.
Teoretic, putem estima, de asemenea, numărul de brokeri necesari pentru a gestiona o încărcare dată. Cu toate acestea, în practică, opțiunile de configurare la diferite niveluri sunt atât de multe încât evaluarea potențialei performanțe a unei configurații devine foarte complicată (dacă nu imposibilă). Cu alte cuvinte, este foarte greu să planificăm o configurație bazându-ne pe o anumită performanță dată.
Pentru utilizatorii Supertubes, de obicei aplicăm următoarea abordare: începem cu o anumită configurație (infrastructură + setări), apoi măsurăm performanța acesteia, ajustăm setările brokerului și repetăm procesul încă o dată. Acest lucru se întâmplă până când potențialul celui mai lent component al infrastructurii este complet utilizat.
În acest mod, obținem o idee mai clară despre câți brokeri sunt necesari unui cluster pentru a face față unei anumite încărcări (numărul de brokeri depinde, de asemenea, de alți factori, cum ar fi numărul minim de replici pentru a asigura reziliența, numărul de lideri de partition etc.). În plus, obținem o perspectivă asupra celui mai dorit component de infrastructură pentru scalarea verticală.
În acest articol, vom discuta despre pașii pe care îi facem pentru a „scoate totul” din cele mai lente componente în configurațiile inițiale și a măsura lățimea de bandă a clusterului Kafka. O configurație rezistentă necesită cel puțin trei brokeri funcționali (min.insync.replicas=3), distribuite pe trei zone de disponibilitate diferite. Pentru configurarea, scalarea și monitorizarea infrastructurii Kubernetes, folosim propria platformă de gestionare a containerelor pentru clouduri hibride — . Aceasta suportă on-premise (bare metal, VMware) și cinci tipuri de clouduri (Alibaba, AWS, Azure, Google, Oracle), precum și orice combinații ale acestora.
Gânduri despre infrastructura și configurarea clusterului Kafka
Pentru exemplele de mai jos, am ales AWS ca furnizor de servicii cloud și EKS ca distribuție Kubernetes. O configurare similară poate fi realizată cu ajutorul — distribuția Kubernetes de la Banzai Cloud, certificat CNCF.
Disc
Amazon oferă diverse . La baza gp2 și io1 se află SSD-uri, totuși pentru a asigura un randament mare gp2 consumă credite I/O (I/O credits), de aceea am preferat un tip io1, care oferă un randament stabil.
Tipuri de instanțe
Performanța Kafka depinde mult de cache-ul pe pagină al sistemului de operare, de aceea avem nevoie de instanțe cu suficientă memorie pentru brokeri (JVM) și cache-ul pe pagină. Instanța c5.2xlarge — este un început bun, având 16 GB de memorie și . Dezavantajul său este că poate furniza performanțe maxime timp de nu mai mult de 30 de minute într-o perioadă de 24 de ore. Dacă sarcina de lucru necesită performanțe maxime pentru o perioadă mai lungă, ar trebui să ne uităm la alte tipuri de instanțe. Exact așa am procedat, alegând c5.4xlarge. Aceasta oferă un randament maxim de 593,75 MB/s. Randamentul maxim al volumului EBS io1 este mai mare decât al instanței c5.4xlarge, astfel încât cel mai lent element al infrastructurii pare a fi randamentul I/O al acestui tip de instanță (ceea ce ar trebui să confirme și rezultatele testelor noastre de încărcare).
Rețea
Randamentul rețelei trebuie să fie suficient de mare comparativ cu performanța instanței VM și a discului, altfel rețeaua devine un punct nevralgic. În cazul nostru, interfața de rețea c5.4xlarge suportă viteze de până la 10 Gb/s, ceea ce este semnificativ mai mult decât randamentul I/O al instanței VM.
Implementarea brokerilor
Brokerii trebuie să fie desfășurați (planificați în Kubernetes) pe noduri dedicate pentru a evita competiția cu alte procese pentru resursele de procesor, memorie, rețea și disc.
Versiunea Java
Alegerea logică este Java 11, deoarece este compatibilă cu Docker în sensul că JVM determină corect procesoarele și memoria disponibile pentru containerul în care rulează brokerul. Știind că limitele procesorului sunt importante, JVM stabilește intern și transparent numărul de fire GC și fire de compilare JIT. Am folosit imaginea Kafka banzaicloud/kafka:2.13-2.4.0, incluzând versiunea Kafka 2.4.0 (Scala 2.13) pe Java 11.
Dacă doriți să aflați mai multe despre Java/JVM pe Kubernetes, consultați publicațiile noastre următoare:
- ;
- .
Setări de memorie pentru broker
Există două aspecte cheie în configurarea memoriei brokerului: setările pentru JVM și pentru podul Kubernetes. Limita de memorie stabilită pentru pod trebuie să fie mai mare decât dimensiunea maximă a heap-ului, astfel încât JVM să aibă loc pentru metaspaițiu Java, care se află în propria memorie, și pentru memoria de cache a sistemului de operare, pe care Kafka o folosește activ. În testele noastre, am rulat brokeri Kafka cu parametrii -Xmx4G -Xms2G, iar limita de memorie pentru pod era 10 Gi. Rețineți că setările de memorie pentru JVM pot fi obținute automat prin -XX:MaxRAMPercentage și -X:MinRAMPercentage, pe baza limitei de memorie pentru pod.
Setările de procesor ale brokerului
În general, performanța poate fi îmbunătățită prin creșterea paralelismului prin creșterea numărului de fire utilizate de Kafka. Cu cât mai multe procesoare sunt disponibile pentru Kafka, cu atât mai bine. În testul nostru, am început cu o limită de 6 procesoare și treptat (prin iterații) am crescut numărul lor la 15. În plus, am setat num.network.threads=12 în setările brokerului, pentru a crește numărul de fire care primesc date din rețea și le trimit. Imediat ce am observat că brokerii de replicare nu pot primi replicile suficient de repede, am crescut num.replica.fetchers la 4, pentru a crește viteza cu care brokerii de replicare replicau mesajele de la lideri.
Instrument pentru generarea sarcinii
Este necesar să ne asigurăm că potențialul generatorului de sarcină ales nu va fi epuizat înainte ca clusterul Kafka (pentru care se realizează benchmark-ul) să ajungă la sarcina maximă. Cu alte cuvinte, trebuie să facem o evaluare preliminară a capabilităților instrumentului de generare a sarcinii și să alegem tipurile de instanțe cu suficienți procesori și memorie. În acest caz, instrumentul nostru va genera mai multă sarcină decât poate procesa clusterul Kafka. După multe experimente, ne-am oprit la trei instanțe c5.4xlarge, fiecare dintre acestea având un generator pornit.
Benchmarking
Măsurarea performanței este un proces iterativ care include următoarele etape:
- configurarea infrastructurii (clusterul EKS, clusterul Kafka, instrumentul de generare a sarcinii, precum și Prometheus și Grafana);
- generarea sarcinii pe o perioadă determinată pentru a filtra abaterile aleatorii din metricile de performanță colectate;
- ajustarea infrastructurii și configurației brokerului pe baza metricilor de performanță observate;
- repetarea procesului până când se atinge nivelul dorit de capacitate de bandă al clusterului Kafka. Acesta trebuie să fie stabil și să demonstreze variații minime ale capacității de bandă.
În secțiunea următoare sunt descriși pașii efectuați în timpul benchmark-ului clusterului de test.
Instrumente
Pentru desfășurarea rapidă a unei configurații de bază, generarea sarcinii și măsurarea performanței s-au folosit următoarele instrumente:
- pentru organizarea clusterului EKS de la Amazon și (pentru colectarea metricilor Kafka și infrastructurii) și (pentru vizualizarea acestor metrici). Am folosit servicii integrate în care oferă monitorizare federativă, colectare centralizată a jurnalelor, scanare a vulnerabilităților, recuperare în caz de eșec, securitate la nivel de întreprindere și multe altele.
- este un instrument pentru testarea de sarcină a clusterului Kafka.
- Panourile Grafana pentru vizualizarea metricilor Kafka și infrastructurii: , .
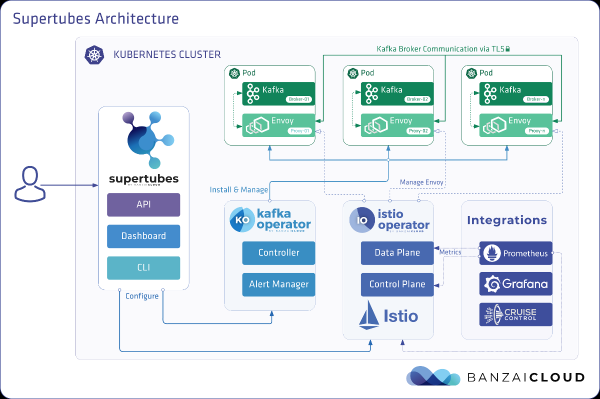
- Supertubes CLI pentru configurarea extrem de simplă a unui cluster Kafka în Kubernetes. Zookeeper, operator Kafka, Envoy și multe alte componente sunt instalate și configurate corect pentru a rula un cluster Kafka gata de producție în Kubernetes.
- Pentru instalare supertubes CLI urmează instrucțiunile furnizate .
Cluster EKS
Pregătește clusterul EKS cu noduri de lucru dedicate c5.4xlarge în diverse zone de disponibilitate pentru poduri cu brokeri Kafka, precum și noduri dedicate pentru generatorul de încărcare și infrastructura de monitorizare.
banzai cluster create -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/cluster_eks_202001.jsonCând clusterul EKS este operațional, activează serviciul său integrat — acesta va lansa Prometheus și Grafana în cluster.
Componentele de sistem Kafka
Instalează componentele de sistem Kafka (Zookeeper, kafka-operator) în EKS folosind supertubes CLI:
supertubes install -a --no-democluster --kubeconfigCluster Kafka
Implicit, în EKS sunt utilizate volume EBS de tip gp2, așa că este necesar să creezi o clasă separată de stocare bazată pe volume io1 pentru clusterul Kafka:
kubectl create -f - <<EOF
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: fast-ssd
provisioner: kubernetes.io/aws-ebs
parameters:
  type: io1
  iopsPerGB: "50"
  fsType: ext4
volumeBindingMode: WaitForFirstConsumer
EOF
Setează parametrul pentru brokeri min.insync.replicas=3 și desfășoară podurile brokerilor pe noduri în trei zone diferite de disponibilitate:
supertubes cluster create -n kafka --kubeconfig -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/kafka_202001_3brokers.yaml --wait --timeout 600Subiecte
Am rulat simultan trei instanțe ale generatorului de încărcare. Fiecare scrie în propria subiect, ceea ce înseamnă că avem nevoie de trei subiecte în total:
supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest1
spec:
  name: perftest1
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
    name: perftest2
spec:
  name: perftest2
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest3
spec:
  name: perftest3
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF
Pentru fiecare subiect, factorul de replicare este 3 — valoarea minimă recomandată pentru sistemele de producție cu înaltă disponibilitate.
Instrument pentru generarea sarcinii
Am lansat trei instanțe ale generatorului de sarcină (fiecare scriind în subiecte separate). Pentru pod-urile generatorului de sarcină, este necesar să specificăm afinitatea nodului, astfel încât acestea să fie planificate doar pe nodurile rezervate pentru ele:
apiVersion: extensions/v1beta1
kind: Deployment
metadata:
  labels:
    app: loadtest
  name: perf-load1
  namespace: kafka
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      app: loadtest
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        app: loadtest
    spec:
      affinity:
        nodeAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            nodeSelectorTerms:
            - matchExpressions:
              - key: nodepool.banzaicloud.io/name
                operator: In
                values:
                - loadgen
      containers:
      - args:
        - -brokers=kafka-0:29092,kafka-1:29092,kafka-2:29092,kafka-3:29092
        - -topic=perftest1
        - -required-acks=all
        - -message-size=512
        - -workers=20
        image: banzaicloud/perfload:0.1.0-blog
        imagePullPolicy: Always
        name: sangrenel
        resources:
          limits:
            cpu: 2
            memory: 1Gi
          requests:
            cpu: 2
            memory: 1Gi
        terminationMessagePath: /dev/termination-log
        terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      terminationGracePeriodSeconds: 30
Câteva aspecte de care ar trebui să țineți cont:
- Generatorul de sarcină generează mesaje cu o lungime de 512 octeți și le publică în Kafka în pachete de câte 500 de mesaje.
- Cu ajutorul argumentului
-required-acks=allpublicarea este considerată reușită atunci când toate replicile sincronizate ale mesajului sunt primite și confirmate de brokerii Kafka. Aceasta înseamnă că în benchmark am măsurat nu doar viteza de lucru a liderilor care primesc mesajele, ci și a succesorilor lor, care replică mesajele. Sarcina acestui test nu este de a evalua viteza de citire a consumatorilor (consumatori) mesajelor recent acceptate, care rămân deocamdată în cache-ul paginilor OS, și compararea sa cu viteza de citire a mesajelor stocate pe disc. - Generatorul de sarcină pornește în paralel 20 de worker-i (
-workers=20). Fiecare worker conține 5 producători, care împărtășesc conexiunea worker-ului cu cluster-ul Kafka. În concluzie, fiecare generator numără 100 de producători, iar toți trimit mesaje în cluster-ul Kafka.
Monitorizarea stării cluster-ului
În timpul testării de încărcare a clusterei Kafka, am monitorizat și sănătatea acestuia, pentru a ne asigura că nu există restarts de poduri, replici nesincronizate și capacitate maximă cu fluctuații minime:
- Generatorul de încărcare scrie statistici standard despre numărul de mesaje publicate și nivelul de erori. Procentul de erori trebuie să rămână la valoarea
0,00%. - , desfășurat de kafka-operator, oferă un panou de monitorizare, unde putem observa și starea clusterei. Pentru a vizualiza acest panou, rulați:
supertubes cluster cruisecontrol show -n kafka --kubeconfig - Nivelul ISR (numărul de replici „în-sincron”) shrink și expansion sunt egale cu 0.
Rezultatele măsurătorilor
3 brokeri, dimensiunea mesajelor — 512 byte
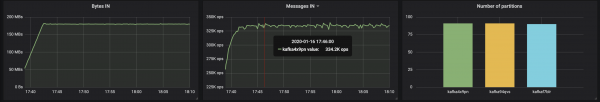
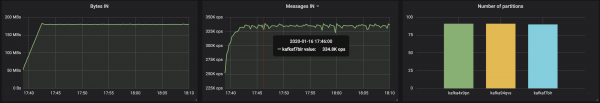
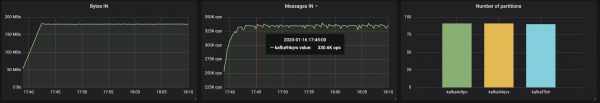
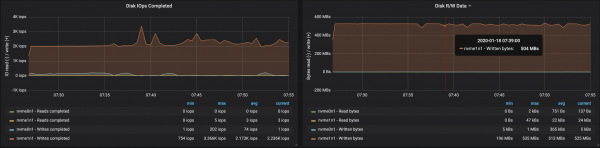
Cu partition-uri distribuite uniform pe trei brokeri, am reușit să obținem o performanță ~500 Mb/s (aproximativ 990.000 mesaje pe secundă):
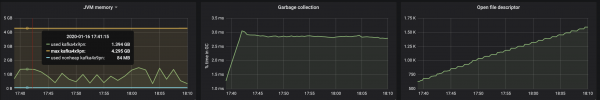
Consumul de memorie al mașinii virtuale JVM nu a depășit 2 Gb:
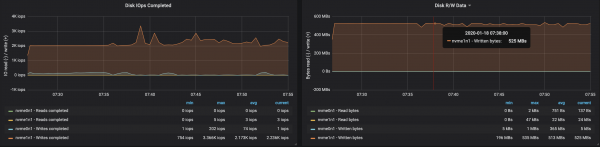
Capacitatea de transfer a discului a atins capacitatea maximă de I/O a nodului pe toate cele trei instanțe, unde au funcționat brokerii:
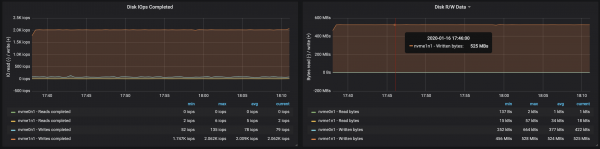
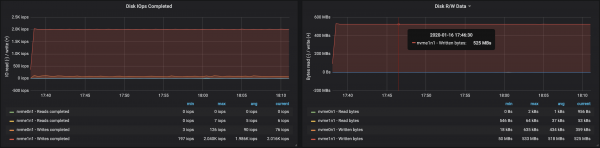
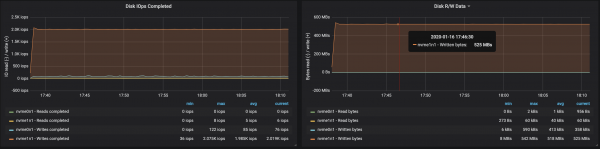
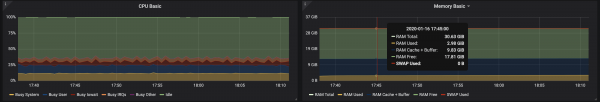
Din datele privind utilizarea memoriei de către noduri, se observă că bufferizarea și cache-ul sistemului au ocupat ~10-15 Gb:
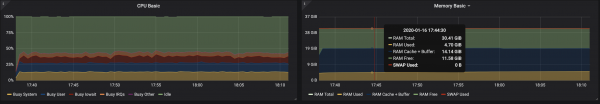
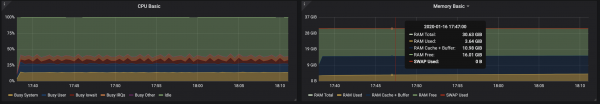
3 brokeri, dimensiunea mesajelor — 100 byte
Odată cu reducerea dimensiunii mesajelor, capacitatea de transfer scade cu aproximativ 15-20%: aceasta se datorează timpului necesar pentru procesarea fiecărui mesaj. În plus, încărcarea CPU-ului a crescut aproape de două ori.
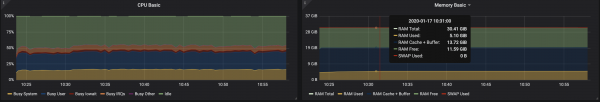
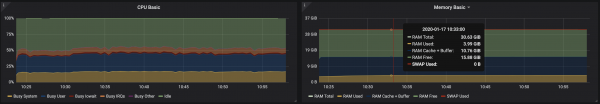
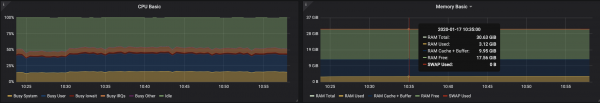
Deoarece nodurile brokerilor au în continuare nuclee neutilizate, performanța poate fi îmbunătățită prin ajustarea configurației Kafka. Aceasta este o sarcină complexă, așa că pentru a crește capacitatea de transfer, este mai bine să lucrăm cu mesaje de dimensiuni mai mari.
4 brokeri, dimensiunea mesajelor — 512 byte
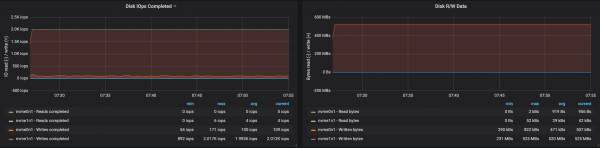
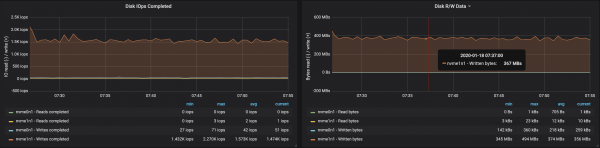
Performanța clusterei Kafka poate fi ușor crescută pur și simplu prin adăugarea de noi brokeri și menținerea echilibrului între partition-uri (acest lucru asigură o distribuție uniformă a sarcinii între brokeri). În cazul nostru, după adăugarea unui broker, capacitatea de transfer a clusterei a crescut la ~580 Mb/s (~1,1 milioane mesaje pe secundă). Creșterea a fost mai mică decât ne așteptam: acest lucru se explică în principal prin dezbalansul partition-urilor (nu toți brokerii funcționează la capacitate maximă).
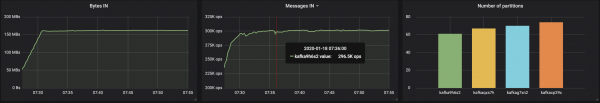
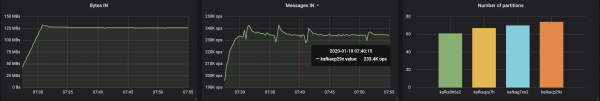
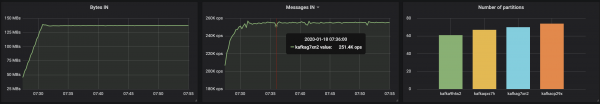
Consumul de memorie al mașinii JVM a rămas sub 2 GB:
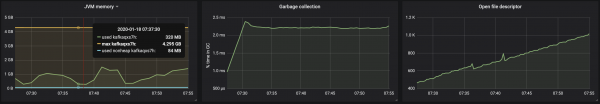
Activitatea brokerilor cu acumulatoare a fost influențată de un dezechilibru al partition-urilor:
Conclusions
Abordarea iterativă prezentată mai sus poate fi extinsă pentru a acoperi scenarii mai complexe, incluzând sute de consumatori, repartitionare, actualizări progresive, reporniri ale pod-urilor etc. Totul ne permite să evaluăm limitele capacităților cluster-ului Kafka în diverse condiții, să identificăm punctele slabe în funcționarea acestuia și să găsim soluții pentru a le combate.
Am dezvoltat Supertubes pentru desfășurarea rapidă și ușoară a cluster-ului, configurarea acestuia, adăugarea/ștergerea brokerilor și topic-urilor, reacționarea la alerte și asigurarea funcționării corecte a Kafka în Kubernetes în ansamblu. Scopul nostru este să ajutăm la concentrarea pe sarcina de bază („a genera” și „a consuma” mesaje Kafka), lăsând întreaga muncă grea Supertubes și operator-ului Kafka.
Dacă sunteți interesat de tehnologii și proiecte Open Source Banzai Cloud, urmăriți compania pe , sau .
P.S. de la traducător
Citiți și în blogul nostru:
- «»;
- «»;
- «».
Sursa: habr.com
