

 Publicăm din nou transcrierea prezentării de la conferința din 2016, care a avut loc în Skolkovo, suburba Moscovei, între 7 și 8 noiembrie anul trecut. vorbește despre cum să extinzi funcționalitățile NGINX cu OpenResty și Lua.
Bună ziua, mă numesc Vladimir Protasov, lucrez la Parallels. O să vă povestesc puțin despre mine. Trei sferturi din viața mea am scris cod. Am devenit programator până în măduvă, adică uneori visez codul. Un sfert din viață este dedicat dezvoltării industriale, scrierii codului care ajunge direct în producție. Codul pe care unii dintre voi îl folosiți, dar nu vă dați seama.
Ca să înțelegeți cât de rău era totul. Când eram un junior mic, am venit și mi-au dat astfel de baze de date de două terabaiți. Acum toată lumea are highload. Mă duceam la conferințe, întrebam: „Băieți, spuneți-mi, aveți big data, e tare? Câte date aveți?” Răspundeau: „Avem 100 de giga!” Eu spuneam: „Minunat, 100 de giga!” Dar în gând mă gândeam, cum să-mi păstrez fața impasibilă. Credeai că sunt tare, iar apoi te întorci și îți dai seama că trebuie să te descurci cu acele baze de date de câteva terabaiți. Și asta, fiind junior. Vă imaginați ce lovitură a fost?
Știu peste 20 de limbaje de programare. Asta e ceea ce a trebuit să învăț în timpul muncii. Îți dau cod pe Erlang, C, C++, Lua, Python, Ruby, pe alte limbaje, și trebuie să le folosești pe toate. În general, așa a fost. Nici măcar nu am reușit să număr exact, dar pe undeva am pierdut numărul pe la 20.
Deoarece toți prezenții știu ce este Parallels și cu ce ne ocupăm, nu o să vorbesc despre cât de grozavi suntem și ce facem. Voi spune doar că avem 13 birouri în lume, peste 300 de angajați, dezvoltare la Moscova, Tallinn și Malta. Dacă doriți, puteți să vă mutați pe Malta, dacă iarna e frig și trebuie să vă încălziți.
Departamentul nostru scrie în Python 2. Ne ocupăm de afaceri și nu avem timp să implementăm tehnologii moderne, așa că suferim. Folosim Django, pentru că are tot ce ne trebuie, iar ce e în plus am aruncat. De asemenea, MySQL, Redis și NGINX. Avem multe alte lucruri grozave. Avem MongoDB, avem iepuri care aleargă, avem de toate – dar nu este domeniul meu, și nu mă ocup de asta.
OpenResty
Asta a fost despre mine. Hai să vedem despre ce voi vorbi astăzi:
- Ce este OpenResty și cu ce se mănâncă?
- De ce să inventăm o altă bicicletă, când avem Python, NodeJS, PHP, Go și alte lucruri grozave de care toată lumea este mulțumită?
- Și câteva exemple din viața reală. A trebuit să reduc considerabil prezentarea, deoarece mi-a ieșit de 3,5 ore, așa că vor fi puține exemple.
OpenResty este NGINX. Datorită lui, avem un server web complet funcțional, care este bine scris și funcționează rapid. Cred că majoritatea dintre noi folosim NGINX în producție. Toți știți că este rapid și grozav. A fost realizată o intrare/ieșire sincronă fantastică, așa că nu trebuie să ne facem griji să reinventăm roata, așa cum s-a întâmplat cu gevent în Python. Gevent este grozav, dar dacă scrii cod în C și ceva nu merge bine, devine al naibii de greu să deboghezi cu gevent. Am avut experiența asta: a fost nevoie de două zile întregi să înțeleg ce s-a întâmplat greșit. Dacă cineva nu s-ar fi băgat câteva săptămâni să descopere problema, să o scrie pe internet, iar Google nu ar fi găsit-o, am fi înnebunit complet.
În NGINX deja există caching și conținut static. Nu trebuie să îți faci griji cum să faci asta ca lumea, pentru a nu rămâne blocat undeva, să nu pierzi descriptorii undeva. NGINX se deplasează foarte ușor, nu trebuie să te gândești ce să alegi - WSGI, PHP-FPM, Gunicorn, Unicorn. NGINX a fost instalat, l-am dat administratorilor și ei știu cum să lucreze cu el. NGINX procesează cererile într-un mod structurat. Voi vorbi mai multe despre asta mai târziu. Pe scurt, are o fază în care a primit cererea, în care a procesat-o și în care a livrat conținutul utilizatorului.
NGINX este grozav, dar există o problemă: nu este suficient de flexibil chiar și cu toate acele caracteristici grozave pe care le-au inclus în configurație, având în vedere cât de multe pot fi ajustate. Această putere nu este suficientă. De aceea, băieții de la Taobao, acum câțiva ani, parcă acum opt ani, au încorporat Lua. Ce oferă acesta?
- Dimensiune. Este mic. LuaJIT oferă undeva între 100-200 de kilobyte overhead în memorie și un overhead minim în performanță.
- Viteză. Interpretatorul LuaJIT este aproape la fel de rapid ca C în multe situații, în unele situații pierde în fața Java, iar în altele o depășește. O perioadă a fost considerat cel mai bun, un JIT compilator fantastic. Acum sunt variante mai grozave, dar sunt foarte grele, de exemplu, V8. Unele interpretatoare JS și HotSpot-ul Java sunt mai rapide în anumite puncte, dar în alte situații tot mai pierd.
- Ușurința de învățare. Dacă aveți, de exemplu, o bază de cod în Perl și nu sunteți Booking, nu veți găsi programatori Perl. Pentru că nu există, i-au luat pe toți, iar a-i învăța durează mult și e complicat. Dacă doriți programatori pe altceva, s-ar putea să trebuiască să-i recalificați sau să-i găsiți. În cazul Lua, totul e simplu. Lua poate fi învățat de orice junior în trei zile. Mi-a trebuit cam două ore să mă familiarizez. După două ore, scriam deja cod în producție. Cam după o săptămână, codul meu a fost deja livrat în producție.
În rezultat, arată așa:
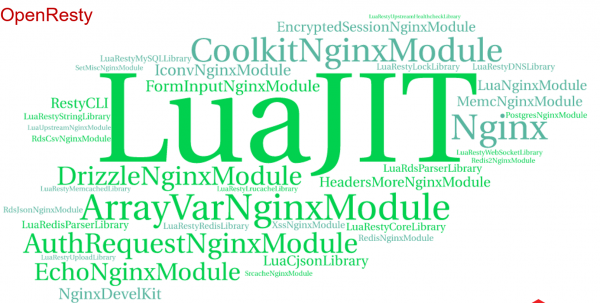
Aici este mult. În OpenResty, au adunat o grămadă de module, atât lua cât și engine. Și aveți totul gata - l-ați implementat și funcționează.
Exemple
Ajunge cu lirica, să trecem la cod. Iată un mic Hello World:
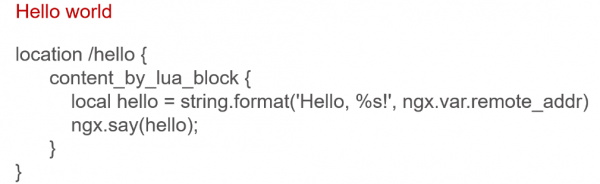
Ce avem aici? Este o locație de engine. Nu ne complicăm, nu scriem rutarea noastră, nu luăm ceva gata - avem deja în NGINX, trăim bine și leneș.
content_by_lua_block – acesta este un bloc care indică faptul că livrăm conținut printr-un script Lua. Luăm variabila de engine remote_addr și o introducem în string.format. Este la fel ca și sprintf, doar că în Lua, doar că corect. Și livrăm clientului.
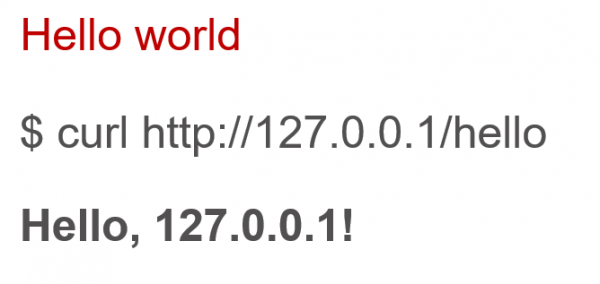
În rezultat, va arăta așa:
Dar să ne întoarcem în lumea reală. În producție, nimeni nu implementează Hello World. Aplicația noastră merge de obicei în baza de date sau în altă parte și cea mai mare parte a timpului așteaptă un răspuns.
Pur și simplu așteaptă. Aceasta nu este foarte bine. Când vin 100.000 de utilizatori, ne este foarte greu. De aceea, să luăm ca exemplu o aplicație simplă. Vom căuta imagini, de exemplu, cu pisici. Doar că nu vom căuta pur și simplu, vom extinde cuvintele cheie și, dacă utilizatorul caută „pisicuțe”, îi vom găsi pisici, pufoși și altele. Pentru început, trebuie să obținem datele cererii pe backend. Arată astfel:
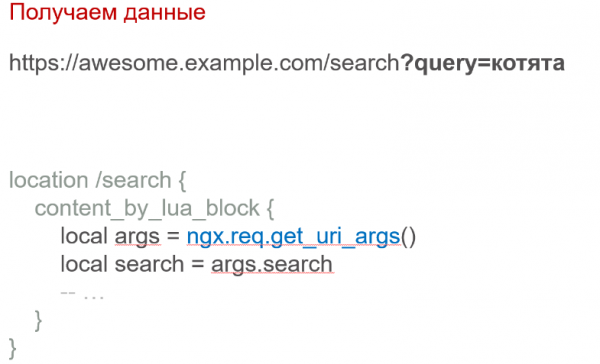
Două linii vă permit să obțineți parametrii GET, nimic complicat. Apoi, presupunem că din baza de date cu o tabelă pe cuvântul cheie și extensie obținem această informație printr-o interogare SQL obișnuită. Totul e simplu. Arată astfel:
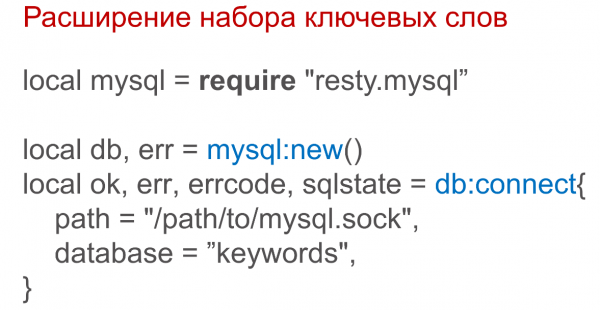
Conectăm biblioteca resty.mysql, care este deja inclusă. Nu trebuie să instalăm nimic, totul este pregătit. Specificăm cum să ne conectăm și facem interogarea SQL:
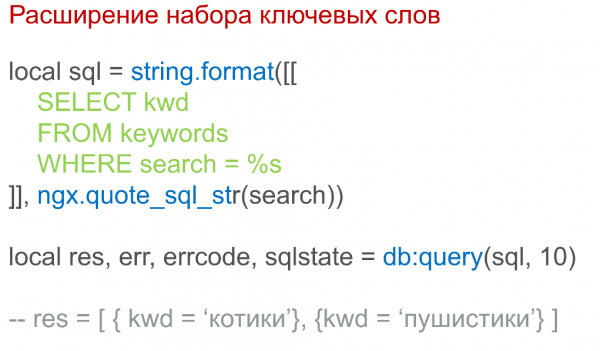
Aici este puțin înfricoșător, dar totul funcționează. Aici, 10 este limita. Extragem 10 înregistrări, suntem lenoși, nu vrem să arătăm mai mult. Am uitat de limită în SQL.
Apoi găsim imagini pentru toate cererile. Adunăm un pachet de cereri și completăm o tabelă Lua, care se numește reqs, și facem ngx.location.capture_multi.
Toate aceste cereri pleacă în paralel și primim răspunsuri. Timpul de execuție este egal cu timpul răspunsului celui mai lent. Dacă toate răspund în 50 de milisecunde și am trimis o sută de cereri, atunci răspunsul va veni în 50 de milisecunde.
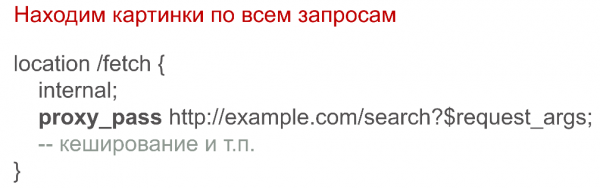
Deoarece suntem leneși și nu vrem să scriem procesare HTTP și caching, vom obliga NGINX să facă totul pentru noi. Așa cum ați văzut, a fost o cerere la url/fetch, iată-l:
Facem o simplă proxy_pass, specificăm unde să cache-uim, cum să o facem, și totul funcționează.
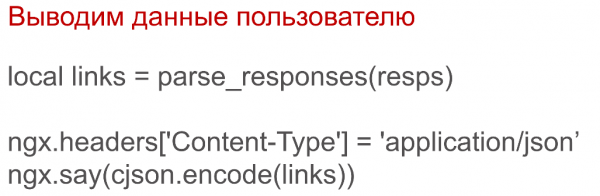
Dar asta nu este suficient, trebuie să livrăm datele utilizatorului. Cea mai simplă idee este să le serializăm în JSON, simplu, în două rânduri. Livrăm Content-Type, livrăm JSON.
Dar există o dificultate: utilizatorul nu vrea să citească JSON. Trebuie să atragem frontend-erii. Uneori, nu ne dorim să facem asta de la bun început. Și SEO-iștii vor spune că, dacă căutăm imagini, nu le pasă. Iar dacă le livrăm un fel de conținut, vor spune că motoarele noastre de căutare nu indexează nimic.
Ce putem face cu asta? Evident, vom livra utilizatorului HTML. A genera manual nu este o opțiune, așa că vrem să folosim șabloane. Pentru aceasta există o bibliotecă lua-resty-template.
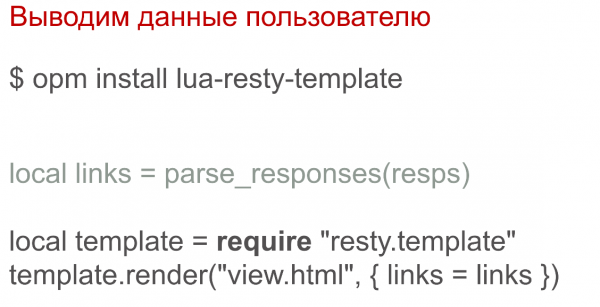
Probabil ați văzut cele trei litere terifiante OPM. OpenResty vine cu propriul manager de pachete, prin care pot fi instalate și multe module diferite, în special, lua-resty-template. Este un motor simplu de șabloane, similar cu Django templates. Acolo se pot scrie coduri și face înlocuiri de variabile.
Ca rezultat, totul va arăta aproximativ astfel:
Am preluat datele și am redat șablonul din nou în două rânduri. Utilizatorul este fericit, a primit pisici. Deoarece am extins cererea, el a primit și o robă marină, cine știe, poate căutase tocmai acel lucru, dar nu a putut formula corect cererea.
Totul este grozav, dar suntem în dezvoltare și nu vrem să le arătăm utilizatorilor deocamdată. Hai să facem autorizare. Pentru a face asta, hai să vedem cum NGINX procesează cererea în termeni de OpenResty:
- Prima fază - -token și, când utilizatorul a venit doar, iar noi l-am analizat după titluri, după adresa IP, după alte date. Îl putem elimina imediat dacă nu ne place. Aceasta poate fi utilizată pentru autorizare, sau, dacă primim foarte multe cereri, le putem bloca ușor în această fază.
- rewrite. Rescriem unele date ale cererii.
- conținut. Furnizăm conținutul utilizatorului.
- filtru de antete. Înlocuim antetele răspunsului. Dacă am folosit
proxy_pass, putem rescrie unele antete înainte de a le da utilizatorului. - filtru de corp. Putem înlocui corpul.
- log — logare. Se pot scrie loguri în elasticsearch fără un strat suplimentar.
Autorizarea noastră va arăta cam așa:
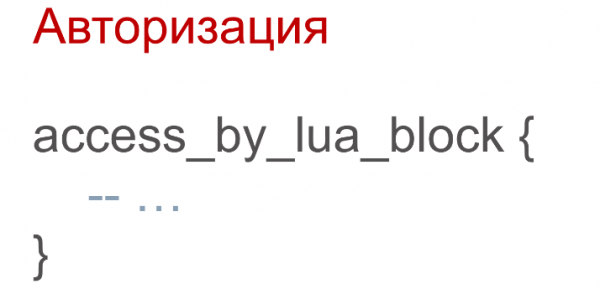
Vom adăuga asta în cel location, pe care l-am descris anterior, și vom introduce acolo un astfel de cod:
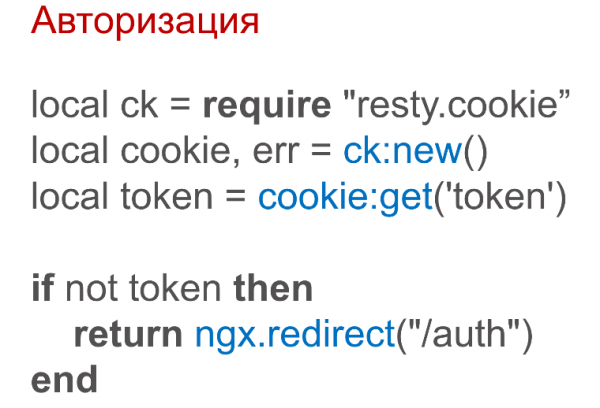
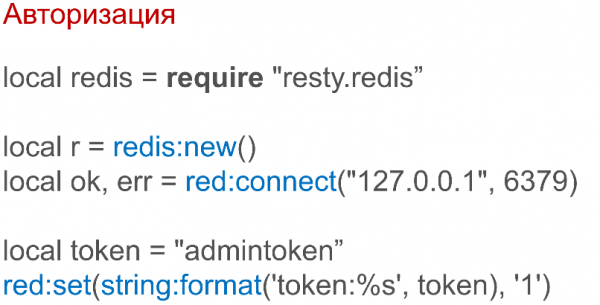
Verificăm dacă avem token cookie. Dacă nu, ne îndreptăm către autorizare. Utilizatorii sunt isteți și pot ghici că trebuie să pună token cookie. Prin urmare, o vom stoca și în Redis:
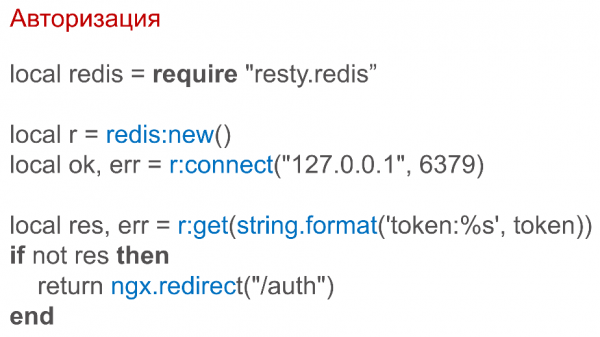
Codul de lucru cu Redis este foarte simplu și nu se deosebește de celelalte limbaje. În același timp, toată intrarea/ieșirea, atât acolo cât și aici, este non-blocantă. Dacă scrieți cod sincron, acesta funcționează asincron. Aproape ca și cu gevent, doar că este realizat bine.
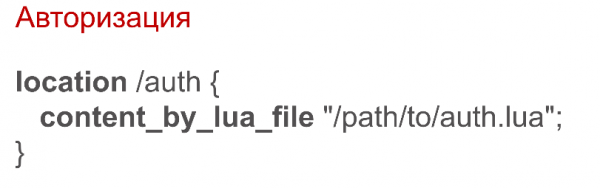
Să facem autorizația în sine:
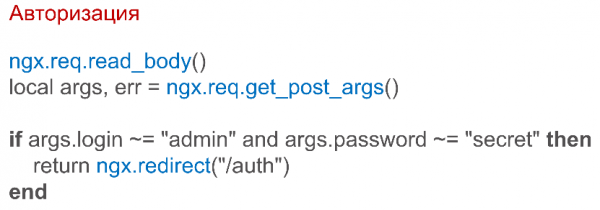
Spunem că trebuie să citim corpul cererii. Obținem argumentele POST, verificăm că numele de utilizator și parola sunt corecte. Dacă sunt greșite, ne îndreptăm către autorizare. Iar dacă sunt corecte, stocăm token în Redis:
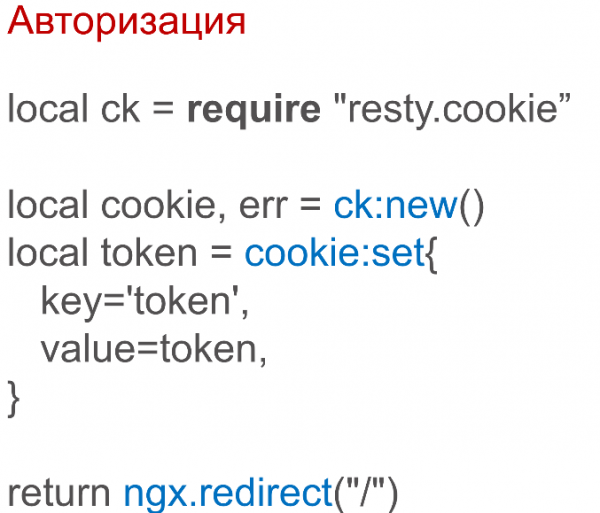
Nu uităm să setăm cookie, acest lucru se face și în două linii:
Un exemplu simplu, ipotetic. Cu siguranță nu vom face un serviciu care să arate oamenilor pisici. Deși cine știe. Așadar, să vedem ce putem face în producție.
- Backend minimalist. Uneori avem nevoie să oferim backend-ului doar câteva date: uneori trebuie să introducem o dată, uneori să prezentăm o listă, să spunem câți utilizatori sunt pe site, să atașăm un contor sau statistica. Ceva mic. Piesele minime pot fi realizate foarte ușor. Asta va ieși rapid, ușor și grozav.
- Preprocesarea datelor. Uneori, vrem să integrăm reclame în pagina noastră, iar aceste reclame le luăm prin interogări API. Este foarte ușor să facem asta aici. Nu ne încărcăm backend-ul, care oricum lucrează din greu. Putem să luăm și să construim aici. Putem să îmbinăm unele JS sau, dimpotrivă, să despărțim, să preprocessăm ceva înainte de a-l livra utilizatorului.
- Fațada pentru microserviciu. Acesta este, de asemenea, un caz foarte bun, pe care l-am implementat. În trecut, am lucrat la compania Tenzor, care se ocupă cu raportarea electronică, asigurând raportarea pentru aproximativ jumătate din persoanele juridice din țară. Am creat un serviciu, iar multe lucruri au fost realizate cu ajutorul aceleași mecanisme: rutare, autorizare și altele.
OpenResty poate fi folosit ca un lipici pentru microserviciile voastre, care va oferi un acces unificat la tot și o interfață unică. Deoarece microserviciile pot fi scrise astfel încât aici să aveți Node.js, aici PHP, aici Python, aici o soluție pe Erlang, înțelegem că nu dorim să rescriem același cod peste tot. De aceea, OpenResty poate fi integrat în front-end. - Statistică și analiză. De obicei, NGINX se află la intrare și toate cererile trec prin el. Este tocmai locul unde este foarte convenabil să adunăm date. Putem calcula ceva imediat și să le trimitem undeva, de exemplu, la Elasticsearch, Logstash sau pur și simplu să le înregistrăm în log și apoi să le trimitem mai departe.
- Sisteme multi-utilizator. De exemplu, este foarte bine să faci jocuri online. Astăzi, în Cape Town, Alexandre Gladyș va vorbi despre cum să prototipizezi rapid un joc multi-utilizator cu ajutorul OpenResty.
- Filtrarea cererilor (WAF). În prezent, este la modă să creezi diverse firewalls pentru aplicații web, sunt multe servicii care le oferă. Cu ajutorul OpenResty poți crea un firewall pentru aplicații web care va filtra cererile conform cerințelor tale, rapid și ușor. Dacă ai Python, înțelegi că PHP nu va fi injectat cu siguranță, cu condiția să nu-l lansezi din consolă în altă parte. Știi că ai MySQL și Python. Probabil că aici se pot face încercări de directory traversal și alte injectări în bază. De aceea, poți filtra rapid și ieftin cererile suspecte direct în front-end.
- Comunitate. Deoarece OpenResty este construit pe baza NGINX, are un bonus – aceasta este comunitatea NGINX. Este foarte vast, iar o parte considerabilă din întrebările pe care le veți avea la început au fost deja soluționate de comunitatea NGINX.
Dezvoltatori Lua. Ieri, am discutat cu niște colegi care au venit la ziua de training HighLoad++ și am aflat că Tarantool este singurul scris în Lua. Nu este adevărat, în Lua sunt scrise multe lucruri. Exemple: OpenResty, serverul XMPP Prosody, motorul de joc Love2D, Lua este utilizat în Warcraft și în alte locuri. Există mulți dezvoltatori Lua, iar comunitatea lor este mare și receptivă. Toate întrebările mele legate de Lua au fost rezolvate în câteva ore. Atunci când scrii pe lista de discuții, practic în câteva minute deja primești o mulțime de răspunsuri, explicând ce și cum, ce se întâmplă. Este minunat. Din păcate, nu peste tot există o comunitate așa de binevoitoare.
Despre OpenResty există GitHub, unde poți deschide un issue dacă ceva nu funcționează. Există o listă de discuții pe Google Groups, unde poți discuta întrebări generale, și există o discuție în chineză - la urma urmei, poate nu stăpânești engleza, însă ai cunoștințe de chineză.
Concluzii
- Sper că am reușit să transmit faptul că OpenResty este un framework foarte confortabil, special conceput pentru web.
- Are o barieră de intrare scăzută, deoarece codul este similar cu ceea ce scriem, iar limbajul este destul de simplu și minimalist.
- Oferă I/O asincron fără callbacks, nu vom avea complexitatea pe care uneori o scriem în NodeJS.
- Are un deployment ușor, deoarece avem nevoie doar de NGINX cu modulul necesar și codul nostru, și totul funcționează imediat.
- O comunitate mare și receptivă.
Nu am explicat în detaliu cum se face rutarea, ar fi ieșit un discurs foarte lung.
Vă mulțumesc pentru atenție!
Sursa: habr.com
