

Mii de manageri din birourile de vânzări din întreaga țară înregistrează în zeci de mii de contacte zilnic — fapte de comunicare cu clienți potențiali sau deja activi. Dar pentru acest client, trebuie mai întâi să-l găsim și, ideal, foarte repede. Acest lucru se întâmplă cel mai adesea după nume.
Prin urmare, nu este de mirare că, analizând din nou „cazurile grele” pe una dintre cele mai încărcate baze — contul nostru corporativ SBIS o cerere pentru „căutarea rapidă” după nume pentru fișele organizațiilor. De altfel, o investigație ulterioară a relevat un exemplu interesant
de optimizare inițială, iar apoi degradarea performanței cererii în urma dezvoltării sale succesive de către mai multe echipe, fiecare acționând exclusiv din cele mai bune intenții. 0: ce dorea utilizatorul
[KDPV
 Ce înseamnă, de obicei, utilizatorul când vorbește despre „căutare rapidă” după nume? De cele mai multe ori, aceasta nu se dovedește a fi o căutare „corectă” după substring-uri de tipul ]
... LIKE '%floare%' — pentru că atunci în rezultate sunt incluse nu doar 'Floarerie' 'Magazin Floare' și 'Gfloare', ci și 'Casa Bunului Floare' și chiar Utilizatorul presupune la nivel de bază că îi veți oferi.
căutare după începutul cuvântului în nume și veți arăta ceea ce este mai relevant începând cu ce a fost introdus. Și veți face asta practic instantaneu — la introducerea substring-ului. 1: limităm sarcina
Și cu atât mai puțin nu va exista o persoană care să introducă special
'floare magazin' , astfel încât să căutați prefixat fiecare cuvânt. Nu, utilizatorului îi este mult mai simplu să reacționeze la sugestia rapidă pentru ultimul cuvânt decât să „introducă insuficient” anterior — uitați-vă cum funcționează orice motor de căutare.În general,
a formula cerințele pentru sarcină este mai mult de jumătate din soluție. Uneori, o analiză atentă a use case-ului să poate influența semnificativ rezultatul .
1.0: motor de căutare extern
Ups, căutarea este complicată, nu-mi place deloc să mă ocup de ea — hai să dăm asta devops-ului! Să ne dezvolte o sistem de căutare externă, relativ la baza de date: Sphinx, ElasticSearch,…
Ой, поиск это сложно, что-то вообще им заниматься не хочется — давайте отдадим это devops! Пусть они нам развернут внешнюю относительно БД поисковую систему: Sphinx, ElasticSearch,…
O opțiune de lucru, deși laborioasă în ceea ce privește sincronizarea și rapiditatea modificărilor. Dar nu este cazul nostru, deoarece căutarea se efectuează pentru fiecare client doar în cadrul datelor contului său. Iar datele au o volatilitate destul de mare — și dacă acum managerul a introdus un card 'Magazinul Roza', atunci în 5-10 secunde poate să-și amintească că a uitat să menționeze email-ul și va dori să-l găsească și să-l corecteze.
Prin urmare — haideți să căutăm „direct din bază”. Din fericire, PostgreSQL ne permite să facem acest lucru, și nu într-un singur mod — le vom analiza.
1.1: „substring” corect
Ne prindem de cuvântul „substring”. Și există un modul excelent pentru căutarea prin substring (și chiar și prin expresii regulate!) ! Numai că va trebui să le sortăm corect mai târziu.
Hai să încercăm să luăm pentru simplificare un astfel de tabel:
CREATE TABLE firms(
  id
    serial
      PRIMARY KEY
, name
    text
);
Încărcăm acolo 7,8 milioane de înregistrări ale organizațiilor reale și le indexăm:
CREATE EXTENSION pg_trgm;
CREATE INDEX ON firms USING gin(lower(name) gin_trgm_ops);
Să căutăm primele 10 înregistrări pentru căutarea substring-ului:
SELECT
  *
FROM
  firms
WHERE
  lower(name) ~ ('(^|s)' || 'roza')
ORDER BY
  lower(name) ~ ('^' || 'roza') DESC -- mai întâi "cele care încep cu"
, lower(name) -- restul în ordine alfabetică
LIMIT 10;
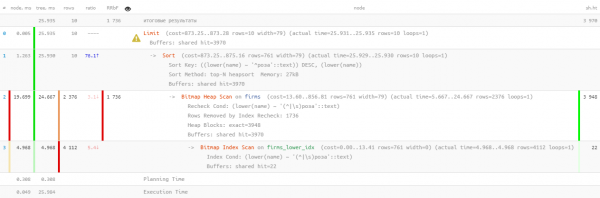
Ei bine, așa... 26ms, 31MB de date citite și mai mult de 1.7K înregistrări filtrate — pentru cele 10 căutate. Cheltuielile sunt prea mari, nu putem să facem cumva mai eficient?
1.2: căutare pe text? este FTS!
Într-adevăr, PostgreSQL oferă un mecanism foarte puternic (Full Text Search), inclusiv cu posibilitatea căutării prefixate. O opțiune excelentă, nu este necesar să instalăm extensii! Hai să încercăm:
CREATE INDEX ON firms USING gin(to_tsvector('simple'::regconfig, lower(name)));SELECT
*
FROM
firms
WHERE
to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'roza:*')
ORDER BY
lower(name) ~ ('^' || 'roza') DESC
, lower(name)
LIMIT 10; 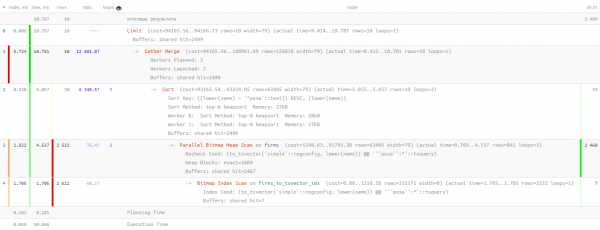
Aici ne-a ajutat un pic paralele execuției interogării, reducând timpul la 11ms. De asemenea, am citit cu 1,5 ori mai puțin — doar 20MB. Iar aici, cu cât mai puțin, cu atât mai bine, pentru că cu cât citim un volum mai mare, cu atât mai mari sunt șansele de a obține un cache miss, și fiecare pagină de date citită în plus de pe disc este potențiale „încetiniri” pentru interogare.
1.3: totuși LIKE?
Toate interogările anterioare sunt bune, dar dacă o să le rulăm de o sută de mii de ori pe zi, se va strânge deja 2TB de date citite. În cel mai bun caz — din memorie, dar dacă nu avem noroc, atunci și de pe disc. Așa că haideți să încercăm să îl facem mai mic.
Să ne amintim că utilizatorul dorește să vadă mai întâi „care încep cu ...”. Asta este pur și simplu folosind text_pattern_ops! Și doar dacă nu ne ajung „” până la 10 înregistrări căutate, atunci va trebui să le citim folosind căutarea FTS:
CREATE INDEX ON firms(lower(name) text_pattern_ops);SELECT
*
FROM
firms
WHERE
lower(name) LIKE ('roza' || '%')
LIMIT 10; 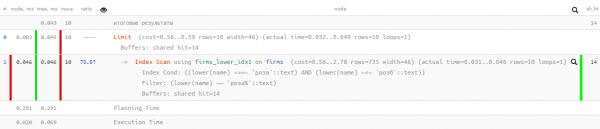
Indici excelent — doar 0.05ms și puțin peste 100KB citiți! Numai că am uitat să sortăm după nume, pentru ca utilizatorul să nu se piardă în rezultate:
SELECT
  *
FROM
  firms
WHERE
  lower(name) LIKE ('roza' || '%')
ORDER BY
  lower(name)
LIMIT 10; 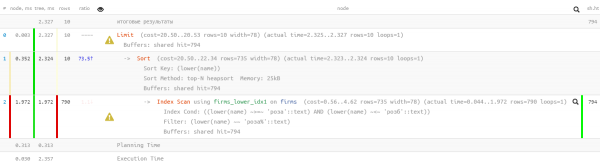
Oh, deja nu mai arată atât de bine — deși există un index, dar sortarea trece pe lângă el… Sigur că este cu mult mai eficient decât varianta anterioară, dar…
1.4: „a rafina cu pilula”
Dar există un index care permite căutarea pe interval și folosește sortarea corect — btree obișnuit!
CREATE INDEX ON firms(lower(name));Doar că interogarea pentru acesta va trebui „să fie adunată manual”:
SELECT
  *
FROM
  firms
WHERE
  lower(name) >= 'roza' AND
  lower(name) <= ('roza' || chr(65535)) -- pentru UTF8, pentru coduri pe un singur byte - chr(255)
ORDER BY
   lower(name)
LIMIT 10; 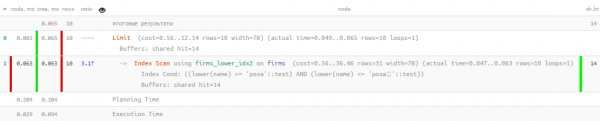
Excelent — funcționează și sortarea, și consumul de resurse a rămas „microscopi” de o mie de ori mai eficient decât „pur” FTS! Rămâne să adunăm într-o singură interogare:
(
  SELECT
    *
  FROM
    firms
  WHERE
    lower(name) >= 'roza' AND
    lower(name) <= ('roza' || chr(65535)) -- pentru UTF8, pentru coduri pe un singur byte - chr(255)
  ORDER BY
     lower(name)
  LIMIT 10
)
UNION ALL
(
  SELECT
    *
  FROM
    firms
  WHERE
    to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'roza:*') AND
    lower(name) NOT LIKE ('roza' || '%') -- „care încep cu” le-am găsit deja mai sus
  ORDER BY
    lower(name) ~ ('^' || 'roza') DESC -- folosim aceeași sortare pentru a NU merge pe indexul btree
  , lower(name)
  LIMIT 10
)
LIMIT 10;
Observ că al doilea subală se execută doar dacă primul a returnat mai puțin decât se aștepta ultimul LIMIT numărul de rânduri. Despre această metodă de optimizare a interogărilor am .
Așadar, acum avem un index btree și gin pe tabel simultan, totuși statistic a rezultat că mai puțin de 10% din interogări ajung la executarea celui de-al doilea bloc. Adică, în condițiile cunoscute dinainte pentru problema noastră, am reușit să reducem consumul total de resurse ale serverului practic de o mie de ori!
1.5*: ne vom folosi un șmirghel
Mai sus LIKE ne-a împiedicat să folosim o sortare incorectă. Dar poate fi „îndreptată” cu ajutorul operatorului USING:
Implicit se subînțelege
ASC. În plus, se poate specifica numele unui operator de sortare specific în propozițieUSING. Operatorul de sortare trebuie să fie membru al „mai mic” sau „mai mare” dintr-o anumită familie de operatori B-tree.ASCde obicei echivalentUSING <șiDESCde obicei echivalentUSING >.
În cazul nostru, „mai mic” este ~<~:
SELECT
  *
FROM
  firms
WHERE
  lower(name) LIKE ('rădescu' || '%')
ORDER BY
  lower(name) USING ~<~
LIMIT 10; 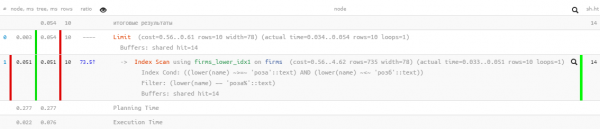
2: cum „se strică” cererile
Acum lăsăm cererea noastră să „deze” timp de șase luni - un an, și cu surprindere o descoperim din nou „în top” cu indicatori de „creștere” zilnică a memoriei (buffers shared hit) în 5.5TB — adică chiar mai mult decât era inițial.
Nu, desigur, și afacerea noastră a crescut, și încărcarea s-a intensificat, dar nu atât de mult! Asta înseamnă că ceva nu e în regulă — să investigăm.
2.1: nașterea paginării
Într-un anumit moment, altui grup de dezvoltatori le-a venit ideea să facă posibilă „sări” din căutarea rapidă într-o registă cu aceleași, dar extinse rezultate. Și ce registru fără navigare pe pagini? Să adăugăm!
( ... LIMIT  + 10)
UNION ALL
( ... LIMIT  + 10)
LIMIT 10 OFFSET ;
Acum putea fi ușor pentru dezvoltator să afișeze registrul rezultatelor căutării cu o „încărcare de tip pagină”.
Desigur, de fapt, pentru fiecare pagină următoare de date se citește din ce în ce mai mult (tot din ultimele cazuri, pe care le vom elimina, plus „codița” necesară) — adică acesta este un antipatron clar. Ar fi fost mai corect să inițiem căutarea pe următoarea iterație de la cheia memorată în interfață, dar despre aceasta — altă dată.
2.2: vrea exotic
Într-un anumit moment, dezvoltatorului i-a venit ideea de a diversifica selecția rezultantă cu date dintr-un alt tabel, pentru care întreaga cerere anterioară a fost trimisă în CTE:
WITH q AS (
  ...
  LIMIT  + 10
)
SELECT
  *
, (SELECT ...) sub_query -- o cerere către un tabel asociat
FROM
  q
LIMIT 10 OFFSET ;
Și chiar așa — nu arată rău, deoarece cererea încorporată este calculată doar pentru cele 10 înregistrări returnate, dacă nu ar fi…
2.3: DISTINCT fără sens și nemilos
Undeva în procesul acestei evoluții din al doilea subquery s-a pierdut NOT LIKE condiția. Este clar că după aceasta UNION ALL a început să returneze unele înregistrări de două ori — mai întâi cele găsite după începutul șirului, iar apoi din nou — după începutul primului cuvânt din acest șir. În limita maximă, toate înregistrările din al doilea subinterogare ar fi putut coincide cu înregistrările primului.
Ce face dezvoltatorul în loc să caute cauza?.. Nicio întrebare!
- să dublăm dimensiunea surselor originale
- să aplicăm DISTINCT, pentru a avea doar instanțe unice ale fiecărui șir
WITH q AS (
  ( ... LIMIT  + 10)
  UNION ALL
  ( ... LIMIT  + 10)
  LIMIT  + 10
)
SELECT DISTINCT
  *
, (SELECT ...) sub_query
FROM
  q
LIMIT 10 OFFSET ;
Adică este clar că rezultatul, în cele din urmă, este exact același, dar șansa de a „zăbovi” în al doilea subinterogare CTE a crescut semnificativ, și astfel. se citește evident mai mult.
Dar asta nu e cea mai mare problemă. Deoarece dezvoltatorul a cerut să selecteze DISTINCT nu pe câmpuri specifice, ci pe toate câmpurile înregistrările, așa că s-a inclus automat și câmpul sub_query — rezultatul subinterogării. Acum, pentru a executa DISTINCT, baza a trebuit să execute deja nu 10 subinterogări, ci toate + 10!
2.4: cooperarea este pe primul loc!
Așa au trăit dezvoltatorii — fără îngrijorări, pentru că în registru „a ajusta” valorile esențiale N, într-o situație de încetinire cronică a obținerii fiecărei „pagini” următoare, utilizatorul evident nu avea răbdare.
Până când au venit dezvoltatorii din alt departament și au dorit să folosească o metodă atât de convenabilă pentru căutarea iterativă — adică luăm un fragment dintr-un set, filtrăm după condiții suplimentare, generăm rezultatul, apoi următorul fragment (ceea ce în cazul nostru se realizează prin creșterea lui N), și așa până umplem ecranul.
În general, înregistrarea prinsă N a atins valori aproape de 17K, iar în total, în decurs de o zi au fost executate „în lanț” nu mai puțin de 4K astfel de interogări. Ultimele dintre ele au fost scanate deja pe 1GB de memorie la fiecare iterație…
În concluzie
Sursa: habr.com
