

Bună! Numele meu este Alexey Pyankov, sunt dezvoltator la compania Sportmaster. În acest am povestit cum a început munca asupra site-ului Sportmaster în anul 2012, ce inițiative am reușit să „împingem” și, dimpotrivă, ce capcane am întâmpinat.
Astăzi vreau să împărtășesc gândurile care urmează unui alt subiect – alegerea sistemului de cache pentru backend-ul java din administrarea site-ului. Acest subiect are o semnificație specială pentru mine – deși povestea s-a desfășurat doar pe parcursul a 2 luni, în acești 60 de zile am lucrat 12-16 ore pe zi, fără zi liberă. Niciodată nu m-am gândit și nu mi-am imaginat că se poate muncii atât de mult.
Prin urmare, textul va fi împărțit în 2 părți, pentru a nu suprasolicita. Din contră, prima parte va fi foarte ușoară — o pregătire, o introducere, câteva considerații despre ce este caching-ul. Dacă ești deja un dezvoltator experimentat sau ai lucrat cu cache-uri – din punct de vedere tehnic, în acest articol probabil nu va fi nimic nou. Dar pentru un junior, un mic astfel de rezumat poate sugera în ce direcție să se uite în cazul în care se află la o astfel de răscruce.
Când noua variantă a site-ului Sportmaster a fost lansată în producție, datele erau primite într-un mod, să spunem, nu foarte convenabil. La bază erau tabele pregătite pentru vechea versiune a site-ului (Bitrix), care trebuiau integrate în ETL, transformate în noul format și îmbogățite cu diverse elemente din încă alte zeci de sisteme. Pentru ca o nouă imagine sau descriere a produsului să apară pe site, trebuia să aștepți până a doua zi — actualizarea se efectua doar noaptea, o dată pe zi.
La început, erau atât de multe griji în primele săptămâni de lansare în producție, încât asemenea inconveniente pentru managerii de conținut păreau nesemnificative. Dar, pe măsură ce lucrurile s-au stabilizat, dezvoltarea proiectului a continuat — după câteva luni, la începutul anului 2015, am început să lucrăm intens la interfața de administrare. În 2015 și 2016, totul a mers bine, am avut lansări regulate, interfața de administrare a acoperit o parte tot mai mare a procesării datelor, iar noi ne pregăteam pentru ceea ce urma să fie încredințat echipei noastre — conturul de produse (pregătirea completă și gestionarea datelor pentru toate produsele). Dar în vara anului 2017, chiar înainte de lansarea conturului de produse, proiectul s-a aflat într-o situație foarte complicată — din cauza problemelor de caching. Despre acest episod vreau să povestesc în a doua parte a acestei publicații în două episoade.
Dar în această postare voi începe din depărtare, sintetizând câteva gânduri — impresii despre caching, care ar fi fost un pas bun să fie revizuite înainte de un proiect mare.
Când apare sarcina de caching
Sarcina de caching nu apare pur și simplu. Noi, dezvoltatorii, creăm un produs software și vrem să fie cerut. Dacă produsul este cerut și de succes — utilizatorii vin. Și tot mai mulți vin. Și astfel, ajungem la un număr foarte mare de utilizatori și produsul devine supraaglomerat.
În primele etape, nu ne gândim la optimizarea și performanța codului. Principalul este funcționalitatea, să lansăm rapid un prototip și să verificăm ipotezele. Și dacă încărcarea crește – ne îmbunătățim echipamentele. Creștem de două, trei, cinci ori, lăsăm să fie chiar de zece ori. Aici, finanțele nu vor mai permite. Dar cu cât va crește numărul utilizatorilor? Nu va fi vorba de 2-5-10, ci, în cazul succesului, va fi de la 100-1000 și până la 100.000 de ori. Așadar, mai devreme sau mai târziu, va trebui să ne ocupăm de optimizare.
Să presupunem că o parte din cod (să numim această parte funcție) funcționează extrem de lent și dorim să reducem timpul de executare. Funcția poate fi un acces la baza de date, poate fi executarea unei logici complexe — important este că durează mult. Cu cât putem reduce timpul de execuție? Teoretic, putem reduce la zero, nu mai departe. Cum putem reduce timpul de execuție la zero? Răspuns: excluzând complet execuția. În loc de aceasta, întoarcem imediat rezultatul. Cum putem afla rezultatul? Răspuns: fie calculând, fie consultând undeva. Calculul durează mult. Iar consultarea înseamnă, de exemplu, a salva acel rezultat pe care funcția l-a generat data trecută, când a fost apelată cu aceleași parametru.
Deci, implementarea funcției nu este importantă pentru noi. E suficient să știm de ce parametrii depinde rezultatul. Așadar, dacă valorile parametrilor sunt reprezentate sub formă de obiect, care poate fi folosit ca o cheie într-un anumit spațiu de stocare — atunci rezultatul calculului poate fi păstrat și la următoarea accesare considerat. Dacă aceste operații de scriere și citire a rezultatului se desfășoară mai repede decât executarea funcției – avem un profit de viteză. Mărimea profitului poate atinge de 100, 1000 sau 100.000 de ori (10^5 – aceasta este mai degrabă o excepție, dar în cazul unei baze de date care funcționează prost, este complet posibil).
Cerințele principale pentru sistemul de caching
Primul lucru care poate deveni o cerință pentru sistemul de caching — viteza rapidă de citire și, într-o măsură ușor mai mică, viteza de scriere. Așa este, dar doar până nu punem sistemul în producție.
Să discutăm un astfel de caz.
Să presupunem că am furnizat hardware-ul necesar pentru sarcina curentă și acum începem treptat implementarea caching-ului. Numărul utilizatorilor crește puțin, sarcina crește – adăugăm puțin cache, integrăm aici și acolo. Aceasta continuă o vreme și, iată, funcțiile grele aproape că nu mai sunt apelate — toată sarcina principală se află pe cache. Numărul utilizatorilor a crescut în acest timp de N ori.
Și dacă resursele inițiale de hardware ar fi putut fi de 2-5 ori, atunci cu ajutorul caching-ului am putea îmbunătăți performanța de 10 ori sau, în cel mai bun caz, de 100 de ori, uneori, poate chiar de 1000 de ori. Adică, pe același hardware – procesăm de 100 de ori mai multe cereri. Minunat, am meritat un bonus!
Dar acum, într-o zi frumoasă, din întâmplare, sistemul a cedat și cache-ul a picat. Nimic special – deoarece cache-ul a fost ales în funcție de cerința „viteză mare de citire și scriere, restul nu este important”.
În ceea ce privește încărcarea inițială, am avut o rezervă de hardware de 2-5 ori, iar încărcarea în acest timp a crescut de 10-100 de ori. Cu ajutorul cache-ului am exclus apelurile pentru funcțiile grele și, astfel, totul mergea strună. Iar acum, fără cache – cu cât va scădea sistemul nostru? Ce se va întâmpla? Sistemul va cădea.
Chiar dacă cache-ul nostru nu a cedat, ci doar s-a șters temporar – va trebui să-l reîncălzim, iar acest lucru va dura ceva timp. Și pentru această perioadă – întreaga încărcare va cădea pe funcționalitate.
Concluzie: proiectele cu o încărcare ridicată în producție necesită de la sistem un cache care nu doar că trebuie să fie rapid în citire și scriere, dar și să păstreze datele și să fie rezistent la defecțiuni.
Dilema alegerii
În proiectul cu admin, alegerea s-a desfășurat astfel: mai întâi am implementat Hazelcast, deoarece deja eram familiarizați cu acest produs din experiența site-ului principal. Dar, aici această alegere s-a dovedit a fi nereușită – pentru profilul nostru de încărcare, Hazelcast funcționează nu doar lent, ci extrem de lent. Și în legătură cu termenul de livrare în producție, noi la acel moment deja semnaserăm.
Spoiler: cum s-au desfășurat circumstanțele astfel încât am ratat o problemă atât de mare și am ajuns într-o situație critică și tensionată – voi povesti în partea a doua — și cum ne-am găsit, și cum am ieșit. Dar acum – voi spune doar că a fost un stres intens, iar „să gândim – pur și simplu nu gândim, agitam sticla”. „Agităm sticla” – acesta este și un spoiler, despre asta puțin mai departe.
Ce am făcut:
- Am întocmit o listă cu toate sistemele sugerate de Google și StackOverflow. Puțin peste 30.
- Am scris teste cu o încărcare caracteristică pentru producție. Pentru aceasta, am înregistrat datele care circulă prin sistem într-un mediu de producție – un fel de sniffer pentru date, nu în rețea, ci în interiorul sistemului. În teste am folosit exact aceste date.
- Întreaga echipă, fiecare alege un sistem din listă, îl configurează, rulează teste. Dacă testul nu trece, nu suportă încărcarea – eliminăm, trecem la următorul din ordine.
- La al 17-lea sistem a devenit clar că totul este fără speranță. S-a terminat cu „agitarea sticlei”, este timpul să ne gândim serios.
Dar este este un scenariu în care trebuie să alegi un sistem care „se încadrează în viteză” în teste pregătite dinainte. Și dacă aceste teste nu există încă și vrei să alegi mai repede?
Să ne imaginăm un astfel de scenariu (e greu de imaginat că un dezvoltator de nivel mediu+ trăiește în vid și că, în momentul alegerii, nu și-a exprimat deja preferințele cu privire la ce produs ar trebui să încerce mai întâi — așadar, considerațiile ulterioare sunt mai degrabă teoretice / filozofice / despre juniori).
După ce ne-am definit cerințele, vom începe să alegem o soluție din cutie. De ce să reinventăm roata: vom lua un sistem de caching gata făcut.
Dacă abia începi și vei căuta pe Google, ordinea va fi, mai mult sau mai puțin, aceasta, dar în general, reperele vor fi astfel. În primul rând, vei da peste Redis, care este foarte familiar. Apoi vei afla că există EhCache, cea mai veche și testată soluție. Urmează Tarantool — o dezvoltare autohtonă care are un aspect unic al soluției. Și desigur Ignite, deoarece acum este în vârful popularității și beneficiază de suport din partea SberTech. La final, mai este Hazelcast, care apare frecvent în mediul enterprise al marilor companii.
Aceasta nu e o listă exhaustivă, există zeci de sisteme. Dar noi ne vom concentra doar pe unul. Vom lua cele 5 sisteme alese pentru un „concurs de frumusețe” și vom face o selecție. Cine va fi câștigătorul?
Redis
Citind ceea ce scrie pe site-ul oficial.
— un proiect opensource. Oferă stocare de date în memorie, posibilitatea de stocare pe disc, fragmentare automată în partiții, disponibilitate ridicată și recuperare după întreruperi de rețea.
Pare că totul e excelent, putem să-l luăm și să-l integrăm — face tot ce trebuie. Dar haideți să ne uităm, din curiozitate, și la ceilalți candidați.
EhCache
— „cel mai utilizat cache pentru Java” (traducerea sloganului de pe site-ul oficial). Tot opensource. Și aici înțelegem că Redis nu e specific pentru Java, ci universal, iar pentru interacțiunea cu el este nevoie de un wrapper. EhCache va fi mai convenabil. Ce altceva promite acest sistem? Fiabilitate, testare, funcționalitate completă. Și este, de asemenea, cel mai răspândit. Cache-uiește terabytes de date.
Redis a fost uitat, sunt gata să aleg EhCache.
Dar sentimentul de patriotism mă împinge să văd ce are bun Tarantool.
Tarantool
— întâmpină denumirea „Platforma de integrare a datelor în timp real”. Suna foarte complicat, așa că citim pagina în detaliu și găsim o afirmație răsunătoare: „Cachează 100% din datele în memorie”. Aceasta ar trebui să ridice întrebări — deoarece datele pot fi semnificativ mai multe decât memoria. Decriptarea este că aici se înțelege că, pentru a scrie datele pe disc din memorie, Tarantool nu efectuează serializarea. În schimb, folosește caracteristici de bază ale sistemului, când memoria este pur și simplu mapată la sistemul de fișiere cu foarte bune performanțe I/O. În general, au făcut ceva remarcabil și cool.
Să ne uităm la implementări: Mail.ru, Avito, Beeline, Megafon, Alfa-Bank, Gazprom…
Dacă mai aveam vreo îndoială cu privire la Tarantool, cazul de implementare în Mastercard m-a convins. Îmi iau Tarantool.
Dar totuși…
Ignite
… mai este , declarat ca „platformă de calcul in-memory… viteze in-memory pe petabytes de date”. Aici sunt multe avantaje: cache in-memory distribuit, cea mai rapidă soluție key-value și cache, scalabilitate orizontală, disponibilitate ridicată, integritate strictă. În general, se dovedește că cel mai rapid este Ignite.
Implementări: Sberbank, American Airlines, Yahoo! Japan. Și apoi mai aflăm că Ignite nu este doar implementat în Sberbank, ci echipa SberTech își trimite oamenii în echipa Ignite pentru a îmbunătăți produsul. Asta mă convinge complet și sunt pregătit să aleg Ignite.
Complet neclar de ce, mă uit la punctul cinci.
Hazelcast
Intru pe site , citesc. Și se pare că cea mai rapidă soluție pentru caching distribuit este Hazelcast. Este cu mult mai rapid decât toate celelalte soluții și de fapt este lider în domeniul in-memory data grid. În comparație cu acest lucru, a alege altceva ar fi o lipsă de respect față de sine. Mai folosește stocarea redundantă a datelor pentru a asigura funcționarea continuă a clusterei fără pierderi de date.
Totul, sunt pregătit să aleg Hazelcast.
Comparare
Dar dacă ne uităm, toate cele cinci candidate sunt descrise astfel încât fiecare dintre ele este cea mai bună. Cum să alegem? Putem vedea care este cel mai popular, să căutăm comparări și durerea de cap va dispărea.
Găsim o astfel de , alegem cele 5 sisteme.
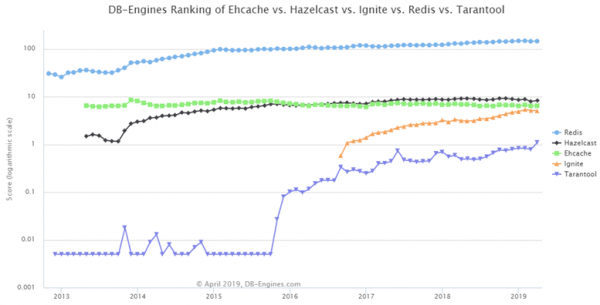
Acestea sunt sortate aici: sus Redis, pe locul doi — Hazelcast, Tarantool și Ignite câștigă popularitate, iar EhCache rămâne la fel ca înainte.
Dar să ne uităm la : linkuri către site-uri web, interes comun pentru sistem, oferte de muncă — minunat! Asta înseamnă că, atunci când sistemul meu va cădea, voi spune: „Nu, este de încredere! Sunt multe oferte de muncă…”. O astfel de comparație simplă nu va funcționa.
Toate aceste sisteme nu sunt doar sisteme pentru caching. Ele au foarte multe funcționalități, inclusiv – când datele nu sunt transferate clientului pentru procesare, ci invers: codul care trebuie executat pe date se mută pe server, acolo se execută și rezultatul este returnat. Și ca sistem separat pentru caching nu sunt considerate prea des.
Bine, nu ne predăm, să găsim o comparație directă între sisteme. Să luăm două opțiuni de top — Redis și Hazelcast. Ne interesează viteza, așa că le comparăm pe acest parametru.
Hz versus Redis
Găsim așa ceva :
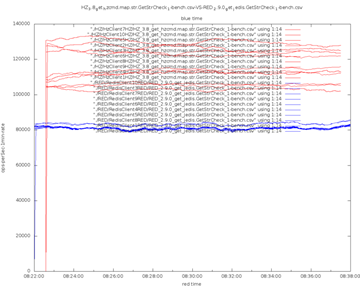
Albastru este Redis, roșu Hazelcast. Hazelcast câștigă în toate privințele, iar acest lucru este justificat: este multi-threaded, foarte optimizat, fiecare fir de execuție lucrează cu propria partiție, așa că nu apar blocaje. Redis, pe de altă parte, este single-threaded și nu beneficiază de CPU-uri moderne multi-core. Hazelcast utilizează I/O asincron, în timp ce Redis-Jedis folosește socket-uri blocante. În cele din urmă, Hazelcast folosește un protocol binar, iar Redis este orientat pe text, adică este ineficient.
Pentru siguranță, să ne referim la o altă sursă de comparație. Ce ne va arăta aceasta?
Redis versus Hz
Încă una :
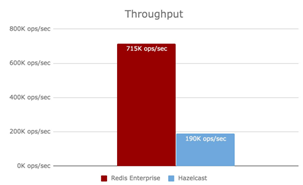
Aici, invers, roșu este Redis. Asta înseamnă că Redis câștigă în performanță față de Hazelcast. În prima comparație, câștiga Hazelcast, iar în a doua — Redis. au explicat foarte clar de ce în comparația anterioară a câștigat Hazelcast.
Se pare că rezultatul primului a fost practic falsificat: Redis a fost luat din cutie, iar Hazelcast a fost ajustat pentru cazul de test. Așa că, pe de o parte, nimănui nu trebuie să-i credem, iar pe de altă parte, atunci când totuși alegem un sistem, trebuie să-l configurăm corect. Aceste configurații includ zeci, aproape sute de parametri.
Agităm sticla
Și întregul proces pe care l-am parcurs acum îl pot explica cu o metaforă Agităm sticla. Asta înseamnă că, în acest moment, nu trebuie să programăm, ci să știm să citim stackoverflow. Și am în echipa mea o persoană, un profesionist, care exact așa lucrează în momentele critice.
Ce face el? Observă o unealtă nefuncțională, vede stack trace-ul, ia câteva cuvinte din el (care anume — acesta este expertiza lui în program), caută pe Google, găsește Stack Overflow printre răspunsuri. Fără să citească, fără să se gândească, printre răspunsurile la întrebare — alege ceva cel mai apropiat de propoziția «fă asta și asta» (a alege un astfel de răspuns este talentul lui, pentru că nu întotdeauna este exact acel răspuns care a adunat cele mai multe like-uri), aplică, se uită: dacă s-a schimbat ceva, atunci excelent. Dacă nu s-a schimbat — revenim. Și repetăm lansarea-verificarea-căutarea. Și astfel, printr-un proces intuitiv, reușește, după un timp, să facă codul să funcționeze. Nu știe de ce, nu știe ce a făcut, nu poate explica. Dar! Această unealtă funcționează. Și „incendiul este stins”. Acum începem să ne dăm seama ce am făcut. Când programul funcționează — este cu mult mai ușor. Și economisește semnificativ timp.
Această metodă se explică foarte bine prin următorul exemplu.
Cândva, era foarte popular să construiești un velier în sticlă. Velierul este mare și fragil, iar gura sticlei foarte îngustă, nu poate fi împins în interior. Cum să-l construiești?
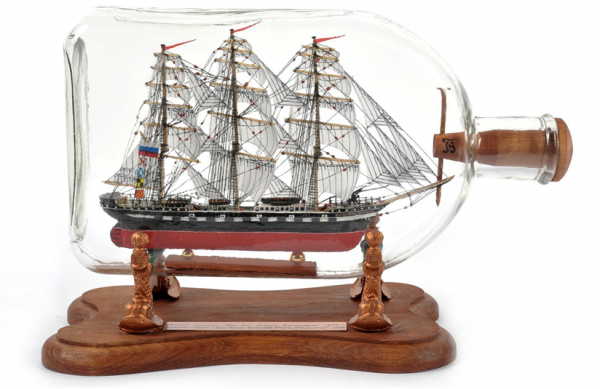
Există o metodă, foarte rapidă și foarte eficientă.
Nava este compusă dintr-o mulțime de detalii: bețe, sfori, pânze, adeziv. Toate acestea le punem în sticlă.
Luăm sticla cu două mâini și începem să o agitam. O agităm-agităm. Și de obicei — iese o prostie completă, desigur. Dar uneori. Uneori iese o navă! Mai exact, ceva asemănător unei nave.
Le arătăm acea ceva cuiva: „Serio, vezi!?”. Și într-adevăr, de la distanță — parcă ar fi o navă. Dar mai departe nu trebuie lăsată.
Există încă o metodă. O folosesc baietii mai avansați, cum ar fi hackerii.
Am dat o sarcină unui astfel de tip, el a făcut totul și a plecat. Și te uiți — părea că este făcut. Dar după un timp, când trebuie să lucrezi din nou la cod — acolo încep niște probleme din cauza lui... Bine că a reușit să se îndepărteze destul de mult. Aceștia sunt genii care, folosindu-se de exemplul sticlei, fac așa: vedeți, acolo unde este fundul – sticla se apleacă. Și nu este foarte clar dacă este transparent sau nu. Atunci hackerii „taie” acest fund, introduc nava acolo, apoi lipesc din nou fundul, și de parcă așa a fost întotdeauna.
Din perspectiva stabilirii sarcinii, totul pare corect. Dar, luând exemplul navelor: de ce să construiești o astfel de navă, cui îi este necesară? Nu are nici o funcționalitate. De obicei, aceste nave sunt cadouri pentru persoane foarte importante, care le pun pe un raft deasupra lor, ca un simbol, un semn. Și, dacă o astfel de persoană, un lider de afaceri sau un oficial de rang înalt, are o astfel de 'amăgire' ca steag, la care i s-a tăiat gura, ar fi mai bine să nu afle niciodată despre asta. Așadar, cum se fac, de fapt, aceste nave care pot fi dăruite unei persoane importante?
Singurul loc, esențial, cu care nu se poate face nimic, este corpul navei. Și corpul navei tocmai trece prin gura sticlei. În timp ce nava este asamblată în afara sticlei. Dar nu este doar o simplă asamblare, este o adevărată artă meșteșugărească. Se adaugă brațe speciale în componente, care permit ulterior ridicarea acestora. De exemplu, se pliază pânzele, se aduc cu grijă înăuntru, și apoi, cu ajutorul unei pensete, se ridică foarte cu atenție, precis. Ca rezultat, este o operă de artă, pe care o poți dărui cu o conștiință curate și mândrie.
Și dacă dorim ca proiectul să fie de succes – în echipă trebuie să fie cel puțin o persoană-artist. Cineva care se îngrijește de calitatea produsului și ține cont de toate aspectele, fără a sacrifica niciunul, chiar și în momentele de stres, atunci când circumstanțele necesită să se facă ceva urgent în detrimentul esențialului. Toate proiectele de succes, care sunt durabile, care au trecut proba timpului, sunt construite pe acest principiu. În ele există ceva foarte precis și unic, ceva care folosește toate posibilitățile disponibile. În exemplul cu nava în sticlă – se joacă cu ideea că corpul navei trece prin gura sticlei.
Revenind la alegerea serverului nostru de caching, cum ar putea fi aplicată această metodă? Propun o variantă de selecție din toate sistemele disponibile – să nu zguduie sticla, să nu aleagă, ci să se uite la ceea ce există în principiu, la ce trebuie să țină cont în alegerea sistemului.
Unde să căutăm bottle-neck
Să încercăm să nu agităm sticla, să nu trecem prin tot ce avem pe rând, dar să vedem ce probleme ar putea apărea dacă, dintr-o dată, trebuie să proiectăm un astfel de sistem pe cont propriu. Nu vom construi o bicicletă, dar vom folosi acest diagram pentru a ne orienta asupra aspectelor la care trebuie să acordăm atenție în descrierile produselor. Să schițăm o astfel de schemă.
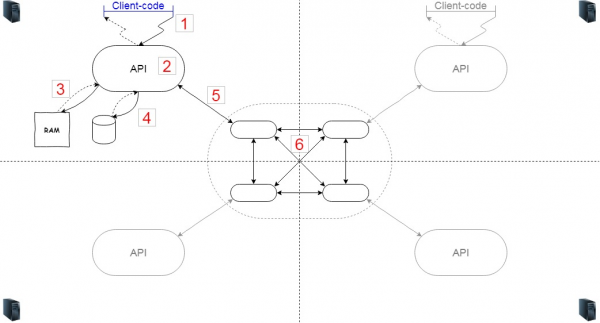
Dacă sistemul este distribuit, atunci vor exista mai multe servere (6). Să presupunem că avem patru (convenabil de plasat în imagine, dar, desigur, pot fi oricât de multe). Dacă serverele sunt pe diferite noduri, înseamnă că pe toate acestea rulează un anumit cod care se ocupă de formarea unui cluster și, în caz de deconectare, să se reconecteze și să se recunoască unul pe celălalt.
De asemenea, avem nevoie de un cod de logică (2) care se ocupă efectiv de caching. Cu acest cod, clienții interacționează printr-un anumit API. Codul client (1) poate fi fie în cadrul aceleași JVM, fie poate să se acceseze prin rețea. Logica implementată intern decide ce obiecte să rămână în cache și pe care să le eliminăm. Pentru stocarea cache-ului, utilizăm memorie (3), dar, dacă este necesar, putem salva o parte din date și pe disc (4).
Să vedem în ce părți va apărea carga. De fapt, fiecare săgeată și fiecare nod vor fi solicitate. În primul rând, între codul client și API, dacă aceasta este o interacțiune de rețea, pot apărea întârzieri semnificative. În al doilea rând, în interiorul API-ului – dacă exagerezi cu logica complexă, putem ajunge la o utilizare maximă a CPU-ului. Ar fi bine ca logica să nu acceseze memoria fără motiv. Iar interacțiunea cu sistemul de fișiere rămâne – de obicei, este vorba despre serializare / restaurare și scriere / citire.
Apoi, interacțiunea cu clusterul. Cel mai probabil, acesta va fi în același sistem, dar ar putea fi și separat. Aici trebuie să luăm în considerare transferul de date către acesta, viteza de serializare a datelor și interacțiunea dintre cluster.
Acum, pe de o parte – putem imagina „ce rotițe vor fi în mișcare” în sistemul de cache în timpul procesării cererilor din codul nostru, iar pe de altă parte – putem estima ce și câte cereri va genera codul nostru către acest sistem. Acest lucru este suficient pentru a face o alegere mai mult sau mai puțin rațională – de a adapta sistemul la varianta noastră de utilizare.
Hazelcast
Să vedem cum putem aplica o astfel de descompunere la lista noastră. De exemplu, Hazelcast.
Pentru a plasa/obține date din Hazelcast, codul client se adresează (1) API-ului. Hz permite rularea serverului ca embedded, iar în acest caz, apelul către API este o invocare a metodei în cadrul JVM, poate fi considerat gratuit.
Pentru ca logica să funcționeze în (2), Hz se bazează pe hash-ul unui array de bytes serializat, adică serializarea cheii va avea loc oricum. Acesta este un overhead inevitabil pentru Hz.
Strategiile de Eviction sunt implementate bine, dar pentru cazuri speciale – se pot conecta cele proprii. Nu trebuie să ne facem griji pentru această parte.
Storage-ul (4) poate fi conectat. Excelent. Interacțiunea (5) pentru embedded poate fi considerată instantanee. Schimbul de date între nodurile din cluster (6) – da, este disponibil. Aceasta contribuie la reziliența la erori, cu un cost în viteză. Costul poate fi redus prin funcția Hz Near-cache – datele obținute din alte noduri ale clusterului vor fi cache-uite.
Ce se poate face în astfel de condiții pentru a crește viteza?
De exemplu, pentru a evita serializarea cheii în (2) – pe lângă Hazelcast se poate adăuga un alt cache, pentru cele mai fierbinți date. La Sportmaster pentru acest scop a fost ales Caffeine.
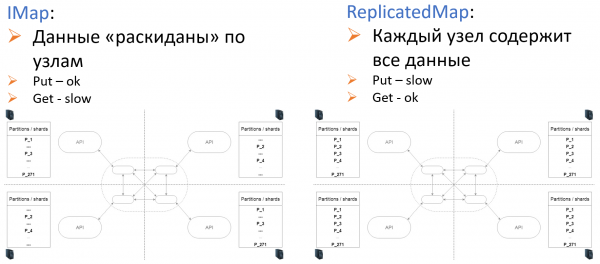
Pentru ajustare la nivelul (6), Hz propune două tipuri de stocare: IMap și ReplicatedMap.
Merită menționat cum a ajuns Hazelcast în tehnologia Sportmaster.
În 2012, când lucram la primul pilot al viitorului site, Hazelcast a fost primul link pe care l-a oferit motorul de căutare. Întâlnirea a început «de la prima încercare» – ne-a cucerit faptul că la doar două ore după ce am integrat Hz în sistem – funcționa. Și funcționa bine. Până la sfârșitul zilei am scris câteva teste, ne-am bucurat. Iar această stare de spirit ne-a fost suficientă pentru a depăși surprizele pe care Hz le-a adus de-a lungul timpului. Acum, echipa Sportmaster nu are motive să renunțe la Hazelcast.
Dar argumentele precum «primul link în motorul de căutare» și «am adunat rapid HelloWorld» – sunt, desigur, excepții și particularități ale momentului în care a avut loc alegerea. Adevăratele teste pentru sistemul ales încep odată cu ieșirea în producție, și tocmai în această etapă merită să ne concentrăm la alegerea oricărui sistem, inclusiv a cache-ului. De fapt, în cazul nostru, putem spune că am ales Hazelcast întâmplător, dar apoi s-a dovedit că am ales corect.
Pentru producție, mai importante sunt: monitorizarea, tratarea erorilor la noduri separate, replicarea datelor, costurile de scalare. Adică, merită să ne concentrăm pe sarcinile care vor apărea în timpul întreținerii sistemului – atunci când sarcina va depăși de zeci de ori cea planificată, când din greșeală vom încărca ceva greșit și greșit, când va fi necesar să lansăm o nouă versiune a codului, să înlocuim datele și să facem acest lucru fără ca clienții să observe.
Pentru toate aceste cerințe, Hazelcast este, fără îndoială, potrivit.
Va urma
Dar Hazelcast nu este o panacee. În 2017, am ales Hazelcast pentru cache-ul din back-office, bazându-ne doar pe impresiile pozitive din experiențele anterioare. Acest lucru a jucat un rol crucial într-o farsă foarte amară, care ne-a adus într-o situație complicată și am reușit „eroic” să ieșim din ea în 60 de zile. Dar despre asta, în partea următoare.
Între timp… Happy New Code!
Sursa: habr.com
