

Mă numesc Yuri, sunt liderul grupului de administrare a sistemelor la Citimobil. Astăzi voi împărtăși experiența mea în lucrul cu tehnologia rezervării reduse (thin provisioning) a sistemelor de fișiere Linux și voi explica cum poate fi utilizată în procesele tehnologice CI/CD ale companiei. Vom analiza situația în care pentru testarea automată a codului la livrarea acestuia în producție avem nevoie cât mai rapid de copii ale bazei de date MySQL, cât mai apropiate de versiunea de „prod” disponibilă pentru citire și scriere.
Introducere: de ce să oferi sfaturi dăunătoare?
O întrebare logică, având în vedere că există mecanisme bine stabilite pentru migrarea schemelor bazei de date în medii de testare. De ce să ducem baza de date principală nespartă la astfel de volume? În plus, pentru testare nu sunt necesare toate datele. Voi încerca să explic.
Aproximativ cu un an în urmă, pe fondul creșterii active a agregatorului nostru de taxiuri (în 2018 am crescut de aproximativ 15 ori în deplasări finalizate), au crescut volumul de date, încărcătura pe servere și frecvența livrărilor. Ne-am aflat în următoarea situație:
- Baza de date MySQL principală a crescut la aproximativ 1000 de tabele cu un volum total de 2,5 TB și continua să crească.
- Nu a existat posibilitatea de a ne împărți rapid și de a dispersa baza. Acest lucru a fost imposibil din cauza vechiului principiu „scriu în baza de date ce vreau și cum vreau”, multe JOIN-uri și dependențe interne ale tabelelor.
- Nu a existat un mecanism pentru migrarea schemei bazei de date în medii de testare.
- Nu a existat testare automată a codului la livrarea în producție.
Ultima problemă a fost dorită să fie rezolvată cât mai repede. Au fost deja scrise teste Postman pentru verificarea monolitului PHP principal, dar lipsea o bază de date actualizată. În același timp, nu puteam crea noaptea o replică, să o facem master și să o oferim în cursul zilei: un număr foarte mare de livrări și modificări, inclusiv în date și schemă, ar fi făcut ca standul să devină nefuncțional deja la mijlocul zilei. Și limitarea livrărilor doar la ziua lucrătoare ar fi fost ineficientă.
Cu toate acestea, sarcina a fost îndeplinită: primul stand operațional l-am obținut deja în două săptămâni. În trecutul an, acesta a suferit multe modificări și continuă să fie folosit.
În continuare, voi descrie în detaliu toate pașii și etapele dezvoltării soluției noastre. Veți constata că această metodă merită să existe.
Ce este „rezervarea redusă”?
Aceasta este o tehnologie hardware sau software (cunoscută și sub numele de volume sparse), care permite alocarea unei cantități mai mari de resurse necesare decât cele disponibile. Astfel, volumul alocat trebuie să respecte criteriile just-enough (cât este nevoie) și just-in-time (în timpul necesar). În principal, rezervarea subțire este utilizată în diverse SCD-uri pentru a oferi spațiu pe disc în volumele necesare, depășind efectiv resursele disponibile. Tehnologia este susținută de diverse sisteme de fișiere, cum ar fi LVM2, ZFS, BTRFS. Este folosită pe scară largă în hipervizoare de virtualizare. Rezervarea subțire ne-a permis să creăm rapid din instantanee ale partției principale cu date atât de multe copii ale acestei partiții cât am avut nevoie (directorul de date al SGBD MySQL).
Prima stație, tehnologia Thin LVM
Această capitol poate fi numit și „Cum să facem instantanee extrem de rapide ale volumelor mari de date folosind , reducând stabilitatea sistemului de fișiere și a SGBD MySQL la valori inacceptabile”.
Deoarece am folosit deja LVM pentru construirea partitiilor principale ale sistemului de operare, am decis să începem cu aceasta. La început, a fost necesară o mașină fizică separată — replica bazei noastre principale MySQL, pe care am putut să creăm la cerere o instantanee a replicii și să o ridicăm într-un exemplu separat de MySQL. Pe timpul testării, am permis operații modificatoare pe acest exemplu și, la finalizarea testelor, l-am șters cu succes. Configurația serverului a fost următoarea:
- 2 x Intel Silver 4114 (10×2,2 GHz HT)
- 8 x 32 GB DDR4
- 8 x 1920 GB Intel SSD în controller RAID Adaptec în RAID-10
Despre alegerea între controller RAID și RAID software MD s-ar putea scrie un articol separat. Voi spune doar că alegerea noastră a fost influențată de doi factori:
- În vremurile stabilirii sarcinii, toate SGBD-urile le instalasem pe controlere RAID, așa că se poate spune că așa s-a întâmplat istoric.
- Diferența de performanță în teste sintetice ale sistemului de fișiere și teste cu diverse operații în MySQL a fost minimă.
Am împărțit RAID-10 rezultat: am creat un singur grup de volum (VG) pentru întreaga capacitate (cu cheltuieli suplimentare de aproximativ 6,7 Gb) și am creat o partiție logicală (Logical Volume, LV) pentru sistem de 50 Gb. În mod normal, restul spațiului este alocat pentru partiția cu MySQL. Dar aveam nevoie de rezervare flexibilă, așa că mai întâi am creat așa-numitul pool, în interiorul căruia am creat o partiție pentru /var/lib/mysql de 3,5 Tb (pe baza volumelor estimate ale bazei de date):
lvcreate -l 100%FREE -T vga/thin
lvcreate -V 3.5T -T vga/thin -n mysql
Am formatat partiția în ext4, am montat-o, am scris o replică și am obținut configurația inițială. Apoi, am realizat o interfață de tip API, care ar trebui să creeze instantanee, să pornească un exemplar MySQL pe un port specificat și să ștergă exemplar creat. Deoarece folosim exclusiv apeluri de sistem, am ales ca limbaj de scripting bash obișnuit, iar ca interfață API HTTP → bash am implementat o soluție open source. , scris în Go.
Cândva, vom publica scripturile noastre bash în open source, dar deocamdată voi descrie doar algoritmul principal:
Crearea instantanei principale snapmain:
- Oprim replica principală.
- Punem o blocare pe operațiunile cu instantanea snapmain.
- Creăm o nouă instantanee snapmain.
- Pornim MySQL și eliminăm blocarea.
Crearea unei baze de date pe un port arbitrar din snapmain:
- Punem o blocare pe un anumit exemplar de bază de date (port).
- Verificăm existența blocării pentru crearea instantanei principale. Dacă aceasta există, atunci așteptăm și verificăm din nou la fiecare 5 secunde.
- Verificăm dacă există o veche partiție LV a exemplarului.
3.1 Dacă da, oprim exemplar MySQL folosind kill -9 și ștergem partiția LV. - Creăm un nou exemplar din snapmain.
- Pregătim și montăm directoarele pentru acest exemplar.
- Eliminăm semnele de slava (fișiere) și pornim exemplar MySQL.
- Îl facem master.
- Eliminăm blocarea.
Ștergerea unei baze de date pe un port arbitrar:
- Punem o blocare pe un anumit exemplar de bază de date (port).
- Împușcăm exemplar MySQL folosind kill -9.
- Demontăm directoarele.
- Ștergem partiția LV și eliminăm blocarea.
Exemple de comenzi pentru clonarea partițiilor noii baze de date:
lvcreate -n stage_3307 -s vga/snapmain
lvchange -ay -K vga/stage_3307
mount -o noatime,nodiratime,data=writeback /dev/mapper/vga-stage_3307 /mnt/stage_3307
Acum voi discuta despre problema principală cu care ne-am confruntat în timpul utilizării rezervării subțiri. Ne-am lovit de performanța dispunerilor SSD. Asta s-a întâmplat din cauza specificităților Thin LVM: aceasta operează, în esența sa, la nivel de dispozitiv cu blocuri de dimensiune de 4 MB, în mod implicit. Cum a arătat asta:
- Creăm un snapshot din partția principală /var/lib/mysql.
- Pornim replicarea pentru a ajunge din urmă masterul.
- Orice modificare în tabelele replicii forțează păstrarea vechilor blocuri de date nemodificate în secțiunea snapshot-ului.
- Orice modificare în exemplarul de test ridicat forțează păstrarea vechilor blocuri de date nemodificate în secțiunea snapshot-ului clonat pentru acest exemplar.
- Obținem o utilizare a operațiunilor de intrare-ieșire de 100% pe dispozitiv, oprind orice operațiune și încetinind treptat replica.
- La sfârșitul zilei de lucru, obținem un stand întârziat cu câteva ore.
Cum ne-am luptat cu asta, pentru a obține un rezultat mai rezonabil (punctele principale):
Controller RAID:
- Am dezactivat toate tipurile de caching în mod implicit.
- Am setat writeback (atunci când datele ajung în buffer, scrierea se finalizează înainte de salvarea efectivă pe disc).
Sistemul de fișiere:
- În punctul de montare /var/lib/mysql am specificat noatime,nodiratime,data=writeback
- Am dezactivat jurnalizarea ext4 prin tune2fs.
MySQL:
- Am specificat innodb_flush_method = O_DSYNC (am crescut viteza de scriere, scăzând astfel fiabilitatea).
- Am dezactivat jurnalizarea, logurile nu ne sunt necesare.
- Am specificat innodb_buffer_pool_size = 4G (cu cât dimensiunea pool-ului InnoDB este mai mică, cu atât MySQL se va opri mai repede, și cu atât mai repede vom crea snapshotul).
Aceasta nu este o listă completă, mai ales privind MySQL. Totuși, celelalte modificări sunt minore și adesea nu sunt aplicabile întotdeauna și nu exact. De exemplu, în încercarea de a descărca discurile, am mutat innodb_parallel_doublewrite_path în /dev/shm, ceea ce, în unele cazuri, la pornirea unui exemplu necorespunzător încheiat, ne economisea până la 5 secunde.
De ce oprim MySQL înainte de a face snapshot? Deoarece putem lua unul de pe replica funcțională. Așa este, dar noul exemplu de bază de date de pe acest snapshot va fi considerat, în mod implicit, corupt și va necesita o scanare completă la pornire. Oprirea replicii este cu siguranță mai rapidă, deși aceasta este, în final, cea mai lungă operațiune din întregul proces.
În urma analizei, am obținut timpi mai acceptabili și un stand funcțional. Totuși, după cum se vede din graficul elocvent al întârzierii replicării principale, situația este încă departe de ideal:
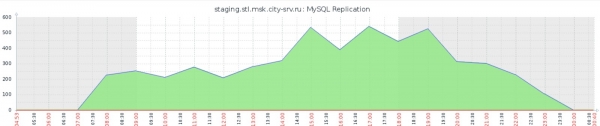
Printre alte dezavantaje, merită menționată imposibilitatea practică de a monitoriza pool-ul Thin LVM: dincolo de funcțiile sistemului standard iostat, nu este posibil să înțelegem, de exemplu, care element al pool-ului generează acum cea mai mare încărcare pe sistemul de fișiere.
Un alt dezavantaj semnificativ, legat de optimizarea menționată anterior, este că am obținut un stand YOLO. Aproape o dată la una-două luni, ext4 nu rezista abuzurilor și se strica ireversibil, necesitând reformatare și reîncărcare a replicii. Câștigând în viteză, am compromis complet stabilitatea.
Ce metrici ar trebui să monitorizăm în timpul utilizării Thin LVM:
- Procentaj de date din pool-ul Thin
- Procentaj de metadate din pool-ul Thin
Dacă standul nostru va supraviețui lipsei de spațiu pentru date (este suficient să curățăm discurile), lipsa de spațiu pentru metadate va duce la o prăbușire completă a pool-ului și va necesita recrearea acestuia de la zero.
Sistemul de fișiere din interiorul pool-ului se fragmentează considerabil în timp. Recomand să rulați zilnic comanda prin cron, fstrim -v /var/lib/mysql.
Rezultate intermediare:
- Tehnologia este ușor aplicabilă, la fel ca și LVM, și nu necesită o calificare specială a inginerului.
- Este bine să fie utilizată pentru baze de date de dimensiuni mici și care nu sunt prea solicitate. Cu cât baza de date este mai mică, cu atât mai puțini chunk-uri se mută prin sistemul de fișiere din interiorul pool-ului și cu atât mai mică este încărcarea pe discuri.
- Pentru sarcina noastră, am început să căutăm alte soluții, despre care vom discuta în următoarea secțiune.
Al doilea stand, tehnologia ZFS
Cu mult timp în urmă am avut de-a face cu sistemul de fișiere ZFS, dar atunci ZFS funcționa cu adevărat bine pe familia sa nativă de sisteme de operare Solaris. Existau versiuni portate pe FreeBSD cu un nivel de implementare destul de bun. De asemenea, a existat un port neterminat pe Linux, care era rar utilizat. Din cauza structurii de stocare a datelor B-tree (de altfel, aceeași structură de stocare este utilizată de InnoDB MySQL), ZFS s-a dovedit a fi slab în instalațiile cu un număr foarte mare de fișiere. Toate acestea, combinate cu necesitatea de a învăța detalii tehnice înainte de utilizare, au dus la eliminarea acestei file de sistem din practica mea pentru o lungă perioadă de timp. Au apărut ext4 și xfs, care au devenit standarde. Dar având în vedere că ZFS se potrivește mai mult decât bine pentru sarcina noastră, iar versiunea de Linux, judecând după recenzii, a evoluat într-un produs decent (deși nu beneficiază de suport complet, ceea ce face ca instalarea completă a sistemului pe ZFS să fie posibilă doar prin diverse trucuri), am decis să o încercăm.
Din motive evidente, am ales un stand cu o configurație similară (cu excepția controller-ului RAID). Am instalat opt SSD-uri de 1920 Gb. Nu am dorit să scriem imaginea de rețea pentru încărcarea serverului pe ZFS gol, așa că am tăiat câte 50 Gb de pe toate discurile și am creat un RAID-10 MD pentru sistem. Celelalte 1950 Gb de pe fiecare disc le-am combinat într-un analog ZFS al RAID-10:
zpool create zpool mirror /dev/sda2 /dev/sdb2 mirror /dev/sdc2 /dev/sdd2 mirror /dev/sde2 /dev/sdf2 mirror /dev/sdg2 /dev/sdh2Am creat partiții pentru MySQL:
zfs create zpool/mysql
zfs set compression=gzip zpool/mysql
zfs set recordsize=128k zpool/mysql
zfs set atime=off zpool/mysql
zfs create zpool/mysql/data
zfs set recordsize=16k zpool/mysql/data
zfs set primarycache=metadata zpool/mysql/data
zfs set mountpoint=/var/lib/mysql zpool/mysql/data
Vă rugăm să rețineți că am activat compresia de date gzip standard. Avem multe resurse de procesor pe server, iar acestea nu sunt utilizate complet. Ca rezultat, 3 TB din baza noastră de date s-au transformat în 1,6 TB, iar deoarece punctul slab, ca și în cazul anterior, este performanța maximă a discurilor, cu cât sunt mai puține date — cu atât mai bine, obținem de la început un bonus excelent de la ZFS! În orele de vârf, sub o sarcină completă, menținerea funcționării gzip necesită până la 4 nuclee, dar nu ne deranjează.
Între timp, implementarea a decurs mai repede. Am copiat setările replica MySQL de pe standul LVM. A trebuit să ne petrecem ceva timp rescriind scripturile în comenzi ZFS, dar în general algoritmii au rămas aceiași. Un exemplu de creare a unui snapshot:
zfs set snapdir=visible zpool/mysql/data
zfs create zpool/stage_3307
zfs clone zpool/mysql/data@snapmain zpool/stage_3307/data
zfs set mountpoint=/mnt/stage_3307 zpool/stage_3307/data
De la tuning suplimentar: am mutat în memorie secțiunile ZFS cu metadate și log-uri l2arc și zil. Pentru sarcina noastră, așa cum s-a dovedit ulterior, aceasta era excesivă, dar deocamdată am păstrat această optimizare, schimbarea este ușoară în caz de nevoie. Din efectele negative — trebuie să recreăm zonele corespunzătoare ale memoriei după repornirea serverului. Datele nu se pierd. Extracție zpool status:
logs
      /dev/shm/zil_slog.img  ONLINE       0     0     0
cache
      /dev/shm/l2arc.img     ONLINE       0     0     0
În această configurație am început să testăm standul și am obținut rezultate excelente: cu două instanțe de baze de date funcționând simultan (și replicat principal activ) pe snapshot-uri, am obținut o încărcare a discurilor de 50-60%.
Am scăpat de problema noastră principală, ceea ce se vede în graficul întârzierii replicării (compărați cu graficul anterior din secțiunea Thin LVM):
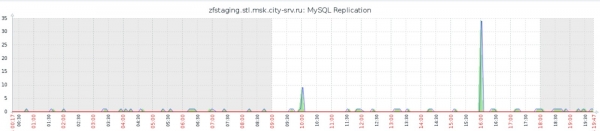
În plus și datorită acestui lucru, am accelerat semnificativ toate operațiile: crearea completă a snapshot-ului cu oprirea și repornirea replicatului durează până la 40 de secunde, desfășurarea unui nou exemplar MySQL din snapshot durează până la 20 de secunde. Ceea ce ne mulțumește pe noi, dar și testele noastre de cod.
Rezultate intermediare:
- Rezultatele au satisfăcut pe deplin nevoia noastră de a obține o copie a bazei de date în producție pentru testarea codului.
- Tehnologia necesită o înțelegere: trebuie să știi ce este ZFS și cum să lucrezi cu ea.
- Nu am verificat starea curentă a funcționării ZFS cu un număr mare (de la 1 milion) de fișiere mici. Dar presupunem că problema persistă, prin urmare nu aș recomanda acest sistem de fișiere pentru niciun fel de stocări de fișiere.
Ce urmează?
În cadrul standului nu facem mai nimic, rezultatul ne mulțumește. Este posibil ca în viitor să adăugăm în configurarea replicării standului excluderea tabelelor inutile pentru testare, ceea ce va reduce și mai mult volumul bazei de date. Nu am testat sistemul BTRFS și implementarea sa a tehnologiei de rezervare subțire. Totuși, o astfel de sarcină nu mai este relevantă, deoarece obiectivul principal a fost atins. În general, desigur, ne dorim să ne îndepărtăm de abordarea descrisă mai sus — să implementăm migrații funcționale ale bazei de date în medii de testare, să creăm un circuit separat de testare pentru baza de date, să ne ocupăm de sharding-ul bazei de date principale. Multe dintre acestea le punem deja în practică, despre ceea ce vom vorbi cu siguranță în articolele viitoare.
Concluzii
Sarcina inițială a fost rezolvată, deși într-un mod neobișnuit. În concluziile intermediare au fost descrise avantajele și dezavantajele fiecărei tehnologii utilizate, așa că să decidem ce tehnologie și când poate fi folosită:
- Thin LVM — pentru baze de date mici și când nu ai dorința sau timpul necesar pentru a studia ZFS.
- ZFS — dacă ai experiență în utilizarea sa sau oportunitatea de a dedica timp pentru a învăța în orice situație.
La un nivel mai înalt, acest articol nu este doar o comparație a tehnologiilor celor două sisteme de fișiere. Ideea principală pe care aș dori să o transmit și să o consolidez este că nu ar trebui să ne temem să gândim neconvențional în situații critice pentru afaceri și să folosim doar rețete gata făcute. Cândva, întreaga noastră echipă tehnică putea să clatină din cap și să spună că sarcina de a crea copii de bază de trei terabytes în mai puțin de un minut este imposibilă, și că nu avem nevoie de tehnologii riscante, așa că haideți să facem cum trebuie. Ar fi fost posibil, dar am fi pierdut aproximativ șase luni până la un an și multe călătorii ale clienților (călătoriile sunt indicatorul nostru de afaceri principal) fără teste și în timpul implementării. Procedând neconvențional, am pierdut mult mai puțin timp cu implementarea, am câștigat experiență în tehnologii noi și vechi uitate, și am oferit testarea exact în acel moment în care aveam cu adevărat nevoie. Fără îndoială, acest lucru a avut un impact pozitiv asupra tuturor indicatorilor noștri. Alegerea este întotdeauna a voastră, iar noi, din partea noastră, vom continua să povestim în blogul nostru despre realizările interesante actuale și viitoare.
Sursa: habr.com
