

Am postat pe Github .
Aceasta este o tabelă hash simplă pentru GPU, capabilă să proceseze sute de milioane de inserții pe secundă. Pe laptopul meu cu NVIDIA GTX 1060, codul inserează 64 de milioane de perechi cheie-valoare generate aleatoriu în aproximativ 210 ms și șterge 32 de milioane de perechi în aproximativ 64 ms.
Așadar, viteza pe laptop este de aproximativ 300 de milioane de inserții/sec și 500 de milioane de ștergeri/sec.
Tabelul este scris în CUDA, deși aceeași metodă poate fi aplicată în HLSL sau GLSL. Implementarea are câteva restricții care asigură o performanță ridicată pe placă grafică:
- Sunt procesate doar chei de 32 de biți și valori de aceeași mărime.
- Tabelul hash are dimensiune fixă.
- Și această dimensiune trebuie să fie o putere a lui doi.
Pentru chei și valori trebuie să rezervi un marcator de delimitare simplu (în codul dat este 0xffffffff).
Tabelă hash fără blocări
În tabelă hash se folosește adresare deschisă cu , adică este pur și simplu un array de perechi cheie-valoare, care este stocat în memorie și are o performanță excelentă a cache-ului. Acest lucru nu este valabil pentru legătura în lanț (chaining), care implică căutarea unui pointer într-o listă conectată. Tabelul hash este un array simplu care stochează elementele KeyValue:
struct KeyValue
{
    uint32_t key;
    uint32_t value;
};
Dimensiunea tabelului este o putere a lui doi, nu un număr prim, deoarece pentru aplicarea unei mască pow2/AND este suficientă o instrucțiune rapidă, iar operatorul modulo funcționează mult mai lent. Acest lucru este important în cazul sondării liniare, deoarece, în căutarea liniară în tabel, indexul slotului trebuie să fie înfășurat în fiecare slot. Și, ca rezultat, se adaugă costul operației modulo în fiecare slot.
Tabelul stochează doar cheie și valoare pentru fiecare element, nu hash-ul cheii. Deoarece tabelul stochează doar chei de 32 de biți, hash-ul este calculat foarte rapid. În codul dat se folosește hash-ul Murmur3, care efectuează doar câteva deplasări, XOR-uri și înmulțiri.
În tabelul hash se aplică o metodă de protecție împotriva blocajelor, care nu depinde de ordinea plasării în memorie. Chiar dacă unele operațiuni de scriere perturbă ordinea altor astfel de operațiuni, tabela hash va păstra totuși o stare corectă. Vom discuta despre acest lucru mai jos. Metoda funcționează excelent cu plăci video, în care mii de fire sunt executate concurent.
Cheile și valorile din tabelul hash sunt inițializate ca fiind goale.
Codul poate fi modificat pentru a putea gestiona atât chei, cât și valori pe 64 de biți. Pentru chei, sunt necesare operațiuni atomice de citire, scriere și comparație cu schimb (compare-and-swap). Iar pentru valori, sunt necesare operațiuni atomice de citire și scriere. Din fericire, în CUDA operațiile de citire-scriere pentru valori de 32 și 64 de biți sunt atomice atâta timp cât sunt aliniate natural (vezi ), iar plăcile video moderne suportă operații atomice de comparație cu schimb pe 64 de biți. Desigur, trecerea la 64 de biți va reduce ușor performanța.
Starea tabelului hash
Fiecare pereche cheie-valoare din tabelul hash poate avea unul dintre cele patru stări:
- Atât cheia, cât și valoarea sunt goale. În această stare, tabela hash este inițializată.
- Cheia a fost scrisă, dar valoarea nu. Dacă un alt fir de execuție citeste datele în acel moment, el va returna o valoare goală. Aceasta este normal, același lucru s-ar întâmpla dacă un alt fir de execuție ar fi terminat puțin mai devreme, iar noi vorbim despre o structură de date concurentă.
- Atât cheia, cât și valoarea sunt scrise.
- Valoarea este disponibilă pentru alte fire de execuție, iar cheia nu. Acest lucru se poate întâmpla pentru că modelul de programare în CUDA presupune un model de memorie slab ordonat. Asta este normal, în orice situație cheia este încă goală, chiar dacă valoarea nu mai este.
Un aspect important este că odată ce cheia a fost scrisă în slot, aceasta nu se mai mută — chiar dacă cheia va fi ștearsă, vom discuta despre acest lucru mai jos.
Codul tabelului hash funcționează chiar și cu modele de memorie slab ordonate, în care nu se cunoaște ordinea citirii și scrierii în memorie. Când vom analiza inserarea, căutarea și ștergerea în tabelul hash, amintește-ți că fiecare pereche cheie-valoare se află într-o dintre cele patru stări descrise mai sus.
Inserția în tabelul hash
Funcția CUDA care inserează perechi cheie-valoare în tabela de hash arată astfel:
void gpu_hashtable_insert(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        uint32_t prev = atomicCAS(&hashtable[slot].key, kEmpty, key);
        if (prev == kEmpty || prev == key)
        {
            hashtable[slot].value = value;
            break;
        }
        slot = (slot + 1) & (kHashTableCapacity-1);
    }
}
Pentru a insera cheia, codul iterează peste masa de hash începând cu hash-ul cheii inserate. În fiecare slot al matricei se efectuează o operație atomică de comparare și schimbare, în care cheia din acel slot este comparată cu cea goală. Dacă se detectează o neconcordanță, cheia din slot este actualizată cu cheia inserată, iar apoi se returnează cheia originală a slotului. Dacă această cheie originală a fost goală sau a fost egală cu cheia inserată, atunci codul a găsit un slot potrivit pentru inserare și introduce valoarea în slot.
Dacă într-o invocare a nucleului gpu_hashtable_insert() există mai multe elemente cu aceeași cheie, atunci oricare dintre valorile lor poate fi scrisă în slotul cheii. Acest lucru este considerat normal: una dintre operațiile de scriere a cheii-valoare în timpul apelului va fi reușită, dar deoarece totul se desfășoară în paralel în cadrul mai multor fire de execuție, nu putem prezice care operație de scriere în memorie va fi ultima.
Căutarea în tabela de hash
Codul pentru căutarea cheilor:
uint32_t gpu_hashtable_lookup(KeyValue* hashtable, uint32_t key)
{
        uint32_t slot = hash(key);

        while (true)
        {
            if (hashtable[slot].key == key)
            {
                return hashtable[slot].value;
            }
            if (hashtable[slot].key == kEmpty)
            {
                return kEmpty;
            }
            slot = (slot + 1) & (kHashTableCapacity - 1);
        }
}
Pentru a găsi valoarea unei chei stocate în tabel, iterăm prin matrice începând cu hash-ul cheii căutate. În fiecare slot verificăm dacă cheia este cea pe care o căutăm și, dacă da, returnăm valoarea acesteia. De asemenea, verificăm dacă cheia este goală, iar dacă da, întrerupem căutarea.
Dacă nu reușim să găsim cheia, codul returnează o valoare goală.
Toate aceste operații de căutare pot fi efectuate concurent în timpul inserărilor și ștergerilor. Fiecare pereche din tabel va avea pentru fir unul dintre cele patru stări descrise mai sus.
Ștergerea în tabela de hash
Codul pentru ștergerea cheilor:
void gpu_hashtable_delete(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        if (hashtable[slot].key == key)
        {
            hashtable[slot].value = kEmpty;
            return;
        }
        if (hashtable[slot].key == kEmpty)
        {
            return;
        }
        slot = (slot + 1) & (kHashTableCapacity - 1);
    }
}
Ștergerea unei chei se efectuează într-un mod neobișnuit: lăsăm cheia în tabel și marcăm valoarea acesteia (nu cheia însăși) ca fiind goală. Acest cod este foarte asemănător cu lookup(), cu excepția faptului că, la detectarea unei corespondențe pe cheie, îi face valoarea goală.
După cum am menționat mai sus, odată ce cheia este scrisă în slot, aceasta nu se mai mută. Chiar și atunci când un element este șters din tabel, cheia rămâne la locul ei, doar că valoarea sa devine goală. Aceasta înseamnă că nu trebuie să folosim o operațiune atomică pentru a scrie valoarea slotului, deoarece nu contează dacă valoarea curentă este goală sau nu — oricum va deveni goală.
Redimensionarea tabelului hash
Redimensionarea tabelului hash se poate face prin crearea unui tabel mai mare și inserarea în el a elementelor non-goale din tabelul vechi. Eu nu am implementat această funcționalitate, deoarece am dorit să păstrez exemplul de cod simplu. Mai mult, în programele CUDA, alocarea de memorie se face adesea în codul gazdă, nu în nucleul CUDA.
În articol se descrie cum să modifici o astfel de structură de date, protejată de blocaje.
Concurența
În fragmentele de cod de mai sus, funcțiile gpu_hashtable_insert(), _lookup() și _delete() procesează câte o pereche cheie-valoare la un moment dat. Iar mai jos gpu_hashtable_insert(), _lookup() și _delete() procesează un array de perechi în paralel, fiecare pereche într-un thread de execuție GPU diferit:
// CPU code to invoke the CUDA kernel on the GPU
uint32_t threadblocksize = 1024;
uint32_t gridsize = (numkvs + threadblocksize - 1) / threadblocksize;
gpu_hashtable_insert_kernel<<<gridsize, threadblocksize>>>(hashtable, kvs, numkvs);

// GPU code to process numkvs key/values in parallel
void gpu_hashtable_insert_kernel(KeyValue* hashtable, const KeyValue* kvs, unsigned int numkvs)
{
    unsigned int threadid = blockIdx.x*blockDim.x + threadIdx.x;
    if (threadid < numkvs)
    {
        gpu_hashtable_insert(hashtable, kvs[threadid].key, kvs[threadid].value);
    }
}
O tabelă hash cu protecție împotriva blocajelor suportă inserții, căutări și ștergeri concurente. Deoarece perechile cheie-valoare se află întotdeauna într-una din cele patru stări, iar cheile nu se mișcă, tabela garantează corectitudinea chiar și în utilizarea simultană a operațiunilor de tipuri diferite.
Cu toate acestea, dacă tratăm în paralel un lot de inserții și ștergeri, și dacă în array-ul de intrare există perechi de chei duplicate, nu vom putea prezice care perechi "vor câștiga" — care vor fi scrise ultimele în tabela hash. Să presupunem că am apelat codul de inserție cu un array de perechi A/0 B/1 A/2 C/3 A/4. Când codul se va termina, perechile B/1 și C/3 vor fi garantat prezente în tabelă, dar în ea se va afla oricuna dintre perechile A/0, A/2 sau A/4Aceasta poate fi o problemă sau nu — totul depinde de utilizare. Puteți ști din timp că în matricea de intrare nu există chei duplicate, sau s-ar putea să nu vă pasă ce valoare a fost înregistrată ultima.
Dacă pentru dumneavoastră aceasta este o problemă, atunci trebuie să separați perechile duplicate în apeluri CUDA sistemice diferite. În CUDA, orice operațiune cu apelul unui nucleu se finalizează întotdeauna înainte de următorul apel al nucleului (cel puțin, în cadrul unui singur fir. În fire diferite, nucleele sunt executate în paralel). Dacă în exemplul de mai sus se apelează un nucleu cu A/0 B/1 A/2 C/3, iar altul cu A/4, atunci cheia A va primi valoarea 4.
Acum să discutăm despre dacă funcțiile lookup() și delete() ar trebui să folosească un pointer simplu (plain) sau un pointer volatil (volatile) pe un array de perechi dintr-o tabelă hash. afirmă că:
Compilatorul poate optimiza operațiunile de citire și scriere în memoria globală sau comună după bunul plac … Aceste optimizări pot fi dezactivate cu ajutorul cuvântului cheie
volatile: … orice referință la această variabilă se compilează într-o instrucțiune reală de citire sau scriere în memorie.
Considerațiile de corectitudine nu impun aplicarea volatile. Dacă firul de execuție folosește o valoare cache dintr-o operațiune de citire anterioară, aceasta înseamnă că va folosi informații puțin învechite. Cu toate acestea, aceasta este informația dintr-o stare corectă a tabelei hash într-un moment dat al apelului nucleului. Dacă aveți nevoie să utilizați cele mai recente informații, atunci puteți aplica un pointer volatile, dar atunci performanța va scădea puțin: conform testelor mele — la ștergerea a 32 de milioane de elemente, viteza a scăzut de la 500 milioane ștergeri/ secundă la 450 milioane ștergeri/ secundă.
Performanță
În testul de inserare a 64 de milioane de elemente și ștergerea a 32 de milioane dintre acestea, competiția între std::unordered_map și tabela hash pentru GPU este practic inexistentă:
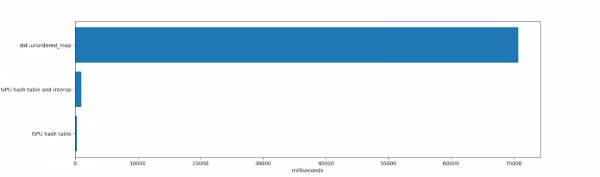
std::unordered_map a durat 70.691 ms pentru inserarea și ștergerea elementelor, urmată de eliberarea unordered_map (eliberarea milioanelor de elemente durează ceva timp, deoarece în interior unordered_map sunt efectuate numeroase alocări de memorie). Să fiu sincer, la std:unordered_map complet alte limitări. Acesta este un singur fir de execuție CPU, care suportă chei-valori de orice dimensiune, funcționează bine în condiții de utilizare ridicată și oferă performanță constantă după numeroase ștergeri.
Durata de funcționare a tabelului hash pentru GPU și interacțiunea dintre programe a fost de 984 ms. Aceasta include timpul petrecut pentru alocarea tabelului în memorie și ștergerea acestuia (alocarea unică a 1 GB de memorie, care în CUDA durează un anumit timp), inserarea și ștergerea elementelor, precum și iterația prin acestea. De asemenea, sunt luate în considerare toate copiile în memorie și din memoria plăcii grafice.
Execuția propriu-zisă a tabelului hash a durat 271 ms. Aceasta include timpul petrecut de placă grafică pentru inserarea și ștergerea elementelor, și nu ia în considerare timpul necesar pentru copierea în memorie și iterația prin tabelul rezultat. Dacă tabelul GPU există mult timp sau dacă tabelul hash este complet în memorie GPU (de exemplu, pentru a crea un tabel hash ce va fi utilizat de un alt cod GPU, nu de CPU), rezultatul testării este relevant.
Tabelul hash pentru placa grafică demonstrează o performanță ridicată datorită lățimii de bandă mari și paralele active.
Dezavantaje
Arhitectura tabelului hash are câteva probleme de care trebuie să țineți cont:
- Zonarea liniară este afectată de clusterizare, ceea ce face ca cheile din tabel să fie plasate departe de ideal.
- Cheile nu sunt șterse printr-o funcție
deleteși în timp aglomerează tabelul.
Ca rezultat, performanța tabelului hash poate scădea treptat, mai ales dacă acesta există mult timp și se efectuează numeroase inserții și ștergeri. Una dintre metodele de atenuare a acestor dezavantaje este rehashing-ul într-un nou tabel cu un coeficient de utilizare suficient de scăzut și filtrarea cheilor șterse în timpul rehashing-ului.
Pentru a ilustra problemele descrise, folosesc codul de mai sus pentru a crea un tabel cu 128 milioane de elemente, voi insera ciclic 4 milioane de elemente, până când umplu 124 milioane de sloturi (coeficient de utilizare de aproximativ 0,96). Iată tabelul rezultatelor, fiecare rând reprezentând un apel la nucleu CUDA cu inserarea a 4 milioane de elemente noi într-un tabel hash:
Coeficient de utilizare
Durata inserării a 4 194 304 de elemente
0,00
11,608448 ms (361,314798 milioane chei/sec.)
0,03
11,751424 ms (356,918799 milioane chei/sec.)
0,06
11,942592 ms (351,205515 milioane chei/sec.)
0,09
12,081120 ms (347,178429 milioane chei/sec.)
0,12
12,242560 ms (342,600233 milioane chei/sec.)
0,16
12,396448 ms (338,347235 milioane chei/sec.)
0,19
12,533024 ms (334,660176 milioane chei/sec.)
0,22
12,703328 ms (330,173626 milioane chei/sec.)
0,25
12,884512 ms (325,530693 milioane chei/sec.)
0,28
13,033472 ms (321,810182 milioane chei/sec.)
0,31
13,239296 ms (316,807174 milioane chei/sec.)
0,34
13,392448 ms (313,184256 milioane chei/sec.)
0,37
13,624000 ms (307,861434 milioane chei/sec.)
0,41
13,875520 ms (302,280855 milioane chei/sec.)
0,44
14,126528 ms (296,909756 milioane chei/sec.)
0,47
14,399328 ms (291,284699 milioane chei/sec.)
0,50
14,690304 ms (285,515123 milioane chei/sec.)
0,53
15,039136 ms (278,892623 milioane chei/sec.)
0,56
15,478656 ms (270,973402 milioane chei/sec.)
0,59
15,985664 ms (262,379092 milioane chei/sec.)
0,62
16,668673 ms (251,627968 milioane chei/sec.)
0,66
17,587200 ms (238,486174 milioane chei/sec.)
0,69
18,690048 ms (224,413765 milioane chei/sec.)
0,72
20,278816 ms (206,831789 milioane chei/sec.)
0,75
22,545408 ms (186,038058 milioane chei/sec.)
0,78
26,053312 ms (160,989275 milioane chei/sec.)
0,81
31,895008 ms (131,503463 milioane chei/sec.)
0,84
42,103294 ms (99,619378 milioane chei/sec.)
0,87
61,849056 ms (67,815164 milioane chei/sec.)
0,90
105,695999 ms (39,682713 milioane chei/sec.)
0,94
240,204636 ms (17,461378 milioane chei/sec.)
Pe măsură ce coeficientul de utilizare crește, performanța scade. Acest lucru este nedorit în majoritatea cazurilor. Dacă aplicația inserează elemente în tabel și apoi le elimină (de exemplu, la numărarea cuvintelor într-o carte), atunci aceasta nu este o problemă. Dar dacă aplicația folosește o tabelă de dispersie de lungă durată (de exemplu, într-un editor grafic pentru a stoca părțile non-goale ale imaginilor, când utilizatorul inserează și șterge frecvent informații), atunci un astfel de comportament poate provoca neplăceri.
Și am măsurat adâncimea de sondare a tabelei hash după 64 de milioane de inserții (coeficientul de utilizare 0,5). Adâncimea medie a fost de 0,4774, astfel încât majoritatea cheilor s-au aflat fie în cel mai bun slot posibil, fie într-un slot de cea mai bună poziție. Adâncimea maximă de sondare a fost de 60.
Apoi am măsurat adâncimea de sondare într-o tabelă cu 124 de milioane de inserții (coeficientul de utilizare 0,97). Adâncimea medie a fost deja de 10,1757, iar maximul a fost 6474 (!!). Performanța sondării liniare scade semnificativ la coeficiente mari de utilizare.
Cel mai bine este să menținem un coeficient de utilizare scăzut pentru această tabelă de hash. Dar atunci creștem performanța prin consumul de memorie. Din fericire, în cazul cheilor și valorilor de 32 de biți, acest lucru poate fi justificat. Dacă în exemplul de mai sus, tabela cu 128 de milioane de elemente are un coeficient de utilizare de 0,25, atunci vom putea stoca în ea nu mai mult de 32 de milioane de elemente, iar celelalte 96 de milioane de sloturi vor fi pierdute — câte 8 biți pentru fiecare pereche, 768 MB de memorie pierdută.
Rețineți că este vorba despre pierderea de memorie a plăcii video, care este un resurs mai valoroasă decât memoria sistemului. Deși majoritatea plăcilor video moderne de birou care susțin CUDA au minimum 4 GB de memorie (la momentul scrierii acestui articol, NVIDIA 2080 Ti are 11 GB), totuși, a pierde astfel de volume nu va fi cea mai înțeleaptă decizie.
Mai târziu, voi scrie mai în detaliu despre crearea tabelelor de hash pentru plăcile video care nu au probleme cu adâncimea de sondare, precum și despre modalitățile de reutilizare a sloturilor eliminate.
Măsurarea adâncimii de sondare
Pentru a determina adâncimea de sondare a cheii, putem extrage hash-ul cheii (indicele său ideal în tabel) din indicele său efectiv în tabel:
// get_key_index() -> index of key in hash table
uint32_t probelength = (get_key_index(key) - hash(key)) & (hashtablecapacity-1);
Datorită magiei a două numere binare în codul suplimentar și a faptului că capacitatea tabelei de hash este puterea de 2, această abordare va funcționa chiar și atunci când indicele cheii se mută la începutul tabelei. Să luăm o cheie care a fost hash-uită în 1, dar care este inserată în slotul 3. Atunci, pentru o tabelă cu capacitatea de 4, vom obține (3 — 1) & 3, ceea ce este echivalent cu 2.
Concluzie
Dacă aveți întrebări sau comentarii, scrieți-mi în sau deschideți un nou subiect în.
Acest cod a fost scris inspirat de articolele minunate:
În viitor, voi continua să scriu despre implementarea tabelelor de hash pentru plăcile video și voi analiza performanța acestora. În planurile mele se află legarea în lanț, hashing-ul lui Robin Hood și hashing-ul cu cuc, folosind operații atomice în structuri de date care sunt convenabile pentru plăcile video.
Sursa: habr.com
