

Sistemul analitic ClickHouse procesează o varietate de șiruri, consumând resurse. Pentru a accelera funcționarea sistemului, sunt adăugate constant noi optimizări. Dezvoltatorul ClickHouse, Nikolai Kochetov, vorbește despre tipul de date șir, inclusiv despre noul tip, LowCardinality, și explică cum se poate îmbunătăți performanța lucrului cu șirurile.
— Mai întâi, să înțelegem cum putem stoca șiruri.
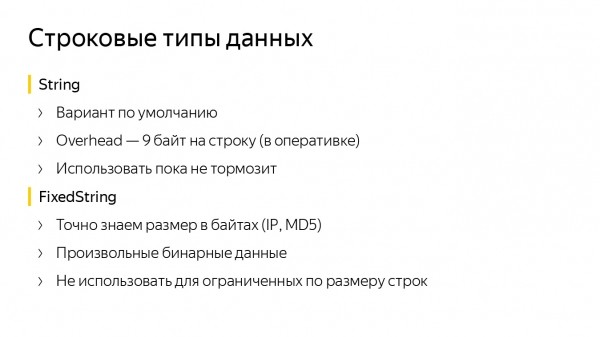
Avem tipuri de date pentru șiruri. String este potrivit ca opțiune implicită și ar trebui folosit aproape întotdeauna. Are un overhead mic — 9 octeți pentru un șir. Dacă dorim ca dimensiunea șirurilor să fie fixă și cunoscută dinainte, este mai bine să folosim FixedString. Aici putem specifica numărul dorit de octeți, ceea ce este convenabil pentru date precum adrese IP sau funcții hash.
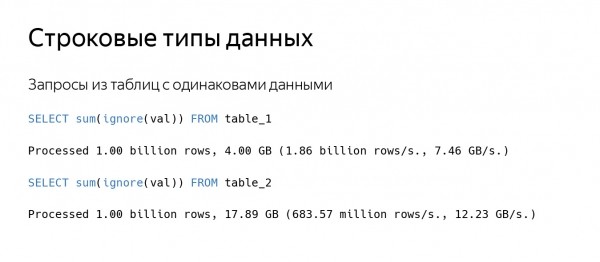
Desigur, uneori ceva poate să fie mai lent. Să spunem că efectuați o interogare asupra unei tabele. ClickHouse citește o cantitate destul de mare de date, să zicem, cu o viteză de 100 GB/s, în timp ce șirurile sunt procesate foarte puțin. Avem două tabele care stochează aproape aceleași date. Din a doua tabelă, ClickHouse citește datele cu o viteză mai mare, dar numărul de șiruri citite pe secundă este de trei ori mai mic.
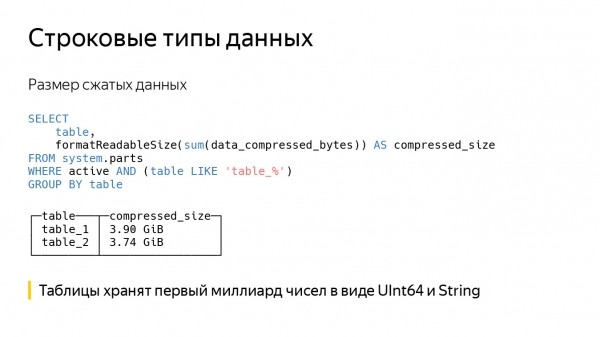
Dacă ne uităm la dimensiunea datelor comprimate, aceasta va fi aproape egală. De fapt, în tabele sunt stocate aceleași date — primul miliard de numere — doar că în prima coloană sunt înregistrate ca UInt64, iar în a doua coloană ca String. Din acest motiv, a doua interogare durează mai mult pentru a citi datele de pe disc și a le decomprima.
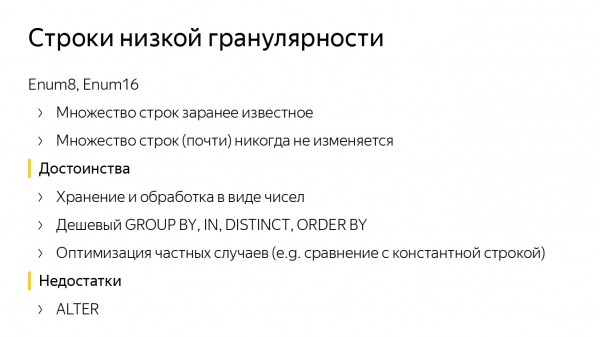
Iată un alt exemplu. Să presupunem că avem un set de șiruri cunoscut dinainte, limitat la o constantă de 1000 sau 10 000 și care nu se schimbă aproape niciodată. Pentru acest caz, tipul de date Enum este potrivit, iar în ClickHouse avem două tipuri — Enum8 și Enum16. Prin stocarea în Enum, procesăm rapid interogările.
În ClickHouse există optimizări pentru GROUP BY, IN, DISTINCT și optimizări pentru anumite funcții, de exemplu, pentru comparația cu un șir constant. Desigur, numerele din șir nu sunt convertite, ci, dimpotrivă, șirul constant este convertit în valoarea Enum. După aceea, toate sunt comparate rapid.
Dar există și dezavantaje. Chiar dacă știm exact setul de șiruri, uneori acesta trebuie să fie extins. A apărut un nou șir — trebuie să facem un ALTER.
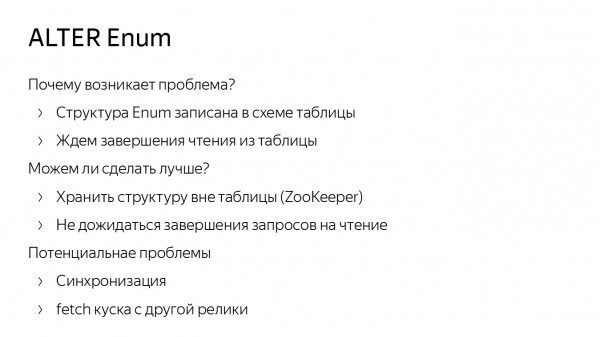
ALTER pentru Enum în ClickHouse este implementat optim. Nu rescriem datele pe disc, dar ALTER poate să râgâie din cauza faptului că structurile Enum sunt stocate în schema tabelului în sine. Prin urmare, trebuie să așteptăm cererile de citire din tabel, de exemplu.
Se pune întrebarea, se poate face mai bine? Probabil, da. Putem salva structura Enum nu în schema tabelului, ci în ZooKeeper. Totuși, pot apărea probleme legate de sincronizare. De exemplu, o replică a primit datele, iar alta nu, iar dacă aceasta din urmă are un Enum vechi, atunci ceva se va strica. (În ClickHouse aproape am terminat de implementat cererile ALTER non-blocante. Când le finalizăm complet, nu va mai fi necesar să așteptăm cererile de citire.)
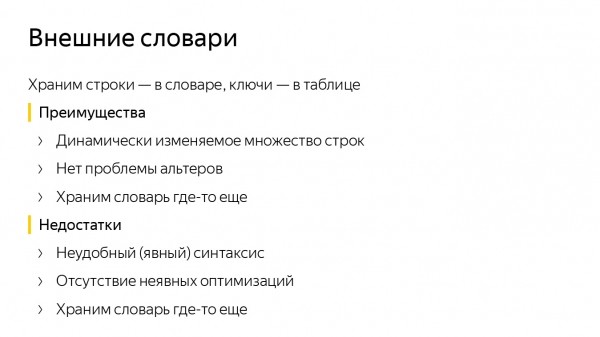
Pentru a nu ne ocupa cu ALTER Enum, putem folosi dicționarele externe ClickHouse. Reamintesc că aceasta este o structură de date key-value în ClickHouse, prin care putem obține date din surse externe, de exemplu din tabele MySQL.
În dicționarul ClickHouse stocăm multe șiruri diferite, iar în tabel avem identificatorii lor sub formă de numere. Dacă trebuie să obținem un șir, apelăm funcția dictGet și lucrăm cu el. După aceea, nu mai trebuie să facem ALTER. Pentru a adăuga ceva în Enum, îl inserăm în aceeași tabelă MySQL.
Dar aici apar alte probleme. În primul rând, sintaxa incomodă. Dacă dorim să obținem un șir, trebuie să apelăm dictGet. În al doilea rând, lipsa unor optimizări. Comparația cu un șir constant pentru dicționare nu se poate face la fel de repede.
De asemenea, pot exista probleme cu actualizarea. Să presupunem că am solicitat un șir în dicționarul cache, dar acesta nu a fost inclus în cache. Atunci va trebui să așteptăm până când datele sunt încărcate din sursa externă.
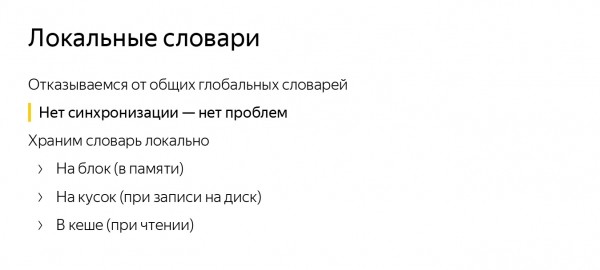
Dezavantajul general al ambelor metode este că stocăm toate cheile într-un singur loc și le sincronizăm. De ce să nu stocăm dicționarele local? Fără sincronizare, fără probleme. Puteți stoca dicționarul local pe un segment de disc. Asta înseamnă că am făcut Insert, am salvat dicționarul. Dacă lucrăm cu date în memorie, putem salva dicționarul fie în blocul de date, fie în segmentul de coloană, fie într-un fel de cache pentru a accelera calculările.
Codificarea dicționarului pentru șiruri
Astfel, am ajuns la crearea unui nou tip de date în ClickHouse - LowCardinality. Acesta este un format de stocare a datelor: cum sunt scrise pe disc și cum sunt citite, cum sunt prezentate în memorie și schema lor de procesare.
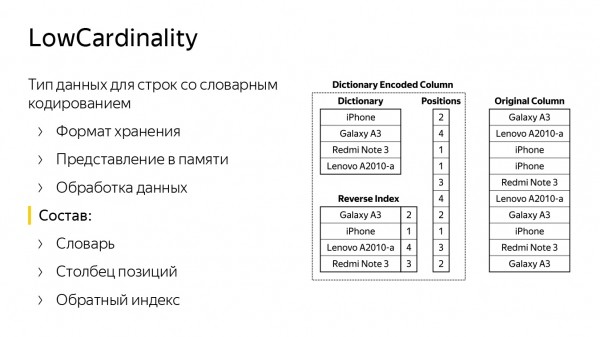
Pe diapozitiv există două coloane. În dreapta, rândurile sunt stocate standard, în tipul String. Se observă că sunt modele de telefoane mobile. În stânga este aceeași coloană, doar că în tipul LowCardinality. Aceasta constă dintr-un dicționar cu multe rânduri diferite (rânduri din coloana din dreapta) și o listă de poziții (numerele rândurilor).
Cu ajutorul acestor două structuri, putem reconstrui coloana inițială. De asemenea, există un index invers — o tabelă hash care ajută să găsim poziția din dicționar pe baza unui rând. Aceasta este necesară pentru a accelera anumite interogări. De exemplu, dacă dorim să comparăm, să căutăm un rând în coloana noastră sau să le unim.
LowCardinality este un tip de date parametric. Poate fi fie un număr, fie ceva care este stocat ca număr, fie un șir, fie Nullable de la acestea.
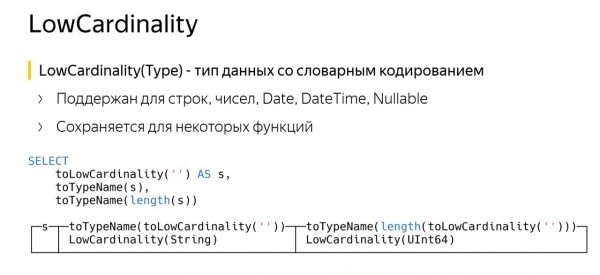
Particularitatea LowCardinality este că acesta poate fi păstrat pentru anumite funcții. Pe diapozitiv se poate vedea un exemplu de interogare. În prima linie, am creat o coloană de tip LowCardinality de la String, numind-o S. Apoi am întrebat numele acesteia — ClickHouse a spus că este LowCardinality de la String. Totul este corect.
A treia linie este aproape aceeași, doar că am apelat funcția length. În ClickHouse, funcția length returnează tipul de date UInt64. Dar am obținut LowCardinality de la UInt64. Care este scopul?
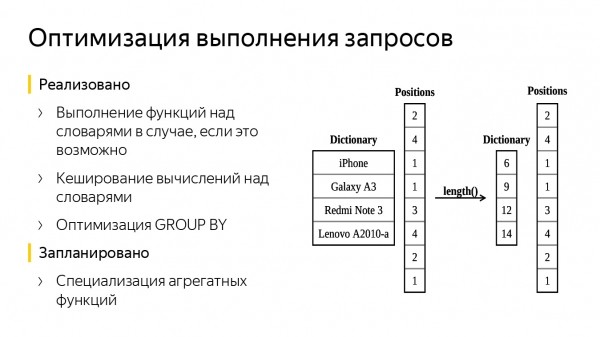
În dicționar erau stocate denumirile telefoanelor mobile, am aplicat funcția length. Acum avem un dicționar similar, constând doar din numere — acestea sunt lungimile șirurilor. Coloana cu pozițiile nu s-a schimbat. În final, am procesat mai puține date, economisind timp pentru interogare.
Pot exista și alte optimizări, de exemplu, adăugarea unui cache simplu. Atunci când se calculează valoarea unei funcții, o putem reține și construi aceeași, fără a o recalcula.
De asemenea, poate fi realizată o optimizare a GROUP BY, deoarece coloana noastră cu dicționarul este deja parțial agregată — se pot calcula mai repede valorile funcțiilor hash și se poate găsi aproximativ bucket-ul în care să fie plasat următorul rând. De asemenea, se pot specializa unele funcții agregate, de exemplu uniq, deoarece în aceasta pot fi trimise doar dicționarele, iar pozițiile pot rămâne netocmite — astfel, totul va funcționa mai repede. Primele două optimizări au fost deja adăugate în ClickHouse.
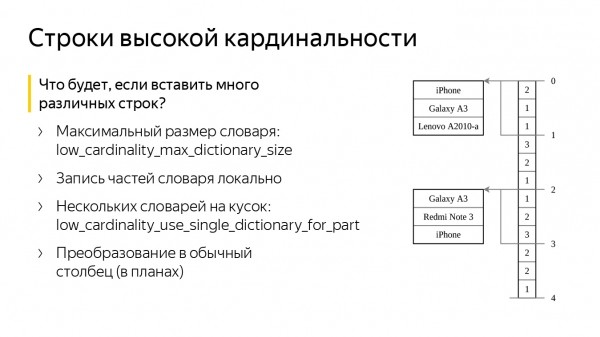
Ce ar fi dacă am crea o coloană cu tipul nostru de date și am insera în ea multe șiruri diferite și proaste? Oare nu ne va umple memoria? Nu, pentru asta ClickHouse are două setări speciale. Prima este low_cardinality_max_dictionary_size. Acesta este dimensiunea maximă a dicționarului care poate fi scris pe disc. Inserarea se desfășoară astfel: atunci când inserăm date, primim un flux de șiruri, din acestea formăm un mare dicționar comun. Dacă dicționarul devine mai mare decât valoarea setării, scriem dicționarul curent pe disc, iar celelalte șiruri le stocăm undeva „pe lângă”, lângă indici. În cele din urmă, niciodată nu vom recalcula un dicționar mare și nu vom avea probleme de memorie.
A doua setare se numește low_cardinality_use_single_dictionary_for_part. Imaginează-ți că, în schema anterioară, când am inserat datele, dicționarul nostru s-a umplut și l-am scris pe disc. Se pune întrebarea, de ce să nu formăm acum un alt dicționar identic?
Când se umple, îl vom scrie din nou pe disc și vom începe să formăm al treilea. Această setare dezactivează exact această posibilitate din oficiu.
De fapt, multe dicționare pot fi utile dacă dorim să inserăm un anumit set de șiruri, dar am inserat din greșeală „gunoi”. Să spunem că mai întâi am inserat șiruri proaste și apoi am inserat unele bune. Atunci dicționarul se va împărți în multe dicționare mici. O parte dintre ele vor conține „gunoi”, dar ultimele vor avea șiruri bune. Și dacă citim, să spunem, doar ultima granula, atunci totul va funcționa rapid.
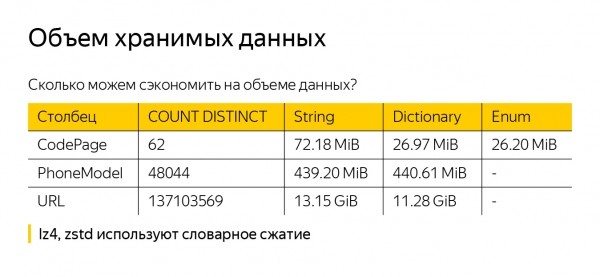
Înainte de a vorbi despre avantajele LowCardinality, trebuie să spun că este puțin probabil să obținem o reducere a datelor pe disc (deși acest lucru poate să se întâmple), deoarece ClickHouse comprimă datele. Există o opțiune implicită - LZ4. De asemenea, se poate face comprimare folosind ZSTD. Dar ambele algoritmi deja implementează comprimarea dicționarului, așa că dicționarul nostru extern ClickHouse nu va ajuta foarte mult.
Pentru a nu fi nedrept, am luat unele date din metrică — String, LowCardinality(String) și Enum — și le-am salvat în tipuri diferite de date. Am obținut trei coloane, fiecare având un miliard de rânduri. În prima coloană, CodePage, sunt doar 62 de valori. Se observă că LowCardinality(String) ne-a comprimat rezultatele mai bine. String este puțin mai puțin eficient, dar asta se datorează, probabil, faptului că șirurile sunt scurte, păstrăm lungimile acestora, iar acestea ocupă mult loc, fiind mai puțin comprimabile.
Dacă luăm PhoneModel, avem 48 de mii — deja mai mult, iar diferențele între String și LowCardinality(String) sunt aproape inexistente. Pentru URL, am economisit doar 2 GB — cred că nu merită să ne bazăm pe asta.
Evaluarea vitezei de execuție
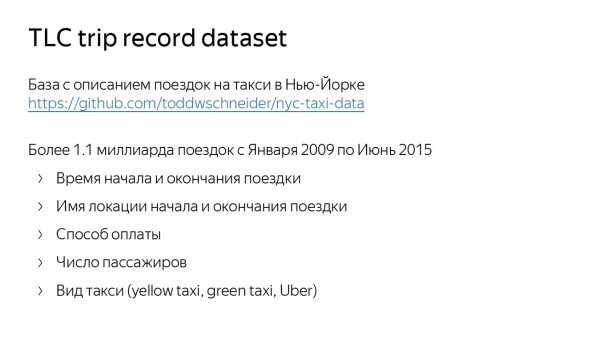
Acum să evaluăm viteza de execuție. Pentru a o evalua, am folosit un dataset cu descrierea călătoriilor cu taxiul din New York. Acesta se găsește pe GitHub. Conține puțin peste un miliard de călătorii. Reflectă locația, ora de început și de sfârșit a călătoriei, metoda de plată, numărul de pasageri și chiar tipul de taxi — verde, galben și Uber.
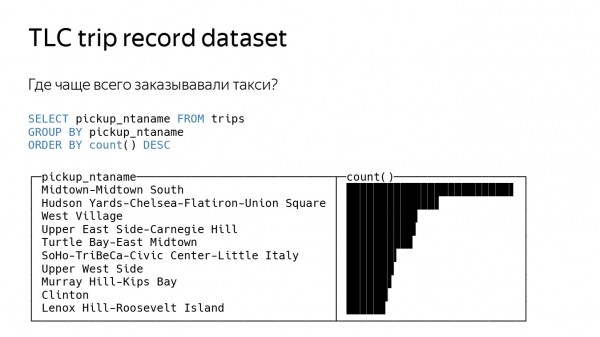
Prima întrebare am formulat-o destul de simplu — am întrebat unde se comandă cel mai des taxiuri. Pentru aceasta, trebuie să luăm locația de unde s-au făcut comenzile, să facem un GROUP BY pe ea și să numărăm funcția count. Iată ce produce ClickHouse.
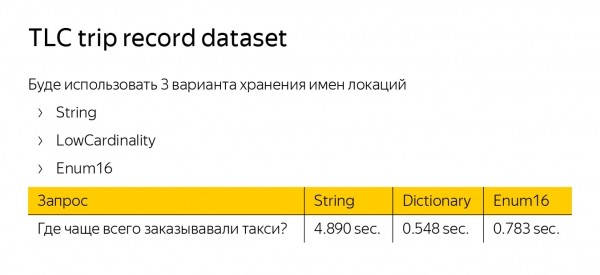
Pentru a măsura viteza de procesare a interogării, am creat trei tabele cu date identice, dar am folosit pentru locația noastră de start trei tipuri diferite de date — String, LowCardinality și Enum. LowCardinality și Enum s-au dovedit a fi de cinci ori mai rapide decât String. Enum este mai rapid pentru că lucrează cu numere. LowCardinality este mai rapid datorită optimizării GROUP BY.
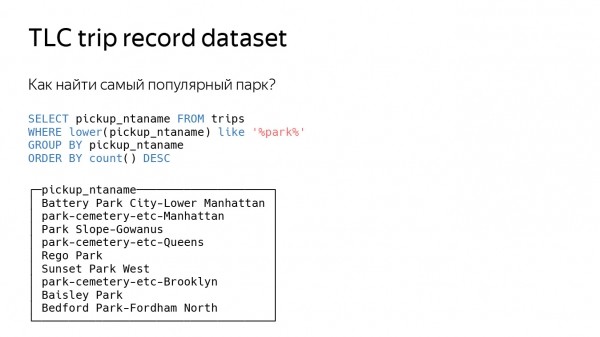
Hai să complicăm un pic interogarea — să întrebăm unde se află cel mai popular parc din New York. Din nou vom măsura aceasta pe baza locurilor unde se comandă cel mai des taxiuri, dar vom filtra doar acele locații care conțin cuvântul „parc”. De asemenea, vom adăuga funcția like.
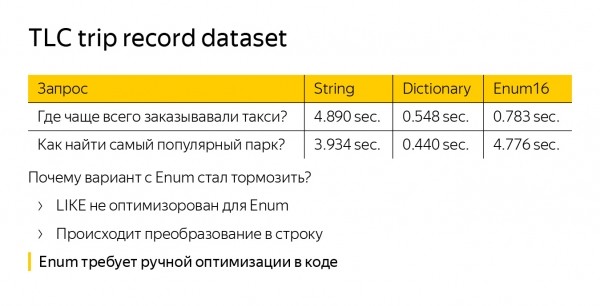
Ne uităm la timp — observăm că Enum a început brusc să încetinească. Și funcționează chiar mai încet decât tipul de date standard, String. Acest lucru se întâmplă pentru că funcția like nu este deloc optimizată pentru Enum. Trebuie să convertim șirurile noastre din Enum în șiruri obișnuite — facem mai multă muncă. LowCardinality(String) nu este optimizat în mod implicit, dar acolo like funcționează pe baza unui dicționar, astfel că interogarea se accelerează față de String.
Când lucrăm cu Enum, există o problemă mai globală. Dacă dorim să-l optimizăm, trebuie să facem acest lucru în fiecare loc din cod. Să presupunem că am scris o nouă funcție — trebuie neapărat să venim cu o optimizare pentru Enum. În schimb, LowCardinality este optimizat implicit.
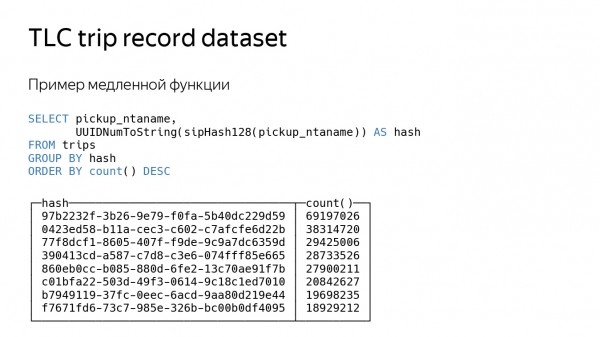
Să ne uităm la ultima cerere, care este mai artificială. Vom calcula pur și simplu funcția hash a locației noastre. Funcția hash este o cerere destul de lentă, durează mult, așa că totul va fi încetinit de aproximativ trei ori.
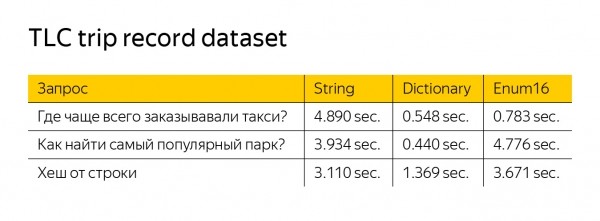
LowCardinality funcționează în continuare mai rapid, deși nu există filtrare aici. Aceasta se întâmplă deoarece funcțiile noastre lucrează doar cu dicționarul. Funcția de calcul a hash-ului are un singur argument — poate procesa mai puține date și poate returna, de asemenea, LowCardinality.
Planul nostru global este de a obține o viteză de lucru nu mai mică decât String în orice caz și să menținem accelerația. Și, poate, cândva vom înlocui String cu LowCardinality, veți actualiza ClickHouse, iar totul va funcționa puțin mai repede.
Sursa: habr.com
