

Această notă va fi interesantă pentru cei care folosesc biblioteca de procesare a datelor tabelare pentru R — data.table, și, posibil, vor fi încântați să vadă flexibilitatea utilizării sale în diferite exemple.
Inspirat de un exemplu bun , și sperând că ați citit deja articolul său, vă propun să aprofundăm optimizarea codului și performanța pe baza data.table.
Introducere: de unde provine data.table?
Cel mai bine este să începem familiarizarea cu biblioteca puțin din depărtare, adică, cu structurile de date din care poate fi obținut un obiect data.table (în continuare, DT).
Array
Cod
## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)
Una dintre aceste structuri este un array (?base::array). Asemenea altor limbaje, arrays-urile aici sunt multidimensionale. Cu toate acestea, interesant este că, de exemplu, un array bidimensional începe să moștenească proprietăți de la clasa matrice (?base::matrix), iar un array unidimensional, ceea ce este de asemenea important, nu moștenește de la vector (?base::vector).
În acest context, trebuie să înțelegem că tipul de date conținute într-un obiect trebuie verificat cu funcția base::typeof, care returnează descrierea internă a tipului conform R Internals — protocolul general al limbajului, legat de primordial C.
O altă comandă, pentru a determina clasa unui obiect, base::class, returnează în cazul vectorilor tipul vectorial (acesta diferă prin nume de cel intern, dar permite, de asemenea, să înțelegeți tipul datelor).
Lista
Dintr-un array bidimensional, adică, matrice, se poate trece la o listă (?base::list).
Cod
## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)
În acest proces au loc câteva lucruri simultan:
- Se comprimă a doua dimensiune a matricei, astfel că obținem simultan și o listă, și un vector.
- O listă, astfel, moștenește de la aceste clase. Trebuie să ținem cont de faptul că fiecărui element din listă îi va corespunde o singură valoare (scalară) din celula matricei-array.
Datorită faptului că lista este de asemenea și un vector, la aceasta se pot aplica anumite funcții pentru vectori.
Data frame
Dintr-o listă, matrice sau vector se poate trece la un data frame (?base::data.frame).
Cod
## data.frames ------------

df <- as.data.frame(arrmatr)
df2 <- as.data.frame(mylist)

is.list(df)

df$V6 <- df$V1 + df$V2
Ce este interesant în el: data frame-ul moștenește de la listă! Coloanele data frame-ului sunt celule ale listei. Acest lucru va fi important mai târziu, când vom folosi funcții aplicate listelor.
data.table
Se poate obține DT (?data.table::data.table) din data frame, listă, vector sau matrice. De exemplu, așa (in place).
Cod
## data.tables -----------------------
library(data.table)

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)
Util este că, asemenea data frame-ului, DT moștenește proprietățile listei.
DT și memoria
Spre deosebire de toate celelalte obiecte din R base, DT sunt transmise prin referință. Dacă trebuie să faceți o copie într-o nouă zonă de memorie, aveți nevoie de o funcție data.table::copy sau trebuie să faceți o selecție din obiectul vechi.
Cod
df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)
Cu aceasta, introducerea se apropie de sfârșit. DT este o continuare a dezvoltării structurilor de date în R, care se desfășoară în principal prin extinderea și accelerarea operațiunilor efectuate asupra obiectelor de clasă data.frame. În acest proces, se păstrează moștenirea de la alte primitive.
Câteva exemple de utilizare a proprietăților data.table
Ca o listă...
A itera prin rândurile unui data.frame sau DT nu este cea mai bună idee, deoarece codul pentru bucle în limbaj R este mult mai lent C, dar a parcurge o buclă prin coloane, care, de obicei, sunt mult mai puține, este perfect posibil. Mergând pe coloane, rețineți că fiecare coloană este un element al listei, care conține, de regulă, un vector. Operațiile asupra vectorilor sunt bine vectorizate în funcțiile de bază ale limbajului. De asemenea, se pot folosi operatori de selecție specifici listelor și vectorilor: `[[`, `$`.
Cod
## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))
Vectorizarea
Dacă există necesitatea de a parcurge rândurile unei DT mari, cea mai bună soluție ar fi scrierea unei funcții cu vectorizare. Dar dacă acest lucru nu este posibil, trebuie să rețineți că bucla inside DT este totuși mai rapidă decât bucla în R, deoarece se execută pe C.
Să încercăm un exemplu mai mare cu 100K rânduri. Vom extrage prima literă din cuvintele care se află în coloana vector. w.
Actualizat
Cod
library(magrittr)
library(microbenchmark)

## Exemplu mai mare ----

rown <- 100000

dt %
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vectorizare

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# al doilea

first_l_f %
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# al treilea

first_l_f2 %
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})
Primul test cu iterație prin rânduri:
Unitate: milisecunde
expr min
{ dt[, `:=`(first_l, unlist(strsplit(w, split = " ", fixed = T))[1]), by = 1:nrow(dt)] } 439.6217
lq mean median uq max neval
451.9998 460.1593 456.2505 460.9147 621.4042 100
A doua rundă, unde vectorizarea se face prin conversia listei într-o matrice și preluarea elementelor pe un tăiat cu indexul 1 (aceasta este, de fapt, vectorizarea). Voi corecta: vectorizarea la nivel de funcție strsplit, care poate accepta un vector ca intrare. Se dovedește că procedura de transformare a listei într-o matrice este mult mai grea decât vectorizarea în sine, dar și în acest caz este mult mai rapidă decât varianta nevectorizată.
Unitate: milisecunde
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f(w)))] } 93.07916 112.1381 161.9267 149.6863 185.9893 442.5199 100
Accelerarea pe medie în de 3 ori.
A treia rundă, unde schema de transformare în matrice a fost schimbată.
Unitate: milisecunde
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f2(w)))] } 32.60481 34.13679 40.4544 35.57115 42.11975 222.972 100
Accelerarea pe medie în de 13 ori.
Trebuie să experimentăm cu această problemă, cu cât mai mult — cu atât mai bine va fi.
Î încă unul exemplu de vectorizare, unde este și text, dar este aproape de condițiile reale: lungimi diferite ale cuvintelor, număr diferit de cuvinte. Trebuie să extragem primele 3 cuvinte. Iată cum:
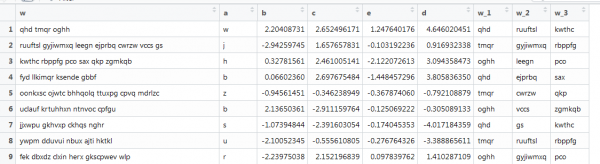
Aici, funcția anterioară nu mai funcționează, deoarece vectorii au lungimi diferite, iar noi am stabilit dimensiunea matricei. O vom refăcea, căutând pe internet.
Cod
# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]
Unitate: milisecunde
expr min lq mean median
{ dt[, `:=`((paste0(«w_», 1:3)), strsplit(w, split = " ", fixed = T))] } 851.7623 916.071 1054.5 1035.199
uq max neval
1178.738 1356.816 100
Scriptul a funcționat cu o viteză medie de 1 secundă. Nu e rău.
Legate printr-un lanț…
Cu obiectele DT se poate lucra, folosind chaining. Arată ca atașarea sintaxei parantezelor din dreapta, practic, un pic de zahăr.
Cod
# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]
Curge prin țevi…
Aceleași operațiuni pot fi efectuate prin piping, arată similar, dar funcțional mai bogat, deoarece se pot folosi orice metode, nu doar DT. Să extragem coeficienții regresiei logistice pentru datele noastre sintetice cu o serie de filtre pe DT.
Cod
# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]
Statistică, învățare automată și altele în cadrul DT
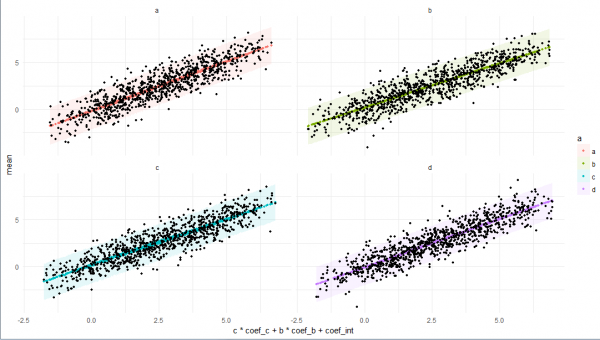
Se pot folosi funcții lambda, dar uneori este mai bine să le creăm separat, să scriem întregul pipeline de analiză a datelor, și înainte — ele funcționează în cadrul DT. Exemplul este îmbogățit cu toate caracteristicile menționate mai sus, plus câteva lucruri utile din arsenalul DT (cum ar fi accesul la DT în interiorul DT prin referință, uneori inserate nu în mod secvențial, dar pentru a fi acolo).
Cod
# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Concluzie
Sper că am reușit să creez o imagine coerentă, dar, desigur, incompletă, a unui obiect precum data.table, începând de la proprietățile sale legate de moștenirea claselor R și terminând cu propriile caracteristici și mediul său din elementele tidyverse. Sper că aceasta vă va ajuta să învățați mai bine și să aplicați această bibliotecă pentru lucru și distracție.
Mulțumesc!
Codul complet
Cod
## load libs ----------------

library(data.table)
library(ggplot2)
library(magrittr)
library(microbenchmark)


## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)


## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)


## data.frames ------------

df <- as.data.frame(arrmatr)

is.list(df)

df$V6 <- df$V1 + df$V2


## data.tables -----------------------

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)

df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)


## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))


## Bigger example ----

rown <- 100000

dt <-
	data.table(
		w = sapply(seq_len(rown), function(x) paste(sample(letters, 3, replace = T), collapse = ' '))
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vectorization

# zero - for loop

microbenchmark({
	for(i in 1:nrow(dt))
		{
		dt[
			i
			, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		]
	}
})

# first

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# second

first_l_f <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# third

first_l_f2 <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})

# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]


# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]

# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]


# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Sursa: habr.com
