

În procesarea complexă a unor seturi mari de date (diferite : importuri, conversii și sincronizări cu o sursă externă) apare adesea necesitatea de a "memora" temporar și de a procesa rapid ceva voluminos.
O sarcină tipică de acest tip sună de obicei cam așa: "Iată aici plățile recente primite, trebuie să le încărcăm rapid pe site și să le legăm de conturi"
Dar când volumul acestui "ceva" începe să fie de sute de megabiți, iar serviciul trebuie să continue să lucreze cu baza în modul 24×7, apar numeroase efecte secundare, care îți vor complica viața.
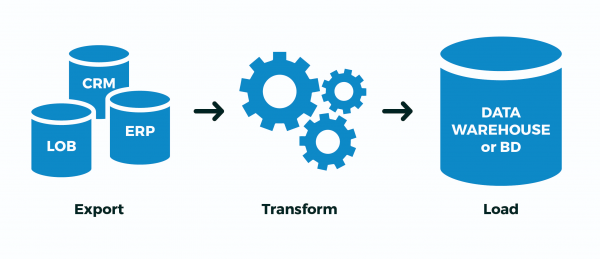
Pentru a face față acestora în PostgreSQL (și nu doar în el), poți folosi anumite opțiuni de optimizare, care vor permite procesarea mai rapidă și cu un consum mai mic de resurse.
1. Unde să încărcăm?
Mai întâi să ne stabilim unde putem încărca datele pe care dorim să le "procesăm".
1.1. Tabele temporare (TEMPORARY TABLE)
În principiu, pentru PostgreSQL, tabelele temporare sunt la fel ca și oricare alte tabele. Prin urmare, superstițiile de tipul " acolo totul este stocat doar în memorie, care poate să se termine"sunt false. Dar există și câteva diferențe esențiale.
Spațiu de nume propriu pentru fiecare conexiune la Bază de date
Dacă două conexiuni încearcă simultan să execute CREATE TABLE x, atunci cineva va obține cu siguranță eroarea de unicitate a obiectelor din Baza de date.
Dar dacă ambele încearcă să execute CREAȚI TEMPORAR TABELA x, atunci ambele o vor face corect și fiecare va primi exemplarul său al tabelei. Și nu va exista nimic comun între ele.
"Auto-distrugerea" la deconectare
La închiderea conexiunii, toate tabelele temporare sunt șterse automat, așa că nu are rost să efectuezi "manual" DROP TABLE x cuiva, în afară de...
Dacă lucrezi prin pgbouncer în modul de tranzacție, baza tot continuă să considere că această conexiune este încă activă, iar în ea această tabelă temporară există în continuare.
Așadar, încercarea de a o crea din nou, dintr-o altă conexiune la pgbouncer, va duce la o eroare. Dar acest lucru poate fi evitat, folosind CREAȚI O MASĂ TEMPORARĂ DACĂ NU EXISTĂ x.
Adevărat, mai bine să nu faci asta, deoarece poți „descoperi brusc” acolo datele rămase de la „proprietarul anterior”. În schimb, este mult mai bine să citești manualul și să vezi că, atunci când creezi o tabelă, există posibilitatea de a adăuga LA CLOSARE ȘTERGE — adică, la finalizarea tranzacției, tabela va fi ștearsă automat.
Non-replicare
Din cauza apartenenței doar la o anumită conexiune, tabelele temporare nu sunt replicate. Totuși aceasta scutește de necesitatea unei dublări a datelor în heap + WAL, așa că INSERT/UPDATE/DELETE în ea este semnificativ mai rapid.
Dar, deoarece tabela temporară este totuși „aproape obișnuită”, nu o poți crea nici pe replica. Cel puțin, deocamdată, deși un patch corespunzător circulă de mult.
1.2. Tabelele ne-jurnalizate (UNLOGGED TABLE)
Dar ce să faci, de exemplu, dacă ai un proces ETL voluminos care nu poate fi realizat într-o singură tranzacție, iar tu ai pgbouncer în modul de tranzacție?..
Sau fluxul de date este atât de mare încât capacitatea unei singure conexiuni cu baza de date (puteți citi, un singur proces pe CPU)?..
Sau o parte din operațiuni se desfășoară asynchronously în conexiuni diferite?..
Aici singura variantă este - a crea temporar o tabelă non-temporară. Un joc de cuvinte, da. Adică:
- ai creat „tabelele tale” cu nume cât mai aleatorii, pentru a nu te intersecta cu nimeni
- Extract: ai încărcat datele dintr-o sursă externă în ele
- Transform: ai transformat, completat câmpurile cheie de legătură
- Load: ai transferat datele gata în tabelele de destinație
- ai șters „tabelele tale”
Și acum - o linguriță de catran. Practic, toată scrierea în PostgreSQL se face de două ori — , apoi în corpurile tabelelor/indecșilor. Toate acestea sunt realizate pentru a susține ACID și o vizibilitate corectă a datelor între COMMIT‘comise și ROLLBACK‘comise tranzacții.
Dar noi nu avem nevoie de asta! Tot procesul nostru a trecut fie complet cu succes, fie nu.. Nu contează câte tranzacții intermediare are - nu ne interesează „a continua procesul din mijloc”, mai ales când nu este clar unde a fost.
Pentru asta, dezvoltatorii PostgreSQL au implementat încă din versiunea 9.1 așa ceva precum :
Cu această specificație, tabela este creată ca ne-jurnalizată. Datele scrise în tabelele ne-jurnalizate nu trec prin jurnalul de pre-înregistrare (vezi Capitolul 29), rezultând că astfel de tabele funcționează mult mai repede decât cele obișnuite. Cu toate acestea, ele nu sunt protejate împotriva căderilor; în cazul unei căderi sau al unei opriri de urgență a serverului, tabelul ne-înregistrat este tăiat automat. În plus, conținutul tabelului ne-înregistrat nu este replicat pe serverele secundare. Orice indici creați pentru tabelul ne-înregistrat devin automat ne-înregistrați.
Pe scurt, va fi mult mai rapid, dar dacă serverul de baze de date „cade” — va fi neplăcut. Dar cât de des se întâmplă asta și poate procesul dvs. ETL să îl finalizeze corect „din mijloc” după „revitalizarea” bazei de date?..
Dacă nu, iar cazul de mai sus este similar cu al vostru — folosiți UNLOGGED, dar niciodată nu activați acest atribut pe tabelele reale, ale căror date vă sunt dragi.
1.3. PE FINAL { ȘTERGE LINIILE | CAD }
Această construcție permite la crearea tabelului să definească un comportament automat la finalizarea tranzacției.
Despre LA CLOSARE ȘTERGE am menționat mai sus, el generează DROP TABLE, dar în cazul LA CLOSARE ȘTERGE RÂNDURI situația este mai interesantă — aici se generează TRUNCATE TABLE.
Din moment ce întreaga infrastructură de stocare a metadescrierii tabelului temporar este exact la fel ca cea a unui tabel obișnuit, atunci crearea și ștergerea constantă a tabelelor temporare duce la o „umflare” puternică a tabelelor de sistem pg_class, pg_attribute, pg_attrdef, pg_depend,…
Acum imaginați-vă că aveți un worker pe o conexiune directă cu baza de date, care deschide o nouă tranzacție în fiecare secundă, creează, umple, procesează și șterge un tabel temporar… Vor acumula gunoi în tabelele de sistem, ceea ce va cauza întârzieri suplimentare la fiecare operație.
În general, nu faceți așa! În acest caz, este mult mai eficient CREATE TEMPORARY TABLE x ... PE FINAL ȘTERGE LINIILOR să fie scos din ciclul tranzacțiilor — atunci la începutul fiecărei noi tranzacții tabelele vor exista deja (economisind apelul CREAȚI), dar va fi gol, datorită TRUNCATE (apelul său l-am economisit și noi) la finalizarea tranzacției anterioare.
1.4. LIKE… INCLUDÂNDU…
Am menționat la început că unul dintre cazurile tipice de utilizare pentru tabelele temporare — este diferite tipuri de importuri — și dezvoltatorul copiază obosit lista de câmpuri ale tabelei țintă în declarația tabelului său temporar…
Dar lenea este motorul progresului! Așadar, crearea unui nou tabel „după exemplu” se poate face mult mai simplu:
CREATE TEMPORARY TABLE import_table(
  LIKE target_table
);
Deoarece este posibil să se genereze o cantitate foarte mare de date în această tabelă, căutările vor deveni destul de lente. Dar există o soluție tradițională pentru aceasta - indecșii! Și, da, tabloul temporar poate avea de asemenea indecși.
Deoarece, de multe ori, indecșii necesari coincid cu indecșii tabelei țintă, poți pur și simplu să scrii CAUTA target_table INCLUDÂ INDEXURILE.
Dacă ai nevoie și de DEFAULT-valori (de exemplu, pentru completarea valorilor cheii primare), poți utiliza CAUTA target_table INCLUDĂRILE IMPLICITĂ. Sau pur și simplu - CAUTA target_table INCLUSIV TOATE — va copia valorile implicite, indecșii, constrângerile,…
Dar aici trebuie să înțelegi că, dacă ai creat tabela de import direct cu indecși, atunci datele vor fi încărcate mai lent, decât dacă le încarci mai întâi pe toate și apoi aplici indecșii - uită-te ca exemplu la cum face .
În general, !
2. Cum să scrii?
Voi spune simplu - folosește -flux în loc de „pachet” INSERT, . Poți chiar să o faci direct dintr-un fișier pregătit anterior.
3. Cum să procesezi?
Așadar, să presupunem că introducerea noastră arată cam așa:
- ai în baza de date o tabelă cu datele clienților de 1M înregistrări
- în fiecare zi clientul îți trimite un nou întreg „profil”
- din experiență știi că de la o dată la alta se schimbă nu mai mult de 10K înregistrări
Un exemplu clasic al unei astfel de situații este — există multe adrese, dar în fiecare export săptămânal de modificări (schimbări de nume de localități, fuziuni de străzi, apariția de noi case) sunt foarte puține chiar și la scară națională.
3.1. Algoritmul de sincronizare completă
Pentru simplificare, să presupunem că nu trebuie nici măcar să restructurezi datele - trebuie doar să aduci tabela în forma dorită, adică:
- să ștergi tot ce nu mai există
- să actualizezi tot ce existase deja și trebuie actualizat
- să inserezi tot ce nu mai fusese încă
De ce trebuie să efectuezi operațiile în această ordine? Pentru că astfel dimensiunea tabelei va crește minim ().
DELETE FROM dst
Nu, desigur, poți face totul doar cu două operații:
- să ștergi (
DELETE) în general tot - să inserezi totul din noul profil
Dar astfel, datorită MVCC, dimensiunea tabelei va crește exact de două ori! A obține +1M înregistrări în tabel din cauza actualizării a 10K - e o redundanță cam mare…
TRUNCATE dst
Un dezvoltator mai experimentat știe că întreaga tabelă poate fi ștearsă destul de ieftin:
- a curăța (
TRUNCATE) întreaga tabelă - să inserezi totul din noul profil
Metoda este eficientă, , dar avem o problemă… Vom încărca 1M de înregistrări timp de mult timp, așa că nu ne putem permite să lăsăm tabelul gol în tot acest timp (așa cum se va întâmpla fără a fi învăluit într-o singură tranzacție).
Asta înseamnă că:
- începem o tranzacție de lungă durată
TRUNCATEimpune AccessExclusive-blocare- facem o inserție îndelungată, iar ceilalți în acest timp nu pot nici măcar
SELECT
Ceva nu merge bine…
ALTER TABLE… RENAME… / DROP TABLE …
Ca alternativă – putem încărca totul într-un tabel nou și apoi pur și simplu să-l redenumim în locul celui vechi. Câteva detalii neplăcute:
- asta la fel AccessExclusive, deși semnificativ mai puțin în timp
- se resetează toate planurile de interogare/statistica acestui tabel,
- se strică toate cheile externe (FK) pe tabel
A fost un patch WIP de la Simon Riggs, care a propus să facem ALTER-operațiune pentru înlocuirea corpului tabelului la nivel de fișier, fără a atinge statisticile și FK, dar nu a adunat cvorumul.
DELETE, UPDATE, INSERT
Deci, ne oprim pe varianta non-blocantă din cele trei operații. Aproape trei… Cum putem face acest lucru cel mai eficient?
-- facem totul în cadrul tranzacției, astfel încât nimeni să nu vadă "stările intermediare"
BEGIN;

-- creăm un tabel temporar cu datele importate
CREATE TEMPORARY TABLE tmp(
  LIKE dst INCLUDING INDEXES -- după modelul și asemănarea, împreună cu indexurile
) ON COMMIT DROP; -- dincolo de tranzacție nu ne mai trebuie

-- încărcăm rapid noul set prin COPY
COPY tmp FROM STDIN;
-- ...
-- .

-- ștergem absențele
DELETE FROM
  dst D
USING
  dst X
LEFT JOIN
  tmp Y
    USING(pk1, pk2) -- câmpuri cheie principal
WHERE
  (D.pk1, D.pk2) = (X.pk1, X.pk2) AND
  Y IS NOT DISTINCT FROM NULL; -- "anti-joint"

-- actualizăm restul
UPDATE
  dst D
SET
  (f1, f2, f3) = (T.f1, T.f2, T.f3)
FROM
  tmp T
WHERE
  (D.pk1, D.pk2) = (T.pk1, T.pk2) AND
  (D.f1, D.f2, D.f3) IS DISTINCT FROM (T.f1, T.f2, T.f3); -- nu este necesar să actualizăm cele care se potrivesc

-- inserăm ce lipsește
INSERT INTO
  dst
SELECT
  T.*
FROM
  tmp T
LEFT JOIN
  dst D
    USING(pk1, pk2)
WHERE
  D IS NOT DISTINCT FROM NULL;

COMMIT;
3.2. Prelucrarea post-import
În același KLADeR, toate înregistrările modificate trebuie să fie supuse unei prelucrări suplimentare – normalizate, extrase cuvinte cheie, aduse la structuri necesare. Dar cum să afli – ce anume s-a modificat, fără a complica codul de sincronizare, ideal, fără a-l atinge deloc?
Dacă accesul la scriere în momentul sincronizării este rezervat doar procesului tău, poți folosi un trigger care să colecteze toate modificările pentru noi:
-- tabele țintă
CREATE TABLE kladr(...);
CREATE TABLE kladr_house(...);

-- tabele cu istoricul modificărilor
CREATE TABLE kladr$log(
  ro kladr, -- aici se află versiunile complete ale înregistrărilor vechi/noi
  rn kladr
);

CREATE TABLE kladr_house$log(
  ro kladr_house,
  rn kladr_house
);

-- funcție comună pentru logarea modificărilor
CREATE OR REPLACE FUNCTION diff$log() RETURNS trigger AS $$
DECLARE
  dst varchar = TG_TABLE_NAME || '$log';
  stmt text = '';
BEGIN
  -- verificăm necesitatea logării la actualizarea înregistrării
  IF TG_OP = 'UPDATE' THEN
    IF NEW IS NOT DISTINCT FROM OLD THEN
      RETURN NEW;
    END IF;
  END IF;
  -- creăm o înregistrare în log
  stmt = 'INSERT INTO ' || dst::text || '(ro,rn)VALUES(';
  CASE TG_OP
    WHEN 'INSERT' THEN
      EXECUTE stmt || 'NULL,$1)' USING NEW;
    WHEN 'UPDATE' THEN
      EXECUTE stmt || '$1,$2)' USING OLD, NEW;
    WHEN 'DELETE' THEN
      EXECUTE stmt || '$1,NULL)' USING OLD;
  END CASE;
  RETURN NEW;
END;
$$ LANGUAGE plpgsql;
Acum putem aplica (sau activa prin) triggerii înainte de sincronizare ALTER TABLE ... ENABLE TRIGGER ...):
CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();

CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr_house
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();
Apoi extragem cu ușurință toate modificările necesare din tabelele de log și le procesăm prin manipulatoare suplimentare.
3.3. Importarea seturilor de date asociate
Anterior, am discutat despre cazuri în care structurile de date ale sursei și destinației coincid. Dar ce trebuie să facem dacă exportul dintr-un sistem extern are un format diferit de structura noastră de stocare?
Să luăm ca exemplu stocarea clienților și a facturilor aferente, un caz tipic de 'mulți-la-unu':
CREATE TABLE client(
  client_id
    serial
      PRIMARY KEY
, inn
    varchar
      UNIQUE
, name
    varchar
);

CREATE TABLE invoice(
  invoice_id
    serial
      PRIMARY KEY
, client_id
    integer
      REFERENCES client(client_id)
, number
    varchar
, dt
    date
, sum
    numeric(32,2)
);
Iată că exportul din sursa externă ne vine sub forma 'totul într-unul':
CREATE TEMPORARY TABLE invoice_import(
  client_inn
    varchar
, client_name
    varchar
, invoice_number
    varchar
, invoice_dt
    date
, invoice_sum
    numeric(32,2)
);
Este clar că datele clienților pot fi duplicate în această variantă, iar înregistrarea principală este 'factura':
0123456789;Vasile;A-01;2020-03-16;1000.00
9876543210;Petre;A-02;2020-03-16;666.00
0123456789;Vasile;B-03;2020-03-16;9999.00
Pentru model, vom insera datele noastre de test, dar ținem minte — COPIE mai eficient!
INSERT INTO invoice_import
VALUES
  ('0123456789', 'Vasile', 'A-01', '2020-03-16', 1000.00)
, ('9876543210', 'Petre', 'A-02', '2020-03-16', 666.00)
, ('0123456789', 'Vasile', 'B-03', '2020-03-16', 9999.00);
Mai întâi, vom identifica 'categoriile' la care se referă 'faptele' noastre. În cazul nostru, facturile fac referire la clienți:
CREAȚI O TABELĂ TEMPORARĂ client_import AS
SELECT DISTINCT ON(client_inn)
-- se poate folosi simplu SELECT DISTINCT, dacă datele sunt în mod evident conforme
  client_inn inn
, client_name "name"
FROM
  invoice_import;
Pentru a corela corect facturile cu ID-urile clienților, trebuie mai întâi să aflam sau să generăm aceste identificatoare. Să adăugăm câmpuri pentru ele:
ALTER TABLE invoice_import ADD COLUMN client_id integer;
ALTER TABLE client_import ADD COLUMN client_id integer;
Vom folosi metoda descrisă mai sus pentru sincronizarea tabelelor cu o mică ajustare - nu vom actualiza și nu vom șterge nimic în tabela țintă, deoarece importul clienților este «append-only»:
-- stabilim în tabela de import ID-urile deja existente
UPDATE
  client_import T
SET
  client_id = D.client_id
FROM
  client D
WHERE
  T.inn = D.inn; -- cheie unică

-- inserăm înregistrările lipsă și stabilim ID-urile acestora
WITH ins AS (
  INSERT INTO client(
    inn
  , name
  )
  SELECT
    inn
  , name
  FROM
    client_import
  WHERE
    client_id IS NULL -- dacă ID-ul nu s-a stabilit
  RETURNING *
)
UPDATE
  client_import T
SET
  client_id = D.client_id
FROM
  ins D
WHERE
  T.inn = D.inn; -- cheie unică

-- stabilim ID-urile clienților pentru înregistrările facturilor
UPDATE
  invoice_import T
SET
  client_id = D.client_id
FROM
  client_import D
WHERE
  T.client_inn = D.inn; -- cheie aplicațională
De fapt, totul este în invoice_import acum avem câmpul de legătură umplut client_id, cu care vom insera factura.
Sursa: habr.com
