

Pe internet există multe resurse de referință, dar uneori cele mai valoroase sunt cele mai simple sfaturi. Echipa a tradus , pe care autorul articolului le-a adunat după un an de muncă cu Kubernetes. Sfaturile nu sunt ordonate după importanță, dar credem că fiecare va găsi ceva util pentru sine.
Cea mai simplă comandă în lucrul cu Kubernetes
Pentru început, probabil cea mai simplă și utilă acțiune în lucrul cu Kubernetes. Următoarea comandă activează completarea automată a comenzilor kubectl în shell-ul bash:
echo "source > ~/ .bashrc
Completarea automată kubectl va fi scrisă în fișierul .bashrc și va fi activată automat de fiecare dată când deschideți shell-ul. Aceasta accelerează introducerea comenzilor și parametrilor lungi, cum ar fi toate-nume. Mai multe detalii în .
Limitele implicite pentru memorie și CPU în spațiul de nume
Dacă aplicația este scrisă greșit, de exemplu, deschide o nouă conexiune la baza de date în fiecare secundă, dar niciodată nu o închide, atunci în cluster are loc o scurgere de memorie. Iar dacă pentru aplicație nu sunt setate limite de memorie la desfășurare, acest lucru poate duce la o cădere a nodului.
Pentru a preveni acest lucru, Kubernetes permite setarea limitelor implicite pentru fiecare spațiu de nume. Acestea sunt specificate în fișierul yaml pentru spațiul de nume respectiv. Iată un exemplu de fișier:
apiVersion: v1
kind: LimitRange
metadata:
  name: mem-limit-range
spec:
  limits:
  - default:
      memory: 512Mi
    defaultRequest:
      memory: 256Mi
    type: Container
Creează un astfel de yaml și aplică-l oricărui spațiu de nume. De exemplu, spațiul de nume limit-example. Acum, pentru orice container desfășurat în acest spațiu de nume, va exista o limită de 512Mi, dacă pentru acel container nu este setată o altă limită individuală.
Curățarea coloanelor deșeuri în versiunile vechi de Kubernetes
Kubelet începe în mod implicit curățarea coloanelor deșeuri atunci când var/lib/docker ocupă 90% din spațiul disc disponibil. Este minunat, totuși, până la versiunea Kubernetes 1.7 nu existau limite implicite pentru numărul descriptorilor de index inode utilizați (inodes), care corespunde numărului de fișiere din sistemul de fișiere.
Potrivit, containerul dvs. var/lib/docker poate utiliza doar 50% din spațiul pe disc, dar descriptorii inode se pot epuiza, ceea ce va provoca probleme în funcționarea muncitorilor.
În versiunile vechi de kubelet de la 1.4 la 1.6, va trebui să adăugați acest flag:
--eviction-hard
=memory.available<100Mi,nodefs.available<10%,nodefs.inodesFree<5%
În versiunile 1.7 și mai recente, acest flag este setat implicit. Totuși, versiunile anterioare nu monitorizează limita inodelor.
Minikube… mic, dar puternic Kubernetes local
Minikube este cea mai simplă modalitate de a rula un cluster Kubernetes local. Acesta se pornește cu o comandă simplă:
minikube start
Ca rezultat al executării acestei comenzi, pe computerul dvs. va funcționa un adevărat cluster Kubernetes.
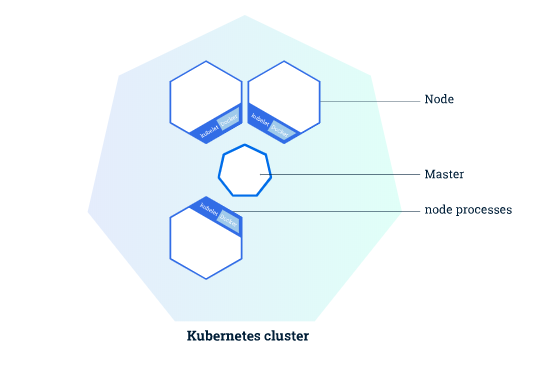
Trucul este modul în care să construiți aplicația și să o rulați local în acest cluster. Dacă nu dați instrucțiuni speciale, imaginea Docker se va construi pe computerul dvs., nu în cluster.
Pentru a face ca Docker să trimită imaginea în clusterul Kubernetes local, se dă următoarea comandă mașinii Docker:
eval $(minikube docker-env)
Acum putem construi aplicații pe clusterul Kubernetes local.
Nu oferiți acces kubectl la toată lumea
Pare evident, dar dacă mai multe echipe folosesc același cluster pentru aplicațiile lor (de aceea a fost creat Kubernetes), nu este recomandat să oferiți fără discriminare. kubectl. Este mai bine să împărțiți echipele, alocând fiecărei echipe propriul spațiu de nume și delimitând accesul prin politici RBAC.
Puteți să vă faceți griji asupra permisiunilor fiecărui pod pentru acces, citire, creare, ștergere și alte operațiuni. Dar cel mai important este să restricționați accesul la secrete, permițându-l doar administratorilor. Astfel, vom delimita pe cei care pot administra clusterul de cei care pot desfășura pur și simplu în el.
Gestionați bugetele podurilor
Cum să garantăm absența opririlor pentru aplicație în clusterul Kubernetes? PodDisruptionBudget și încă o dată PodDisruptionBudget.
Clusterele sunt actualizate periodic, iar nodurile sunt golite. Nimic nu stă pe loc, aceasta este realitatea. Fiecare desfășurare cu mai mult de o instanță ar trebui să includă întotdeauna PDB (PodDisruptionBudget). Acesta se creează într-un simplu fișier yaml, care este aplicat la cluster. Domeniul de aplicare al unui PDB specific este definit de selectorii de etichete.
Notă: Bugetul PDB se ia în considerare doar în cazul unei încălcări reversibile a bugetului (). În situații precum defectele hardware, PDB nu va funcționa.
Exemplu de PDB:
apiVersion: policy/v1beta1
kind: PodDisruptionBudget
metadata:
  name: app-a-pdb
spec:
  minAvailable: 2
  selector:
      matchLabels:
        app: app-a
Cele două parametrii principali sunt matchLabels și minAvailable. Primul parametru specifică pentru ce aplicații se aplică bugetul. De exemplu, dacă am deployment-uri cu etichete app: app-a și app: app-b, atunci acest PDB se va aplica doar primului.
Parametru minAvailable este luat în calcul la golirea (curățarea) nodului. De exemplu, în cazul nostru, în timpul golirii, toate instanțele app: app-a, cu excepția a două.
Aceasta permite controlul asupra câte instanțe ale aplicației ar trebui să fie executate în fiecare moment.
Monitorizarea stării aplicației
Această monitorizare este posibilă în două moduri: prin probele Readiness sau Liveness.
Prima probă (readiness) determină dacă containerul este pregătit pentru a primi trafic.
A doua (liveness) arată dacă containerul este funcțional sau trebuie reinicializat.
Configurările corespunzătoare sunt adăugate pur și simplu în yaml pentru desfășurare. Acolo pot fi specificate timeout-uri, timp de întârziere și numărul de repetiții ale probelor. Mai multe detalii despre acestea găsiți în .
Etichete peste tot
Etichetele sunt unul dintre conceptele fundamentale din Kubernetes. Ele permit obiectelor să se conecteze liber între ele, precum și să creeze solicitări pe baza etichetelor. În Kubernetes, este chiar posibil să accesați clientul și să observați evenimentele pe baza unor etichete specifice.
Folosing etichete, se poate face practic orice, dar un exemplu bun ar fi crearea mai multor medii pentru rularea programelor într-un singur cluster.
Să presupunem că folosiți același cluster pentru dev și qa. Aceasta înseamnă că aveți o aplicație app-a, care poate funcționa simultan în ambele medii qa și dev. În acest caz, putem apela în mod separat la instanța aplicației dintr-o anumită mediu, specificând parametrul corespunzător environment. De exemplu, app: app-a și environment: dev pentru un mediu, și app: app-a și environment: qa pentru al doilea.
Aceasta permite accesarea ambelor instanțe ale aplicației, de exemplu, pentru a efectua teste simultan.
Organizați-vă
Kubernetes este un sistem foarte puternic, dar orice sistem poate ajunge, în cele din urmă, să fie copleșit de un număr mare de procese. Kubelet rulează toate procesele și verificările specificate de voi, precum și pe ale sale.
Sigur, un serviciu lăsat necontrolat nu va încetini sistemul, iar Kubernetes este inițial proiectat pentru scalare. Dar dacă în loc de un singur serviciu apar milioane, kubelet-ul începe să se copleșească.
Dacă dintr-un anumit motiv ștergeți un deployment (container, imagine, orice altceva), asigurați-vă că a fost efectuată o curățare completă.
Întâlniți Go
Cel mai important sfat l-am păstrat pentru final. Învățați limbajul de programare Go.
Kubernetes este dezvoltat în Go, toate extensiile sunt scrise în Go și, mai mult, biblioteca client oficială client-go este susținută.
Este utilizată pentru lucruri diverse și interesante. De exemplu, pentru a extinde sistemul Kubernetes în modul dorit. Astfel, puteți folosi propriile programe pentru colectarea datelor, desfășurarea aplicațiilor sau simpla curățare a containerelor.
Să învățați limbajul de programare Go și să stăpâniți client-go este, probabil, cel mai important sfat pe care îl putem oferi utilizatorilor începători ai Kubernetes.
Ce altceva să citiți:
- .
- ?
- .
Sursa: habr.com
