

Unul dintre scenariile tipice în toate aplicațiile cu care suntem obișnuiți este căutarea de date după anumite criterii și afișarea acestora într-un format ușor de citit. De asemenea, pot exista funcții suplimentare pentru sortare, grupare și paginare. Sarcina este, în teorie, trivială, dar în procesul de implementare mulți dezvoltatori fac o serie de greșeli care afectează ulterior performanța. Să încercăm să discutăm diferitele opțiuni de soluționare a acestei probleme și să formulăm recomandări pentru alegerea celei mai eficiente implementări.
Opțiunea de paginare #1
Cea mai simplă varianta care vine în minte este afișarea rezultatelor căutării pagină cu pagină, în cea mai clasică formă a sa.
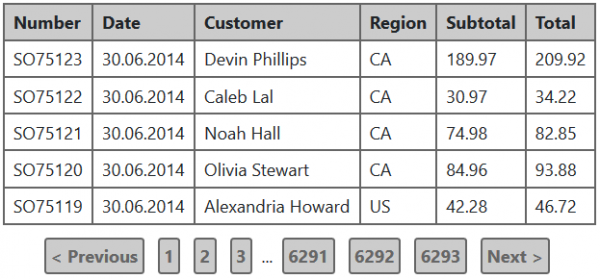
Să presupunem că în aplicație se folosește o bază de date relațională. În acest caz, pentru a afișa informațiile într-un astfel de format, va fi necesar să se execute două interogări SQL:
- Obține liniile pentru pagina curentă.
- Numără totalul liniilor care corespund criteriilor de căutare — acest lucru este necesar pentru a afișa paginile.
Să analizăm prima interogare folosind baza de date de test MS SQL pentru serverul 2016. În acest scop, vom folosi tabela Sales.SalesOrderHeader:
SELECT * FROM Sales.SalesOrderHeader
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Interogarea de mai sus va returna primele 50 de comenzi din listă, sortate în ordinea descrescătoare a datei adăugării, adică cele mai recente 50 de comenzi.
Aceasta se execută rapid pe baza de date de test, dar să vedem planul de execuție și statisticile de intrare-ieșire:
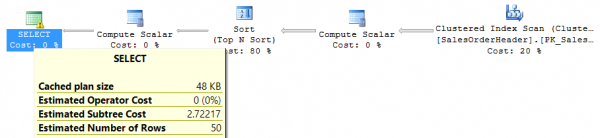
Tabel 'SalesOrderHeader'. Numărul de scanări 1, citiri logice 698, citiri fizice 0, citiri anticipate 0, citiri logice lob 0, citiri fizice lob 0, citiri anticipate lob 0.Pentru a obține statisticile de intrare/ieșire pentru fiecare interogare, poți executa în mediu de execuție comanda SET STATISTICS IO ON.
După cum se poate observa din planul de execuție, cea mai consumatoare de resurse este sortarea tuturor liniilor din tabelul original după data adăugării. Problema constă în faptul că, cu cât apar mai multe linii în tabel, cu atât sortarea devine mai 'greoaie'. În practică, se recomandă evitarea unor astfel de situații, așa că vom adăuga un index pe data adăugării și vom observa dacă s-a schimbat consumul de resurse:
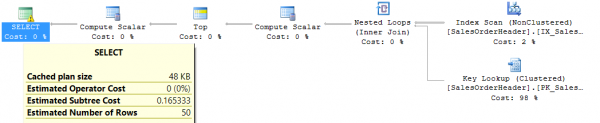
Tabel 'SalesOrderHeader'. Numărul de scanări 1, citiri logice 165, citiri fizice 0, citiri anticipate 5, citiri logice lob 0, citiri fizice lob 0, citiri anticipate lob 0.
Evident, a devenit mult mai bine. Dar au fost rezolvate toate problemele? Să schimbăm interogarea pentru a căuta comenzile unde valoarea totală a produselor depășește 100 de dolari:
SELECT * FROM Sales.SalesOrderHeader
WHERE SubTotal > 100
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
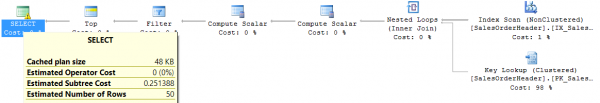
Tabela 'SalesOrderHeader'. Numărul de scanări 1, citiri logice 1081, citiri fizice 0, citiri anticipative 0, citiri logice lob 0, citiri fizice lob 0, citiri anticipative lob 0.Avem o situație amuzantă: planul interogării nu este cu mult mai bun decât cel anterior, dar numărul efectiv de citiri logice este aproape dublu comparativ cu scanarea completă a tabelei. Există o soluție - dacă din indexul existent facem unul compus și adăugăm ca al doilea câmp suma totală a produselor, vom obține din nou 165 de citiri logice:
CREATE INDEX IX_SalesOrderHeader_OrderDate_SubTotal on Sales.SalesOrderHeader(OrderDate, SubTotal);
Această serie de exemple poate fi continuată mult timp, dar cele două idei principale pe care vreau să le exprim aici sunt:
- Adăugarea oricărui nou criteriu sau ordine de sortare în interogare poate influența semnificativ viteza de execuție a acesteia.
- Dar dacă trebuie să extragem doar o parte din date, nu toate rezultatele care corespund criteriilor de căutare, există multe modalități de a optimiza o astfel de interogare.
Acum să trecem la a doua interogare menționată la început - cea care numără înregistrările care satisfac criteriul de căutare. Să luăm același exemplu - căutarea comenzilor care depășesc 100 de dolari:
SELECT COUNT(1) FROM Sales.SalesOrderHeader
WHERE SubTotal > 100
Având indexul compus menționat mai sus, obținem:
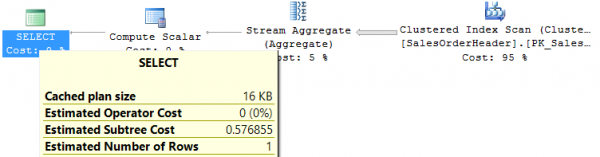
Tabel 'SalesOrderHeader'. Numărul de scanări 1, citiri logice 698, citiri fizice 0, citiri anticipate 0, citiri logice lob 0, citiri fizice lob 0, citiri anticipate lob 0.Faptul că interogarea parcurge întregul index nu este surprinzător, deoarece câmpul SubTotal nu este pe prima poziție, deci interogarea nu poate să-l folosească. Problema se rezolvă adăugând un alt index pe câmpul SubTotal, ceea ce rezultă în doar 48 de citiri logice.
Mai pot fi aduse câteva exemple de interogări pentru numărarea cantității, dar esența va rămâne aceeași: obținerea unei porții de date și numărarea totalului sunt două interogări fundamental diferite, și fiecare necesită măsuri specifice pentru optimizare. În general, nu se va reuși găsirea unei combinații de indecși care să funcționeze la fel de bine pentru ambele interogări.
Prin urmare, una dintre cerințele importante de clarificat în dezvoltarea unor astfel de soluții de căutare este dacă este cu adevărat important pentru afacere să vadă numărul total de obiecte găsite. De cele mai multe ori, răspunsul este nu. Iar navigarea după numerele specifice ale paginilor, din punctul meu de vedere, este o soluție cu un domeniu de aplicare foarte restrâns, deoarece majoritatea scenariilor cu paginarea arată ca „mergi la pagina următoare”.
Varianta de paginare #2
Să presupunem că utilizatorilor nu le pasă de numărul total de obiecte găsite. Să încercăm să simplificăm pagina de căutare:
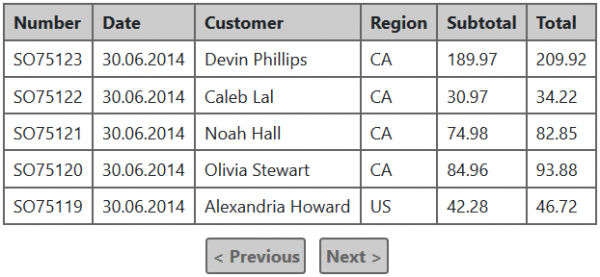
Practic, s-a schimbat doar faptul că nu mai există posibilitatea de a naviga după numerele specifice ale paginilor, iar acum această tabelă nu trebuie să știe câte vor fi în total. Însă apare întrebarea — cum va ști tabela dacă există date pentru pagina următoare (pentru a afișa corect linkul „Următorul”)?
Răspunsul este foarte simplu: se poate citi din baza de date cu o înregistrare mai mult decât este necesar pentru a fi afișată, iar prezenta acestei „înregistrări suplimentare” va arăta dacă există un nou set de date. Astfel, pentru a obține o pagină de date, va fi necesar să se efectueze doar o singură interogare, ceea ce îmbunătățește semnificativ performanța și facilitează întreținerea acestei funcționalități. În practică, am avut un caz în care renunțarea la numărarea totalului înregistrărilor a accelerat returnarea rezultatelor de 4-5 ori.
Pentru această abordare există mai multe opțiuni de interfață utilizator: comenzi „înapoi” și „înaintare”, ca în exemplul de mai sus, un buton „încarcă mai mult”, care adaugă pur și simplu un nou set de rezultate, „derulare infinită”, care funcționează pe principiul „încarcă mai mult”, dar semnalul pentru a obține următorul set de date este derularea utilizatorului până la capătul tuturor rezultatelor afișate. Indiferent de soluția vizuală, principiul de selecție a datelor rămâne același.
Nuante în implementarea paginării
În toate exemplele de interogări date mai sus, se folosește abordarea „offset + număr”, când în interogare se indică de la ce rând rezultat și câte rânduri trebuie returnate. Mai întâi, să vedem cum ar fi mai bine să organizăm transmiterea parametrilor în acest caz. În practică, am întâlnit mai multe metode:
- Numărul de ordine al paginii solicitate (pageIndex), dimensiunea paginii (pageSize).
- Numărul de ordine al primei înregistrări care trebuie returnată (startIndex), numărul maxim de înregistrări în rezultat (count).
- Numărul de ordine al primei înregistrări care trebuie returnată (startIndex), numărul de ordine al ultimei înregistrări care trebuie returnată (endIndex).
La prima vedere, poate părea atât de elementar încât nu există nicio diferență. Dar nu este așa — cea mai convenabilă și versatilă opțiune este a doua (startIndex, count). Există câteva motive pentru aceasta:
- Pentru abordarea cu citirea +1 înregistrare, menționată mai sus, prima opțiune cu pageIndex și pageSize este extrem de incomodă. De exemplu, dorim să afișăm 50 de înregistrări pe pagină. Conform algoritmului menționat anterior, trebuie să citim cu una mai mult decât este necesar. Dacă acest „+1” nu este luat în calcul pe server, se dovedește că pentru prima pagină trebuie să cerem înregistrările de la 1 la 51, pentru a doua — de la 51 la 101 etc. Dacă specificăm dimensiunea paginii 51 și creștem pageIndex, atunci a doua pagină va returna de la 52 la 102 etc. În consecință, în prima variantă, singurul mod de a implementa în mod normal butonul de trecere la pagina următoare este să luăm în considerare pe server citirea „în plus” a unei înregistrări, ceea ce va fi un detaliu foarte neclar.
- A treia variantă nu are sens deloc, deoarece pentru a efectua cereri în majoritatea bazelor de date, va trebui oricum să transmitem numărul, nu indexul ultimei înregistrări. Fie să scădem startIndex din endIndex o operație aritmetică simplă, dar ea este de prisos aici.
Acum ar trebui să descriem dezavantajele implementării paginării prin „offset + count”:
- Obținerea fiecărei următoare pagini va fi mai costisitoare și mai lentă decât cea anterioară, deoarece baza de date va trebui oricum să parcurgă toate înregistrările „de la început” conform criteriilor de căutare și sortare, după care să se oprească pe fragmentul dorit.
- Nu toate SGBD-urile pot susține această abordare.
Există alternative, dar nici acestea nu sunt ideale. Prima dintre aceste abordări se numește „keyset paging” sau „metoda de căutare” și constă în următoarele: după obținerea unei porții, putem reține valorile câmpurilor din ultima înregistrare de pe pagină și apoi să le folosim pentru a obține următoarea porție. De exemplu, am efectuat o astfel de cerere:
SELECT * FROM Sales.SalesOrderHeader
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
În ultima înregistrare am obținut valoarea datei comenzii '2014-06-29'. Așadar, pentru a obține pagina următoare, putem încerca să executăm următoarea interogare:
SELECT * FROM Sales.SalesOrderHeader
WHERE OrderDate < '2014-06-29'
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Problema este că OrderDate nu este un câmp unic, iar condiția specificată mai sus va omite cu o mare probabilitate multe rânduri necesare. Pentru a adăuga claritate acestei interogări, trebuie să adăugăm un câmp unic la condiție (să presupunem că 75074 este ultima valoare a cheii primare din prima porțiune):
SELECT * FROM Sales.SalesOrderHeader
WHERE (OrderDate = '2014-06-29' AND SalesOrderID < 75074)
   OR (OrderDate < '2014-06-29')
ORDER BY OrderDate DESC, SalesOrderID DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Această variantă va funcționa corect, dar în general va fi greu de optimizat, deoarece condiția conține operatorul OR. Dacă, pe măsură ce OrderDate crește, valorile cheii primare cresc, atunci condiția poate fi simplificată, păstrând doar filtrul pentru SalesOrderID. Însă, dacă între valorile cheii primare și câmpul după care este sortat rezultatul nu există o corelație strictă, în majoritatea SGBD-urilor nu va fi posibil să evităm acest OR. O excepție cunoscută este PostgreSQL, unde se susține pe deplin comparația tuplelor, iar condiția menționată mai sus poate fi scrisă ca „WHERE (OrderDate, SalesOrderID) < ('2014-06-29', 75074)”. Dacă există o cheie compusă cu aceste două câmpuri, astfel de interogări ar trebui să fie suficient de ușoare.
O a doua abordare alternativă poate fi întâlnită, de exemplu, în sau — când interogarea, pe lângă date, returnează un identificator special, cu ajutorul căruia se poate obține următoarea porțiune de date. Dacă acest identificator are o durată de viață nelimitată (așa cum este în Cosmos DB), atunci este o metodă excelentă de implementare a paginării cu tranziții secvențiale între pagini (varianta #2 menționată mai sus). Posibilele sale dezavantaje: nu este susținut în toate SGBD-urile; identificatorul obținut pentru următoarea porțiune poate avea o durată de viață limitată, ceea ce, în general, nu se potrivește pentru interacțiunea utilizatorului (precum, de exemplu, ElasticSearch scroll API).
Filtrare complexă
Să complicăm puțin lucrurile. Să presupunem că a apărut cerința de a implementa așa-numitul faceted search, foarte cunoscut din magazinele online. Exemplele anterioare bazate pe tabela comenzilor nu sunt foarte relevante în acest caz, așa că ne vom concentra pe tabela Product din baza de date AdventureWorks:
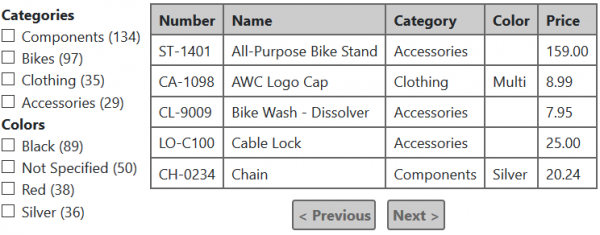
Care este ideea faceted search? Să arate pentru fiecare element de filtrare numărul de înregistrări care corespund acestui criteriu. ținând cont de filtrele selectate în toate celelalte categorii..
De exemplu, dacă vom alege în acest exemplu categoria Bikes și culoarea Black, tabela va afișa doar biciclete de culoare neagră, dar în același timp:
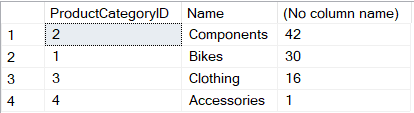
- Pentru fiecare criteriu din grupul „Categories” va fi arătat numărul de produse din această categorie de culoare neagră.
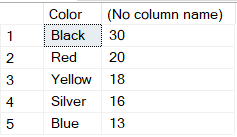
- Pentru fiecare criteriu din grupul „Colors” va fi arătat numărul de biciclete de această culoare.
Iată un exemplu de ieșire a rezultatului pentru astfel de condiții:
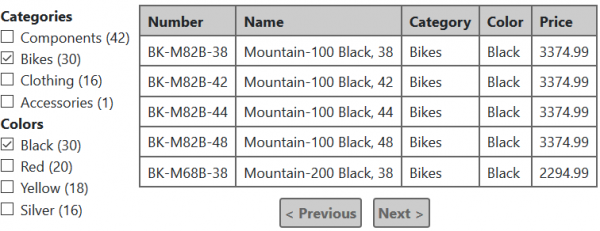
Dacă, în plus, vom marca categoria „Clothing”, tabela va arăta și îmbrăcăminte de culoare neagră disponibilă. Numărul de produse de culoare neagră din secțiunea „Color” va fi, de asemenea, recalculat conform noilor condiții, însă în secțiunea „Categories” nu se va schimba nimic... Sper că aceste exemple sunt suficiente pentru a înțelege algoritmul familiar al funcționării faceted search.
Acum să ne imaginăm cum ar putea fi implementat acest lucru într-o bază de date relațională. Fiecare grup de criterii, cum ar fi Category și Color, va necesita o interogare separată:
SELECT pc.ProductCategoryID, pc.Name, COUNT(1) FROM Production.Product p
  INNER JOIN Production.ProductSubcategory ps ON p.ProductSubcategoryID = ps.ProductSubcategoryID
  INNER JOIN Production.ProductCategory pc ON ps.ProductCategoryID = pc.ProductCategoryID
WHERE p.Color = 'Black'
GROUP BY pc.ProductCategoryID, pc.Name
ORDER BY COUNT(1) DESC
SELECT Color, COUNT(1) FROM Production.Product p
  INNER JOIN Production.ProductSubcategory ps ON p.ProductSubcategoryID = ps.ProductSubcategoryID
WHERE ps.ProductCategoryID = 1 --Bikes
GROUP BY Color
ORDER BY COUNT(1) DESC
Ce este în neregulă cu această soluție? Foarte simplu — aceasta nu se scalabilizează bine. Fiecare secțiune de filtrare necesită o interogare separată pentru a număra cantitățile și aceste interogări nu sunt cele mai ușoare. În magazinele online, în unele categorii, pot fi și câteva zeci de secțiuni de filtrare, ceea ce poate reprezenta o problemă serioasă pentru performanță.
De obicei, după aceste afirmații, mi se oferă anumite soluții, și anume:
- Combinați toate numărătoarele într-o singură interogare. Tehnic este posibil prin utilizarea cuvântului cheie UNION, totuși, acest lucru nu va ajuta semnificativ la performanță — baza de date va trebui să execute „de la zero” fiecare dintre fragmente.
- Cache-ați numărătorile. Aceasta mi se sugerează practic de fiecare dată când descriu problema. Nuanta este că, în general, acest lucru este imposibil. Să presupunem că avem 10 „fațete”, fiecare cu 5 valori. Aceasta este o situație foarte „modestă” în comparație cu ceea ce se poate observa în magazinele online. Selectarea unui element de fațetă influențează numărătoarele în celelalte 9, cu alte cuvinte, pentru fiecare combinație de criterii, numărătoarele pot fi diferite. În total, în exemplul nostru, sunt 50 de criterii pe care utilizatorul le poate selecta, așadar, vor exista 250 de combinații posibile. Complectarea unei astfel de matrice de date nu va fi suportată de nici o memorie sau timp. Aici se poate obiecta și spune că nu toate combinațiile sunt reale și utilizatorul rareori va selecta mai mult de 5-10 criterii. Da, se poate face o încărcare leneșă și cache-a numărătoarele doar pentru cei care au fost selectați vreodată, dar cu cât vor fi mai multe opțiuni de selectat, cu atât mai puțin eficient va fi acest cache și cu atât mai vizibile vor fi problemele de timp de răspuns (mai ales dacă setul de date se schimbă regulat).
Din fericire, o astfel de sarcină are deja de mult timp soluții destul de eficiente, previzibile în gestionarea unor volume mari de date. Pentru oricare dintre aceste opțiuni, are sens să separați recalcularea fațetelor și obținerea paginii de rezultate în două apeluri paralele către server și să organizați interfața utilizatorului astfel încât încărcarea datelor pe fațete să „nu interfereze” cu afișarea rezultatelor căutării.
- Chem mai rar să recalculați „facetele”. De exemplu, nu recalculați totul la fiecare modificare a criteriilor de căutare, ci, în schimb, găsiți numărul total de rezultate care se potrivesc condițiilor actuale și oferiți utilizatorului opțiunea de a le afișa — „1425 de înregistrări găsite, doriți să le afișați?” Utilizatorul poate continua să schimbe condițiile de căutare sau poate apăsa butonul „afișați”. Doar în acest caz se vor executa toate solicitările pentru a obține rezultatele și pentru a recalcula cantitățile de pe toate „facetele”. Este evident că va trebui să gestionați solicitarea de obținere a numărului total de rezultate și optimizarea acesteia. Această metodă poate fi întâlnită în multe magazine online mici. Este clar că nu este o soluție universală, dar în cazuri simple poate fi un compromis bun.
- Folosiți motoare de căutare pentru a găsi rezultate și a calcula facetele, cum ar fi Solr, ElasticSearch, Sphinx și altele. Toate acestea sunt configurate pentru a construi „facete” și fac acest lucru destul de eficient, datorită indexului invers. Cum funcționează motoarele de căutare, de ce sunt mai eficiente în aceste cazuri decât bazele de date de utilizare generală, ce practici și capcane există — aceasta este o temă pentru un articol aparte. Aici vreau să subliniez că motorul de căutare nu poate înlocui depozitul principal de date, ci este folosit ca un supliment: orice modificări în baza principală, care sunt relevante pentru căutare, sunt sincronizate în indexul de căutare; mecanismul de căutare interacționează de obicei doar cu motorul de căutare și nu se referă la baza principală. Unul dintre cele mai importante aspecte aici este cum să organizați această sincronizare într-un mod fiabil. Totul depinde de cerințele pentru „timpul de reacție”. Dacă timpul dintre modificarea din baza principală și „apariția” acesteia în căutare nu este critic, se poate crea un serviciu care caută înregistrările recent modificate și le indexează o dată la câteva minute. Dacă este necesar un timp de reacție cât mai mic posibil, se poate implementa ceva de genul pentru a trimite actualizări către serviciul de căutare.
Conclusions
- Implementarea paginării pe partea serverului este o complexitate serioasă, și are sens să o aplici doar pentru seturi de date în creștere rapidă sau pur și simplu mari. Cum să evaluezi "mare" sau "în creștere rapidă" — nu există o rețetă absolut precisă, dar aș adopta următoarea abordare:
- Dacă obținerea întregii colecții de date, ținând cont de timpul serverului și de transmiterea prin rețea, se încadrează normal în cerințele de performanță — nu are sens să implementezi paginarea pe partea serverului.
- Poate fi o situație în care, pentru următoarea perioadă, nu se preconizează probleme de performanță, deoarece sunt puține date, dar colecția de date crește constant. Dacă un anumit set de date ar putea înceta în viitor să satisfacă punctul anterior — este mai bine să planifici paginarea de la început.
- Dacă din partea afacerii nu există o cerință strictă pentru a afișa numărul total de rezultate sau pentru a afișa numerele paginilor, iar în sistemul tău nu există un motor de căutare — mai bine să nu implementezi aceste aspecte și să consideri varianta #2.
- Dacă există o cerință clară pentru căutarea faceted, ai două opțiuni pentru a nu sacrifica performanța:
- Să nu recalculezi toate cantitățile la fiecare modificare a criteriilor de căutare.
- Să folosești motoare de căutare precum Solr, ElasticSearch, Sphinx și altele. Dar trebuie să înțelegi că acestea nu pot înlocui baza de date principală și ar trebui utilizate ca un supliment la stocarea principală pentru a rezolva problemele de căutare.
- De asemenea, în cazul căutării faceted, are sens să separi obținerea paginii de rezultate ale căutării și numărarea cantităților în două cereri paralele. Numărarea cantităților poate dura mai mult decât obținerea rezultatelor, în timp ce rezultatele sunt mai importante pentru utilizator.
- Dacă folosești o bază de date SQL pentru căutare, orice modificare a codului referitoare la această parte trebuie să fie testată bine în ceea ce privește performanța pe un volum de date corespunzător (care depășește volumul din baza "vie"). De asemenea, este de dorit să folosești monitorizarea timpului de execuție a cererilor pe toate instanțele bazei, și în special — pe cea "viu". Chiar dacă în etapa de dezvoltare planurile cererilor erau bune, pe măsură ce volumul de date crește, situația se poate schimba semnificativ.
Sursa: habr.com
