

Întrebarea clasică cu care un dezvoltator se adresează DBA-ului său sau proprietarului de afaceri – consultantului PostgreSQL, aproape întotdeauna sună la fel: „De ce interogările durează atât de mult?”
Setul tradițional de cauze:
- algoritm ineficient
când ai decis să faci JOIN între mai multe CTE cu câteva zeci de mii de înregistrări - statistici neactualizate
dacă distribuția efectivă a datelor în tabel deja diferă semnificativ de cea colectată la ultima ANALYZE - întreruperi de resurse
și deja nu mai sunt suficiente puteri de calcul CPU alocate, se consumă constant gigaocteți de memorie sau discul nu face față tuturor „vulnerabilităților” Bazei de date - blocaje de la procese concurente
Și dacă blocajele sunt destul de complicate de prins și analizat, pentru tot restul, avem nevoie doar de planul interogării, care poate fi obținut cu ajutorul (cel mai bine este, desigur, să folosești direct EXPLAIN (ANALYZE, BUFFERS) …) sau .
Dar, așa cum se menționează în aceeași documentație,
„Înțelegerea planului este o artă, și pentru a o stăpâni, este nevoie de o anumită experiență, …”
Dar te poți descurca și fără el, dacă folosești un instrument potrivit!
Cum arată, de obicei, un plan de interogare? Cam așa:
Scanare de index folosind pg_class_relname_nsp_index pe pg_class (timp efectiv=0.049..0.050 rânduri=1 bucle=1)
  Condiție Index: (relname = $1)
  Filtru: (oid = $0)
  Buffere: hit-uri partajate=4
  Plan de inițializare 1 (returnează $0,$1)
    ->  Limită (timp efectiv=0.019..0.020 rânduri=1 bucle=1)
          Buffere: hit-uri partajate=1
          ->  Scanare secvențială pe pg_class pg_class_1 (timp efectiv=0.015..0.015 rânduri=1 bucle=1)
                Filtru: (relkind = 'r'::"char")
                Rânduri eliminate de Filtru: 5
                Buffere: hit-uri partajate=1
sau așa:
"Append  (cost=868.60..878.95 rânduri=2 lățime=233) (timp efectiv=0.024..0.144 rânduri=2 bucle=1)"
"  Buffere: hit-uri partajate=3"
"  CTE cl"
"    ->  Scanare secvențială pe pg_class  (cost=0.00..868.60 rânduri=9972 lățime=537) (timp efectiv=0.016..0.042 rânduri=101 bucle=1)"
"          Buffere: hit-uri partajate=3"
"  ->  Limită  (cost=0.00..0.10 rânduri=1 lățime=233) (timp efectiv=0.023..0.024 rânduri=1 bucle=1)"
"        Buffere: hit-uri partajate=1"
"        ->  Scanare CTE pe cl  (cost=0.00..997.20 rânduri=9972 lățime=233) (timp efectiv=0.021..0.021 rânduri=1 bucle=1)"
"              Buffere: hit-uri partajate=1"
"  ->  Limită  (cost=10.00..10.10 rânduri=1 lățime=233) (timp efectiv=0.117..0.118 rânduri=1 bucle=1)"
"        Buffere: hit-uri partajate=2"
"        ->  Scanare CTE pe cl cl_1  (cost=0.00..997.20 rânduri=9972 lățime=233) (timp efectiv=0.001..0.104 rânduri=101 bucle=1)"
"              Buffere: hit-uri partajate=2"
"Timp de planificare: 0.634 ms"
"Timp de execuție: 0.248 ms"
Dar citirea planului ca text „de pe hârtie” este foarte dificilă și neclară:
- în nod apare suma resurselor subarborelui
adică, pentru a înțelege cât timp a fost necesar pentru a executa un anumit nod sau cât de mult a adus această citire din tabel date de pe disc, trebuie cumva să scădem unul din celălalt - timpul nodului este necesar a înmulți cu loops
da, scăderea nu este cea mai complicată operațiune pe care trebuie să o facem „în minte” — deoarece timpul de executare este indicat ca medie pentru o execuție a nodului, iar acestea pot fi sute - ei bine, și toate acestea împreună împiedică răspunsul la întrebarea principală — așadar, cine „slăbiciunea cea mai mare”?
Când am încercat să explicăm toate acestea câtorva sute dintre dezvoltatorii noștri, am realizat că din exterior arată cam așa:
Așadar, ne trebuie...
Instrument
În acesta am încercat să adunăm toate mecanismele cheie care ajută, conform planului și cererii, să înțelegem „cine e de vină și ce trebuie făcut”. De asemenea, am dorit să împărtășim o parte din experiența noastră cu comunitatea.
Întâmpinați și folosiți —
Claritatea planurilor
Este ușor să înțelegi planul când arată așa?
Seq Scan on pg_class (actual time=0.009..1.304 rows=6609 loops=1)
  Buffers: shared hit=263
Planning Time: 0.108 ms
Execution Time: 1.800 ms
Nu prea.
Dar așa, într-o formă comprimată, când indicatorii cheie sunt separați — devine mult mai clar:
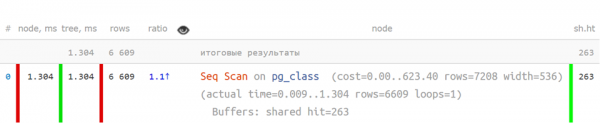
Dar dacă planul este mai complex — la ajutor vine diagramă pie chart a distribuției timpului pe noduri:
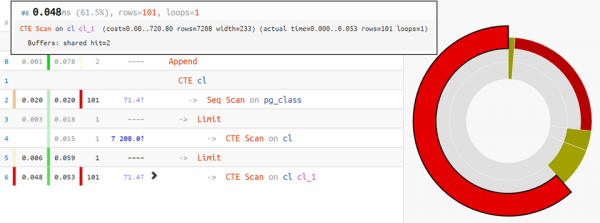
Ei bine, pentru cele mai complexe variante, ajută diagrama de execuție:
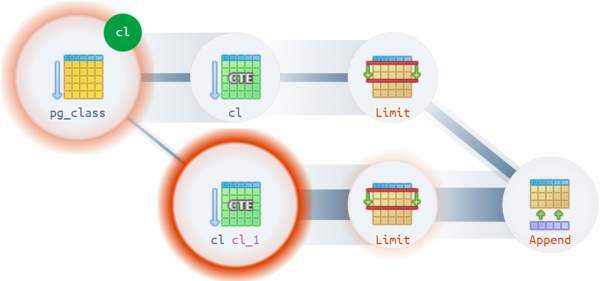
De exemplu, pot exista situații destul de neobișnuite când planul poate avea mai mult de o rădăcină efectivă:
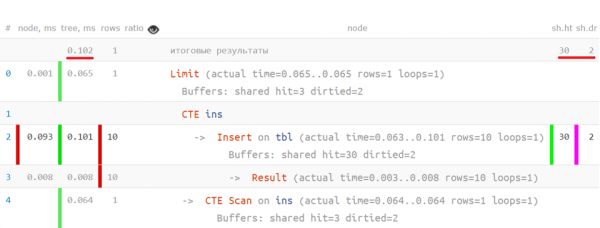
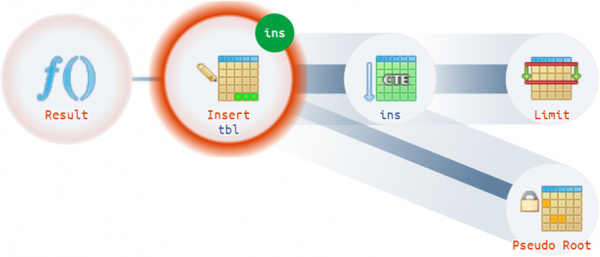
Sugestii structurale
Ei bine, dacă întreaga structură a planului și punctele sale slabe sunt deja desfășurate și vizibile — de ce să nu le evidențiem dezvoltatorului și să nu explicăm „în limbaj simplu”?
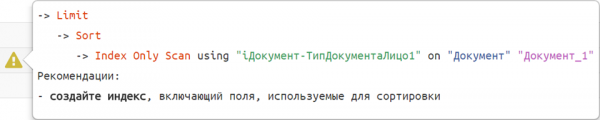 Am adunat deja câteva zeci de astfel de modele de recomandări.
Profiler de interogare pe linie
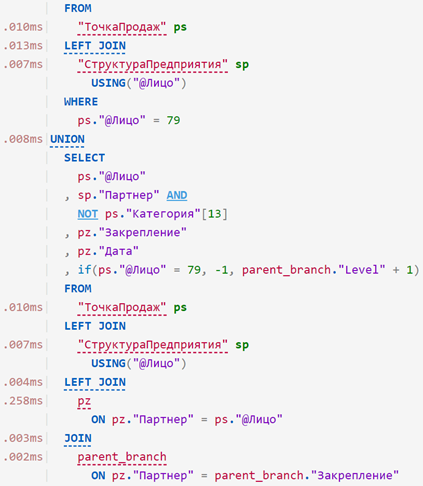
Acum, dacă suprapuneți interogarea de analizat pe planul original, puteți vedea cât timp a fost necesar pentru fiecare operator în parte — cam așa:
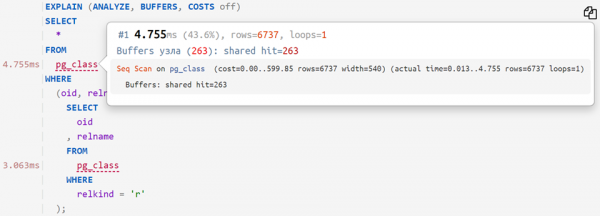
… sau chiar așa:
Înlocuirea parametrilor în interogare
Dacă ați „atașat” planului nu doar interogarea, ci și parametrii săi din linia DETAIL a jurnalului, atunci veți putea să-l copiați în plus în una din variante:
- cu înlocuirea valorilor în interogare
pentru executarea directă pe baza dumneavoastră și profilarea ulterioarăSELECT 'const', 'param'::text; - cu înlocuirea valorilor prin PREPARE/EXECUTE
pentru a emula funcționarea planificatorului, când partea parametrizată poate fi ignorată — de exemplu, atunci când lucrați cu tabele secționateDEALLOCATE ALL; PREPARE q(text) AS SELECT 'const', $1::text; EXECUTE q('param'::text);
Arhiva planurilor
Introduceți, analizați, împărtășiți cu colegii! Planurile vor rămâne în arhivă și veți putea reveni la ele mai târziu:
Dar dacă nu doriți ca planul dumneavoastră să fie văzut de alții, nu uitați să bifați opțiunea „nu publica în arhivă”.
În articolele următoare voi vorbi despre dificultățile și soluțiile care apar în analiza planului.
Sursa: habr.com
