

Cu câteva luni în urmă — un serviciu pentru PostgreSQL.
În tot acest timp, l-ați folosit deja de peste 6000 de ori, dar una dintre funcțiile convenabile ar fi putut rămâne neobservată — aceasta este sugestiile structurale, care arată cam așa:
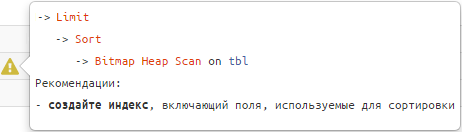
Ascultați-le, și cererile dumneavoastră „vor deveni netede și mătăsoase”. 🙂
Serios, multe dintre situațiile care fac o cerere lentă și „grea” din punct de vedere al resurselor sunt tipice și pot fi recunoscute după structură și datele planului.
În acest caz, fiecare dezvoltator în parte nu va trebui să caute opțiunea de optimizare singur, bazându-se exclusiv pe experiența sa — putem să-i sugerăm ce se întâmplă aici, care ar putea fi cauza și cum poate aborda soluția. Asta am și făcut.
Să ne uităm mai în detaliu la aceste cazuri — cum sunt ele definite și la ce recomandări conduc.
Pentru a înțelege mai bine subiectul, mai întâi puteți asculta secțiunea corespunzătoare din , și apoi să treceți la analiza detaliată a fiecărui exemplu:
#1: индексная «недосортировка»
Când apare
Afișați ultima factură pentru clientul „SRL Clopoțel”.
Cum să recunoști
-> Limit
   -> Sort
      -> Index [Numai] Scan [Inapoi] | Bitmap Heap Scan
Recomandări
Index utilizat extindeți cu câmpurile de sortare.
Exemplu:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "fapte"
, (random() * 1000)::integer fk_cli; -- 1K chei externe diferite

CREATE INDEX ON tbl(fk_cli); -- index pentru foreign key

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 1 -- selecție pe baza unei relații specifice
ORDER BY
  pk DESC -- vrem doar o „ultimă” înregistrare
LIMIT 1; 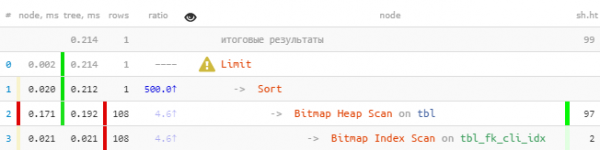
Se poate observa imediat că, folosind indexul, au fost citite mai mult de 100 de înregistrări, care apoi au fost toate sortate, iar apoi a fost lăsată doar una.
Corectăm:
DROP INDEX tbl_fk_cli_idx;
CREATE INDEX ON tbl(fk_cli, pk DESC); -- am adăugat o cheie de sortare
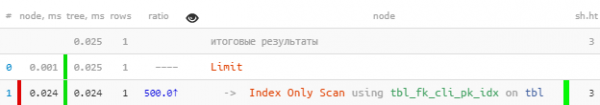
Chiar și pentru o selecție atât de primitivă — de 8.5 ori mai rapidă și cu 33 de citiri mai puțin.Efectul va fi cu atât mai vizibil cu cât aveți mai multe „fapte” pentru fiecare valoare fk.
Observ că un astfel de index va funcționa ca „prefixat” la fel de bine și pentru alte cereri în care fk, unde nu a existat și nu există sortări după pk nu a fost și nu este (mai multe detalii despre acest subiect pot fi citite ). De asemenea, va asigura și un sprijin normal pentru menținerea corectă a foreign key pe acest câmp.
#2: пересечение индексов (BitmapAnd)
Când apare
Afișați toate contractele pentru clientul „SRL Clopoțel”, încheiate în numele „NAO Floricica”.
Cum să recunoști
-> BitmapAnd
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Recomandări
Creare index compus pe câmpurile din ambele surse sau pentru a extinde unul dintre câmpurile existente cu câmpuri din a doua sursă.
Exemplu:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "fapte"
, (random() *  100)::integer fk_org  -- 100 chei externe diferite
, (random() * 1000)::integer fk_cli; -- 1K chei externe diferite

CREATE INDEX ON tbl(fk_org); -- index pentru cheia externă
CREATE INDEX ON tbl(fk_cli); -- index pentru cheia externă

SELECT
  *
FROM
  tbl
WHERE
(fk_org, fk_cli) = (1, 999); -- filtrare după o pereche specifică 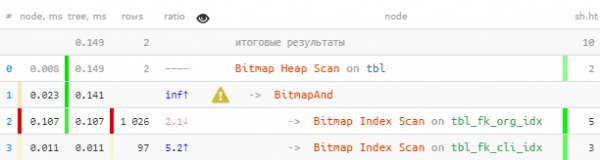
Corectăm:
DROP INDEX tbl_fk_org_idx;
CREATE INDEX ON tbl(fk_org, fk_cli);
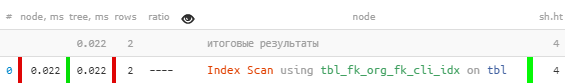
Aici câștigul este mai mic, deoarece Bitmap Heap Scan este destul de eficient de la sine. Totuși de 7 ori mai rapid și cu 2,5 ori mai puține citiri.
#3: объединение индексов (BitmapOr)
Când apare
Afișați primele 20 de cereri "proprii" sau nespecificate pentru procesare, cu cele proprii având prioritate.
Cum să recunoști
-> BitmapOr
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Recomandări
Utilizați UNION [ALL] pentru a combina subinterogările pentru fiecare bloc OR al condițiilor.
Exemplu:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "fapte"
, CASE
    WHEN random() < 1::real/16 THEN NULL -- cu o probabilitate de 1:16 înregistrarea este "egalitate"
    ELSE (random() * 100)::integer -- 100 chei externe diferite
  END fk_own;

CREATE INDEX ON tbl(fk_own, pk); -- index cu o sortare "aproape potrivită"

SELECT
  *
FROM
  tbl
WHERE
  fk_own = 1 OR -- proprii
  fk_own IS NULL -- ... sau "egalități"
ORDER BY
  pk
, (fk_own = 1) DESC -- întâi "propriile"
LIMIT 20;
Corectăm:
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own = 1 -- întâi "proprii" 20
  ORDER BY
    pk
  LIMIT 20
)
UNION ALL
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own IS NULL -- apoi "egalități" 20
  ORDER BY
    pk
  LIMIT 20
)
LIMIT 20; -- dar în total - 20, mai mult nu este necesar 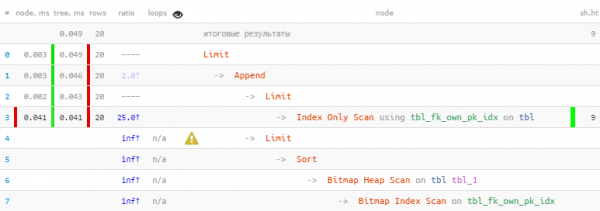
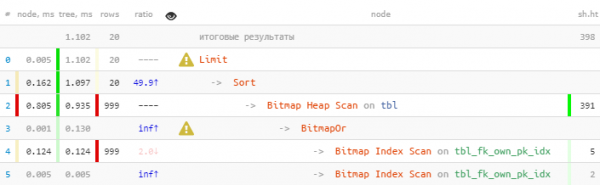
Am profitat de faptul că toate cele 20 de înregistrări necesare au fost obținute imediat în primul bloc, astfel că al doilea, cu un Bitmap Heap Scan mai "scump", nu a fost nici măcar executat — în cele din urmă de 22 de ori mai rapid, cu 44 de ori mai puține citiri!
O poveste mai detaliată despre această metodă de optimizare pe exemple concrete puteți citi în articolele și .
O variantă generalizată de selecție ordonată pe mai multe chei (nu doar pe perechea const/NULL) este discutată în articol .
#4: читаем много лишнего
Când apare
De obicei, apare atunci când există dorința de a "atașa încă un filtru" la interogarea existentă.
"Dar nu aveți ceva asemănător, dar cu nasturi din perlă?» filmul "Mâna de diamant"
De exemplu, modificând sarcina de mai sus, să afișăm primele 20 de cereri "critice" pentru procesare, indiferent de gradul lor de atribuire.
Cum să recunoști
-> Seq Scan | Bitmap Heap Scan | Index [Doar] Scan [Înapoi]
   && 5 × rows < RRbF -- filtrate >80% din citiri
   && loops × RRbF > 100 -- și în același timp mai mult de 100 de înregistrări în total
Recomandări
Creează [mai] specializat index cu condiția WHERE sau să includeți în index câmpuri suplimentare.
Dacă condiția de filtrare este „statică” pentru sarcinile dumneavoastră — adică nu presupune o extindere a listei de valori în viitor — este mai bine să folosiți un index WHERE. În această categorie se încadrează bine diferitele statuturi boolean/enum.
Dacă însă condiția de filtrare poate accepta valori diferite, este mai bine să extindeți indexul cu aceste câmpuri — așa cum este situația cu BitmapAnd de mai sus.
Exemplu:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk -- 100K "fapte"
, CASE
    WHEN random() < 1::real/16 THEN NULL
    ELSE (random() * 100)::integer -- 100 chei externe diferite
  END fk_own
, (random() < 1::real/50) critical; -- 1:50, că cererea este "critic"

CREATE INDEX ON tbl(pk);
CREATE INDEX ON tbl(fk_own, pk);

SELECT
  *
FROM
  tbl
WHERE
  critical
ORDER BY
  pk
LIMIT 20; 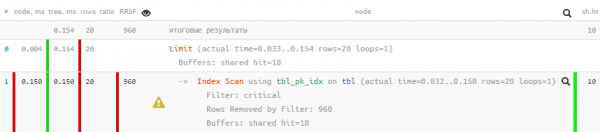
Corectăm:
CREATE INDEX ON tbl(pk)
  WHERE critical; -- am adăugat o „condiție statică” de filtrare
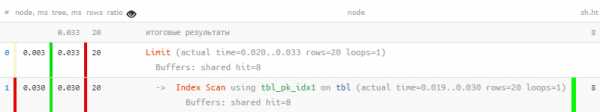
Așa cum vedem, filtrarea din plan a dispărut complet, iar interogarea a devenit de 5 ori mai rapidă.
#5: разреженная таблица
Când apare
Diferite încercări de a crea propriul sistem de procesare a sarcinilor, când un număr mare de actualizări/ștergeri de înregistrări în tabel duc la o situație cu un număr mare de „înregistrări moarte”.
Cum să recunoști
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && loops × (rows + RRbF)  64
Recomandări
A efectua regulat manual VACUUM [FULL] sau a obține o execuție adecvat de frecventă prin ajustarea fină a parametrilor săi, inclusiv .
În cele mai multe cazuri, astfel de probleme sunt cauzate de o compunere slabă a interogărilor în apeluri din logica de afaceri, cum ar fi cele discutate în .
Dar trebuie să înțelegem că chiar și VACUUM FULL nu poate ajuta întotdeauna. Pentru astfel de cazuri, merită să consultați algoritmul din articolul .
#6: чтение с «середины» индекса
Când apare
Se pare că am citit puțin, totul a fost pe index, și nu am filtrat nimic în plus — dar totuși s-a citit substanțial mai multe pagini decât ne-am fi dorit.
Cum să recunoști
-> Index [Only] Scan [Backward]
   && loops × (rows + RRbF)  64
Recomandări
A privi cu atenție structura indexului utilizat și câmpurile cheie specificate în interogare — cel mai probabil, o parte a indexului nu este specificată. Cel mai probabil, va trebui să creați un index similar, dar fără câmpuri prefixate sau .
Exemplu:
CREAȚI TABELA tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "fapte"
, (random() *  100)::integer fk_org  -- 100 chei externe diferite
, (random() * 1000)::integer fk_cli; -- 1K chei externe diferite

CREAȚI INDEX PE tbl(fk_org, fk_cli); -- totul aproape ca în #2
-- doar că am considerat indexul separat pe fk_cli ca fiind inutil și l-am eliminat

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 999 -- dar fk_org nu este specificat, deși este în index mai devreme
LIMIT 20; 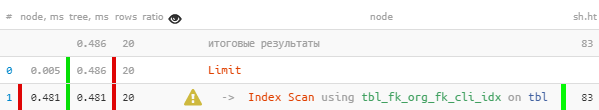
Totul pare în regulă, chiar și pe index, dar este oarecum suspect — pentru fiecare dintre cele 20 de înregistrări citite a fost necesar să se citească 4 pagini de date, 32KB pe înregistrare — nu este prea mult? Și numele indexului tbl_fk_org_fk_cli_idx provocă la reflecție.
Corectăm:
CREAȚI INDEX PE tbl(fk_cli); 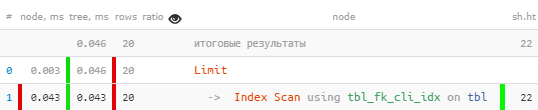
Dintr-o dată — de 10 ori mai repede și cu 4 ori mai puțin de citit!
Alte exemple de utilizare ineficientă a indexurilor pot fi observate în articolul .
#7: CTE × CTE
Când apare
În interogare am introdus „heavy” CTE din diferite tabele, iar apoi am decis să facem între ele JOIN.
Cazul este relevant pentru versiunile anterioare v12 sau interogări cu WITH MATERIALIZED.
Cum să recunoști
-> CTE Scan
   && loops > 10
   && loops × (rows + RRbF) > 10000
      -- produs cartezian prea mare CTE
Recomandări
Analizați cu atenție interogarea — și ? Если все-таки да, то aplicați „dictionarul” în hstore/json după modelul descris în .
#8: swap на диск (temp written)
Când apare
Prelucrarea (sortarea sau unificarea) unui număr mare de înregistrări nu încap în memoria dedicată pentru aceasta.
Cum să recunoști
-> *
   && temp written > 0
Recomandări
Dacă cantitatea de memorie utilizată de operație nu depășește semnificativ valoarea setată a parametrului , este bine să o corectăm. Poate fi setată imediat în configurare pentru toți, sau prin SET [LOCAL] pentru o interogare/transacție specifică.
Exemplu:
AFIȘAȚI work_mem;
-- "16MB"

SELECT
  random()
FROM
  generate_series(1, 1000000)
ORDER BY
1; 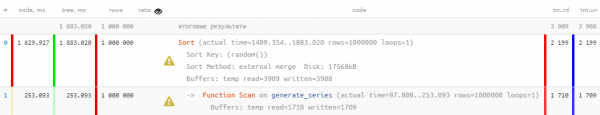
Corectăm:
SET work_mem = '128MB'; -- înainte de a executa interogarea 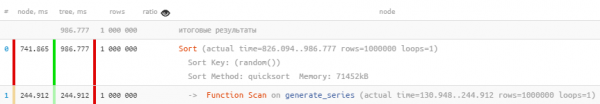
Din motive evidente, dacă se folosește doar memorie, nu și disc, interogarea va fi executată mult mai repede. În același timp, o parte din sarcina de pe HDD este eliminată.
Dar trebuie să înțelegem că nu putem aloca multă memorie, pentru că pur și simplu nu va fi suficientă pentru toți.
#9: неактуальная статистика
Când apare
Baza de date a fost umplută imediat cu multe, dar nu am avut timp să o procesăm cu ANALIZEAZĂ.
Cum să recunoști
-> Scanare secvențială | Scanare tampon Heap | Index [Doar] Scanare [Înapoi]
   && raport >> 10
Recomandări
Asta trebuie făcut ANALIZEAZĂ.
Această situație este detaliată în .
#10: «что-то пошло не так»
Când apare
A avut loc o așteptare pentru o blockage impusă de o interogare concurentă sau nu au fost suficiente resurse hardware CPU/hypervisor.
Cum să recunoști
-> *
   && (hit partajat / 8K) + (citire partajată / 1K)  100ms -- s-au citit puțin, dar foarte lent
Recomandări
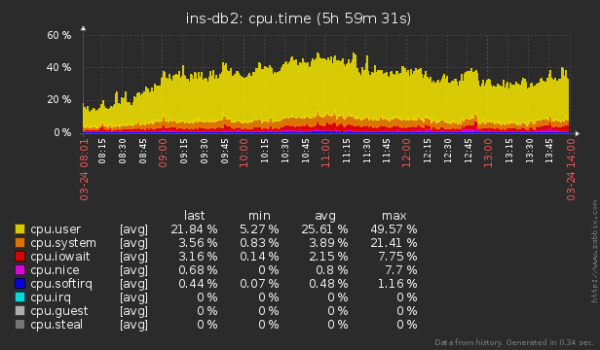
Utilizați un extern sistem pentru monitorizarea serverelor pentru a verifica existența blocajelor sau consumului neobișnuit de resurse. Despre varianta noastră de organizare a acestui proces pentru sute de servere am povestit deja și .
Sursa: habr.com
