

Mulți se confruntă cu Elasticsearch. Dar ce se întâmplă când vrei să stochezi jurnale "într-un volum foarte mare" cu ajutorul său? Și cum să supraviețuiești fără durere într-o situație de eșec a unuia dintre cele câteva centre de date? Ce arhitectură ar trebui să construiești și pe ce capcane poți da peste?
Noi, la Odnoklassniki, am decis să abordăm problema gestionării jurnalelelor cu ajutorul Elasticsearch și acum împărtășim cu Habr experiența noastră: atât despre arhitectură, cât și despre capcane.
Sunt Petru Zaitsev, lucrez ca administrator de sistem la Odnoklassniki. Înainte am fost de asemenea admin, lucrând cu Manticore Search, Sphinx Search, Elasticsearch. Probabil, dacă va apărea un alt …search, voi lucra și cu el. De asemenea, particip în mai multe proiecte open-source pe bază de voluntariat.
Când am venit la Odnoklassniki, am spus imprudent în cadrul interviului că știu să lucrez cu Elasticsearch. După ce m-am aclimatizat și am rezolvat câteva sarcini simple, mi-a fost încredințată o mare sarcină de reformare a sistemului de gestionare a jurnalelelor, care exista la acel moment.
Cerințe
Cerințele pentru sistem au fost formulate astfel:
- Ca frontend, ar trebui să fie utilizat Graylog. Pentru că în companie exista deja experiența utilizării acestui produs, programatorii și testeri îl știau, le era familiar și convenabil.
- Volumul de date: în medie, 50-80 de mii de mesaje pe secundă, dar dacă ceva se strică, traficul nu este restricționat, acesta poate ajunge la 2-3 milioane de rânduri pe secundă
- Discutând cu clienții despre cerințele de viteză de procesare a interogărilor de căutare, am realizat că modelul tipic de utilizare a unui astfel de sistem este următorul: oamenii caută în jurnalele aplicației lor din ultimele două zile și nu doresc să aștepte mai mult de o secundă pentru rezultatul interogării formulate.
- Adminii au insistat ca sistemul să fie ușor scalabil, fără a necesita o înțelegere profundă a modului în care este construit.
- Astfel, singura sarcină de întreținere care era necesară periodic pentru aceste sisteme era de a schimba o parte de hardware.
- În plus, la Odnoklassniki există o tradiție tehnică minunată: orice serviciu pe care îl lansăm trebuie să supraviețuiască eșecului unui centru de date (brusc, neplanificat și în orice moment).
Cea mai recentă cerință în realizarea acestui proiect ne-a costat cel mai mult, despre care voi mai povesti în detaliu.
Mediu
Operăm în patru centre de date, însă nodurile de date Elasticsearch pot fi amplasate doar în trei (din motive non-tehnice).
În aceste patru centre de date se află aproximativ 18.000 de surse de loguri diferite - componente hardware, containere, mașini virtuale.
O caracteristică importantă: clusterul este lansat în containere nu pe mașini fizice, ci pe . Containerele beneficiază de 2 nuclei, echivalenti cu 2.0Ghz v4, cu posibilitatea de reutilizare a celorlalți nuclei în cazul în care sunt neutilizați.
Cu alte cuvinte:
Topologie
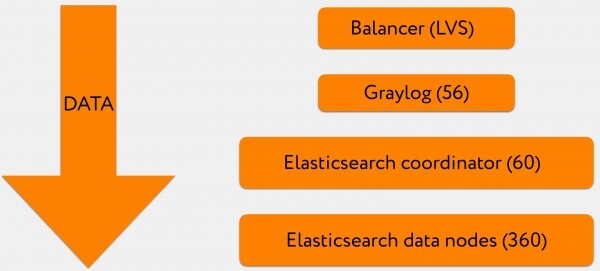
Aspectul general al soluției mi s-a părut inițial astfel:
- 3-4 VIP-uri se află în spatele înregistrării A a domeniului Graylog, acesta este adresa la care sunt trimise logurile.
- fiecare VIP este un balansor LVS.
- După aceea, logurile ajung la bateria Graylog, o parte din date sunt în format GELF, iar cealaltă parte în format syslog.
- Apoi, totul este scris în mari batch-uri în bateria de coordonatori Elasticsearch.
- Iar aceștia, la rândul lor, trimit solicitări de scriere și citire către nodurile de date relevante.
Terminologie
Poate că nu toată lumea este familiarizată cu terminologia, așa că aș dori să mă opresc puțin asupra acesteia.
În Elasticsearch există mai multe tipuri de noduri - master, coordinator, nod de date. Mai există două tipuri pentru diverse transformări ale logurilor și pentru legătura între diferite clustere, dar noi am folosit doar cele enumerate.
Master
Pingează toate nodurile prezente în cluster, menține o hartă actualizată a clusterului și o distribuie între noduri, prelucrează logica evenimentelor, se ocupă cu diverse activități de întreținere la nivel de cluster.
Coordinator
Îndeplinește o singură sarcină: acceptă solicitările clienților pentru citire sau scriere și direcționează acest trafic. În cazul în care este o solicitare de scriere, va întreba probabil master-ul în ce shard relevant al indexului să fie plasată și va redirecționa cererea mai departe.
Data node
Stochează date, execută solicitările de căutare venite din exterior și operațiile asupra shardurilor amplasate pe ea.
Graylog
Este ceva asemănător cu o combinație între Kibana și Logstash în stiva ELK. Graylog îmbină interfața de utilizator și un pipeline pentru procesarea logurilor. Sub capotă, Graylog folosește Kafka și Zookeeper, care asigură conectivitatea clusterei Graylog. Graylog poate cache-ui logurile (Kafka) în cazul în care Elasticsearch nu este disponibil și poate repeta cererile nereușite pentru citire și scriere, grupând și etichetând logurile conform regulilor specificate. La fel ca Logstash, Graylog are funcționalitate de modificare a liniilor înainte de a le scrie în Elasticsearch.
În plus, Graylog are o descoperire de servicii încorporată, care permite obținerea întregului harta a clusterei pe baza unei singure noduri Elasticsearch disponibile și filtrarea acesteia după un anumit tag, ceea ce oferă posibilitatea de a direcționa cererile către anumite containere.
Vizual, aceasta arată cam așa:

Aceasta este o captură de ecran de pe o instanță specifică. Aici construim un histogramă pe baza unei interogări de căutare, afișând liniile relevante.
Indecși
Întorcându-ne la arhitectura sistemului, aș dori să mă opresc mai în detaliu asupra modului în care am construit modelul de indecși, astfel încât să funcționeze corect.
În schema prezentată anterior, acesta este cel mai de jos nivel: nodurile de date Elasticsearch.
Un index este o entitate virtuală mare, formată din sharde Elasticsearch. Fiecare shard este, de fapt, un index Lucene. Iar fiecare index Lucene este compus din unul sau mai multe segmente.
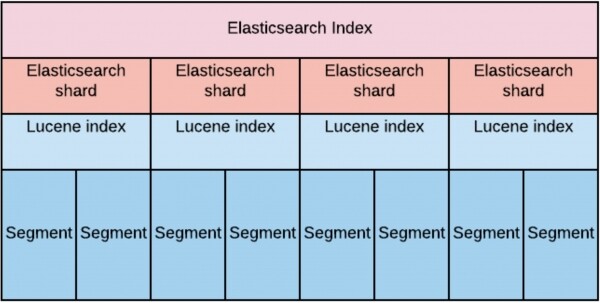
Atunci când am proiectat, am estimat că pentru a îndeplini cerința de viteză de citire la un volum mare de date trebuie să „distribuim” uniform aceste date pe nodurile de date.
Aceasta a dus la concluzia că numărul de sharde pe index (cu replici) trebuie să fie strict egal cu numărul de noduri de date. În primul rând, pentru a asigura un factor de replicare de două (adică putem pierde jumătate din cluster). Și, în al doilea rând, pentru a procesa cererile de citire și scriere, pe cel puțin jumătate din cluster.
Am stabilit inițial timpul de păstrare ca fiind 30 de zile.
Distribuția shardelor poate fi reprezentată grafic în următorul fel:
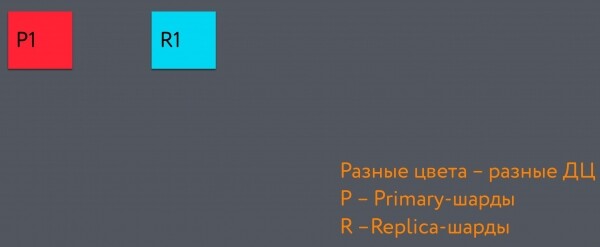
Întregul dreptunghi gri închis este indexul. Cadrul roșu din stânga reprezintă shardul principal, primul din index. Iar cadranul albastru este shardul replicat. Ele se află în centre de date diferite.
Atunci când adăugăm un nou shard, acesta ajunge în al treilea data center. Și, în cele din urmă, obținem o structură care permite pierderea DC fără pierderea consistenței datelor:
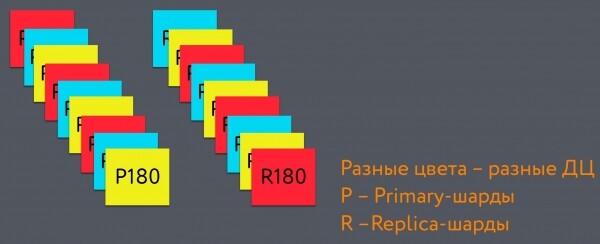
Rotirea indexurilor, adică crearea unui nou index și ștergerea celui mai vechi, a fost setată la 48 de ore (în funcție de modelul de utilizare a indexului: cele mai frecvente căutări se fac în ultimele 48 de ore).
Acest interval de rotire a indexurilor este legat de următoarele motive:
Când un anumit nod de date primește o interogare de căutare, din punct de vedere al performanței, este mai avantajos să se interogheze un singur shard, dacă dimensiunea lui este comparabilă cu dimensiunea heap-ului nodului. Acest lucru permite păstrarea părții „fierbinți” a indexului în heap și accesarea rapidă a acesteia. Când devin multe „părți fierbinți”, viteza de căutare în index se degradează.
Atunci când un nod începe să execute o interogare de căutare pe un shard, alocă un număr de fire egal cu numărul nucleelor de hyperthreading ale mașinii fizice. Dacă interogarea de căutare implică un număr mare de sharduri, numărul de fire crește proporțional. Acest lucru are un impact negativ asupra vitezei de căutare și afectează negativ indexarea noilor date.
Pentru a asigura latența necesară căutării, am decis să folosim SSD-uri. Pentru procesarea rapidă a interogărilor, mașinile pe care erau plasate aceste containere trebuiau să aibă cel puțin 56 de nuclee. Numărul de 56 este ales ca o măsură condiționată suficientă pentru a determina numărul de fire pe care îl va genera Elasticsearch în timpul funcționării. În Elasticsearch, multe parametrii din thread pool depind direct de numărul de nuclee disponibile, ceea ce la rândul său influențează direct numărul necesar de noduri în cluster conform principiului „mai puține nuclee — mai multe noduri”.
În rezultatul final, am obținut că, în medie, un shard cântărește cam 20 de gigabaiți, iar pentru 1 index sunt 360 de sharduri. Prin urmare, dacă le rotim la fiecare 48 de ore, avem 15 dintre ele. Fiecare index conține date pentru 2 zile.
Scheme de scriere și citire a datelor
Să analizăm cum sunt scrise datele în acest sistem.
Să presupunem că avem o solicitare care vine de la Graylog în coordonator. De exemplu, dorim să indexăm 2-3 mii de rânduri.
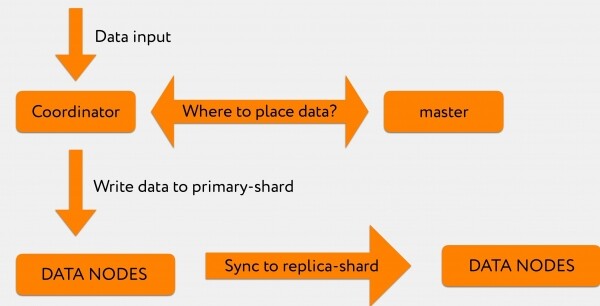
Coordonatorul, primind cererea de la Graylog, intervievează masterul: „În cererea de indexare, a fost specificat în mod concret indexul, dar nu s-a menționat în care shard trebuie să-l scrie.”
Masterul răspunde: „Scrie această informație în shardul numărul 71”, după care este trimisă direct către nodul de date relevant, unde se află shardul primar numărul 71.
Apoi, jurnalul tranzacțiilor este replicat pe replica-shard, care se află deja în alt centru de date.
Din Graylog, coordonatorul primește o solicitare de căutare. Coordonatorul o redirecționează pe index, în timp ce Elasticsearch distribuie cererile între primar-shard și replica-shard pe baza principiului round-robin.
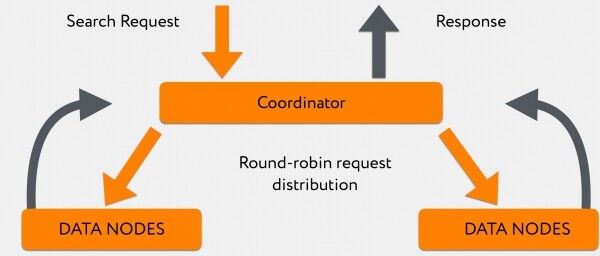
Cele 180 de noduri răspund inegal, iar, pe măsură ce răspund, coordonatorul acumulează informațiile pe care nodurile de date mai rapide le-au „fluierat” deja în el. După aceea, când fie toată informația a sosit, fie cererea a atins timeout-ul, returnează totul direct clientului.
Întreaga acestă sistemă procesează, în medie, cererile de căutare pentru ultimele 48 de ore în 300-400ms, excluzând acele cereri cu wildcard de început.
„Flori” cu Elasticsearch: configurarea Java
Pentru ca toate acestea să funcționeze așa cum ne-am dorit inițial, am petrecut mult timp ajustând cele mai variate aspecte în cluster.
Prima parte a problemelor descoperite a fost legată de modul în care Java este configurată implicit în Elasticsearch.
Problema întâi
Am observat un număr foarte mare de mesaje conform cărora la nivel de Lucene, atunci când sunt rulate joburi de fundal, fuzionările segmentelor Lucene se finalizează cu eroare. În loguri, era clar că era o eroare OutOfMemoryError. Prin telemetrie am observat că heap-ul era liber, și nu era clar de ce această operație eșuează.
S-a descoperit că fuzionările indexurilor Lucene au loc în afara heap-ului. Iar containerele sunt destul de strict limitate în ceea ce privește resursele consumate. Aceste resurse includeau doar heap-ul (valoarea heap.size era aproximativ egală cu RAM), iar unele operațiuni off-heap cădeau cu eroare de alocare a memoriei, dacă dintr-un motiv oarecare nu se încadrau în cele ~500MB care rămâneau până la limită.
Fixul a fost destul de trivial: am crescut volumul de RAM disponibil pentru container, după care am uitat de faptul că am avut vreo problemă de acest tip.
Problema a doua
După aproximativ 4-5 zile de la lansarea cluster-ului, am observat că nodurile de date încep să cadă periodic din cluster și se reintegrează în el în decurs de 10-20 de secunde.
Când am început să investigăm, am descoperit că memoria off-heap din Elasticsearch nu este practic controlată în niciun fel. Când am alocat mai multă memorie containerului, am obținut capacitatea de a umple pool-urile de buffer direct cu informații diverse, iar acestea erau curățate doar după ce era lansat un GC explicit din partea Elasticsearch.
În unele cazuri, această operațiune se desfășura destul de lent, iar în acest timp cluster-ul reușea să marcheze acest nod ca fiind deja ieșit. Această problemă este bine descrisă .
Soluția a fost următoarea: am limitat Java să utilizeze majoritatea memoriei din afara heap-ului pentru aceste operațiuni. Am limitat-o la 16 gigabaiți (-XX:MaxDirectMemorySize=16g), reușind astfel să apelăm GC explicit mult mai des, iar acesta să funcționeze semnificativ mai repede, stabilizând astfel cluster-ul.
Problema a treia
Dacă credeți că problemele cu «nodurile care părăsesc cluster-ul în cele mai neprevăzute momente» s-au oprit aici, vă înșelați.
Atunci când am configurat lucrul cu indexurile, ne-am oprit asupra mmapfs, pentru a pe shard-urile recente cu o segmentare mare. Aceasta a fost o greșeală destul de gravă, deoarece utilizarea mmapfs mapează fișierul în memoria operativă, iar ulterior lucrăm deja cu fișierul mapped. Din cauza aceasta, atunci când încercăm să oprim thread-urile din aplicație, ajungem destul de greu la safepoint, iar pe drumul către acesta, aplicația încetează să răspundă la cererile master-ului cu privire la starea ei. Prin urmare, master-ul consideră că nodul nu mai este prezent în cluster. După aceasta, după aproximativ 5-10 secunde, garbage collector-ul își finalizează operația, nodul revine la viață, intră din nou în cluster și începe inițializarea shard-urilor. Totul a semănat foarte mult cu „produția pe care o merităm” și nu era potrivit pentru nimic serios.
Pentru a scăpa de acest comportament, mai întâi am trecut la standardul niofs, iar apoi, când ne-am migrat de la versiunile a cincea la a șasea a Elastic, am încercat hybridfs, unde această problemă nu s-a mai prezentat. Puteți citi mai multe despre tipurile de stocare .
Problema a patra
Apoi a fost o altă problemă foarte captivantă, pe care am tratat-o extrem de mult timp. Am întâmpinat-o timp de 2-3 luni, deoarece modelul său era complet neclar.
Uneori, coordonatorii noștri intrau în Full GC, de obicei după-amiaza, și nu se mai întorceau. În timpul logării întârzierilor GC, acest lucru arăta astfel: totul mergea bine, bine, bine, apoi brusc — și totul devenea brusc rău.
La început, am crezut că avem un utilizator rău care trimite o cerere care scoate coordonatorul din modul de lucru. Am logat cererile foarte mult, încercând să ne dăm seama ce se întâmpla.
În cele din urmă, s-a dovedit că în momentul în care un utilizator trimite o cerere foarte mare și aceasta ajunge pe un coordonator Elasticsearch specific, unele noduri răspund mai lent decât altele.
Iar timpul pe care coordonatorul îl așteaptă pentru a obține răspunsul de la toate nodurile, el acumulează rezultatele trimise de nodurile care au răspuns deja. Pentru GC, aceasta înseamnă că modelul de utilizare a heap-ului se schimbă foarte repede. Și GC-ul pe care l-am folosit nu se descurca cu această problemă.
Singura soluție pe care am găsit-o pentru a schimba comportamentul clusterului în această situație a fost migrarea la JDK13 și utilizarea colectorului de gunoi Shenandoah. Aceasta a rezolvat problema, iar coordonatorii nu mai cădeau.
După aceasta, problemele cu Java s-au încheiat și au început problemele cu lățimea de bandă.
„Cireșele” cu Elasticsearch: lățimea de bandă
Problemele cu lățimea de bandă înseamnă că clusterul nostru funcționează stabil, dar în momentele de vârf de documente indexate și în momentele de manevră performanța este insuficientă.
Primul simptom întâlnit: la anumite „explozive” în producție, când se generează brusc o cantitate foarte mare de loguri, în Graylog începe să apară frecvent eroarea de indexare es_rejected_execution.
Aceasta se întâmpla deoarece thread_pool.write.queue pe un nod de date, înainte ca Elasticsearch să poată procesa cererea de indexare și să adauge informația în shard pe disc, în mod implicit poate cache doar 200 de cereri. Și în despre acest parametru se vorbește foarte puțin. Se indică doar numărul maxim de fire de execuție și dimensiunea implicită.
Desigur, am mers să ajustăm această valoare și am descoperit următoarele: în configurația noastră specifică, putem cache până la 300 de cereri destul de bine, dar o valoare mai mare aduce riscul de a reveni în Full GC.
În plus, având în vedere că acestea sunt pachete de mesaje care vin într-o singură cerere, a fost necesar să ajustăm Graylog astfel încât să scrie nu frecvent și în mici loturi, ci în loturi mari sau o dată la 3 secunde, dacă lotul nu este încă plin. În acest caz, informația pe care o scriem în Elasticsearch devine disponibilă nu în două secunde, ci în cinci (ceea ce ne mulțumește), dar numărul de retrageri necesare pentru a împinge un lot mare de informații se reduce.
Acest lucru este deosebit de important în momentele în care avem ceva care a căzut undeva și anunță cu fervoare despre acest lucru, pentru a nu obține un Elastic complet spam-uit, iar după un timp, nodurile Graylog care nu mai funcționează din cauza buffer-elor blocate.
În plus, atunci când au avut loc aceste explozii în producție, am primit plângeri de la programatori și testerii: în momentul în care aveau cu adevărat nevoie de aceste jurnale, acestea le erau furnizate foarte lent.
Am început să investigăm. Pe de o parte, a fost clar că atât cererile de căutare, cât și cererile de indexare funcționează, de fapt, pe aceleași mașini fizice, și într-un fel sau altul vor exista anumite scăderi de performanță.
Dar acest lucru putea fi parțial evitat datorită faptului că în versiunile șase de Elasticsearch a apărut un algoritm care permite distribuirea cererilor între nodurile de date relevante nu pe un principiu aleatoriu round-robin (containerul, care se ocupă de indexare și menține shard-ul principal, poate fi foarte ocupat, nu va putea răspunde rapid), ci direcționând această cerere către un container mai puțin aglomerat cu replica-shard, care va răspunde semnificativ mai repede. Cu alte cuvinte, am ajuns la use_adaptive_replica_selection: true.
Imaginea citirii începe să arate astfel:
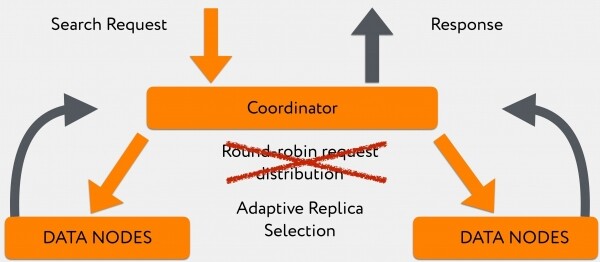
Trecerea la acest algoritm a permis îmbunătățirea semnificativă a timpului de interogare în momentele în care aveam un flux mare de jurnale pe scriere.
În cele din urmă, principala problemă consta în ieșirea fără durere din centrul de date.
Ce ne doream de la cluster imediat după pierderea conexiunii cu un DC:
- Dacă masterul curent se află în centrul de date căzut, acesta va fi reselectat și va muta rolul său pe un alt nod dintr-un alt DC.
- Masterul va elimina rapid din cluster toate nodurile inaccesibile.
- Pe baza celor rămase, el va înțelege: în centrul de date pierdut am avut aceste șarduri primare, va promova rapid șardurile replica complementare în centrele de date rămase, și ne va continua indexarea datelor.
- Ca rezultat, capacitatea de bandă a clusterei va degrada lin pentru scriere și citire, însă, în general, totul va funcționa, chiar dacă încet, dar stabil.
Așa cum s-a dovedit, am vrut ceva de genul:
Și am obținut următoarele:
Cum s-a întâmplat asta?
În momentul prăbușirii centrului de date, punctul nostru critic a fost masterul.
De ce?
Problema este că în master există TaskBatcher, care se ocupă cu distribuitul unor sarcini și evenimente specifice în cluster. Orice ieșire de nod, orice promovare a unui șard din replica în primar, orice sarcină de a crea un șard undeva — toate acestea ajung mai întâi la TaskBatcher, unde sunt procesate secvențial și într-un singur fir.
În momentul ieșirii unui centru de date, se întâmpla ca toate nodurile de date din centrele de date supraviețuitoare să considere că trebuie să informeze masterul «am pierdut astfel de șarduri și astfel de noduri de date».
În același timp, nodurile de date supraviețuitoare trimiteau toate aceste informații actualului master și încercau să aștepte confirmarea că el le-a primit. Nu așteptau acest lucru, deoarece masterul primea sarcini mai repede decât reușea să răspundă. Nodurile repetau cererile din cauza timeout-ului, iar masterul în acel timp deja nu mai încerca să le răspundă, fiind complet absorbit în sarcina de sortare a cererilor după prioritate.
În forma terminală, nodurile de date spaminu-l pe master atât de mult încât acesta ajungea în full GC. După asta, rolul masterului se transfera pe un alt nod, cu care se întâmpla exact același lucru, și în final clusterul se destrăma complet.
Am efectuat măsurători, iar până la versiunea 6.4.0, unde acest lucru a fost reparat, ne era suficient să scoatem simultan doar 10 noduri de date din 360 pentru a distruge complet clusterul.
Asta arăta aproximativ așa:
După versiunea 6.4.0, unde s-a reparat acest bug enervant, nodurile de date au încetat să-l distrugă pe master. Dar nu a devenit mai „inteligent” din aceasta. Adică: atunci când scoatem 2, 3 sau 10 (orice număr diferit de unu) noduri de date, masterul primește un prim mesaj, care spune că nodul A a ieșit, și încearcă să comunice despre acest lucru nodului B, nodului C, nodului D.
În prezent, singura soluție pentru a gestiona acest lucru este să setăm un timeout pentru încercările de a comunica cu cineva, de aproximativ 20-30 de secunde, și astfel să controlăm viteza de ieșire a centrului de date din cluster.
În principiu, acest lucru se încadrează în cerințele inițial stabilite pentru produsul final în cadrul proiectului, dar din perspectiva „științei pure”, acesta este un bug. Care, de altfel, a fost rezolvat cu succes de dezvoltatori în versiunea 7.2.
Mai mult, atunci când o anumită dată-nod ieșea din funcțiune, se întâmpla că a difuza informații despre ieșirea sa era mai important decât a anunța întregul cluster că pe aceasta se aflau anumite primary-shard (pentru a promova replica-shard în alt centru de date la primary, unde putea să se scrie informație).
Prin urmare, când totul s-a terminat, nodurile de date ieșite nu sunt marcate imediat ca stale. În consecință, suntem nevoiți să așteptăm până când toate ping-urile să expire pentru nodurile de date ieșite și abia după aceea clusterul nostru începe să comunice despre faptul că acolo, acolo și acolo trebuie continuată înregistrarea informațiilor. Despre acest subiect se poate citi mai în detaliu .
În cele din urmă, operațiunea de ieșire a centrului de date ne ocupă astăzi aproximativ 5 minute în orele de vârf. Pentru o mașină atât de mare și greoaie este un rezultat destul de bun.
În cele din urmă, am ajuns la următoarea soluție:
- Avem 360 de date-noduri cu discuri de 700 de gigabytes.
- 60 de coordonatori pentru rutarea traficului pe aceste date-noduri.
- 40 de masteri, care ne-au rămas ca un fel de moștenire din versiunile anterioare 6.4.0 — pentru a supraviețui ieșirii centrului de date, am fost moral pregătiți să pierdem câteva mașini, pentru a ne asigura că, chiar și în cel mai rău scenariu, să avem cvorum de masteri.
- Orice încercări de a combina rolurile pe un singur container s-au lovit de faptul că, mai devreme sau mai târziu, nodul se strica sub sarcină.
- În întregul cluster se folosește heap.size, egal cu 31 de gigabytes: toate încercările de a reduce dimensiunea au dus la faptul că la interogările de căutare grele cu wildcard-uri de început fie se omorau unele noduri, fie se activa circuit breaker în Elasticsearch.
- În plus, pentru a asigura performanța căutării, ne-am străduit să menținem numărul de obiecte în cluster cât mai redus posibil, pentru a procesa cât mai puține evenimente în cel mai îngust punct, pe care l-am avut la master.
În final, despre monitorizare
Pentru ca toate acestea să funcționeze așa cum ne-am propus, monitorizăm următoarele:
- Fiecare nod de date raportează în cloud-ul nostru că există și că pe el se află anumite fragmente. Când stingem ceva într-un loc, clusterul raportează în 2-3 secunde că, în centrul A, am stins nodurile 2, 3 și 4 — aceasta înseamnă că în alte centre de date nu putem stinge nodurile pe care mai există fragmente unice.
- Cunoscând comportamentul maestrului, ne uităm cu atenție la numărul de sarcini în așteptare. Deoarece chiar și o sarcină blocată, dacă nu este timeoutată la timp, teoretic într-o situație de urgență poate fi motivul pentru care nu vom reuși, de exemplu, să promovăm un fragment replica în primar, ceea ce va duce la oprirea indexării.
- De asemenea, ne uităm foarte atent la întârzierile garbage collector-ului, pentru că am avut deja dificultăți mari în optimizare cu acest aspect.
- Rejecțiile pe thread-uri, pentru a înțelege din timp unde se află 'gâtul de sticlă'.
- Și metrici standard, cum ar fi heap, RAM și I/O.
Atunci când se construiește monitorizarea, trebuie să se țină cont de particularitățile Thread Pool din Elasticsearch. descrie posibilitățile de configurare și valorile implicite pentru căutare, indexare, dar nu menționează deloc thread_pool.management. Aceste thread-uri procesează, printre altele, cereri de tip _cat/shards și alte similar, care sunt utile la scrierea monitorizării. Cu cât clusterul este mai mare, cu atât mai multe astfel de cereri sunt executate într-o unitate de timp, iar thread_pool.management menționat mai sus nu numai că nu este prezent în documentația oficială, dar este și limitat prin default la 5 thread-uri, ceea ce se consumă foarte repede, după care monitorizarea încetează să funcționeze corect.
Ce dorim să spunem în concluzie: am reușit! Am reușit să le oferim programatorilor și dezvoltatorilor noștri un instrument care poate oferi rapid și cu acuratețe informații despre ceea ce se întâmplă în producție, practic în orice situație.
Da, a fost destul de complicat, dar, cu toate acestea, dorințele noastre au reușit să se integreze în produsele deja existente, care nu au necesitat patch-uri și nici rescriere după nevoile noastre.
Sursa: habr.com
