

Acest articol descrie implementarea conductelor în nucleul Unix. Am fost oarecum dezamăgit că articolul recent intitulat „” s-a dovedit a fi nu despre structura internă. M-a făcut curios și am săpat în surse mai vechi pentru a găsi un răspuns.
Despre ce este vorba?
Conductele — „probabil cea mai importantă invenție în Unix” — sunt o caracteristică definitorie a filosofiei Unix, care reunește programe mici, precum și o comandă familiară în linia de comandă:
$ echo hello | wc -c
6
Această funcționalitate depinde de apelul de sistem furnizat de nucleu pipe, care este descris în paginile documentației și :
Conductele oferă un canal unidirecțional pentru comunicarea între procese. O conductă are un intrare (write end) și o ieșire (read end). Datele scrise în intrarea conductei pot fi citite la ieșire.
Conducta este creată prin apelul
pipe(2), care returnează doi descriitori de fișiere: unul se referă la intrarea conductei, iar celălalt la ieșire.
Rezultatele trasării comenzii de mai sus demonstrează crearea unei conducte și fluxul de date prin ea de la un proces la altul:
$ strace -qf -e execve,pipe,dup2,read,write
    sh -c 'echo hello | wc -c'

execve("/bin/sh", ["sh", "-c", "echo hello | wc -c"], …)
pipe([3, 4])                            = 0
[pid 2604795] dup2(4, 1)                = 1
[pid 2604795] write(1, "hellon", 6)    = 6
[pid 2604796] dup2(3, 0)                = 0
[pid 2604796] execve("/usr/bin/wc", ["wc", "-c"], …)
[pid 2604796] read(0, "hellon", 16384) = 6
[pid 2604796] write(1, "6n", 2)        = 2
Procesul părinte apelează pipe(), pentru a obține descriitorii de fișiere conectați. Un proces copil scrie într-un descritor, iar alt proces citește aceleași date din alt descritor. Shell-ul folosește dup2 pentru a „renumi” descriitorii 3 și 4, astfel încât să corespundă stdin și stdout.
Fără conducte, shell-ul ar fi trebuit să scrie rezultatul unui proces într-un fișier și să-l transfere unui alt proces pentru a citi datele din fișier. Drept urmare, am fi consumat mai multe resurse și spațiu pe disc. Cu toate acestea, conductele sunt bune nu doar pentru că evită utilizarea fișierelor temporare:
Dacă un proces încearcă să citească dintr-o conductă goală, atunci
read(2)va fi blocat până când datele devin disponibile. Dacă un proces încearcă să scrie într-o conductă plină, atunciwrite(2)va bloca până când din conductă vor fi citite suficiente date pentru a efectua scrierea.
Ca și cerința POSIX, aceasta este o proprietate importantă: scrierea în conductă până la PIPE_BUF octeți (minim 512) trebuie să fie atomică, astfel încât procesele să poată interacționa între ele prin conductă în modul în care fișierele obișnuite (care nu oferă astfel de garanții) nu pot.
Când se utilizează un fișier obișnuit, un proces poate scrie toate ieșirile sale și le poate transmite unui alt proces. Sau procesele pot acționa în modul de paralelizare strânsă, folosind un mecanism extern de semnalizare (precum un semafor) pentru a comunica între ele când s-a terminat scrierea sau citirea. Conductele ne scutesc de toate aceste necazuri.
Ce căutăm?
Voi explica în termeni simpli, pentru a vă ajuta să vizualizați cum poate funcționa o conductă. Veți avea nevoie să alocați un buffer în memorie și o stare. Vor fi necesare funcții pentru adăugarea și eliminarea datelor din buffer. Va fi nevoie de un mecanism pentru a apela funcțiile în timpul operațiunilor de citire și scriere în descriptorii de fișiere. Și vor fi necesare blocări pentru a implementa comportamentul special descris mai sus.
Acum suntem pregătiți să interogăm, sub lumina puternică a lămpii, codul sursă al nucleului pentru a confirma sau infirma modelul nostru mental vag. Dar fiți mereu pregătiți pentru surprize.
Unde căutăm?
Nu știu unde se află exemplarul meu al celebrei cărți „“ cu codul sursă Unix 6, dar datorită poate fi căutată online în versiuni și mai vechi ale Unix.
Rătăcirea prin arhivele TUHS este similară cu vizitarea unui muzeu. Putem privi în istoria noastră comună și simt un respect profund pentru eforturile de lungă durată de a recupera toate aceste materiale, bit cu bit, de pe vechi benzi și printuri. Și sunt profund conștient de fragmentele care încă lipsesc.
După ce mi-am satisfăcut curiozitatea în privința istoriei antice a conductelor, pentru comparație putem privi nucleele moderne.
Apropo, pipe este apelul de sistem numărul 42 din tabelul sysent[]. Coincidență?
Nucleele tradiționale Unix (1970–1974)
Nu am găsit nicio urmă pipe(2) nici în (ianuarie 1970), nici în (noiembrie 1971), nici în codul sursă incomplet (iunie 1972).
TUHS afirmă că (februarie 1973) a fost prima versiune cu pipe-uri:
A treia ediție Unix a fost ultima versiune cu un nucleu scris în asamblare, dar și prima versiune cu pipe-uri. În 1973, s-au desfășurat lucrări pentru îmbunătățirea celei de-a treia ediții, nucleul a fost rescris în C, iar astfel a apărut a patra ediție Unix.
Unul dintre cititori a găsit o scanare a documentului în care Doug McIlroy a propus ideea de a „conecta programele pe principiul unui furtun de gradină”.
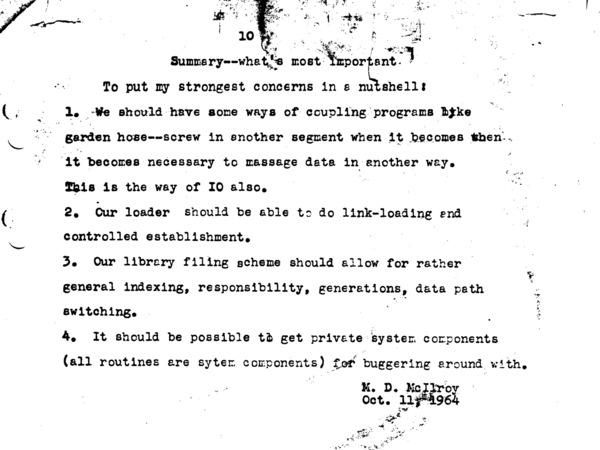
În cartea lui Brian Kernighan „”, se menționează de asemenea acest document în povestea despre apariția pipe-urilor: „… a stat pe peretele biroului meu de la Bell Labs timp de 30 de ani”. Iată , și încă o poveste din :
Când a apărut Unix, pasiunea mea pentru corutine m-a făcut să îi cer autorului sistemului de operare, Ken Thompson, să permită datelor înregistrate într-un proces să meargă nu doar la un dispozitiv, ci și la ieșirea către un alt proces. Ken a decis că acest lucru este posibil. Totuși, ca minimalist, și-a dorit ca fiecare funcție de sistem să joace un rol semnificativ. Are într-adevăr scrierea directă între procese un avantaj semnificativ comparativ cu scrierea într-un fișier intermediar? Și doar când am venit cu o propunere specifică având un nume atrăgător, „pipe”, și o descriere a sintaxei interacțiunii între procese, Ken a exclamat, în cele din urmă: „O voi face!”.
Și a făcut-o. Într-o seară fatidică, Ken a modificat nucleul și shell-ul, a corectat câteva programe standard, standardizând procedura de acceptare a datelor de intrare (care pot proveni din pipe), și a schimbat numele fișierelor. A doua zi, pipe-urile au început să fie folosite pe scară largă în aplicații. Până la sfârșitul săptămânii, secretarele le foloseau pentru a trimite documente din editorii de text la imprimante. Puțin mai târziu, Ken a înlocuit API-ul și sintaxa originale pentru shell cu convenții mai clare, care sunt folosite de atunci.
Din păcate, codul sursă al nucleului celei de-a treia ediții Unix este pierdut. Și deși avem codul sursă al nucleului , lansată în noiembrie 1973, aceasta a apărut cu câteva luni înainte de lansarea oficială și nu conține implementarea pipe-urilor. Este păcat că codul sursă al legendarului feature Unix a fost pierdut, poate pentru totdeauna.
Avem textul documentației despre pipe(2) din ambele versiuni, așa că putem începe cu căutarea în documentație (după anumite cuvinte, subliniate „manual”, o linie din literal ^H, după care urmează o subliniere!). Acest proto-pipe(2) este scris în assembler și returnează doar un descriptor de fișier, dar deja oferă funcționalitatea de bază așteptată:
Apelul de sistem pipe creează un mecanism de intrare-ieșire numit conductă. Descriptorul de fișier returnat poate fi folosit pentru operații de citire și scriere. Când se scrie ceva în conductă, se bufferizează până la 504 octeți de date, după care procesul de scriere este suspendat. La citirea din conductă, datele bufferizate sunt luate.
Până la anul următor, nucleul a fost rescris în C, iar a căpătat aspectul său modern cu prototipul „pipe(fildes)»:
Apelul de sistem pipe creează un mecanism de intrare-ieșire numit conductă. Descriptorii de fișier returnați pot fi folosiți în operații de citire și scriere. Când se scrie ceva în conductă, se folosește descriptorul returnat în r1 (corespondent fildes[1]), se bufferizează până la 4096 octeți de date, după care procesul de scriere este suspendat. La citirea din conductă, descriptorul returnat în r0 (corespondent fildes[0]) ia datele.
Se presupune că, după definirea conductei, două (sau mai multe) procese interacționante (create prin apeluri succesive fork) vor transmite date din conductă prin apeluri read și write.
În shell există o sintaxă pentru definirea unui tablou liniar de procese, conectate prin conducte.
Apelurile de citire dintr-o conductă goală (care nu conține date bufferizate), având doar un capăt (toate deschiderile de fișier de scriere fiind închise), returnează „sfârșitul fișierului”. Apelurile de scriere în situații similare sunt ignorate.
Cea mai timpurie se referă (iunie 1974), dar este aproape identică cu cea apărută în următoarea versiune. Numai comentariile au fost adăugate, astfel că a cincea ediție poate fi omisă.
Cea de-a șasea ediție Unix (1975)
Începem să citim codul sursă Unix (mai 1975). În mare parte datorită Lions este mult mai ușor să-l găsești decât sursele versiunilor anterioare:
Mulți ani, cartea Lions a fost singurul document despre nucleul Unix disponibil în afara zidurilor Bell Labs. Deși licența versiunii a șasea permitea profesorilor să folosească codul sursă, licența versiunii a șaptea a exclus această posibilitate, astfel că cartea a fost distribuită sub formă de copii tipărite ilegal.
Astăzi, puteți cumpăra o ediție reprint a cărții, pe coperta căreia sunt studenți lângă un copiator. Iar datorită lui Warren Toomey (care a inițiat proiectul TUHS), puteți descărca . Vreau să vă ofer o idee despre cât efort a fost necesar pentru crearea fișierului:
Cu mai bine de 15 ani în urmă, am tipărit o copie a codului sursă prezentat în Lions, pentru că nu-mi plăcea calitatea copiei mele dintr-un număr necunoscut de alte copii. TUHS nu exista încă, iar eu nu aveam acces la vechile surse. Dar în 1988 am găsit o bandă veche cu 9 piste, care conținea o copie de rezervă de pe calculatorul PDP11. Era greu de înțeles dacă funcționa, dar acolo era un arbore intact /usr/src/, în care majoritatea fișierelor erau marcate cu anul 1979, ceea ce părea deja o antichitate. Aceasta era versiunea a șaptea sau un derivat PWB, așa cum credeam.
Am folosit această descoperire ca bază și am editat manual sursele până la starea versiunii a șasea. O parte din cod a rămas aceeași, iar partea a fost ușor editată, schimbând tokenul modern += cu cel învechit =+. Unele lucruri au fost pur și simplu eliminate, iar altele au trebuit rescrise complet, însă nu foarte multe.
Și astăzi putem citi online pe TUHS codul sursă al versiunii a șasea din .
Apropo, la prima vedere, trăsătura principală a codului C din perioada Kernighan și Ritchie este succintitudinea. Nu mi se întâmplă prea des să pot insera fragmente de cod fără o editare extinsă, astfel încât să se conformeze unei zone relativ înguste de afișare pe site-ul meu.
La început există un comentariu explicativ (și da, acolo este și ):
/*
 * Max allowable buffering per pipe.
 * This is also the max size of the
 * file created to implement the pipe.
 * If this size is bigger than 4096,
 * pipes will be implemented in LARG
 * files, which is probably not good.
 */
#define    PIPSIZ    4096
Dimensiunea buffer-ului nu s-a schimbat din vremea versiunii a patra. Dar aici, fără nicio documentație publică, vedem că odată, conductele foloseau fișiere ca stocare de rezervă!
În ceea ce privește fișierele LARG, acestea corespund , care este utilizat de „algoritmul de adresare mare” pentru procesare pentru a sprijini sisteme de fișiere mai mari. Deoarece Ken a spus că este mai bine să nu le folosim, îl voi crede cu plăcere pe cuvânt.
Iată o adevărată apelare a sistemului pipe:
/*
 * The sys-pipe entry.
 * Allocate an inode on the root device.
 * Allocate 2 file structures.
 * Put it all together with flags.
 */
pipe()
{
    register *ip, *rf, *wf;
    int r;

    ip = ialloc(rootdev);
    if(ip == NULL)
        return;
    rf = falloc();
    if(rf == NULL) {
        iput(ip);
        return;
    }
    r = u.u_ar0[R0];
    wf = falloc();
    if(wf == NULL) {
        rf->f_count = 0;
        u.u_ofile[r] = NULL;
        iput(ip);
        return;
    }
    u.u_ar0[R1] = u.u_ar0[R0]; /* wf's fd */
    u.u_ar0[R0] = r;           /* rf's fd */
    wf->f_flag = FWRITE|FPIPE;
    wf->f_inode = ip;
    rf->f_flag = FREAD|FPIPE;
    rf->f_inode = ip;
    ip->i_count = 2;
    ip->i_flag = IACC|IUPD;
    ip->i_mode = IALLOC;
}
Comentația descrie clar ce se întâmplă aici. Însă, a înțelege codul nu este atât de simplu, parțial din cauza modului în care prin „” și registrele R0 și R1 sunt transmise parametrii apelurilor de sistem și valorile returnate.
Hai să încercăm să folosim pentru a plasa pe disc , iar cu ajutorul — să plasăm în memorie două Dacă totul decurge bine, atunci vom seta flaguri pentru a defini aceste fișiere ca cele două capete ale unui țeavă, le vom specifica în același inode (al cărui contor de referințe va deveni 2) și vom marca inode-ul ca fiind modificat și utilizat. Observați apeland la pe căile greșite (error paths) pentru a reduce contorul de referințe în noul inode.
pipe() trebuie prin R0 și R1 să returneze numerele descriptorilor de fișiere pentru citire și scriere. falloc() returnează un pointer către structura de fișier, dar de asemenea „returnează” prin u.u_ar0[R0] și descriptorul de fișier. Adică, codul salvează în r descriptorul de fișier pentru citire și alocă descriptorul pentru scriere direct din u.u_ar0[R0] după a doua apelare falloc().
Steagul FPIPE, pe care l-am definit la crearea țevii, gestionează comportamentul funcției , apelând subprogramele specifice de intrare-ieșire I/O:
/*
 * common code for read and write calls:
 * check permissions, set base, count, and offset,
 * and switch out to readi, writei, or pipe code.
 */
rdwr(mode)
{
    register *fp, m;

    m = mode;
    fp = getf(u.u_ar0[R0]);
        /* … */

    if(fp->f_flag&FPIPE) {
        if(m==FREAD)
            readp(fp); else
            writep(fp);
    }
        /* … */
}
Apoi funcția readp() în pipe.c citește date din țeavă. Dar este mai bine să urmărești implementarea începând de la writep(). Repet, codul s-a complicat din cauza particularităților convenției de transmisie a argumentelor, dar unele detalii pot fi omise.
writep(fp)
{
    register *rp, *ip, c;

    rp = fp;
    ip = rp->f_inode;
    c = u.u_count;

loop:

    plock(ip);
    if(c == 0) {
        prele(ip);
        u.u_count = 0;
        return;
    }


    if(ip->i_count i_size1 == PIPSIZ) {
        ip->i_mode =| IWRITE;
        prele(ip);
        sleep(ip+1, PPIPE);
        goto loop;
    }


    u.u_offset[0] = 0;
    u.u_offset[1] = ip->i_size1;
    u.u_count = min(c, PIPSIZ-u.u_offset[1]);
    c =- u.u_count;
    writei(ip);
    prele(ip);
    if(ip->i_mode&IREAD) {
        ip->i_mode =& ~IREAD;
        wakeup(ip+2);
    }
    goto loop;
}
În intrarea țevii vrem să scriem biți u.u_count. Mai întâi trebuie să blocăm descriptorul de index (vezi mai jos plock/prele).
Apoi verificăm contorul de referințe inode. Atâta timp cât ambele capete ale conduitei rămân deschise, contorul ar trebui să fie egal cu 2. Păstrăm o referință (din rp->f_inode), așa că dacă contorul este mai mic de 2, asta ar trebui să însemne că procesul de citire a închis capătul său al conduitei. Cu alte cuvinte, încercăm să scriem într-o conductă închisă, iar aceasta este o eroare. Codul de eroare EPIPE și semnalul SIGPIPE au apărut în a șasea ediție Unix.
Dar chiar dacă conducta este deschisă, ar putea fi plină. În acest caz, dezactivăm blocarea și ne culcăm în speranța că un alt proces va citi din conductă și va elibera suficient spațiu în ea. Când ne trezim, ne întoarcem la început, din nou punem blocarea și începem un nou ciclu de scriere.
Dacă în conductă există suficient spațiu liber, atunci scriem date în ea folosind . Parametrul i_size1 al inode-ului (pe o conductă goală acesta poate fi 0) indică sfârșitul datelor care sunt deja conținute în ea. Dacă există suficient spațiu pentru scriere, putem umple conducta de la i_size1 la PIPESIZ. Apoi dezactivăm blocarea și încercăm să trezim orice proces care așteaptă să citească din conductă. Ne întoarcem la început pentru a verifica dacă am reușit să scriem atâtea bite cât aveam nevoie. Dacă nu, începem un nou ciclu de scriere.
De obicei, parametrul i_mode al inode-ului este utilizat pentru a stoca permisiunile r, w și x. Dar în cazul conducților, semnalizăm așteptarea de către un proces de scriere sau citire cu ajutorul bitilor IREAD și IWRITE respectiv. Procesul setează un flag și cheamă sleep(), și se așteaptă ca în viitor un alt proces să cheme wakeup().
Adevăratul magic se întâmplă în sleep() și wakeup(). Ele sunt implementate în , sursa celebrului comentariu «Nu e necesar să înțelegi asta» (You are not expected to understand this). Din fericire, nu trebuie să înțelegem codul, putem doar să ne uităm la câteva comentarii:
/*
 * Give up the processor till a wakeup occurs
 * on chan, at which time the process
 * enters the scheduling queue at priority pri.
 * The most important effect of pri is that when
 * pri<0 a signal cannot disturb the sleep;
 * if pri>=0 signals will be processed.
 * Callers of this routine must be prepared for
 * premature return, and check that the reason for
 * sleeping has gone away.
 */
sleep(chan, pri) /* … */

/*
 * Wake up all processes sleeping on chan.
 */
wakeup(chan) /* … */
Procesul care cheamă sleep() pentru un anumit canal poate fi ulterior trezit de un alt proces care cheamă wakeup() pentru același canal. writep() și readp() coordonează acțiunile lor prin astfel de apeluri pereche. Observați că pipe.c întotdeauna dă prioritate PPIPE la apelul sleep(), de aceea toate sleep() pot fi întrerupte de un semnal.
Acum avem tot ce ne trebuie pentru a înțelege funcția readp():
readp(fp)
int *fp;
{
    register *rp, *ip;

    rp = fp;
    ip = rp->f_inode;

loop:
    /* Blocare foarte conservatoare. */

    plock(ip);

    /*
     * Dacă capul (citire) a ajuns din urmă
     * coada (scriere), resetați ambele la 0.
     * /

    if(rp->f_offset[1] == ip->i_size1) {
        if(rp->f_offset[1] != 0) {
            rp->f_offset[1] = 0;
            ip->i_size1 = 0;
            if(ip->i_mode&IWRITE) {
                ip->i_mode =& ~IWRITE;
                wakeup(ip+1);
            }
        }

        /*
         * Dacă nu sunt activi atât cititorul, cât și
         * scriitorul, întoarceți fără
         * a satisface lectura.
         * /

        prele(ip);
        if(ip->i_count i_mode |= IREAD;
        sleep(ip+2, PPIPE);
        goto loop;
    }

    /* Citește și întoarce */

    u.u_offset[0] = 0;
    u.u_offset[1] = rp->f_offset[1];
    readi(ip);
    rp->f_offset[1] = u.u_offset[1];
    prele(ip);
}
Poate va fi mai ușor să citiți această funcție de jos în sus. Ramura „citește și întoarce” este de obicei folosită atunci când există date în canal. În acest caz, folosim citind atâtea date cât sunt disponibile începând de la actualul f_offset de citire, iar apoi actualizăm valoarea corespunzătoarei deplasări.
La citirea ulterioară, canalul va fi gol dacă deplasarea de citire a atins valoarea i_size1 de la inode. Resetăm poziția la 0 și încercăm să trezim orice proces care vrea să scrie în canal. Știm că atunci când canalul va fi plin, writep() se va adormi la ip+1. Și acum, când canalul este gol, putem să-l trezim pentru a-și relua ciclul de scriere.
Dacă nu este nimic de citit, atunci readp() poate seta un flag IREAD și să adoarmă la ip+2. Știm că va fi trezit writep(), când va scrie date în canal.
Comentariile la vor ajuta să înțelegem că, în loc să transmitem parametrii prin „u”, putem să ne adresăm cu ele ca unor funcții obișnuite de intrare-ieșire, care iau un fișier, o poziție, un buffer în memorie și calculează numărul de octeți de citit sau scris.
/*
 * Read the file corresponding to
 * the inode pointed at by the argument.
 * The actual read arguments are found
 * in the variables:
 *    u_base        core address for destination
 *    u_offset    byte offset in file
 *    u_count        number of bytes to read
 *    u_segflg    read to kernel/user
 */
readi(aip)
struct inode *aip;
/* … */

/*
 * Write the file corresponding to
 * the inode pointed at by the argument.
 * The actual write arguments are found
 * in the variables:
 *    u_base        core address for source
 *    u_offset    byte offset in file
 *    u_count        number of bytes to write
 *    u_segflg    write to kernel/user
 */
writei(aip)
struct inode *aip;
/* … */
În ceea ce privește blocarea „conservatoare”, se blochează inode-ul până când finalizează munca sau obține un rezultat (adică apelează readp() și writep() wakeup plock()). prele() și funcționează pur și simplu: o utilizare a altui set de apeluri care ne permite să trezim orice proces care are nevoie de blocarea pe care tocmai am eliberat: La început, nu am putut înțelege de ce nu se apelează sleep și plock() prele(ip)
/*
 * Lock a pipe.
 * If its already locked, set the WANT bit and sleep.
 */
plock(ip)
int *ip;
{
    register *rp;

    rp = ip;
    while(rp->i_flag&ILOCK) {
        rp->i_flag =| IWANT;
        sleep(rp, PPIPE);
    }
    rp->i_flag =| ILOCK;
}

/*
 * Unlock a pipe.
 * If WANT bit is on, wakeup.
 * This routine is also used to unlock inodes in general.
 */
prele(ip)
int *ip;
{
    register *rp;

    rp = ip;
    rp->i_flag =& ~ILOCK;
    if(rp->i_flag&IWANT) {
        rp->i_flag =& ~IWANT;
        wakeup(rp);
    }
}
înainte de a apela readp() wakeup(ip+1) . Primul lucru care apeloază în bucla sa este plock(ip), care duce la blocaj mutual, dacă writep() încă nu și-a eliberat blocarea, așa că codul trebuie să funcționeze corect într-un fel. Dacă ne uităm la plock(ip), care duce la blocare mutuală, dacă readp() încă nu și-a ridicat blocajul, astfel încât codul ar trebui să funcționeze corect într-un fel. Dacă ne uităm la wakeup(), devine că doar marchează procesul suspendat ca fiind gata de execuție, pentru o utilizare ulterioară. sched() a fost cu adevărat inițiat. Așadar, readp() cauzează wakeup(), ridică blocarea, stabilește IREAD și cheamă sleep(ip+2)— totul înainte de a writep() relua ciclul.
Acesta este sfârșitul descrierii conductelor în a șasea ediție. Un cod simplu, dar cu implicații ample.
ianuarie 1979 a fost o nouă versiune majoră (după patru ani), care a adus multe aplicații și caracteristici noi la nucleu. De asemenea, a suferit modificări semnificative în legătură cu utilizarea conversiilor de tip, unioni și pointeri tipizați pentru structuri. Totuși, a rămas practic neschimbat. Putem să sărim peste această ediție.
Xv6, un nucleu de tip Unix simplu
Crearea nucleului a fost influențată de a șasea ediție Unix, dar este scrisă în C modern, astfel încât să poată rula pe procesoare x86. Codul este ușor de citit și clar. În plus, spre deosebire de sursele Unix de la TUHS, îl poți compila, modifica și rula pe ceva diferit de PDP 11/70. Din acest motiv, acest nucleu este utilizat pe scară largă în universități ca material educațional pentru sisteme de operare. Sursele .
Codul conține o implementare clară și bine gândită, , susținută de un buffer în memorie în loc de inode pe disc. Aici aduc doar definiția „conductei structurale” și funcția pipealloc():
#define PIPESIZE 512

struct pipe {
  struct spinlock lock;
  char data[PIPESIZE];
  uint nread;     // number of bytes read
  uint nwrite;    // number of bytes written
  int readopen;   // read fd is still open
  int writeopen;  // write fd is still open
};

int
pipealloc(struct file **f0, struct file **f1)
{
  struct pipe *p;

  p = 0;
  *f0 = *f1 = 0;
  if((*f0 = filealloc()) == 0 || (*f1 = filealloc()) == 0)
    goto bad;
  if((p = (struct pipe*)kalloc()) == 0)
    goto bad;
  p->readopen = 1;
  p->writeopen = 1;
  p->nwrite = 0;
  p->nread = 0;
  initlock(&p->lock, "pipe");
  (*f0)->type = FD_PIPE;
  (*f0)->readable = 1;
  (*f0)->writable = 0;
  (*f0)->pipe = p;
  (*f1)->type = FD_PIPE;
  (*f1)->readable = 0;
  (*f1)->writable = 1;
  (*f1)->pipe = p;
  return 0;

 bad:
  if(p)
    kfree((char*)p);
  if(*f0)
    fileclose(*f0);
  if(*f1)
    fileclose(*f1);
  return -1;
}
pipealloc() stabilește starea întregii realizări, care include funcțiile piperead(), pipewrite() și pipeclose(). Apelul de sistem real sys_pipe este un wrapper implementat în Recomand să citești întregul său cod. Complexitatea este la nivelul sursei versiunii a șasea, dar este mult mai ușor și mai plăcut de citit.
Linux 0.01
Poți găsi codul sursă al Linux 0.01. Ar fi instructiv să studiezi implementarea conductelor în acesta. fs/pipe.c. Aici, pentru reprezentarea conductei se folosește inode, dar conducta în sine este scrisă în C modern. Dacă ai reușit să parcurgi codul versiunii a șasea, atunci aici nu vei întâmpina dificultăți. Așa arată funcția write_pipe():
int write_pipe(struct m_inode * inode, char * buf, int count)
{
    char * b=buf;

    wake_up(&inode->i_wait);
    if (inode->i_count != 2) { /* nu există cititori */
        current->signal |= (1<0) {
        while (PIPE_FULL(*inode)) {
            wake_up(&inode->i_wait);
            if (inode->i_count != 2) {
                current->signal |= (1<i_wait);
        }
        ((char *)inode->i_size)[PIPE_HEAD(*inode)] =
            get_fs_byte(b++);
        INC_PIPE( PIPE_HEAD(*inode) );
        wake_up(&inode->i_wait);
    }
    wake_up(&inode->i_wait);
    return b-buf;
}
Chiar și fără a privi definițiile structurii, se poate înțelege cum contează referințele inode pentru a verifica dacă operația de scriere duce la SIGPIPE. Pe lângă lucrul pe byte, această funcție se poate asocia ușor cu ideile descrise mai sus. Chiar și logica sleep_on/wake_up nu pare atât de străină.
Kernelurile moderne Linux, FreeBSD, NetBSD, OpenBSD
Am parcurs rapid câteva kerneluri moderne. Niciunul dintre ele nu mai are implementări cu utilizarea discului (nu-i de mirare). În Linux există propria implementare. Și deși cele trei kerneluri BSD moderne conțin implementări bazate pe cod scris de John Dyson, de-a lungul anilor acestea au devenit mult prea diferite între ele.
Pentru a citi fs/pipe.c (pe Linux) sau sys/kern/sys_pipe.c (pe *BSD), necesită o adevărată dăruire. Astăzi, în cod, performanța și suportul pentru funcții precum operațiuni de intrare-ieșire vectorizate și asincrone sunt esențiale. Iar detaliile alocării memoriei, blocajului și configurării kernelului - toate acestea variază semnificativ. Acestea nu sunt informații necesare universităților pentru un curs introductiv despre sisteme de operare.
În orice caz, am fost curios să descopăr câteva tipare vechi (de exemplu, generarea SIGPIPE și întoarcerea EPIPE în scrierea într-un tub închis) în toate aceste kerneluri moderne, atât de diferite. Probabil că nu voi vedea niciodată un computer PDP-11, dar există încă multe de învățat din codul scris cu câțiva ani înainte de nașterea mea.
Articolul scris de Divi Kapoor în 2011 „” reprezintă o privire de ansamblu asupra modului în care funcționează (încă) pipe-urile în Linux. Iar ilustrează modelul de interacțiune a pipe-ului, a cărui capacitate depășește cea a fișierelor temporare; de asemenea, arată cât de departe au avansat pipe-urile față de „blocarea foarte conservatoare” din kernelul Unix în cea de-a șasea ediție.
Sursa: habr.com
