

Bună ziua, în articolele anterioare ne-am familiarizat cu funcționarea stack-ului ELK. Acum vom discuta despre posibilitățile pe care un specialist în securitate informațională le poate realiza utilizând aceste sisteme. Ce loguri pot și trebuie să fie arhivate în Elasticsearch? Vom analiza ce statistici pot fi obținute prin configurarea dashboard-urilor și dacă aceasta aduce un beneficiu. Cum putem implementa automatizarea proceselor de securitate informațională folosind stack-ul ELK? Vom elabora arhitectura de funcționare a sistemului. În total, implementarea întregii funcționalități reprezintă o sarcină foarte mare și complexă, de aceea soluția a fost denumită TS Total Sight.
În prezent, soluțiile care consolidează și analizează incidentele de securitate informațională într-un singur loc logic câștigă popularitate. Astfel, specialistul obține statistici și un ghid de acțiune pentru îmbunătățirea stării securității informaționale în organizație. Această sarcină ne-am propus-o în utilizarea stack-ului ELK, rezultând în evidențierea funcționalității principale în 4 secțiuni:
- Statistică și vizualizare;
- Detectarea incidentelor de securitate informațională;
- Prioritizarea incidentelor;
- Automatizarea proceselor de securitate informațională.
În continuare, vom analiza fiecare în detaliu.
Detectarea incidentelor de securitate informațională.
Principala sarcină în utilizarea Elasticsearch în cazul nostru este colectarea exclusiv a incidentelor de securitate informațională. Incidentele de securitate informațională pot fi colectate din orice instrument de protecție, atâta timp cât acestea suportă măcar unele moduri de transmitere a logurilor, standardul fiind syslog sau salvarea în fișiere prin SCP.
Putem oferi exemple standard de instrumente de protecție și nu numai, din care ar trebui să configurăm transmiterea logurilor:
- Orice instrumente NGFW (Check Point, Fortinet);
- Orice scanere de vulnerabilitate (PT Scanner, OpenVas);
- Web Application Firewall (PT AF);
- Analizatori de netflow (Flowmon, Cisco StealthWatch);
- Server AD.
După ce am configurat trimiterea logurilor și fișierele de configurare în Logstash, putem corela și compara incidentele primite de la diversele instrumente de securitate. Pentru aceasta, este convenabil să utilizăm indecși în care vom păstra toate incidentele legate de un anumit dispozitiv. Cu alte cuvinte, un index reprezintă toate incidentele referitoare la un singur dispozitiv. Implementarea unei astfel de distribuții este posibilă în 2 moduri.
Prima variantă Aceasta este configurarea fișierului de configurare Logstash. Pentru aceasta, trebuie să duplici jurnalul pe anumite câmpuri într-o unitate separată cu un alt tip. Apoi, ulterior, folosește acest tip. În exemplu, jurnalele sunt clonate pe blade-ul IPS al firewall-ului Check Point.
filter {
    if [product] == "SmartDefense" {
        clone {
	    clones => ["CloneSmartDefense"]
	    add_field => {"system" => "checkpoint"}
	}
    }
}
Pentru a salva înregistrări separate pentru evenimentele în funcție de câmpurile jurnalului, de exemplu, cum ar fi adresa IP de destinație a semnăturii de atac, poți folosi o structură similară:
output {
    if [type] == "CloneSmartDefense"{
    {
         elasticsearch {
    	 hosts => [",:9200"]
    	 index => "smartdefense-%{dst}"
    	 user => "admin"
    	 password => "password"
  	 }
    }
}
Astfel, se poate realiza salvarea în index a tuturor incidentelor, de exemplu, după adresa IP sau după numele de domeniu al mașinii. În acest caz, salvăm în index «smartdefense-%{dst}», pe adresa IP de semnătură.
Cu toate acestea, diferite produse vor avea câmpuri diferite pentru jurnale, ceea ce va duce la haos și la o utilizare inutilă a memoriei. Aici va trebui fie să schimbi cu atenție câmpurile din configurația Logstash cu cele planificate anterior, care vor fi identice pentru toate tipurile de incidente, ceea ce reprezintă o sarcină complicată.
Al doilea mod de implementare — este scrierea unui script sau a unui proces care va accesa în timp real baza de date Elasticsearch, extrage incidentele necesare și le salvează într-un nou index. Aceasta este o sarcină dificilă, dar permite lucrul cu jurnalele așa cum dorești și corelarea directă cu incidentele din alte instrumente de securitate. Această variantă permite configurarea lucrului cu jurnalele cât mai util pentru cazul tău, cu o flexibilitate maximă, dar ridică problema găsirii unui specialist care să o poată implementa.
Și, desigur, cea mai importantă întrebare, ce poate fi de fapt corelat și descoperit?
Aici pot fi mai multe variante, și depinde de ce instrumente de securitate sunt utilizate în infrastructura ta, câteva exemple:
- Cea mai evidentă și, din punctul meu de vedere, cea mai interesantă opțiune pentru cei care au o soluție NGFW și un scanner de vulnerabilități. Aceasta este compararea jurnalelor IPS cu rezultatele scanării vulnerabilităților. Dacă o atac a fost detectat (nu blocat) de sistemul IPS și această vulnerabilitate nu este închisă pe mașina finală conform rezultatelor scanării, este necesar să anunțăm despre acest lucru, deoarece există o mare probabilitate ca vulnerabilitatea să fi fost exploatată.
- Multe încercări de conectare de pe o mașină în diferite locuri pot simboliza o activitate malițioasă.
- Descărcarea de fișiere virusate de către utilizator în urma vizitării unui număr mare de site-uri potențial periculoase.
Statistici și vizualizare
Cel mai evident și ușor de înțeles motiv pentru care este necesar ELK Stack este stocarea și vizualizarea jurnalelor, s-a arătat cum se pot colecta jurnalele de la diverse dispozitive, folosind Logstash. După ce jurnalele ajung în Elasticsearch, pot fi configurate tablouri de bord, despre care s-a menționat anterior , cu informațiile și statisticile necesare pentru dumneavoastră prin vizualizare.
Exemple:
- Tabloul de bord pentru evenimentele de prevenire a amenințărilor cu cele mai critice evenimente. Aici se pot reflecta ce semnături IPS au fost detectate, din ce locații provin.
- Tabloul de bord pentru utilizarea celor mai critice aplicații, din care informațiile pot fi compromise.
- Rezultatele scanării de la orice scanner de securitate.
- Jurnalele din Active Directory pe utilizatori.
- Tabloul de bord pentru conexiuni VPN.
În acest caz, dacă tablourile de bord sunt configurate să se actualizeze la fiecare câteva secunde, se poate obține un sistem destul de convenabil pentru monitorizarea evenimentelor în timp real, care ulterior poate fi utilizat pentru reacția rapidă la incidentele de securitate, dacă tablourile de bord sunt setate pe un ecran separat.
Prioritizarea incidentelor
În cadrul unei infrastructuri mari, numărul incidentelor poate deveni copleșitor, iar specialiștii nu vor reuși să analizeze toate incidentele la timp. În acest caz, este esențial să se prioritizeze în primul rând acele incidente care reprezintă o amenințare semnificativă. Prin urmare, sistemul ar trebui să prioritizeze incidentele în funcție de pericolul acestora pentru infrastructura dumneavoastră. Este recomandat să se configureze notificări prin e-mail sau Telegram pentru aceste evenimente. Prioritizarea poate fi realizată cu ajutorul funcționalităților standard din Kibana, prin configurarea vizualizărilor. Însă, notificările sunt mai dificile, deoarece, în mod implicit, această funcționalitate nu este inclusă în versiunea de bază a Elasticsearch, ci doar în cea plătită. Așadar, fie achiziționați versiunea plătită, fie va trebui să dezvoltați un proces care să notifice specialiștii în timp real prin e-mail sau Telegram.
Automatizarea proceselor de securitate informațională
Una dintre cele mai interesante componente este automatizarea reacțiilor la incidentele de securitate informațională. Anterior, acest funcțional a fost implementat pentru Splunk; mai multe detalii puteți citi în această . Ideea principală este că politica IPS nu este niciodată verificată și optimizată, deși în anumite cazuri aceasta reprezintă o parte esențială a proceselor de securitate informațională. De exemplu, la un an după implementarea NGFW, fără acțiuni de optimizare a IPS, veți acumula un număr mare de semnături cu acțiunea Detect, care nu vor fi blocate, ceea ce reduce semnificativ nivelul de securitate informațională în organizație. Iată câteva exemple de lucruri care pot fi automatizate:
- Schimbarea semnăturii IPS de la Detect la Prevent. Dacă pentru semnăturile critice nu funcționează Prevent, atunci acest lucru nu este acceptabil și reprezintă o breșă serioasă în sistemul de protecție. Vom schimba acțiunea din politică pentru aceste semnături. Implementarea acestui funcțional poate fi realizată dacă dispozitivul NGFW dispune de funcționalitatea REST API. Acest lucru este posibil doar având abilități de programare, trebuie să extrageți informațiile necesare din Elasticsearch și să efectuați solicitări API la serverul de gestionare NGFW.
- Dacă de la o adresă IP s-au descoperit sau blocat mai multe semnături în traficul de rețea, are sens să se blocheze temporar această adresă IP în politica Firewall. Implementarea constă de asemenea în utilizarea REST API.
- Rulați un scaner de vulnerabilitate pe gazdă atunci când această gazdă are un număr mare de semnături IPS sau alte soluții de securitate. Dacă este vorba despre OpenVas, puteți scrie un script care se va conecta prin SSH la scanerul de securitate și va iniția scanarea.
TS Total Sight
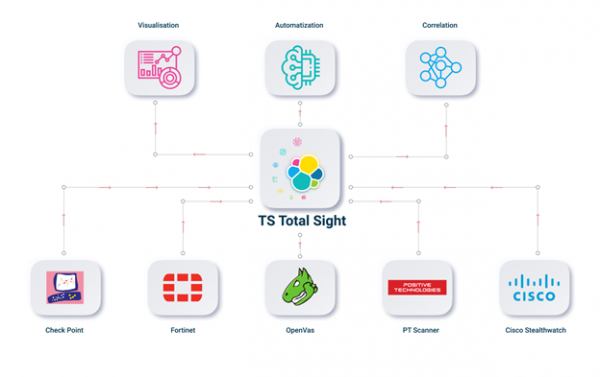
În concluzie, implementarea tuturor funcționalităților reprezintă o sarcină foarte complexă și grea. Fără abilități de programare, este posibil să configurați un minim de funcționalitate care ar putea fi suficient pentru utilizarea în producție. Dar dacă sunteți interesat de toate funcționalitățile, puteți lua în considerare TS Total Sight. Puteți afla mai multe pe site-ul nostru . În rezultat, întreaga schemă de lucru și arhitectura vor arăta în acest mod:
Concluzie
Am discutat despre ce se poate realiza folosind ELK Stack. În articolele viitoare, vom explora mai detaliat funcționalitatea TS Total Sight!
Așadar, urmăriți actualizările (, , , ), .
Sursa: habr.com
