

Profesiile Data Scientist și Data Engineer sunt adesea confundate. Fiecare companie are propria specificitate în lucrul cu datele, obiective diferite pentru analiză și o viziune distinctă asupra rolului fiecărui specialist, ceea ce implică și cerințe diferite.
Hai să analizăm în ce constă diferența dintre acești specialiști, ce probleme de afaceri rezolvă, ce abilități au și cât câștigă. Materialul este extins, așa că l-am împărțit în două publicații.
În prima articol, Elena Gerașimova, șefa facultății „” de la Netology, vorbește despre diferența dintre Data Scientist și Data Engineer și ce instrumente folosesc.
Cum se diferențiază rolurile inginerilor și ale scientistilor
Inginerul de date este un specialist care, pe de o parte, dezvoltă, testează și întreține infrastructura de lucru cu date: baze de date, stocări și sisteme de procesare în masă. Pe de altă parte, este cel care curăță și „aranjează” datele pentru utilizarea de către analiști și data scientists, adică creează conducte de procesare a datelor.
Data Scientist creează și antrenează modele predictive (dar nu numai) prin utilizarea algoritmilor de învățare automată și rețele neuronale, ajutând afacerile să descopere modele ascunse, să prognozeze evoluția evenimentelor și să optimizeze procesele de afaceri cheie.
Principala diferență dintre Data Scientist și Data Engineer constă în faptul că, de obicei, au obiective diferite. Amândoi lucrează pentru a asigura accesibilitatea și calitatea datelor. Dar Data Scientist găsește răspunsuri la întrebările sale și verifică ipoteze în ecosistemul de date (de exemplu, pe baza Hadoop), în timp ce Data Engineer creează un pipeline care susține algoritmul de învățare automată scris de data scientist într-un cluster Spark în cadrul aceluiași ecosistem.
Inginerul de date aduce valoare afacerii, lucrând în echipă. Sarcina sa este să fie un link important între diferiți participanți: de la dezvoltatori la consumatorii de rapoarte de afaceri, și să îmbunătățească productivitatea analiștilor — de la marketing și produs la BI.
Data Scientist, în schimb, participă activ la strategia companiei, la extragerea de insight-uri, la luarea deciziilor, la implementarea algoritmilor de automatizare, modelare și generarea de valoare din date.
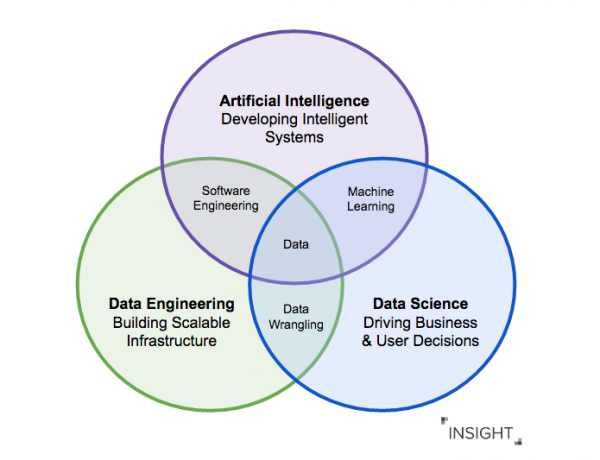
Lucrul cu datele se supune principiului GIGO (garbage in — garbage out): dacă analiștii și data scientist-ii se confruntă cu date neprelucrate și potențial incorecte, rezultatele, chiar și cu cele mai sofisticate algoritmi de analiză, vor fi greșite.
Inginerii de date rezolvă această problemă construind pipeline-uri pentru prelucrarea, curățarea și transformarea datelor, permițând data scientist-ului să lucreze deja cu date de calitate.
Pe piață există multe instrumente pentru lucrul cu datele, care acoperă fiecare etapă: de la apariția datelor până la prezentarea pe un dashboard pentru consiliul de administrație. Este important ca decizia de utilizare a acestora să fie luată de inginer, — nu pentru că este la modă, ci pentru că cu adevărat va ajuta ceilalți participanți la proces.
Într-un mod simplificat: dacă compania trebuie să integreze BI cu ETL — încărcarea datelor și actualizările rapoartelor, iată o fundație legacy tipică cu care se va confrunta un Inginer de Date (bine, dacă în echipă va fi și un arhitect).
Responsabilitățile Inginerului de Date
- Dezvoltarea, construirea și întreținerea infrastructurii pentru gestionarea datelor.
- Gestionarea erorilor și crearea de pipeline-uri de prelucrare a datelor fiabile.
- Transformarea datelor nestructurate din diverse surse dinamice într-un format necesar pentru analiști.
- Oferirea de recomandări pentru îmbunătățirea consistenței și calității datelor.
- Asigurarea și întreținerea arhitecturii datelor utilizate de data scientist-ii și analiștii de date.
- Prelucrarea și stocarea datelor într-un mod secvențial și eficient într-cluster distribuit format din zeci sau sute de servere.
- Evaluarea compromisurilor tehnice ale instrumentelor pentru crearea unor arhitecturi simple, dar fiabile, capabile să reziste la defecțiuni.
- Monitorizarea și întreținerea fluxurilor de date și a sistemelor asociate (configurarea monitorizării și alertelor).
Există o altă specializare în cadrul traseului Inginerului de Date — inginerul ML. În termeni simpli, acești ingineri se specializează în implementarea modelelor de învățare automată pentru utilizarea în mediu comercial. Adesea, modelul provenit de la data scientist este parte a unei cercetări și poate să nu funcționeze în condiții reale.
Responsabilitățile Data Scientist-ului
- Extracția caracteristicilor din date pentru aplicarea algoritmilor de învățare automată.
- Utilizarea diverselor instrumente de învățare automată pentru a prezice și clasifica modele în date.
- Îmbunătățirea performanței și preciziei algoritmilor de învățare automată prin ajustarea fină și optimizarea acestora.
- Formarea de ipoteze „puternice” conforme cu strategia companiei, care trebuie verificate.
Atât Data Engineer, cât și Data Scientist contribuie semnificativ la dezvoltarea culturii de lucru cu datele, ceea ce permite companiei să obțină profituri suplimentare sau să reducă costurile.
Cu ce limbaje și instrumente lucrează inginerii și oamenii de știință?
Astăzi așteptările de la specialiștii în prelucrarea datelor s-au schimbat. În trecut, inginerii scriau interogări SQL mari, scriau manual MapReduce și procesau datele cu ajutorul unor instrumente precum Informatica ETL, Pentaho ETL, Talend.
În 2020, un specialist nu poate să se descurce fără cunoștințe de Python și instrumente moderne de calcul (de exemplu, Airflow), precum și fără înțelegerea principiilor de funcționare a platformelor cloud (utilizarea acestora pentru economisirea costurilor la „hardware”, respectând principiile de securitate).
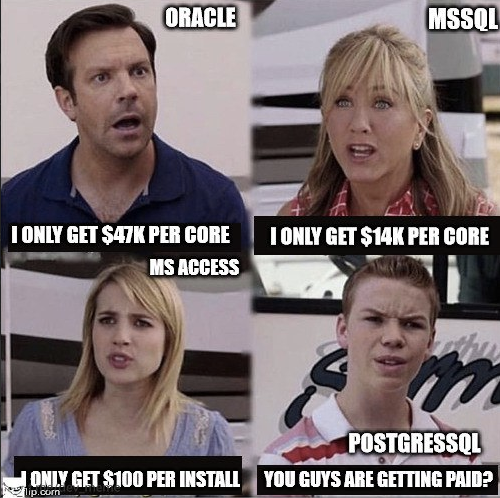
SAP, Oracle, MySQL, Redis sunt instrumente tradiționale pentru inginerii de date în companii mari. Acestea sunt bune, dar costul licențelor este atât de ridicat încât este logic să înveți să lucrezi cu ele doar în proiecte industriale. Totuși, există o alternativă gratuită sub formă de Postgres – este gratuit și potrivit nu doar pentru învățare.
Istoric, cererea pentru Java și Scala a fost frecventă, deși pe măsură ce tehnologiile și abordările evoluează, aceste limbaje sunt lăsate pe plan secund.
Cu toate acestea, Big Data hardcore: Hadoop, Spark și restul parcului de instrumente nu mai sunt o cerință obligatorie pentru inginerii de date, ci o varietate de instrumente pentru rezolvarea problemelor ce nu pot fi soluționate prin ETL tradițional.
În trend sunt serviciile care permit utilizarea instrumentelor fără a cunoaște limbajul în care sunt scrise (de exemplu, Hadoop fără cunoștințe de Java), precum și furnizarea de servicii gata făcute pentru procesarea datelor în flux (recunoașterea vocii sau imaginilor în videoclipuri).
Soluțiile industriale de la SAS și SPSS sunt populare, iar Tableau, Rapidminer, Stata și Julia sunt, de asemenea, folosite pe scară largă de data scientist pentru sarcini locale.
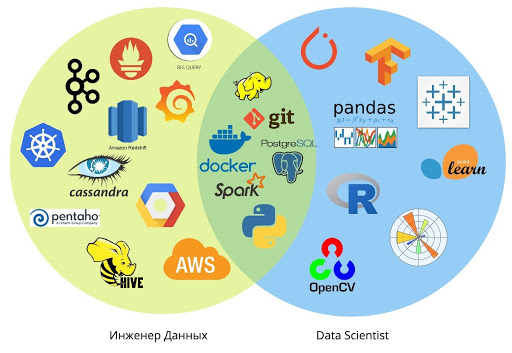
Posibilitatea de a construi singuri pipeline-uri a apărut pentru analiști și data scientist doar în urmă cu câțiva ani: de exemplu, acum este posibil să direcționezi datele către un stocare bazată pe PostgreSQL cu scripturi relativ simple.
De obicei, utilizarea canalelor și a structurilor de date integrate rămâne în responsabilitatea inginerilor de date. Dar astăzi, mai mult ca niciodată, tendința specialiștilor în T - cu competențe largi în domenii adiacente - este puternică, deoarece instrumentele devin constant mai simple.
De ce trebuie să colaboreze Data Engineer și Data Scientist
Colaborând strâns cu inginerii, Data Scientist pot să se concentreze pe partea de cercetare, creând algoritmi de învățare automată gata de utilizare.
În același timp, inginerii se pot concentra pe scalabilitate, reutilizarea datelor și asigurarea că pipeline-urile de intrare și ieșire a datelor în fiecare proiect respectiv se conformează arhitecturii globale.
Această împărțire a responsabilităților asigură coerența acțiunilor între grupurile de specialiști care lucrează la diferite proiecte de învățare automată.
Cooperarea ajută la crearea eficientă a unor produse noi. Viteza și calitatea sunt realizate printr-un echilibru între crearea unui serviciu pentru toți (stocare globală sau integrarea tablourilor de bord) și implementarea fiecărei nevoi sau proiecte specifice (pipeline specializat, conectarea la surse externe).
Lucrul îndeaproape cu data scientist și analiști ajută inginerii să își dezvolte abilitățile analitice și de cercetare pentru a scrie cod de o calitate mai bună. Se îmbunătățește schimbul de cunoștințe între utilizatorii de stocare și lacuri de date, ceea ce face proiectele mai flexibile și asigură rezultate mai durabile pe termen lung.
În companiile care își propun să dezvolte o cultură a muncii cu datele și să construiască procesele de afaceri pe baza acestora, Data Scientist și Data Engineer se completează reciproc și creează un sistem complet de analiză a datelor.
În materialul următor, vom discuta despre ce educație ar trebui să aibă Data Engineer și Data Scientist, ce abilități trebuie să dezvolte și cum este structurat piața.
De la redacția Netology
Dacă sunteți interesat de profesia de Data Engineer sau Data Scientist, vă invităm să explorați programele cursurilor noastre:
- Profesia „».
- Profesia „».
Sursa: habr.com
