

Salut tuturor, numele meu este Alexander și sunt inginer în calitatea datelor, ocupându-mă cu verificarea calității datelor. În acest articol voi vorbi despre cum am ajuns aici și de ce, în 2020, această direcție de testare s-a dovedit a fi pe val.
Tendința globală
Lumea de astăzi trăiește o nouă revoluție tehnologică, unul dintre aspectele căreia este utilizarea de către diverse companii a datelor acumulate pentru a-și impulsiona vânzările, profiturile și imaginea publică. Se pare că dispunerea de date de calitate și de minți capabile să transforme aceste date în bani (prin procesare corectă, vizualizare, construirea de modele de învățare automată etc.) a devenit cheia succesului pentru multe dintre acestea. Dacă acum 15-20 de ani, lucrul intens cu acumularea și monetizarea datelor era apanajul în principal al companiilor mari, astăzi aceasta este o preocupare comună pentru aproape toți cei care gândesc rațional.
În acest context, acum câțiva ani, toate portalurile dedicate căutării de locuri de muncă din întreaga lume au fost inundate cu anunțuri pentru Data Scientists, deoarece toată lumea era convinsă că, angajând un astfel de specialist, se poate construi un supermodel de învățare automată, prezicând viitorul și realizând un 'salt cuantic' pentru companie. Cu timpul, oamenii au înțeles că această abordare funcționează foarte rar, deoarece nu toate datele care ajung în mâinile acestor specialiști sunt adecvate pentru antrenarea modelelor.
Și au început solicitările din partea Data Scientists: „Să cumpărăm mai multe date de la aceștia și de la aceia...”, „Ne lipsesc date...”, „Avem nevoie de și mai multe date, ideal de calitate...”. Pe baza acestor cereri, au început să se existențeze numeroase interacțiuni între companiile care dețin diverse seturi de date. Evident, aceasta a necesitat o organizare tehnică a procesului — conectarea la sursa de date, extragerea acestora, verificarea că au fost încărcate complet și așa mai departe. Numărul acestor procese a început să crească, iar astăzi avem o nevoie imensă de un alt tip de specialiști — ingineri în calitatea datelor — cei care să supravegheze fluxul de date din sistem (data pipelines), calitatea datelor la intrare și ieșire, să tragă concluzii cu privire la suficiența, integritatea și alte caracteristici ale acestora.
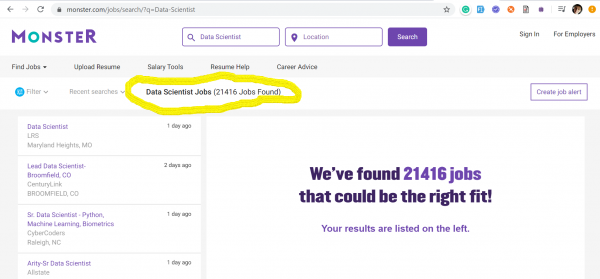
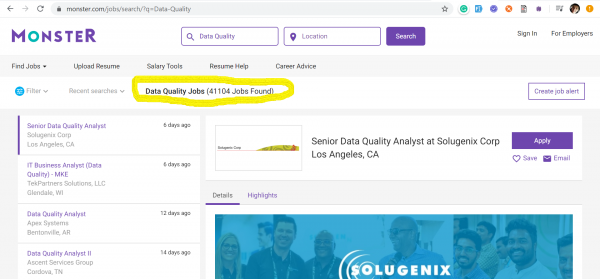
Trendul inginerilor de Data Quality a venit la noi din SUA, unde, în plina eră a capitalismului, nimeni nu este dispus să piardă bătălia pentru date. Mai jos am inclus capturi de ecran de pe două dintre cele mai populare site-uri de căutare a locurilor de muncă din SUA: și — pe care sunt afișate datele la 17 martie 2020 despre numărul locurilor de muncă publicate, obținute folosind cuvintele cheie: Data Quality și Data Scientist.
Data Scientists – 21416 locuri de muncă
Data Quality – 41104 locuri de muncă
Data Scientists – 404 locuri de muncă
Data Quality – 2020 locuri de muncă
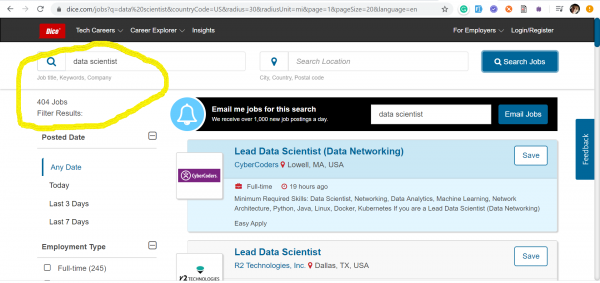
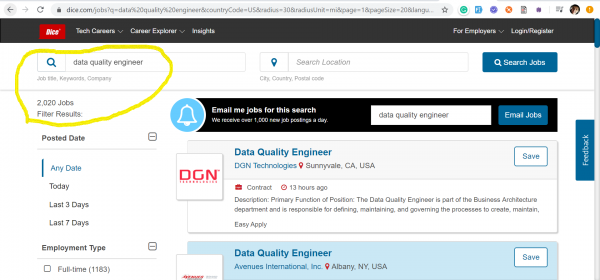
Este evident că aceste profesii nu concurent între ele. Capturile de ecran le-am folosit doar pentru a ilustra situația actuală pe piața muncii în ceea ce privește cererea pentru inginerii de Data Quality, care sunt acum solicitați mult mai mult decât Data Scientists.
În iunie 2019, EPAM, răspunzând nevoilor pieței IT moderne, a înființat Data Quality ca o practică separată. Inginerii de Data Quality, în cadrul activității lor zilnice, gestionează datele, verifică comportamentul acestora în condiții și sisteme noi, monitorizează relevanța, suficiența și actualitatea datelor. În același timp, în practică, inginerii de Data Quality dedică într-adevăr puțin timp testării funcționale clasice, DAR asta depinde foarte mult de proiect (exemplul îl voi oferi mai departe).
Responsabilitățile inginerului de Data Quality nu se limitează doar la verificări manuale/automate de rutină pentru „nulls, count și sums” în tabelele DB, ci necesită o înțelegere profundă a nevoilor de afaceri ale clientului și, în consecință, capacitatea de a transforma datele disponibile în informații de afaceri utile.
Teoria Data Quality
Pentru a înțelege pe deplin rolul unui astfel de inginer, haideți să analizăm ce reprezintă Data Quality în teorie.
Data Quality — este unul dintre pașii din Data Management (o lume întreagă, pe care o vom lăsa pentru studiu individual) și răspunde de analiza datelor după următoarele criterii:
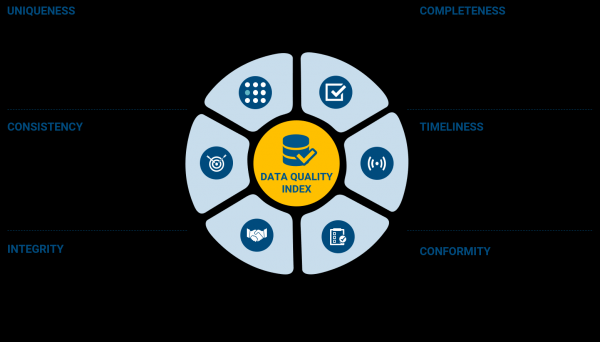
Cred că nu are sens să explic fiecare dintre punctele (teoretic denumite „dimensiuni de date”), ele sunt descrise destul de bine în imagine. Totuși, procesul de testare nu implică copierea strictă a acestor atribute în cazurile de testare și verificarea lor. În Calitatea Datelor, ca și în orice alt tip de testare, trebuie să ne bazăm mai întâi pe cerințele de calitate a datelor, convenite cu participanții la proiect, care iau decizii de afaceri.
În funcție de proiect, un inginer de Calitate a Datelor poate îndeplini diferite funcții: de la un simplu testator automatizat cu o evaluare superficială a calității datelor, până la o persoană care realizează profilarea lor detaliată pe baza caracteristicilor menționate mai sus.
O descriere foarte detaliată a proceselor de Management al Datelor, Calitate a Datelor și domenii conexe este excelent prezentată în cartea intitulată „DAMA-DMBOK: Data Management Body of Knowledge: 2nd Edition”. Recomand cu căldură această carte ca o introducere în acest domeniu (linkul către ea îl veți găsi la sfârșitul articolului).
Povestea mea
În industria IT, am parcurs un drum de la Junior tester în companii de produse până la Lead Data Quality Engineer în compania EPAM. După aproximativ doi ani de muncă ca tester, eram ferm convins că am realizat absolut toate tipurile de testare: regresivă, funcțională, de stres, de stabilitate, de securitate, UI etc. — și am experimentat o mulțime de instrumente de testare, lucrând totodată în trei limbaje de programare: Java, Scala, Python.
Privind înapoi, înțeleg de ce setul meu de abilități profesionale a fost atât de divers — am participat la proiecte legate de manipularea datelor, mari și mici. Acest lucru m-a adus într-o lume plină de instrumente și oportunități de creștere.
Pentru a aprecia diversitatea instrumentelor și posibilitățile de a obține noi cunoștințe și abilități, este suficient să ne uităm la imaginea de mai jos, care prezintă cele mai populare dintre ele în domeniul „Date și AI”.
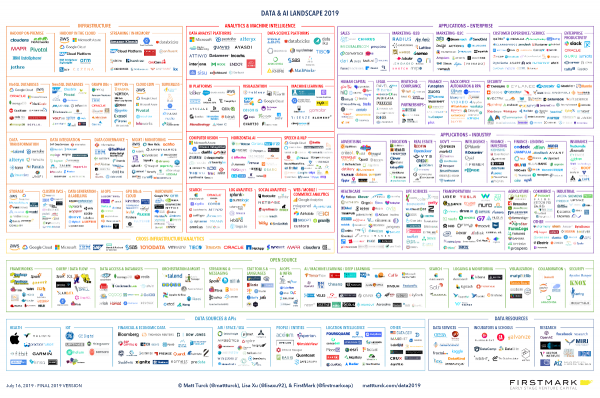
Astfel de ilustrații sunt realizate anual de către unul dintre cunoscuții investitori de capital de risc, Matt Turck, venit din domeniul dezvoltării de software. Iată blogul său și , unde lucrează ca partener.
Am crescut profesional extrem de rapid atunci când am fost singurul tester al proiectului, sau cel puțin în primele etape ale acestuia. Într-un astfel de moment, trebuie să răspunzi de întregul proces de testare, iar opțiunea de a te retrage nu există, trebuie să mergi înainte. La început, acest lucru era înfricoșător, dar acum îmi sunt evidente toate avantajele acestei experiențe:
- Începi să comunici cu întreaga echipă cum nu ai făcut-o niciodată, deoarece nu există un intermediar pentru comunicare: nici manager de teste, nici colegi testeri.
- Imersiunea în proiect devine incredibil de profundă, iar tu deții informații despre toate componentele atât în general, cât și în detaliu.
- Dezvoltatorii nu te privesc ca pe «tipul din testare care face ceva neclar», ci mai degrabă ca pe un egal, care aduce o valoare incredibilă echipei prin testele sale automate și previziunea apariției bug-urilor în anumite părți ale produsului.
- Ca rezultat — ești mai eficient, mai calificat, mai căutat.
Pe măsură ce proiectul se dezvolta, în 100% din cazuri deveneam mentor pentru noii testeri care se alăturau, îi învățam și le ofeream cunoștințele pe care le acumulasem. Totuși, în funcție de proiect, nu primeam întotdeauna resurse de înaltă calitate pentru automatizarea testării și era necesar fie să îi învăț automatizarea (pentru cei interesați), fie să creez instrumente pentru utilizarea acestora în activitățile lor zilnice (instrumente de generare a datelor și încărcarea acestora în sistem, instrument pentru testare de stres/testare a stabilității „pe rapid” etc.).
Exemplu de proiect concret
Din păcate, din cauza obligațiilor de confidențialitate, nu pot oferi detalii despre proiectele la care am lucrat, totuși voi da exemple de sarcini tipice pentru un Data Quality Engineer într-unul din proiecte.
Scopul proiectului era să implementăm o platformă pentru pregătirea datelor folosite în antrenarea modelelor de învățare automată. Clientul era o mare companie farmaceutică din SUA. Tehnic, acesta era un cluster , ridicat pe instanțe, cu mai multe microservicii și bazat pe proiectul Open Source al companiei EPAM — , adaptat nevoilor specifice ale clientului (în prezent, proiectul a fost transformat în ). Procesele ETL au fost organizate cu ajutorul și au mutat datele din sistemul clientului în Buckets. Apoi, pe platformă a fost depus un container Docker al modelului de învățare automată, care a fost antrenat pe date recente și prin intermediul interfeței API REST a furnizat predicții relevante pentru afacere și care rezolvă sarcini concrete.
Vizual, totul arăta cam așa:
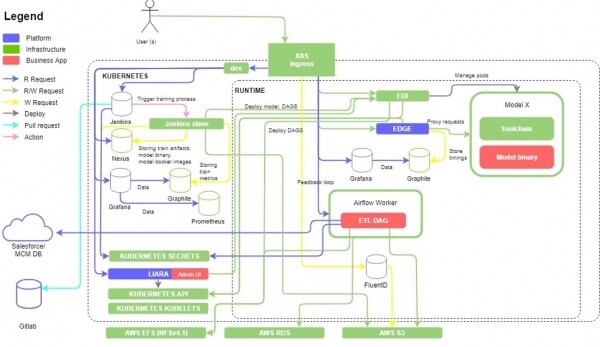
Testarea funcțională a acestui proiect a fost abundentă, având în vedere viteza de dezvoltare a funcționalităților și necesitatea de a menține rapiditatea ciclului de lansare (sprinturi de două săptămâni), a fost esențial să ne gândim din timp la automatizarea testării celor mai critici noduri ale sistemului. O mare parte din platformă, bazată pe Kubernetes, era acoperită de teste automate, implementate pe + Python, dar era necesar să le menținem și să le extindem. În plus, pentru confortul clientului, a fost creat un GUI pentru gestionarea modelelor de învățare automată, desfășurate pe cluster, precum și posibilitatea de a specifica de unde și unde trebuie mutate datele pentru antrenarea modelelor. Această extensie amplă a dus la extinderea verificărilor funcționale automatizate, care au fost realizate în mare parte prin apeluri API REST și un număr mic de teste UI end-to-end. Aproximativ la mijlocul acestui proces, s-a alăturat un tester manual care s-a descurcat excelent cu testarea de acceptare a versiunilor produsului și cu comunicarea cu clientul în legătură cu acceptarea noului release. În plus, datorită apariției noului specialist, am reușit să documentăm munca noastră și să adăugăm câteva verificări manuale foarte importante, care au fost greu de automatizat imediat.
Și, în sfârșit, după ce am obținut stabilitate de la platformă și un GUI construit pe aceasta, am început să construim pipelines ETL folosind Apache Airflow DAG-uri. Verificarea automatizată a calității datelor a fost realizată prin scrierea unor DAG-uri Airflow speciale care verificau datele în funcție de rezultatele procesului ETL. În cadrul acestui proiect am avut noroc, iar clientul ne-a oferit acces la seturi de date anonimizate, pe care am efectuat testele. Am verificat datele, linie cu linie, pentru conformitatea cu tipurile, existența datelor corupte, numărul total de înregistrări înainte și după, compararea transformărilor efectuate de procesul ETL în ceea ce privește agregarea, schimbarea denumirilor coloanelor și altele. În plus, aceste verificări au fost amplificate pe diferite surse de date, de exemplu, pe lângă Salesforce și pe MySQL.
Verificările calității finale a datelor au fost efectuate deja la nivelul S3, unde acestea erau stocate și erau în stare ready-to-use pentru antrenarea modelelor de învățare automată. Pentru a obține datele din fișierul CSV final, aflat pe S3 Bucket, și pentru validarea acestora, a fost scris un cod folosind .
De asemenea, din partea clientului a fost o cerință de a stoca o parte din date într-un S3 Bucket și o altă parte în altul. Pentru aceasta, a fost necesar să scriem verificări suplimentare care să controleze validitatea unei astfel de sortări.
Experiența generalizată din alte proiecte
Exemplul celei mai generalizate liste de activități ale unui inginer de calitate a datelor:
- Pregătirea datelor de test (valide/nevalide, mari/mici) printr-un instrument automatizat.
- Încărcarea setului de date pregătit în sursa inițială și verificarea pregătirii acestuia pentru utilizare.
- Lansarea proceselor ETL pentru procesarea setului de date din depozitul inițial în cel final sau intermediar, folosind un anumit set de configurații (în cazul în care este posibil să stabiliți parametrii configurabili pentru sarcina ETL).
- Verificarea datelor procesate de procesul ETL pentru calitatea și conformitatea lor cu cerințele de business.
Accentuarea verificărilor ar trebui să nu se concentreze doar pe faptul că fluxul de date în sistem a funcționat în general și a ajuns la final (ceea ce face parte din testarea funcțională), ci, mai ales, pe verificarea și validarea datelor pentru a se asigura că acestea corespund cerințelor așteptate, identificând anomalii și altele.
Instrumente
Una dintre tehnicile de control al datelor poate fi organizarea de verificări în lanț la fiecare etapă a procesării datelor, așa cum se numește în literatură „data chain” — controlul datelor de la sursă până la punctul final de utilizare. Astfel de verificări sunt, de obicei, implementate prin scrierea de interogări SQL de verificare. Este evident că aceste interogări trebuie să fie cât mai ușoare și să verifice bucăți separate de calitate a datelor (metadatele tabelelor, linii goale, NULL-uri, erori de sintaxă — alte atribute cerute de verificare).
În cazul testării de regresie, unde se folosesc seturi de date gata pregătite (nemodificabile sau modificate nesemnificativ), în codul testelor automate pot fi stocate deja șabloane pentru verificarea datelor în conformitate cu calitatea (descrieri ale metadatelor așteptate ale tabelelor; obiecte de selecție ale liniilor care pot fi selectate aleatoriu în timpul testului și altele).
De asemenea, în timpul testării este necesar să se scrie procese ETL de testare, folosind cadre precum Apache Airflow, sau complet instrumente black-box de tip cloud, cum ar fi , și altele. Această circumstanță obligă inginerul de teste să se familiarizeze cu principiile de funcționare ale instrumentelor menționate mai sus și să efectueze testarea funcțională mai eficient (de exemplu, a proceselor ETL existente în proiect), precum și să le folosească pentru verificarea datelor. În special, pentru Apache Airflow există deja operatori gata pregătiți pentru a lucra cu baze de date analitice populare, cum ar fi . Cel mai simplu exemplu al utilizării sale a fost deja prezentat , așa că nu voi repeta.
Pe lângă soluțiile gata pregătite, nimeni nu vă interzice să implementați propriile tehnici și instrumente. Acest lucru nu va aduce doar beneficii proiectului, ci și inginerului de calitate a datelor, care astfel își va îmbunătăți orizontul tehnic și abilitățile de programare.
Cum funcționează acest lucru într-un proiect real
O ilustrare bună a ultimelor paragrafe despre „data chain”, ETL și verificările omniprezente este următorul proces din unul dintre proiectele reale:
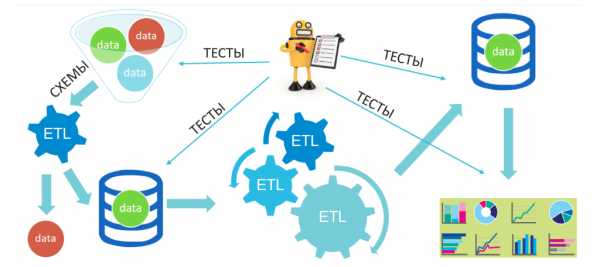
Aici, în «funnel»-ul de intrare al sistemului nostru ajung diferite date (bineînțeles, pregătite de noi): valide, invalide, mixte etc., apoi acestea sunt filtrate și ajung într-un depozit intermediar, după care urmează o nouă serie de transformări și se vor plasa în depozitul final, din care, la rândul său, se va realiza analiza, construirea vitrinelor de date și căutarea insight-urilor de business. Într-un astfel de sistem, fără a verifica funcționalitatea proceselor ETL, ne concentrăm pe calitatea datelor înainte și după transformări, precum și pe ieșirea în analiză.
Rezumând cele spuse anterior, indiferent de locurile în care am lucrat, am fost implicat în proiecte de Data care au avut următoarele trăsături:
- Numai prin automatizare se pot verifica anumite cazuri și atinge un ciclu de lansare acceptabil pentru afaceri.
- Testerul într-un astfel de proiect este unul dintre cei mai respectați membri ai echipei, deoarece aduce o valoare enormă fiecărui participant (accelerarea testării, date bune pentru Data Scientist, identificarea defectelor în etapele timpurii).
- Nu contează dacă lucrezi pe propria ta echipă sau în cloud - toate resursele sunt abstractizate într-un cluster de tip Hortonworks, Cloudera, Mesos, Kubernetes etc.
- Proiectele sunt construite pe un model de microservicii, predominând calculul distribuit și paralel.
Voi sublinia că, implicându-mă în testarea calității datelor, specialistul în testare își mută accentul profesional pe codul produsului și instrumentele utilizate.
Trăsăturile distinctive ale testării calității datelor
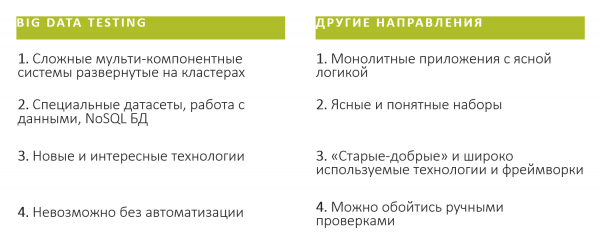
În plus, pentru mine, am identificat următoarele (imediat menționez FOARTE generalizate și exclusiv subiective) trăsături distinctive ale testării în proiectele de Data (Big Data) și alte domenii:
Linkuri utile
- Teorie: .
- EPAM
- Materiale recomandate pentru un inginer în calitatea datelor la început de drum:
- Curs gratuit pe Stepik: .
- Curs pe LinkedIn Learning: .
- Articole:
- ;
- ;
- ;
- Video:
- ;
- ;
Concluzie
Data Quality — este un domeniu foarte tânăr și promițător, a cărui apartenență înseamnă a fi parte dintr-un start-up. Intrați în domeniul Calității Datelor și vă veți scufunda într-o multitudine de tehnologii moderne foarte căutate, dar cel mai important — înaintea dumneavoastră se vor deschide oportunități enorme pentru generarea și implementarea propriilor idei. Veți putea aplica o abordare de îmbunătățire continuă nu doar în proiect, ci și pentru propria dezvoltare ca specialist.
Sursa: habr.com
