

Nota traducătorului.: această poveste instructivă a Omio — aggregatorul de călătorii din Europa — îndrumă cititorii de la teoria de bază la subtilități captivante în configurarea Kubernetes. Familiarizarea cu astfel de cazuri nu doar lărgește orizonturile, ci ajută și la prevenirea problemelor netriviale.
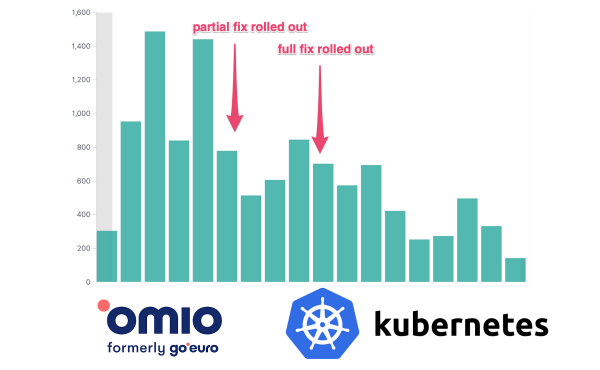
Ați avut vreodată probleme cu aplicația care "se blochează", încetând să răspundă la cererile de verificare a stării (health check-uri) și nu reușeați să înțelegeți cauza acestui comportament? O posibilă explicație este legată de limita cota pe resursele CPU. Despre aceasta va fi vorba în acest articol.
TL;DR:
Recomandăm cu tărie să renunțați la limitările CPU în Kubernetes (sau să dezactivați cotele CFS în Kubelet), dacă folosiți o versiune a nucleului Linux care are o eroare în cotele CFS. În nucleu o eroare gravă și care duce la throttling excesiv și întârzieri.
La Omio întreaga infrastructură este gestionată de Kubernetes. Toate sarcinile noastre stateful și stateless funcționează exclusiv pe Kubernetes (folosim Google Kubernetes Engine). În ultimele șase luni, am început să observăm întârzieri aleatorii. Aplicațiile se blochează sau încetează să răspundă la health check-uri, pierd conectivitatea la rețea etc. Un astfel de comportament ne-a pus în dificultate de mult timp, și, în fine, am decis să ne ocupăm de problemă.
Rezumatul articolului:
- Câteva cuvinte despre containere și Kubernetes;
- Cum sunt implementate cererile și limitările CPU;
- Cum funcționează limitarea CPU în medii cu mai multe nuclee;
- Cum să monitorizăm throttlingul CPU;
- Soluția problemei și nuanțele.
Câteva cuvinte despre containere și Kubernetes
Kubernetes este, în esență, standardul modern în lumea infrastructurii. Sarcina sa principală este orchestrarea containerelor.
Containere
În trecut, era necesar să creăm artefacte precum Java JAR-uri/WAR-uri, Python Egg-uri sau fișiere executabile pentru a fi rulate pe servere. Totuși, pentru a le face să funcționeze, trebuia să depunem eforturi suplimentare: să instalăm mediul de execuție (Java/Python), să plasăm fișierele necesare în locurile potrivite, să ne asigurăm de compatibilitatea cu o anumită versiune de sistem de operare etc. Cu alte cuvinte, trebuia să acordăm o atenție deosebită gestionării configurațiilor (ceea ce adesea era motivul neînțelegerilor între dezvoltatori și administratori de sistem).
Containerele au schimbat totul. Acum, artefactul este o imagine de container. Poate fi văzut ca un fel de fișier executabil extins, care conține nu doar programul, ci și un mediu de execuție complet (Java/Python/…) și fișiere/pachete necesare, preinstalate și gata de rulat. Containerele pot fi desfășurate și rulate pe diverse servere fără alte acțiuni suplimentare.
În plus, containerele funcționează într-un mediu sandbox propriu. Au propriul adaptator de rețea virtual, sistem de fișiere cu acces restricționat, propria ierarhie de procese, limitări pe CPU și memorie etc. Toate acestea sunt realizate datorită unei subsisteme speciale din kernelul Linux — namespaces (spații de nume).
Kubernetes
Așa cum s-a menționat mai devreme, Kubernetes este un orchestrator de containere. Funcționează în felul următor: îi oferiți un grup de mașini și apoi spuneți: „Hei, Kubernetes, rulează zece instanțe ale containerului meu cu 2 procesoare și 3 GB de RAM fiecare și menține-le funcționale!”. Kubernetes se va ocupa de restul. Va găsi resursele disponibile, va lansa containerele și le va reporni când este necesar, va rula upgrade-uri la schimbarea versiunilor etc. Practic, Kubernetes permite abstraherea de componenta hardware și face ca diversitatea sistemelor să fie potrivită pentru desfășurarea și funcționarea aplicațiilor.
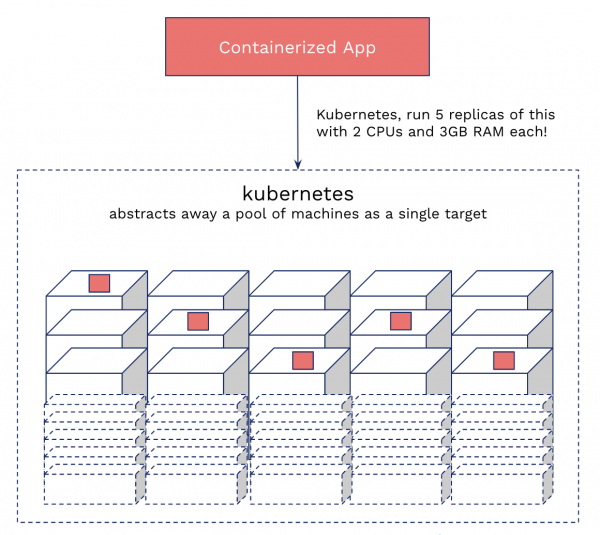
Kubernetes din perspectiva unui simplu cetățean
Ce sunt request-urile și limit-urile în Kubernetes
Bun, am înțeles containerele și Kubernetes. De asemenea, știm că mai multe containere pot fi rulate pe aceeași mașină.
Se poate face o analogie cu o garsonieră. Se ia o încăpere spațioasă (mașini/noduri) și se închiriază mai multor chiriași (containere). Kubernetes joacă rolul agentului imobiliar. Se naște întrebarea, cum putem preveni conflictele între chiriași? Ce se întâmplă dacă unul dintre ei, să zicem, decide să ocupe baia timp de o jumătate de zi?
Exact aici intervin request-urile și limitările. CPU Request este necesar exclusiv pentru planificare. Este ca un «lista de dorințe» a containerului, folosit pentru a găsi nodul cel mai potrivit. În același timp, CPU Limit poate fi comparat cu un contract de închiriere - de îndată ce găsim un nod pentru container, acesta nu va putea depăși limitele stabilite. Și aici apare problema…
Cum sunt implementate request-urile și limitările în Kubernetes?
Kubernetes utilizează un mecanism de throttling încorporat în kernel pentru a implementa limitele CPU. Dacă aplicația depășește limita, se activează throttling (adică primește un număr mai mic de tacți CPU). Request-urile și limitările pentru memorie sunt organizate diferit, astfel încât sunt mai ușor de detectat. Este suficient să verifici ultima stare de repornire a pod-ului: nu este «OOMKilled». Cu throttling-ul CPU lucrurile nu sunt atât de simple, deoarece K8s face disponibile doar metrici de utilizare, nu și de cgroups.
CPU Request
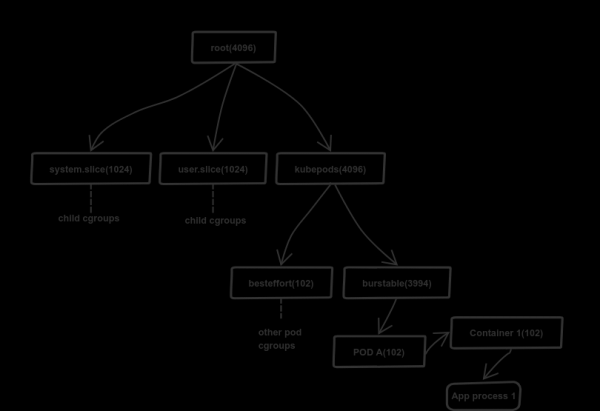
Cum este implementat CPU request
Pentru simplitate, să luăm ca exemplu un proces pe o mașină cu un CPU cu 4 nuclee.
K8s utilizează mecanismul de grupuri de control (cgroups) pentru a gestiona distribuția resurselor (memorie și procesor). Acesta dispune de un model ierarhic: un urmaș moștenește limitările grupului părinte. Detaliile distribuției sunt stocate în sistemul de fișiere virtual (/sys/fs/cgroup). În cazul procesorului, aceasta este /sys/fs/cgroup/cpu,cpuacct/*.
K8s utilizează fișierul cpu.share pentru a distribui resursele procesorului. În cazul nostru, grupul de control rădăcină primește 4096 de părți din resursele CPU — 100% din capacitatea totală a procesorului (1 nucleu = 1024; aceasta este o valoare fixă). Grupul rădăcină distribuie resursele proporțional în funcție de părțile urmașilor, specificate în cpu.share, aceștia, la rândul lor, procedează similar cu urmașii lor etc. Într-un nod tipic Kubernetes, grupul de control rădăcină are trei urmași: system.slice, user.slice și kubepods. Primile două subgrupuri sunt utilizate pentru a distribui resurse între sarcinile de sistem critic și aplicațiile utilizatorilor în afara K8s. Ultimul — kubepods — este creat de Kubernetes pentru a distribui resurse între pod-uri.
În schema de mai sus, se observă că prima și a doua subgrupă au primit câte 1024 parți, iar subgrupa kuberpod a primit 4096 părți. Cum este posibil asta: având în vedere că grupului rădăcină îi sunt disponibile doar 4096 părți, iar suma părților descendenților săi depășește semnificativ acest număr (6144)? Problema este că acest lucru are sens logic, prin urmare, programatorul Linux (CFS) îl utilizează pentru a distribui proporțional resursele CPU. În cazul nostru, primele două grupuri primesc câte 680 părți reale (16,6% din 4096), iar kubepod primește restul de 2736 părți. În cazul de inactivitate, primele două grupuri nu vor utiliza resursele alocate.
Din fericire, în programator există un mecanism care ajută la evitarea pierderii resurselor CPU neutilizate. Acesta transferă puterea 'inactivă' în un fond global, din care acestea sunt redistribuite către grupurile care necesită capacități suplimentare de procesor (trasferul se face pe loturi pentru a evita pierderile din rotunjire). O metodă similară este aplicată tuturor descendenților.
Acest mecanism asigură o distribuție echitabilă a capacităților procesorului și se asigură că niciun proces nu 'fura' resurse de la altele.
Limită CPU
Deși configurațiile limitelor și cererilor în K8s par similare, implementarea lor diferă fundamental: aceasta este cea mai înșelătoare și cea mai puțin documentată parte.
K8s utilizează pentru a implementa limitele. Setările acestora sunt definite în fișierele cfs_period_us și cfs_quota_us din directorul cgroup (acolo se află și fișierul cpu.share).
Spre deosebire de cpu.share, cota se bazează pe perioada de timp, nu pe capacitatea disponibilă a procesorului. cfs_period_us stabilește durata perioadei (epocii) — aceasta este întotdeauna 100000 μs (100 ms). În K8s există opțiunea de a schimba această valoare, cu toate că aceasta este disponibilă doar în versiunea alpha. Programatorul folosește epoca pentru a reporni cotelor utilizate. Al doilea fișier, cfs_quota_us, stabilește timpul disponibil (cota) în fiecare epocă. Rețineți că acesta este de asemenea specificat în microsecunde. Cota poate depăși durata epocii; cu alte cuvinte, poate fi mai mare de 100 ms.
Să luăm în considerare două scenarii pe mașini cu 16 nuclee (cel mai comun tip de computere pentru noi la Omio):
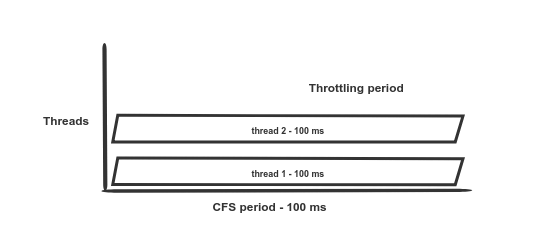
Scenariul 1: 2 fluxuri și limită de 200 ms. Fără throttling
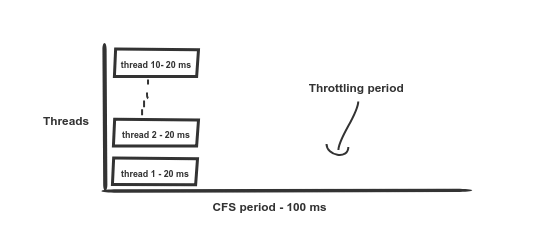
Scenariul 2: 10 fluxuri și limită de 200 ms. Throttling-ul începe după 20 ms, accesul la resursele procesorului este reluat după încă 80 ms
Să presupunem că ați setat limita CPU pe 2 nuclee; Kubernetes va traduce această valoare în 200 ms. Asta înseamnă că containerul poate folosi maximum 200 ms de timp de procesor fără throttling.
Și aici începe partea interesantă. Așa cum s-a menționat mai sus, cota disponibilă este de 200 ms. Dacă aveți simultan zece fluxuri pe o mașină cu 12 nuclee (vezi ilustrația de la scenariul 2), în timp ce toate celelalte pod-uri sunt inactiv, cota va fi epuizată în doar 20 ms (deoarece 10 * 20 ms = 200 ms), iar toate fluxurile acestui pod vor "îngheța" (throttle) pentru următoarele 80 ms. Situația este agravată de deja menționat , care cauzează throttling excesiv și containerul nu poate genera nici măcar cota disponibilă.
Cum se evaluează throttling-ul în pod-uri?
Pur și simplu intrați în pod și executați cat /sys/fs/cgroup/cpu/cpu.stat.
-
nr_periods— numărul total de perioade ale planificatorului; -
nr_throttled— numărul de perioade throttled dinnr_periods; -
throttled_time— timpul total throttled în nanosecunde.
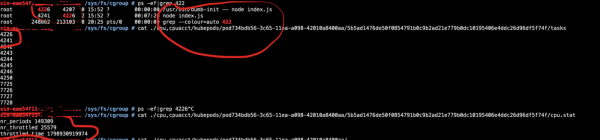
Ce se întâmplă de fapt?
În concluzie, obținem un throttling ridicat în toate aplicațiile. Uneori este de 1,5 ori mai mare decât cel estimat!
Acest lucru duce la diverse erori — eșecuri ale verificărilor de disponibilitate (readiness), înghețarea containerelor, întreruperi ale conexiunilor de rețea, timeout-uri în cadrul apelurilor de serviciu. În cele din urmă, acest lucru se traduce prin o întârziere crescută și o creștere a erorilor.
Soluția și consecințele
Aici totul este simplu. Am renunțat la limitele CPU și ne-am ocupat cu actualizarea kernel-ului OS în clustere la cea mai recentă versiune, în care bug-ul a fost corectat. Numărul de erori (HTTP 5xx) în serviciile noastre a scăzut imediat semnificativ:
Erori HTTP 5xx
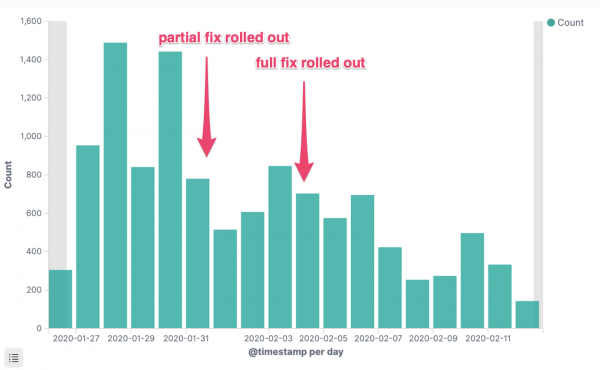
Erori HTTP 5xx ale unui serviciu critic
Timpul de răspuns p95
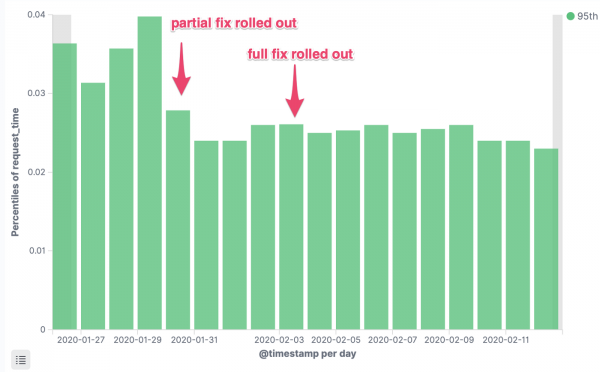
Întârzierea cererilor pentru un serviciu critic, percentila 95
Cheltuieli operaționale
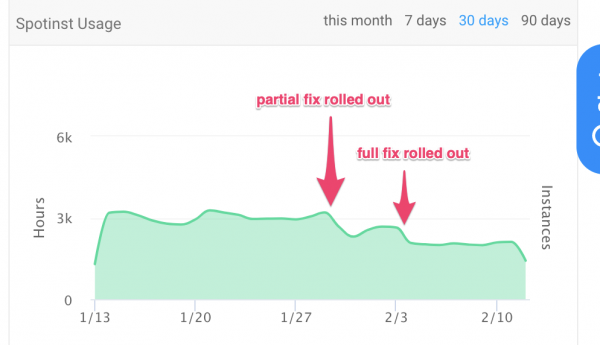
Numărul de ore de instanță consumate
Care este capcana?
Așa cum s-a spus la începutul articolului:
Se poate face o analogie cu un apartament comun… Kubernetes acționează ca un agent imobiliar. Dar cum să împiedici chiriașii să intre în conflict între ei? Ce se întâmplă dacă unul dintre ei, să zicem, decide să ocupe baia timp de o jumătate de zi?
Aici este capcana. Un container neglijent poate consuma toate resursele disponibile ale procesorului pe mașină. Dacă ai un stivă de aplicații bine configurată (de exemplu, JVM-uri, Go, Node VM configurate corespunzător), atunci nu este o problemă: poți funcționa în aceste condiții pentru o perioadă lungă de timp. Dar dacă aplicațiile sunt prost optimizate sau complet neoptimizate (FROM java:latest), situația poate scăpa de sub control. La Omio avem fișier Docker de bază automatizate cu setări adecvate implicite pentru stiva principalelor limbaje, astfel încât această problemă nu a existat.
Recomandăm să monitorizăm metricele (utilizare, saturație și erori), întârzierile API și frecvența erorilor. Asigurați-vă că rezultatele se aliniază cu așteptările.
Linkuri
Aceasta este povestea noastră. Materialele următoare ne-au ajutat foarte mult să înțelegem ce se întâmplă:
- ;
- ;
- ;
- ;
- — căutați «cpu throttling».
Raportele de erori Kubernetes:
- ;
- ;
- .
Te-ai confruntat cu probleme similare în practica ta sau ai experiențe legate de throttling în medii de producție containerizate? Împărtășește-ți povestea în comentarii!
P.S. de la traducător
Citiți și în blogul nostru:
- «»;
- «»;
- «».
Sursa: habr.com
