

Exact aceste plângeri le-am auzit de la dezvoltatorii noștri. Cea mai interesantă parte este că s-a dovedit a fi adevărat, dând naștere unei investigații de lungă durată. Vorbim despre servere SQL care funcționează pe VMware la noi.
De fapt, este ușor să obții ca serverul de producție să rămână mult în urmă față de laptop. Rulați (nu pe tempdb și nu pe baza cu Delayed Durability activat) codul:
set nocount on
create table _t (v varchar(100))
declare @n int=300000
while @n>0 begin
  insert into _t select 'Ce melc!'
  delete from _t
  set @n=@n-1
  end
GO
drop table _t
Pe desktop-ul meu, acesta se execută în 5 secunde, iar pe serverul de producție — în 28 de secunde. Pentru că SQL trebuie să aștepte finalizarea fizică a scrierii în jurnalul de tranzacții, iar noi facem tranzacții foarte scurte. Ca să fiu mai explicit, am bagi un camion mare și puternic în traficul urban, și observăm cum livratorii de pizza pe scutere îl depășesc cu ușurință — aici nu contează throughput-ul, ci doar latența. Și niciun stocare în rețea, indiferent câte zerouri ar avea prețul său, nu poate câștiga în latență față de un SSD local.
(în comentarii s-a dovedit că am mințit — amândouă locurile au activat delayed durability. Fără delayed durability, obținem:
Desktop — 39 de secunde, 15K tr/sec, 0.065ms /io roundtrip
PROD — 360 de secunde, 1600 tr/sec, 0.6ms
Ar fi trebuit să observ că era mult prea rapid)
Totuși, în acest caz, avem de-a face cu zerouri triviale ale acelei funcții Riemann cu un exemplu trivial. În exemplul pe care mi l-au adus dezvoltatorii, era altceva. Am confirmat că au avut dreptate și am început să curăț exemplul de toată specificitatea legată de logica de afaceri. Într-un moment dat, mi-am dat seama că pot elimina complet codul lor și să scriu al meu — care demonstrează aceeași problemă — și pe producție se execută de 3-4 ori mai lent:
create function dbo.isPrime (@n bigint)
returns int
as
  begin
  if @n = 1 return 0
  if @n = 2 return 1
  if @n = 3 return 1
  if @n % 2 = 0 return 0
  declare @sq int
  set @sq = sqrt(@n)+1 -- verificați numerele impare până la sqrt
  declare @dv int = 1
  while @dv < @sq
    begin
	set @dv=@dv+2
	if @n % @dv = 0 return 0
	end
  return 1
  end
GO
declare @dt datetime set @dt=getdate()
select dbo.isPrime(1000000000000037)
select datediff(ms,@dt,getdate()) as ms
GO
Dacă totul este în regulă, atunci verificarea primalității unui număr se va executa în 6-7-8 secunde. Așa a fost pe o serie de servere. Dar iată că pe unele a durat 25-40 de secunde. Ce este interesant, nu au fost servere unde execuția să dureze, să zicem, 14 secunde — codul a funcționat fie foarte repede, fie extrem de încet, deci problema era, să zicem, alb-negru.
Ce am făcut? M-am uitat în metricele VMware. Totul era în regulă - resursele erau suficiente, timpul de pregătire = 0, aveam tot ce trebuie, în timpul testului atât pe serverele rapide, cât și pe cele lente, CPU=100 pe un vCPU. Am luat un test pentru calcularea numărului Pi - testul arăta rezultate identice pe orice server. A început să miroasă a magie neagră.
Ieșind pe ferma DEV, am început să experimentez cu serverele. Am descoperit că vMotion de pe un gazdă pe alta poate «vindeca» un server, dar poate și invers, să transforme un server «rapid» într-unul «lent». Se pare că această problemă apare deoarece unele gazde au probleme... dar... nu. O mașină virtuală încetinea pe gazda A, dar funcționa rapid pe gazda B. O altă mașină virtuală, dimpotrivă, funcționa rapid pe A și încetinea pe B! Pe gazdă erau frecvent atât mașini «rapide», cât și «leneșe»!
De la acest moment s-a simțit clar miros de sulf în aer. Problema nu putea fi atribuită unei mașini virtuale (patch-uri Windows, de exemplu) — pentru că ea devenea «rapidă» în timpul vMotion. Dar problema nu putea fi atribuită nici gazdei — pentru că pe ea puteau fi atât mașini «rapide», cât și «leneșe». De asemenea, nu era legată de sarcină — am reușit să obțin o mașină «leneșă» pe o gazdă unde nu mai era nimic altceva.
Din disperare, am lansat Process Explorer de la Sysinternals și am verificat stiva SQL. Pe mașinile lente, mi-a sărit imediat în ochi următoarea linie:
ntoskrnl.exe!KeSynchronizeExecution+0x5bf6
ntoskrnl.exe!KeWaitForMultipleObjects+0x109d
ntoskrnl.exe!KeWaitForMultipleObjects+0xb3f
ntoskrnl.exe!KeWaitForSingleObject+0x377
ntoskrnl.exe!KeQuerySystemTimePrecise+0x881 < — !!!
ntoskrnl.exe!ObDereferenceObjectDeferDelete+0x28a
ntoskrnl.exe!KeSynchronizeExecution+0x2de2
sqllang.dll!CDiagThreadSafe::PxlvlReplace+0x1a20
… omis
sqldk.dll!SystemThread::MakeMiniSOSThread+0xa54
KERNEL32.DLL!BaseThreadInitThunk+0x14
ntdll.dll!RtlUserThreadStart+0x21
Asta era deja ceva. A fost scris un program:
    class Program
    {
        [DllImport("kernel32.dll")]
        static extern void GetSystemTimePreciseAsFileTime(out FILE_TIME lpSystemTimeAsFileTime);

        [StructLayout(LayoutKind.Sequential)]
        struct FILE_TIME
        {
            public int ftTimeLow;
            public int ftTimeHigh;
        }

        static void Main(string[] args)
        {
            for (int i = 0; i < 16; i++)
            {
                int counter = 0;

                var stopwatch = Stopwatch.StartNew();

                while (stopwatch.ElapsedMilliseconds  0)
                {
                    Console.WriteLine("{0}", counter);
                }
            }
        }
    }
Această programă a demonstrat o încetinire și mai marcată — pe mașinile «rapide» arată 16-18 milioane de cicluri pe secundă, în timp ce pe cele lente — un milion și jumătate sau chiar 700 de mii. Așadar, diferența este de 10-20 de ori (!!!). Aceasta a fost deja o mică victorie: în orice caz, nu exista riscul de a rămâne blocat între suportul Microsoft și VMware, astfel încât aceștia să se transfere reciproc responsabilitatea.
Apoi, progresul s-a oprit — vacanțe, afaceri importante, isterie virală și o creștere bruscă a încărcăturii. Am menționat adesea problema magică colegilor, dar uneori părea că nici măcar nu-mi cred — era o afirmație prea terifiantă că VMware încetinește codul de 10-20 de ori.
Am încercat să descopăr singur ce anume este problema. Uneori, părea că am găsit soluția — activarea și dezactivarea Hot plugs, modificarea volumului de memorie sau a numărului de procesoare transforma adesea mașina în «rapidă». Dar nu pentru totdeauna. Ceea ce s-a dovedit a fi adevărat este că, de ajuns să ieși afară și să dai cu pumnul în roată — asta înseamnă să schimbi oricine parametrul virtualului
În sfârșit, colegii mei americani au descoperit brusc cauza principală.
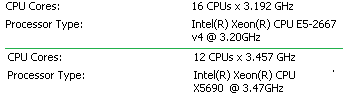
Hosturile diferă prin frecvență!
- În general, acest lucru nu este grav. Dar: când te muți de pe un host ‘nativ’ pe un host cu o frecvență ‘diferită’, VMware trebuie să corecteze rezultatul GetTimePrecise.
- În general, nu este grav, cu excepția cazului în care se dovedește a fi o aplicație care solicită timpul precis de milioane de ori pe secundă, precum SQL server.
- Dar nici asta nu este grav, deoarece SQL server nu face acest lucru decât foarte rar (vezi Concluzia)
Dar sunt cazuri în care aceste capcane doare rău. Și da, dând cu pumnul în roată (schimbând ceva în setările VM) am determinat VMware să ‘recalculeze’ configurația, iar frecvența hostului curent devenea frecvența ‘nativă’ a mașinării.
Soluție
Când dezactivezi virtualizarea TSC, citirea TSC din interiorul mașinii virtuale returnează valoarea TSC a mașinii fizice, iar scrierea TSC din interiorul mașinii virtuale nu are efect. Migrând mașina virtuală pe un alt host, reluând-o din stare suspendată sau revenind la un snapshot, cauzează ca TSC să sară discontinu. În trecut, această caracteristică a fost uneori recomandată pentru a îmbunătăți performanța aplicațiilor care citesc frecvent TSC, dar performanța TSC-ului virtual a fost îmbunătățită considerabil în produsele actuale. De asemenea, caracteristica a fost recomandată pentru utilizare când se efectuează măsurători ce necesită o sursă precisă de timp real în mașina virtuală.
Pe scurt, trebuie adăugat parametrul
monitor_control.virtual_rdtsc = FALSE
Concluzie
Probabil că te întrebi: de ce să chem SQL GetTimePrecise atât de des?
Nu am surse pentru SQL Server, dar logica spune următoarele. SQL este aproape un sistem de operare cu concurență cooperativă, unde fiecare fir trebuie din când în când să "cedă". Și unde este cel mai bine să facem asta? Acolo unde există o așteptare naturală — blocare sau IO. Bine, dar ce se întâmplă dacă avem cicluri de calcul? Atunci, singurul loc evident este în interpretator (nu este chiar un interpretator), după executarea următoarei instrucțiuni.
De obicei, SQL Server nu este folosit pentru a încuia cuie în calcule brute și aceasta nu este o problemă. Însă ciclurile care lucrează cu diverse tabele temporare (care sunt imediat cache-uite) transformă codul într-o secvență de instrucțiuni ce sunt executate foarte rapid.
Apropo, dacă înfășurăm funcția în NATIVELY COMPILED, atunci aceasta încetează să mai solicite timpul, iar viteza ei crește de 10 ori. Dar cum rămâne cu multitaskingul cooperativ? Ei bine, pentru codul natively compiled a fost necesar să se facă PREEMPTIVE MULTITASKING în SQL.
Sursa: habr.com
