

Vă propun să consultați transcrierea prezentării lui Nikolay Samohvalov "Abordare industrială pentru tunarea PostgreSQL: experimente asupra bazelor de date"
Shared_buffers = 25% – este mult sau puțin? Sau exact cât trebuie? Cum să înțelegi dacă această recomandare – destul de învechită – se potrivește situației tale specifice?
A venit momentul să abordăm problema alegerii parametrilor postgresql.conf "ca niște adulți". Nu cu ajutorul "autotunerilor" oarbe sau a sfaturilor învechite din articole și bloguri, ci pe baza:
- experimentelor strict controlate pe baze de date, efectuate automatizat, în cantități mari și în condiții cât mai aproape de cele "de producție",
- înțelegerii profunde a caracteristicilor de funcționare ale SGBD-ului și sistemului de operare.
Folosind Nancy CLI (), vom analiza un exemplu concret – celebrele shared_buffers – în diverse situații, în diferite proiecte și vom încerca să înțelegem cum să alegem setarea optimă pentru infrastructura noastră, baza de date și sarcina de lucru.
Vor fi discutate experimentele asupra bazelor de date. Aceasta este o poveste care continuă de puțin peste șase luni.
Câte ceva despre mine. Am o experiență de peste 14 ani cu Postgres. Am fondat mai multe companii în domeniul rețelelor sociale, unde Postgres a fost folosit și este folosit.
De asemenea, grupul RuPostgres pe Meetup, pe locul 2 în lume. Ne apropiem încet de 2 000 de membri. RuPostgres.org.
Și la diverse conferințe, inclusiv Highload, mă ocup de baze de date, în special de Postgres, de la începuturi.
Și în ultimii câțiva ani, mi-am reluat practica de consultanță Postgres, având clienți în 11 fusuri orare diferite.
Atunci când am făcut acest lucru cu câțiva ani în urmă, am avut o perioadă de pauză în lucrul activ cu Postgres, probabil din 2010. M-a surprins cât de puțin s-au schimbat provocările zilnice ale DBA-urilor, cât de multă muncă manuală este încă necesară. Și m-am gândit că trebuie să fie ceva în neregulă, trebuie să automatizăm mai multe lucruri.
Și având în vedere că majoritatea clienților erau în cloud, multe s-au automatizat evident. Despre asta vom vorbi puțin mai târziu. Adică, toată această experiență a dus la ideea că ar trebui să existe o serie de instrumente, adică o anumită platformă care să automatizeze practic toate acțiunile DBA-ului, pentru a putea gestiona un număr mare de baze de date.
În această prezentare nu vor fi:
- Nu există „gloanțe de argint” și părerile de tipul – setați 8 GB sau 25 % shared_buffers și veți fi bine. Despre shared_buffers nu va fi atât de mult.
- Interioare hardcore.
Și ce se va întâmpla?
- Vor exista principii de optimizare pe care le aplicăm și le dezvoltăm. Vor exista diverse idei care ne vin pe parcurs și diverse instrumente pe care le creăm, în mare parte, în Open Source, adică baza o facem în Open Source. Mai mult, avem tichete, toată comunicarea se desfășoară practic în Open Source. Puteți urmări ce facem acum, ce va fi în următoarea versiune etc.
- De asemenea, va exista o anumită experiență în utilizarea acestor principii și instrumente în diverse companii: de la startup-uri mici la mari corporații.
Cum se dezvoltă totul?
În primul rând, principalul obiectiv al DBA-ului pe lângă asigurarea creării instanțelor, desfășurarea backup-urilor etc. este identificarea punctelor critice și optimizarea performanței.
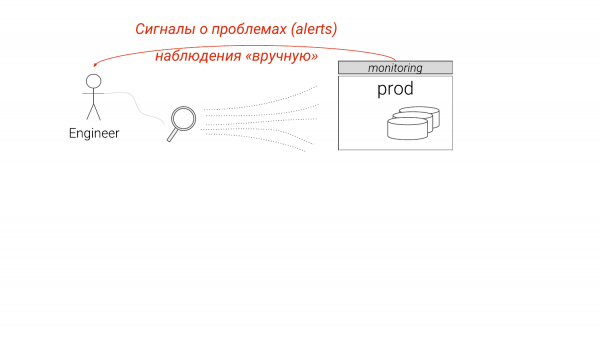
Acum, lucrurile sunt organizate astfel. Ne uităm la monitorizare, vedem ceva, ne lipsesc anumite detalii. Începem să cercetăm mai atent, de obicei manual și înțelegem ce să facem cu asta, într-un fel sau altul.
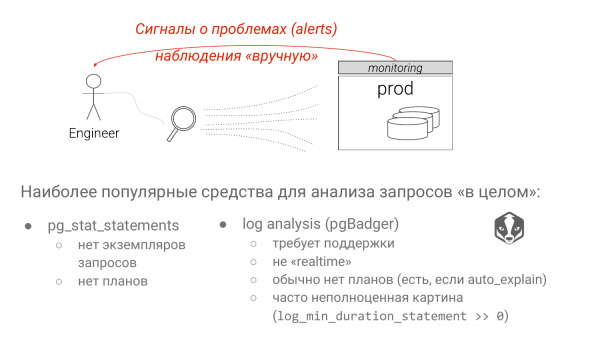
Și există două abordări. Pg_stat_statements – soluția standard implicită pentru identificarea interogărilor lente. Și analiza jurnalelor Postgres cu ajutorul pgBadger.
Fiecare dintre abordări are serios dezavantaje. La prima abordare, toate parametrii sunt omise. Și dacă vedem grupuri SELECT * FROM table where coloana este egală cu semnul „?” sau „$” începând cu versiunea Postgres 10. Nu știm – este scanare a indexului sau scanare secvențială. Depinde foarte mult de parametru. Dacă pui o valoare rar întâlnită, va fi scanare a indexului. Dacă pui o valoare care reprezintă 90 % din tabel, evident va fi scanare secvențială, pentru că Postgres cunoaște statisticile. Și acesta este un dezavantaj mare al pg_stat_statements, deși se fac anumite lucrări.
Cel mai mare dezavantaj al analizei jurnalelor este că, în general, nu îți poți permite „log_min_duration_statement = 0”. Despre asta vom vorbi și noi. În consecință, nu vezi întreaga imagine. Și o anumită interogare care este foarte rapidă poate consuma o cantitate uriașă de resurse, dar nu o vei observa, pentru că este sub pragul tău.
Cum rezolvă DBA-ii problemele identificate?
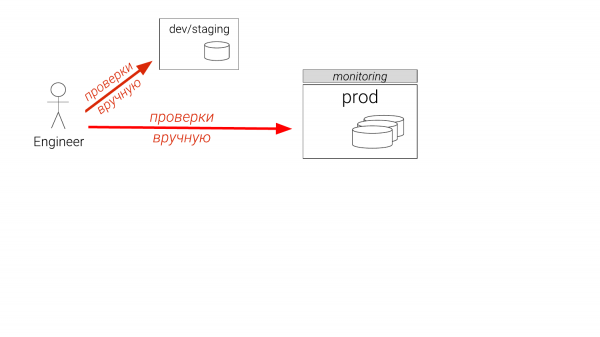
De exemplu, am găsit o problemă. Ce se face de obicei? Dacă ești dezvoltator, vei face ceva pe un anumit instanță, care nu este de o dimensiune prea mare. Dacă ești DBA, ai un staging. Și poate fi doar unul. Și acesta a întârziat cu jumătate de an. Și te gândești că vei merge în producție. Chiar și DBA-ii experimentați verifică apoi în producție, pe replică. Se întâmplă chiar să creeze un index temporar, se asigură că acesta ajută, îl șterg și-l înapoie devlopatorilor pentru a-l include în fișierele de migrare. Cam așa se întâmplă acum. Și asta este o problemă.
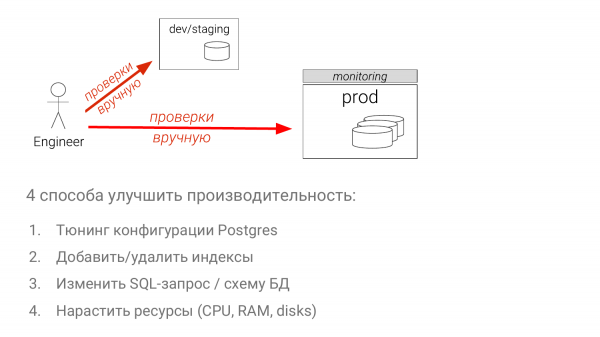
- Configurarea ajustărilor.
- Optimizarea setului de indecși.
- Modificarea interogării SQL (aceasta este cea mai complexă abordare).
- Adăugarea de putere (cea mai simplă metodă în majoritatea cazurilor).
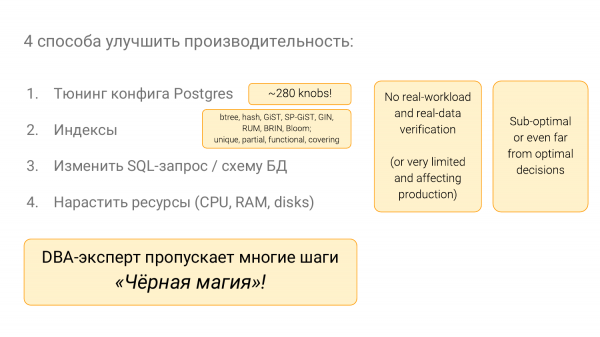
Cu aceste lucruri sunt foarte multe de spus. Există multe detalii în Postgres. Trebuie să știi foarte multe. Există multe indecși în Postgres, datorită organizatorilor acestei conferințe. Trebuie să știi toate acestea și tocmai acest lucru le dă DBA-ilor senzația că se ocupă de magie neagră. Asta înseamnă că trebuie să te ocupi timp de 10 ani pentru a începe să înțelegi toate acestea corect.
Și eu sunt un luptător împotriva acestei magii negre. Vreau să fac totul astfel încât să fie tehnologie, nu intuiție în toate acestea.
Exemple din viață
Am observat asta în cel puțin două proiecte, inclusiv al meu. O nouă postare pe blog ne spune că o valoare de 1.000 pentru default_statistic_target este bună. Bun, haideți să încercăm în producție.
Și aici, folosindu-ne de instrumentul nostru doi ani mai târziu, prin experimentele efectuate asupra bazelor de date de care vorbim astăzi, putem compara ce a fost și ce a devenit.
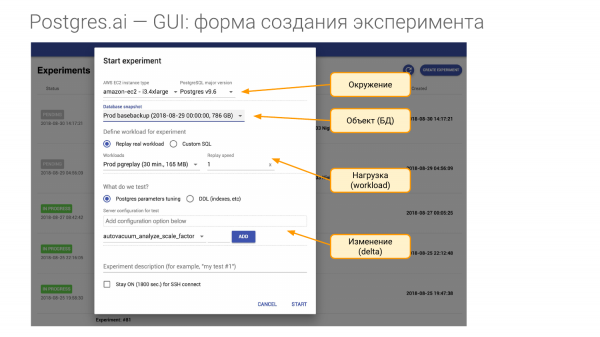
Și pentru asta trebuie să creăm un experiment. Acesta constă din patru părți.
- Prima parte este mediu. Avem nevoie de hardware. Și când ajung într-o companie și semnez un contract, spun că vreau un hardware asemănător cu cel din producție. Pentru fiecare dintre meșterii tăi am nevoie de cel puțin un hardware de același tip. Fie că este o mașină virtuală instance în Amazon sau Google, fie că am nevoie de exact același hardware. Adică vreau să recreez mediu. În conceptul de mediu includem versiunea majoră a Postgres.
- A doua parte este obiectul cercetărilor noastre. Aceasta este baza de date. Poate fi creată în mai multe moduri. Îți voi arăta cum.
- A treia parte este sarcina. Acesta este cel mai complex moment.
- Și a patra parte este ceea ce verificăm, adică cu ce vom compara. Să zicem că putem schimba unul sau mai multe parametrii în configurație, sau putem crea un index și așa mai departe.
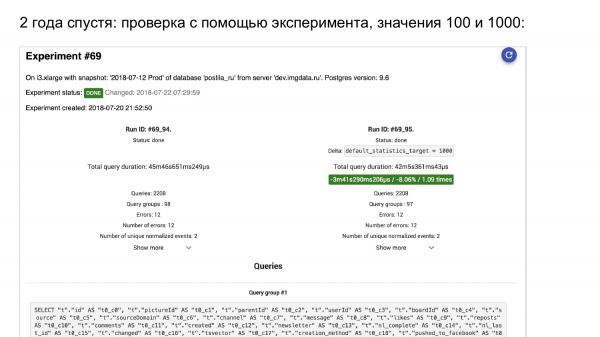
Lansăm un experiment. Iată pg_stat_statements. În stânga – ceea ce era. În dreapta – ce a devenit.
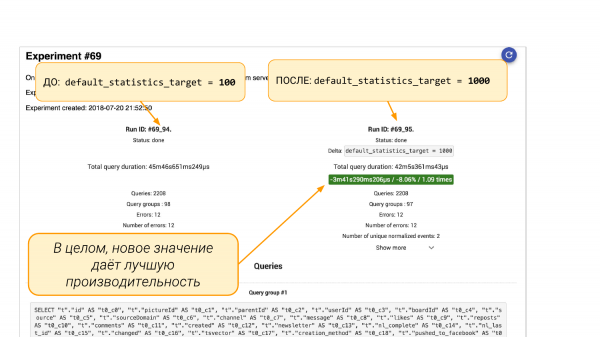
În stânga default_statistics_target = 100, în dreapta = 1 000. Vedem că ne-a ajutat. În general, a fost cu 8% mai bine.
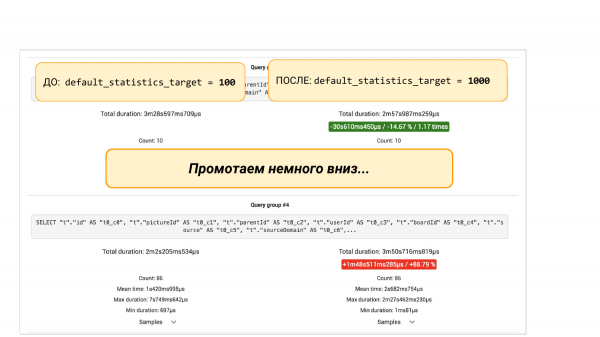
Dar dacă derulăm în jos, acolo vor fi grupuri de cereri din pgBadger sau din pg_stat_statements. Există două variante. Vom observa că o cerere a scăzut cu 88%. Și aici intervine abordarea ingineriască. Putem să ne adâncim, pentru că e interesant de ce a scăzut. Trebuie să înțelegem ce s-a întâmplat cu statistica. De ce mai multe bucket-uri în statistică duc la un rezultat mai prost.
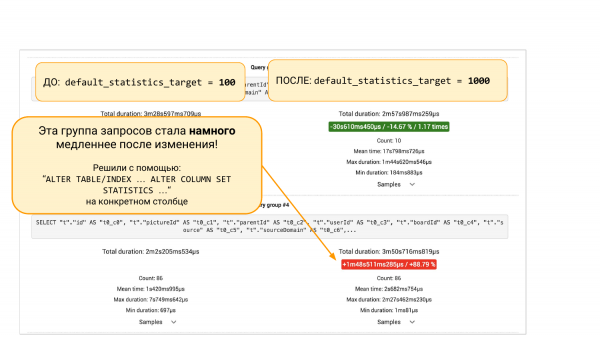
Sau putem să nu ne adâncim, ci să facem „ALTER TABLE … ALTER COLUMN” și să-i returnăm înapoi 100 de bucket-uri în statistica acestei coloane. Și printr-un alt experiment putem să ne asigurăm că această soluție a ajutat. Gata. Aceasta este abordarea ingineriască, care ne ajută să vedem tabloul și să luăm decizii pe baza datelor, nu pe baza intuiției.
Câteva exemple din alte domenii. În teste, există teste CI de mulți ani. Niciun proiect care este în toate mințile nu va putea trăi fără teste automate.
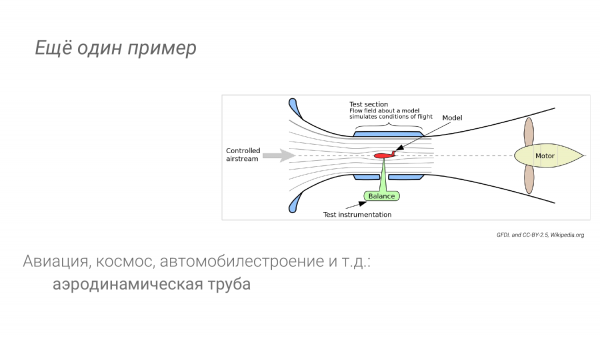
În alte industrii: în aviație, în industria auto, atunci când testăm aerodinamica, avem și noi oportunitatea de a face experimente. Nu vom lansa imediat ceva în spațiu direct dintr-un desen, sau nu vom scoate o mașină imediat pe drum. De exemplu, există un tub aerodinamic.
Din observațiile asupra altor domenii putem trasa concluzii.
În primul rând, avem un mediu special. Este aproape de producție, dar nu chiar. Principala sa caracteristică este că ar trebui să fie ieftin, repetabil și maxim automatizat. Și ar trebui să existe instrumente speciale pentru a efectua analize detaliate.
Probabil, când am lansat avionul și zburăm, avem mai puține oportunități de a studia fiecare milimetru al suprafeței aripii decât avem în tunelul aerodynamic. Avem mai multe resurse pentru diagnosticare. Ne putem permite să atașăm mai multe lucruri grele, ceea ce nu ne putem permite să facem pe avion în aer. La fel este și cu Postgres. În anumite cazuri, putem activa logarea completă a interogărilor în timpul experimentelor. Și nu vrem să facem asta în producție. Poate că vom activa asta cu ajutorul auto_explain.
Și așa cum am spus deja, un nivel ridicat de automatizare înseamnă că am apăsat un buton și am repetat. Așa ar trebui să fie, pentru a avea multe experimente, astfel încât să devină un flux.
Nancy CLI – fundația „laboratorului de baze de date”
Și iată, am realizat o astfel de chestie. Adică, vorbeam despre aceste idei în iunie, aproape acum un an. Și avem deja în Open Source așa-numita Nancy CLI. Acesta este fundamentul pentru a construi un laborator de baze de date.
— Aceasta este în Open Source, pe Gitlab. Puteți să spuneți, puteți încerca. Am pus un link în slide-uri. Puteți face clic pe el și acolo va fi pe toate parametrii.
Desigur, acolo mai sunt multe în stadiu de dezvoltare. Există multe idei. Dar deja este ceva ce aplicăm practic zilnic. Și când ne trece o idee – ce se întâmplă când ștergem 40 000 000 de rânduri și totul se blochează din cauza IO-ului, putem face un experiment și să ne uităm mai în detaliu pentru a înțelege ce se întâmplă și apoi să încercăm să corectăm pe parcurs. Adică, facem un experiment. De exemplu, ajustăm ceva și vedem ce rezultat obținem. Și facem asta nu în producție. Aceasta este esența ideii.
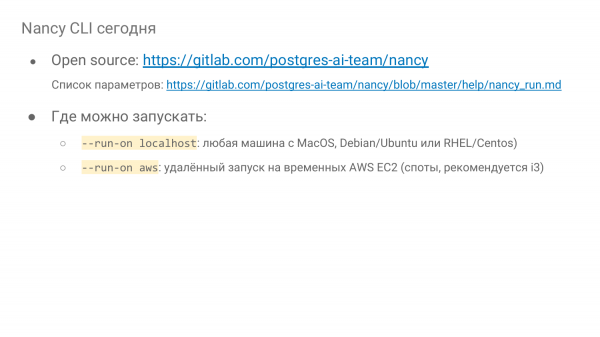
Unde poate funcționa asta? Poate funcționa local, adică se poate face oriunde, chiar și pe un MacBook. Ai nevoie de Docker, ești gata. Și totul. Poate fi rulat pe un instance pe hardware, sau într-o mașină virtuală, oriunde.
Există, de asemenea, posibilitatea de a lansa de la distanță pe Amazon, în EC2 Instance, în spoturi. Este o oportunitate foarte interesantă. De exemplu, ieri am efectuat peste 500 de experimente pe i3 instance, începând cu cel mai mic și terminând cu i3-16-xlarge. Aceste 500 de experimente ne-au costat 64 de dolari. Fiecare a durat 15 minute. Așadar, datorită utilizării spoturilor, costurile sunt foarte reduse – o reducere de 70%, cu tarifare pe secundă de la Amazon. Puteți face foarte multe. Puteți desfășura o cercetare reală.
Și sunt acceptate trei versiuni majore Postgres. Nu este atât de complicat să aducem unele vechi și noua versiune 12.
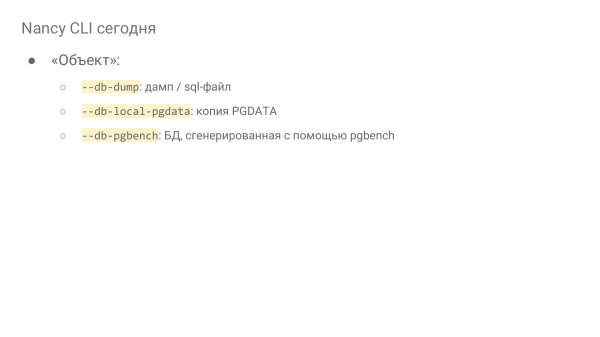
Obiectul îl putem defini în trei moduri. Acestea sunt:
- Dump/sql-file.
- Principalul mod este clonarea directorului PGDATA. De obicei, acesta este preluat de pe serverul de backup. Dacă aveți backup-uri binare corecte, puteți face clone de acolo. Dacă aveți servicii de cloud, aceasta va fi realizată de compania de cloud, cum ar fi Amazon sau Google. Acesta este principalul mod de a realiza clone în producție. Noi desfășurăm astfel de operațiuni.
- Iar ultima metodă este potrivită pentru cercetări, când doriți să înțelegeți cum funcționează o anumită parte a Postgres. Aceasta este pgbench. Puteți genera cu ajutorul pgbench. Este pur și simplu o opțiune «db-pgbench». Îi spuneți ce scală doriți. Și totul va fi generat în cloud, așa cum este specificat.
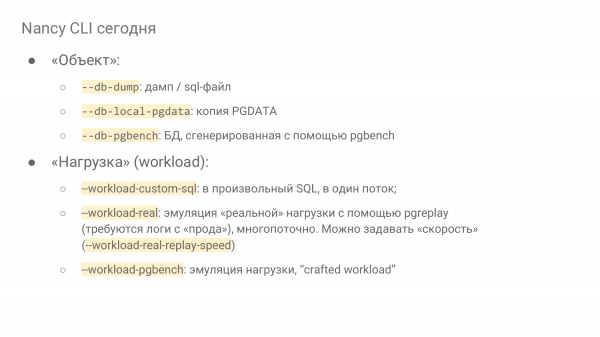
Și încărcarea:
- Încărcarea o putem executa într-un singur thread SQL. Acesta este cel mai primitiv mod.
- Dar putem simula o încărcare. Iar simularea o putem face în primul rând în felul următor. Trebuie să colectăm toate logurile. Și aceasta este o provocare. Voi arăta de ce. Și cu ajutorul pgreplay, care este încorporat în Nancy, vom reda.
- Sau există o alternativă. Așa-numita încărcare manuală, la care lucrăm cu un anumit efort. Analizând încărcarea noastră actuală pe sistemul de producție, extragem grupurile de interogări cele mai performante. Și cu ajutorul pgbench putem simula această încărcare în laborator.
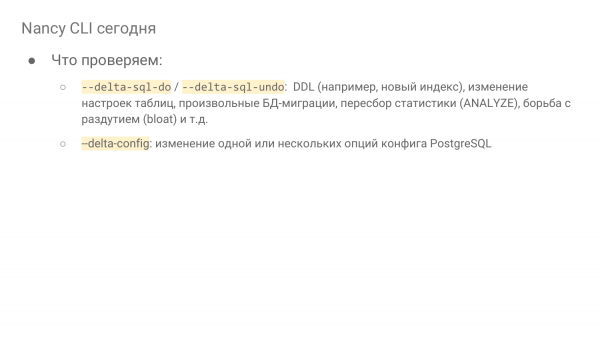
- Ori trebuie să executăm o interogare SQL, adică verificăm o migrare, creăm un index, executăm ANALYZE. Și observăm ce s-a întâmplat înainte și după vacuum. Practic, orice SQL.
- Ori configurăm unul sau mai multe parametrii. Putem solicita să verifice, de exemplu, 100 de valori în Amazon pentru baza noastră de un terabyte. Și după câteva ore veți avea un rezultat. De obicei, baza de un terabyte se desfășoară câteva ore. Dar în dezvoltare există un patch, putem avea o serie, adică puteți folosi consecutiv aceeași pgdata pe același server și verifica. Postgres se va reporni, cache-urile se vor reseta. Și puteți aplica sarcină.
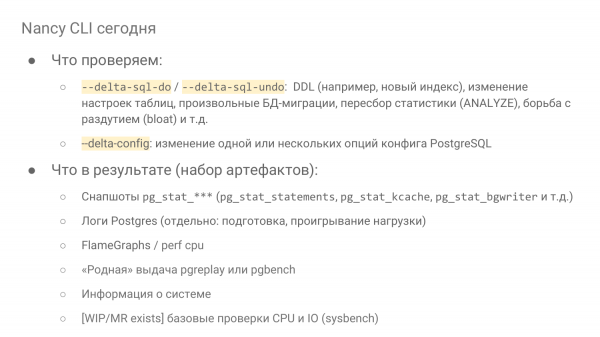
- Sosește un director, în care sunt o mulțime de fișiere, începând cu instantaneele pg.stat***. Și cel mai interesant acolo este pg_stat_statements, pg_stat_kcache. Acestea sunt două extensii care analizează cererile. Iar pg_stat_bgwriter conține nu doar statistica pgwriter, ci și date despre checkpoint-uri și despre modul în care backend-urile înlocuiesc buffer-urile murdare. Și este interesant de observat. De exemplu, când configurăm shared_buffers, este foarte interesant să vedem câte au fost înlocuite.
- De asemenea, sosesc jurnalele Postgres. Două jurnale – jurnalul de pregătire și jurnalul de rulare a sarcinii.
- O caracteristică relativ nouă – FlameGraphs.
- De asemenea, dacă ați folosit pgreplay sau pgbench pentru simularea încărcării, veți avea ieșirea lor nativă. Și veți vedea latența și TPS. Se va putea înțelege cum au perceput asta.
- Informații despre sistem.
- Verificări de bază ale CPU și IO. Acest lucru este mai mult pentru instanțele EC2 din Amazon, când doriți să rulați în flux 100 de instanțe identice și să executați 100 de rânduri diferite, veți avea 10.000 de experimente. Și trebuie să vă asigurați că nu ați prins o instanță deficitară, care este deja restricționată de cineva. Pe acest hard, altele activează și resursele disponibile sunt reduse. Aceste rezultate ar trebui să fie eliminate. Și cu ajutorul sysbench de la Alexei Kopytov facem câteva verificări scurte, care vor veni și pot fi comparate cu altele, adică veți înțelege cum se comportă CPU-ul și cum se comportă IO.
Ce dificultăți tehnice există pe baza diferitelor companii?
Să presupunem că dorim să replicăm o încărcare reală folosind jurnalele. Este o idee excelentă, dacă este construit pe Open Source pgreplay. Îl folosim. Dar, pentru a funcționa bine, trebuie să activați logarea completă a cererilor cu parametrii și timing.
Există unele dificultăți legate de duration și timestamp. Vom trece cu vederea această problemă. Întrebarea principală este: vă puteți permite sau nu?
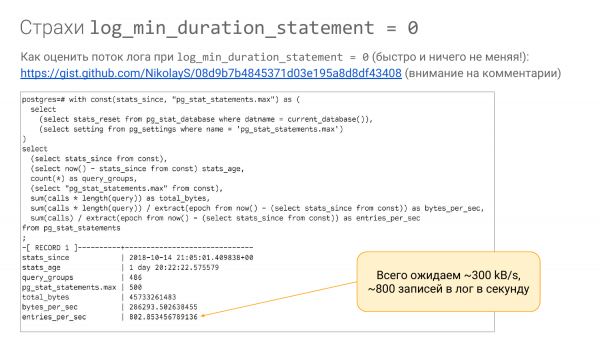
Problema este că acesta poate fi indisponibil. Trebuie, mai întâi, să înțelegeți ce flux va fi scris în jurnal. Dacă aveți pg_stat_statements, puteți folosi această interogare (linkul va fi disponibil în slide-uri) pentru a înțelege câți bytes vor fi scriși pe secundă.
Ne uităm la lungimea interogării. Ignorăm faptul că nu sunt parametriere, dar știm lungimea interogării și câte ori pe secundă este executată. Astfel, putem estima aproximativ câți bytes pe secundă. Ne putem înșela de două ori, dar ordinea va fi clară astfel.
Putem observa că această interogare este executată de 802 de ori pe secundă. Și vedem că bytes_per sec – 300 kB/s vor fi scriși plus minus. Și, în general, ne putem permite acest flux.
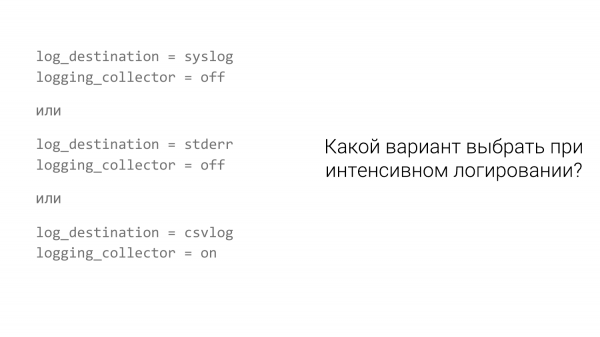
Dar! Problema este că există diferite sisteme de logare. Iar în mod implicit, oamenii folosesc de obicei „syslog”.
Și dacă aveți syslog, atunci poate apărea un tablou de genul acesta. Vom lua pgbench, vom activa logarea interogărilor și vom vedea ce iese.
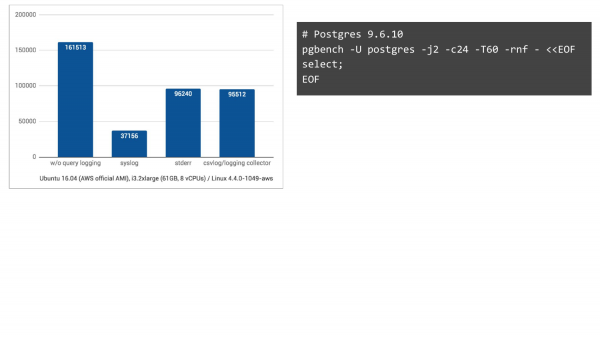
Fără logare – aceasta este coloana din stânga. Aveam 161 000 TPS. Cu syslog – în Ubuntu 16.04 pe Amazon avem 37 000 TPS. Și dacă schimbăm către două alte metode de logare, situația se îmbunătățește semnificativ. Adică, ne așteptam să scadă, dar nu atât de mult.
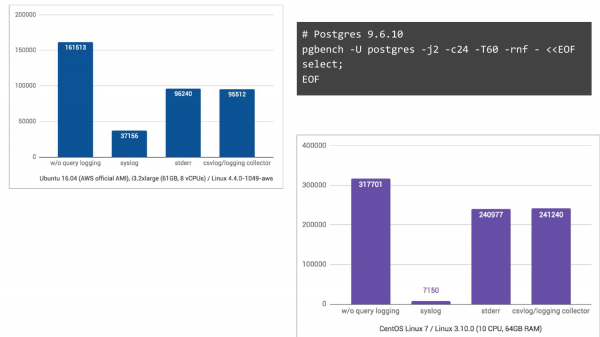
Iar în CentOS 7, unde journald este implicat, transformând jurnalele într-un format binar pentru căutare ușoară etc., situația este îngrozitoare, cu o scădere de 44 de ori a TPS.
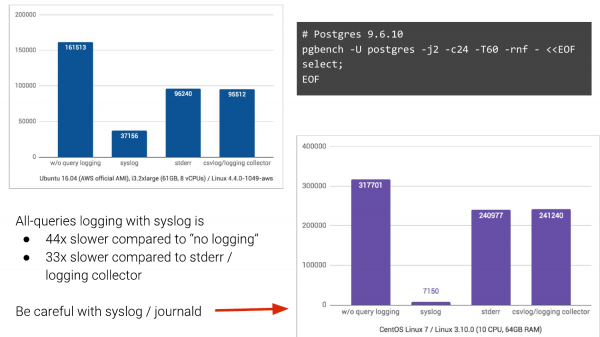
Și acesta este ceea ce trăiesc oamenii. Și adesea, în companii, mai ales în cele mari, este foarte complicat să se schimbe. Dacă puteți renunța la syslog, vă rog, faceți-o.
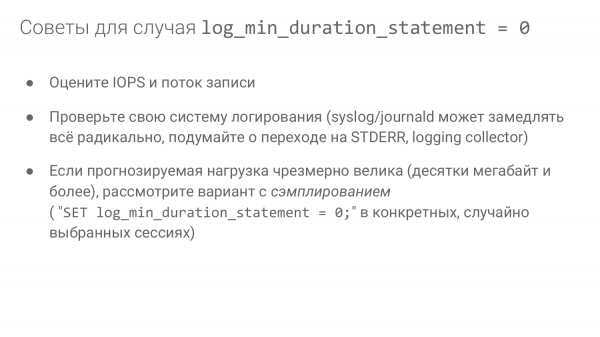
- Evaluați IOPS și fluxul de scriere.
- Verificați sistemul vostru de logare.
- Dacă încărcarea prevăzută este excesiv de mare, luați în considerare opțiunea de eșantionare.
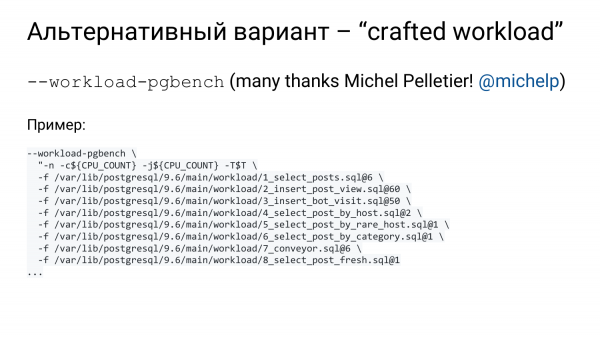
Avem pg_stat_statements. După cum am spus, trebuie să fie prezent. Și putem lua și să descriem fiecare grup de interogări într-un fișier special. Apoi putem folosi o funcție foarte convenabilă în pgbench – aceea de a introduce mai multe fișiere folosind opțiunea „-f”.
El înțelege mult despre „-f”. Și putem spune cu ajutorul „@” la final, ce proporție ar trebui să aibă fiecare fișier. Adică, putem spune că acesta să ruleze în 10% din cazuri, iar acesta în 20%. Și asta ne va apropia de ceea ce vedem în producție.
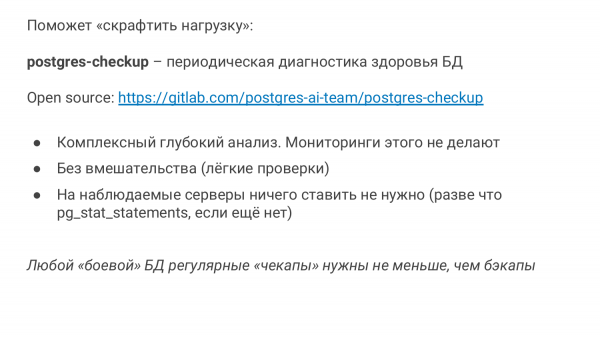
Și cum ne dăm seama ce avem în producție? Ce proporție și ce anume? Aici ne abatem puțin. Mai avem un produs. . Este, de asemenea, o bază Open Source. Și acum îl dezvoltăm activ.
A fost creat din alte motive. Din cauza că monitorizarea nu este suficientă. Adică, vii, te uiți la bază, te uiți la problemele existente. Și, de obicei, faci un health_check. Dacă ești un DBA experimentat, atunci faci un health_check. Te uiți la utilizarea indicilor etc. Dacă ai OKmeter, atunci e excelent. Este o monitorizare grozavă pentru Postgres. OKmeter.io – te rog, instalează-l, este foarte bine realizat. Este contra cost.
Dacă nu-l ai, de obicei nu ai mare lucru. În monitorizare, de obicei, există doar CPU, IO și asta cu rezerve, și cam atât. Dar noi avem nevoie de mai mult. Trebuie să vedem cum funcționează avvacuumul, cum funcționează checkpoint-ul, în io trebuie să separăm checkpoint-ul de bgwriter și de backend-uri etc.
Problema este că, atunci când ajuți o companie mare, nu pot implementa ceva rapid. Nu pot cumpăra rapid OKmeter. Poate că vor cumpăra după șase luni. Nu pot instala rapid anumite pachete.
Și ne-a venit ideea că avem nevoie de un instrument special, care să nu necesite nimic în instalare, adică nu trebuie să instalezi nimic pe producție. Îl instalezi pe laptopul tău sau pe un server de observare, de unde vei lansa. Și acesta va analiza multe aspecte: atât sistemul de operare, cât și sistemul de fișiere, și PostgreSQL, făcând câteva cereri simple care pot fi efectuate direct pe producție fără a ceda.
L-am numit Postgres-checkup. Dacă ar fi pe înțelesul medical, este o verificare regulată a sănătății. Dacă ne raportăm la domeniul auto, este ca un service periodic. Facem service la mașină la fiecare șase luni sau un an, în funcție de marcă. Dar faci service pentru baza ta? Adică, faci o investigație profundă regulat? Este necesar. Dacă faci backup-uri, atunci fă și checkup, este la fel de important.
Și avem un astfel de instrument. A început să se dezvolte activ doar acum trei luni. Este încă tânăr, dar are deja multe funcționalități.
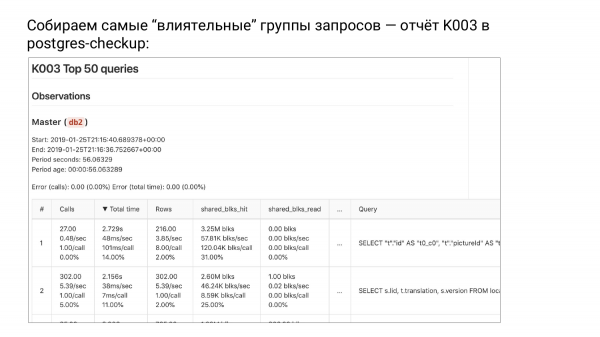
Colectăm cele mai „influențabile” grupuri de interogări – raport K003 în Postgres-checkup
Și acolo există un grup de rapoarte K. Trei rapoarte deocamdată. Și există un astfel de raport K003. Acolo este vârful din pg_stat_statements, sortat după total_time.
Atunci când sortăm grupurile de interogări după total_time, vedem un astfel de grup care îngreunează cel mai mult sistemul nostru, adică consumă cele mai multe resurse. De ce numesc grupuri de interogări? Pentru că am eliminat parametrii. Acestea nu mai sunt interogări, ci grupuri de interogări, adică sunt abstractizate.
Și dacă ne vom optimiza de sus în jos, ne vom ușura resursele și vom amâna momentul în care va trebui să facem un upgrade. Aceasta este o modalitate foarte bună de a economisi bani.
Poate că aceasta nu este o metodă foarte bună în ceea ce privește grija pentru utilizatori, pentru că, poate, nu vedem cazuri rare, dar foarte neplăcute, când o persoană a așteptat 15 secunde. În total, sunt atât de rare că nu le vedem, dar ne ocupăm de resurse.
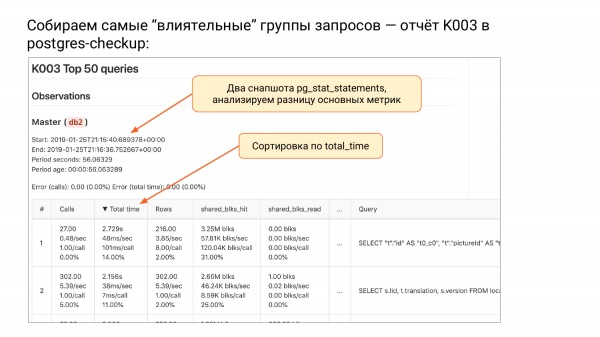
Ce s-a întâmplat în această tabelă? Am făcut două snapshoturi. Postgres_checkup îți va face delta pentru fiecare metrică: total-time, calls, rows, shared_blks_read etc. Totul, delta a fost calculată. O mare problemă a pg_stat_statements este că nu își amintește când a avut loc resetarea. Dacă pg_stat_database își amintește, pg_stat_statements nu își amintește. Vezi că acolo este numărul 1.000.000, dar de unde am calculat, nu știm.
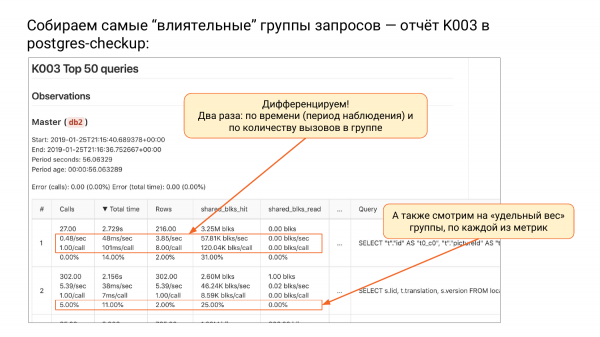
Aici știm, avem două snapshoturi. Știm că delta în acest caz a fost de 56 de secunde. Un interval foarte mic. Am sortat după total_time. Și apoi putem diferenția, adică toate metricile le împărțim la duration. Dacă împărțim fiecare metrică la duration, vom avea numărul de apeluri pe secundă.
Mai departe, total_time pe secundă – aceasta este metrica mea preferată. Se măsoară în secunde, pe secundă, adică câte secunde a necesitat sistemul nostru pentru executarea acestui grup de interogări pe secundă. Dacă vezi acolo mai mult de o secundă pe secundă, asta înseamnă că ai nevoie de mai mult de un nucleu. Aceasta este o metrică foarte bună. Poți înțelege că acel tip, de exemplu, are nevoie de minimum trei nuclee.
Aceasta este inovația noastră, nu am văzut așa ceva nicăieri. Observați – este o lucru foarte simplu – secundă pe secundă. Uneori, când ai CPU 100%, înseamnă că ai lucrat timp de jumătate de oră pe secundă, adică ai fost ocupat doar cu aceste interogări.
Apoi vedem rânduri pe secundă. Știm câte rânduri pe secundă au fost returnate.
Și mai departe este o altă chestiune interesantă. Câte shared_buffers am citit pe secundă din shared_buffers. Hiturile erau deja acolo, iar rândurile le-am preluat din cache-ul sistemului de operare sau din disk. Prima variantă este rapidă, iar a doua poate fi rapidă, dar poate nu, depinde de situație.
Iar a doua metodă de diferențiere – împărțim numărul de cereri din acest grup. În a doua coloană vei avea întotdeauna o cerere împărțită la cerere. Și apoi devine interesant – câte milisecunde au fost în această cerere. Știm cum se comportă în medie această cerere. 101 milisecunde erau necesare pentru fiecare cerere. Aceasta este o metrică tradițională de care avem nevoie pentru înțelegere.
Câte rânduri a returnat fiecare cerere în medie. Vedem că acest grup returnează 8. Câte dintre acestea au fost preluate și citite din cache în medie. Observăm că totul este foarte bine cache-uit. Doar hituri pentru primul grup.
Și a patra sublinie din fiecare linie – este câte procente din total. Avem calls. Să presupunem, în 1 000 000. Și putem înțelege ce contribuție aduce acest grup. Vedem că în acest caz, prima grupare are o contribuție mai mică de 0,01%. Adică, este atât de lentă încât nu o vedem în imaginea de ansamblu. Iar a doua grupare – 5% din apeluri. Adică, 5% din toate apelurile sunt din a doua grupare.
De asemenea, este interesant și pentru total_time. Pentru prima grupă de cereri am cheltuit 14% din tot timpul de funcționare. Iar pentru a doua – 11% și așa mai departe.
Nu mă voi adânci în detalii, dar există nuanțe. Afișăm o eroare în partea de sus, pentru că atunci când comparăm, instantaneele pot fi distorsionate, adică unele cereri pot lipsi, iar în a doua fază deja nu mai pot fi prezente, iar altele pot apărea noi. Și acolo calculăm eroarea. Dacă vezi 0, atunci este bine. Nu sunt erori. Dacă rata de eroare este de până la 20%, este în regulă.
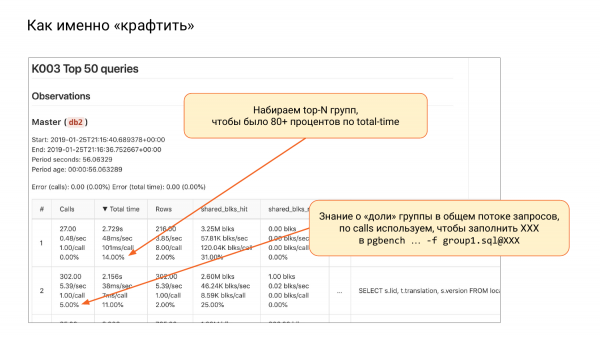
Apoi ne întoarcem la tema noastră. Trebuie să creăm workload-ul. Luăm de sus în jos, până când strângem 80% sau 90%. De obicei, sunt 10-20 de grupuri. Și facem fișiere pentru pgbench. Acolo folosim random. Uneori, din păcate, nu se reușește. Iar în Postgres 12 vor fi mai multe oportunități de a folosi acest tip de abordare.
Și apoi, în acest mod, atingem 80-90 % din total_time. Ce ar trebui să introducem după «@»? Ne uităm la apeluri, vedem ce procente sunt și înțelegem că aici ar trebui să avem un anumit procent. Din aceste procente putem înțelege cum să echilibrăm fiecare dintre fișiere. După aceea, folosim pgbench și ne apucăm de lucru.
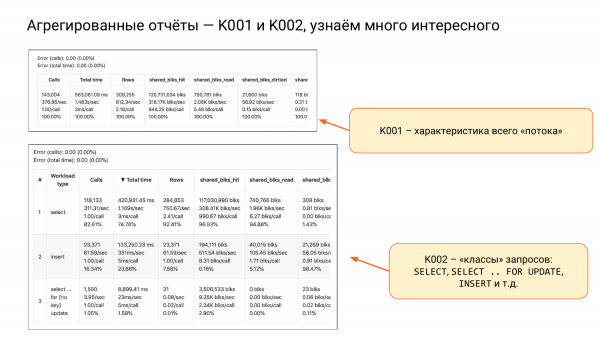
Mai avem K001 și K002.
K001 – este un singur string mare cu patru sub-stringuri. Aceasta caracterizează întreaga noastră încărcare. Uitați-vă la a doua coloană și la al doilea sub-string. Vedem că aproximativ o jumătate de secundă pe secundă, adică dacă avem două nuclee, va fi bine. Va fi aproximativ 75 % din încărcare. Așa va funcționa. Dacă avem 10 nuclee, atunci vom fi foarte liniștiți. Astfel putem evalua resursele.
K002 – acestea sunt clasele de solicitări, adică SELECT, INSERT, UPDATE, DELETE. Și separat SELECT FOR UPDATE, pentru că acesta blochează.
Și aici putem concluziona că SELECT-urile normale, de citire – reprezintă 82 % din toate apelurile, dar în același timp – 74 % din total_time. Adică sunt apelate frecvent, dar consumă mai puține resurse.
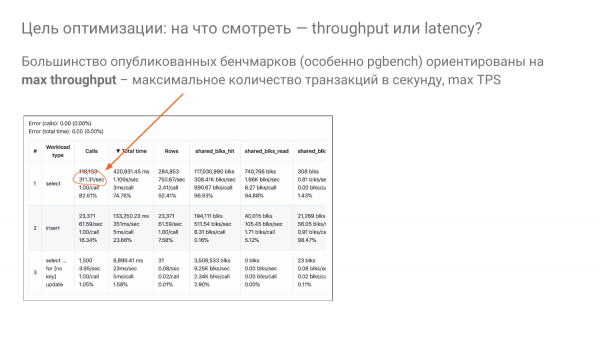
Și revenind la întrebarea: «Cum ne putem stabili corect shared_buffers?». Observ că majoritatea benchmarkurilor se bazează pe ideea – haideți să vedem care va fi throughput-ul, adică care va fi capacitatea de procesare. Aceasta este măsurată de obicei în TPS sau QPS.
Și încercăm să extragem din mașină cât mai multe tranzacții pe secundă prin intermediul parametrilor de tuning. Aici avem 311 pe secundă pentru select.
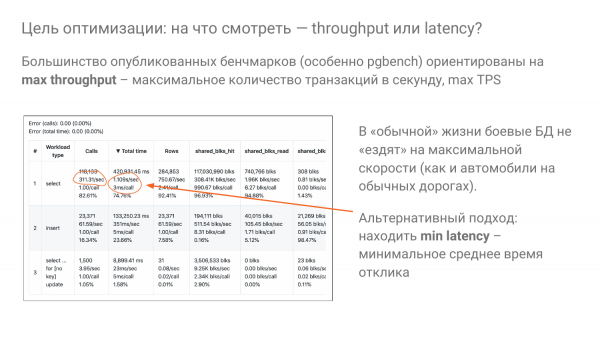
Dar nimeni nu merge la muncă și înapoi acasă cu mașina pe viteză maximă. Este prostesc. La fel este și cu bazele de date. Nu ar trebui să circulăm pe viteză maximă, iar nimeni nu o face. Nimeni nu trăiește în producție cu 100% CPU. Deși poate cineva o face, dar nu este bine.
Ideea este că circulăm de obicei la aproximativ 20% din capacitate, de preferință nu mai mult de 50%. Și ne străduim să optimizăm timpul de răspuns pentru utilizatorii noștri în primul rând. Adică trebuie să ne ajustăm sistemele astfel încât să avem o latență minimă la o viteză de 20%, în mod condiționat. Aceasta este ideea pe care încercăm să o folosim în experimentele noastre.
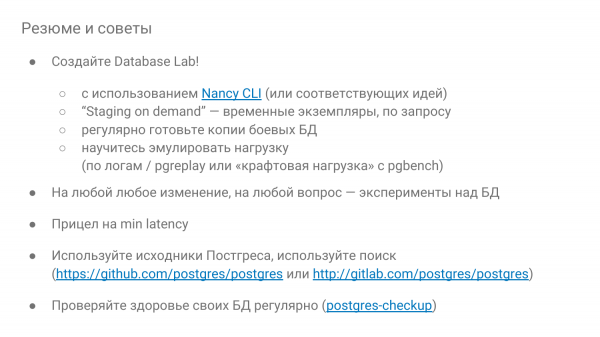
Și în concluzie, recomandările:
- Asigurați-vă că faceți Database Lab.
- Dacă este posibil, faceți-l on demand, pentru a se desfășura pentru o anumită perioadă – jucați-vă și apoi eliminați-l. Dacă aveți clouduri, aceasta este evident, adică aveți multe instanțe disponibile.
- Fiți curioși. Și dacă ceva nu este în regulă, verificați prin experimente cum se comportă. Nancy poate fi folosită pentru a vă instrui pe voi înșivă, pentru a verifica cum funcționează baza de date.
- Și vizați un timp minim de răspuns.
- Și nu vă temeți de sursele Postgres. Când lucrați cu sursele, trebuie să știți engleză. Sunt multe comentarii acolo, totul este explicat.
- Și verificați sănătatea bazei de date regulat, cel puțin o dată la trei luni, fie manual, fie cu Postgres-checkup.
Întrebări
Mulțumesc mult! Este o idee foarte interesantă.
Două lucruri.
Da, două lucruri. Numai că nu am înțeles complet. Când lucrăm cu Nancy, putem ajusta doar un parametru sau un grup întreg?
Noi avem parametru delta-config. Puteți ajusta câte doriți simultan. Dar trebuie să înțelegeți că, atunci când schimbați multe lucruri, s-ar putea să trageți concluzii greșite.
Da. De ce am întrebat? Pentru că este greu să conduceti experimente când aveți doar un singur parametru. Îl ajustați, verificați cum funcționează. L-ați setat. Apoi începeți cu următorul.
Puteți ajusta simultan, dar depinde de situație, desigur. Dar este mai bine să verificați o singură idee. Ieri ne-a venit o idee. Am avut o situație foarte asemănătoare. Au fost două configurații. Și nu am putut înțelege de ce există o diferență mare. Și ne-a venit ideea că trebuie să folosim dicotomia pentru a înțelege treptat și a găsi în ce constă diferența. Puteți face imediat jumătate din parametrii identici, apoi o pătrime, și așa mai departe. Totul este flexibil.
Și mai am o întrebare. Proiectul este tânăr, se dezvoltă. Documentația este deja gata, există o descriere detaliată?
Am făcut acolo o legătură specială către descrierea parametrilor. Aceasta există. Dar multe lucruri nu sunt încă gata. Caut oameni cu aceleași idei. Și îi găsesc când țin prezentări. Este foarte grozav. Cineva colaborează deja cu mine, cineva m-a ajutat și a făcut ceva acolo. Și dacă sunteți interesați de acest subiect, vă rugăm să ne oferiți feedback - ce vă lipsește.
Când vom avea laboratorul, poate va exista feedback. Vom vedea. Mulțumesc!
Bună ziua! Mulțumesc pentru prezentare! Am observat că există suport pentru Amazon. Este planificată și suportul pentru GSP?
O întrebare bună. Am început să lucrăm la asta. Și deocamdată am suspendat, deoarece dorim să economisim. Adică, există suport prin executarea pe localhost. Puteți crea singur un instance și lucra local. Apropo, așa facem. La Getlab fac asta, acolo pe GSP. Dar acum nu vedem sensul de a face o astfel de orchestrare, deoarece Google nu are spoturi ieftine. Există ??? instances, dar au restricții. În primul rând, aceștia oferă întotdeauna doar o reducere de 70% și nu se poate negocia prețul. La spoturi, creștem prețul cu 5-10% pentru a reduce probabilitatea ca să fiți eliminați. Adică, economisiți cu spoturile, dar acestea vă pot fi luate oricând. Dacă faceți un preț puțin mai mare decât ceilalți, veți fi eliminați mai repede. Google are o specificație complet diferită. Și mai există o restricție foarte neplăcută - acestea trăiesc doar 24 de ore. Dar uneori dorim să desfășurăm un experiment timp de 5 zile. Însă asta se poate face la spoturi, uneori acestea rămân active luni întregi.
Bună ziua! Vă mulțumesc pentru prezentare! Ați menționat despre controlul stării. Cum calculați erorile stat_statements?
O întrebare foarte bună. Pot să explic și să arăt foarte detaliat. Pe scurt - ne uităm la cum a evoluat grupul de cereri: câte au eșuat și câte noi au apărut. Apoi ne uităm la două metrice: total_time și calls, așa că sunt două erori. Și analizăm contribuția grupurilor afectate. Există două subgrupuri: cele care s-au retras și cele care au apărut. Observăm contribuția lor în imaginea generală.
Nu vă temeți că s-ar putea relua de două-trei ori între instantaneele de captură?
Adică, s-au înregistrat din nou sau cum?
De exemplu, această cerere a fost deja eliminată o dată, apoi a venit din nou și a fost eliminată, apoi a venit din nou și a fost eliminată. Și voi ați calculat ceva, dar unde este totul?
O întrebare bună, trebuie să analizăm.
Am făcut un lucru similar. Desigur, pe o scară mai mică, l-am realizat singur. Dar a trebuit să resetez, să fac reset la stat_statements și să mă orientez în momentul instantaneei de captură, că trebuie să existe o anumită proporție mai mică, că totuși nu a ajuns la maximul pe care stat_statements îl poate acumula. Și mă orientez că, cel mai probabil, nu s-a eliminat nimic.
Da-da.
Dar nu înțeleg cum să fac altfel în mod fiabil.
Din păcate, nu îmi amintesc exact - folosim textul cererii sau queryid de la pg_stat_statements și ne orientăm după el. Dacă ne orientăm după queryid, atunci, teoretic, comparăm lucruri comparabile.
Nu, el poate fi înlocuit de mai multe ori între snapshot-uri și poate reveni din nou.
Cu același ID?
Da.
O să ne uităm la asta. O întrebare bună. Trebuie să studiem. Dar până acum, ceea ce vedem este că avem fie 0 scris...
Asta, desigur, este un caz rar, dar am fost zguduit când am aflat că stat_statements poate fi înlocuit acolo.
În Pg_stat_statements poate fi multe lucruri. Ne-am confruntat cu situația în care, dacă aveți track_utility = on, atunci seturile sunt de asemenea urmărite.
Da, desigur.
Și dacă aveți java hibernate, care este aleatorie, atunci începe să se blocheze tabela hash. Și imediat ce dezactivați o aplicație foarte solicitată, ajungeți la 50-100 de grupuri. Și acolo totul devine mai mult sau mai puțin stabil. Una dintre metodele de combatere a acestui lucru este de a crește pg_stat_statements.max.
Da, dar trebuie să știi cât de mult. Și trebuie să-l monitorizăm. Așa fac eu. Adică, am pg_stat_statements.max. Și mă uit, la momentul snapshot-ului nu am ajuns la 70%. Bun, înseamnă că nu am pierdut nimic. Facem reset. Și acumulăm din nou. Dacă în următorul snapshot este mai puțin de 70, atunci înseamnă că, cel mai probabil, din nou nu am pierdut nimic.
Da. În mod implicit acum 5000. Și acest lucru este suficient pentru foarte mulți.
De obicei – da.
Video:
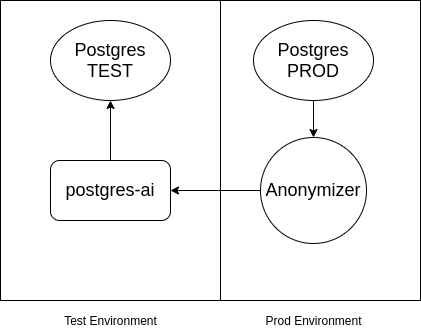
P.S. Din partea mea, adaug că dacă în Postgres se află date confidențiale și acestea nu trebuie să ajungă în medii de testare, atunci se poate folosi . Schema este aproximativ următoarea:
Sursa: habr.com
