

Recent am vorbit despre cum, cu ajutorul unor rețete standard din baza de date PostgreSQL. Astăzi, vom discuta despre cum putem face mai eficient scrierea în Bază de Date fără a folosi vreun „control” în configurație — doar organizând corespunzător fluxurile de date.
#1. Секционирование
Articol despre cum și de ce ar trebui să organizăm a fost deja scris, aici vom vorbi despre practica aplicării unor abordări în cadrul serviciului nostru .
„Zilele de demult...”
La început, ca orice MVP, proiectul nostru a început cu o sarcină destul de mică — monitorizarea se efectua doar pentru câteva zeci de cele mai critice servere, toate tabelele fiind relativ compacte... Dar timpul a trecut, gazdelor monitorizate devenind din ce în ce mai multe, și încercând din nou să facem ceva cu una dintre tabelele de 1.5TB, ne-am dat seama că se poate trăi așa, dar este extrem de incomod.
Vremurile erau aproape legendare, erau relevante diverse variante PostgreSQL 9.x, așa că toată partiționarea a trebuit să fie realizată „manual” — prin moștenirea tabelelor și declanșatoarele routingului cu dinamic EXECUTE.
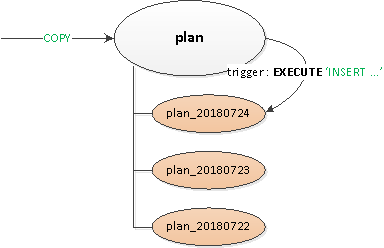
Soluția rezultată s-a dovedit destul de universală, astfel încât să poată fi transformată pentru toate tabelele:
- A fost declarată o tabelă „header” goală, pe care erau descrise toate indiciile și declanșatoarele necesare.
- Scrierea din perspectiva clientului se realiza în tabelul „rădăcină”, iar în interior, cu ajutorul declanșatorului de routing
BEFORE INSERTscrierea era „fizic” inserată în secțiunea dorită. Dacă nu exista încă — prindeam o excepție și ... - … cu ajutorul conform șablonului tabelei părinte se crea o secțiune cu o restricție pe data dorită, astfel încât la extragerea datelor citirea să se efectueze doar în ea.
PG10: prima încercare
Dar partiționarea prin moștenire nu a fost istoric foarte adaptată pentru a lucra cu un flux activ de scriere sau cu un număr mare de secțiuni descendente. De exemplu, putem aminti că algoritmul de selecție a secțiunii dorite avea complexitate pătratică, ceea ce, în cazul a 100+ secțiuni, funcționează, înțelegeți cum...
În PG10, această situație a fost îmbunătățită semnificativ, implementând suportul . Așadar, am încercat imediat să o aplicăm după migrarea stocării, dar...
După cum s-a dovedit în urma consultării manualului, o masă secționată nativ în această versiune:
- nu suportă descrierea indicilor
- nu acceptă trigger-e
- nu poate fi ea însăși un «descendent» al nimănui
- nu suportă
INSERT ... ON CONFLICT - nu generează automat secțiuni
După ce ne-am lovit serios de această problemă, am realizat că nu putem evita modificarea aplicației și am amânat cercetările ulterioare timp de șase luni.
PG10: a doua șansă
Așadar, am început să rezolvăm problemele apărute pe rând:
- Fiindcă trigger-ele și
ON CONFLICTne-au fost necesare în unele cazuri, am creat o masă proxy intermediară. - Am eliminat «rutarea» în trigger-e — adică
EXECUTE. - Am separat masa-templu cu toți indicii, astfel încât să nu fie nici măcar prezentați în masa proxy.
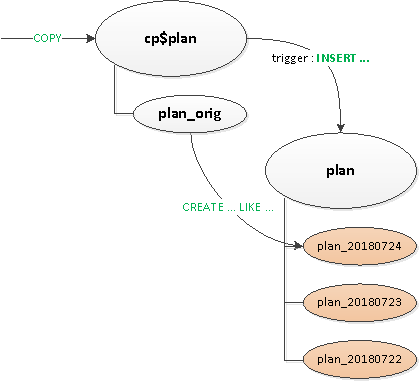
În cele din urmă, după toate acestea, am secționat nativ masa principală. Crearea unei noi secțiuni a rămas, totuși, în responsabilitatea aplicației.
«Creăm» dicționare
Ca în orice sistem analitic, am avut și noi «fapte» și «dimensiuni» (dicționare). În cazul nostru, acestea erau, de exemplu, cererilor lente sau textul cererii însăși.
«Faptele» noastre erau deja secționate pe zile de mult timp, așa că am șters cu ușurință secțiunile învechite, ele nu ne deranjau (deoarece erau doar jurnale!). Însă cu dicționarele a fost o problemă...
Nu că ar fi fost foarte multe, dar aproximativ pentru 100 TB de «fapte», am obținut un dicționar de 2.5 TB.Dintr-o astfel de masă, nu poți șterge nimic cu ușurință, nu poți să o comprimi în timp rezonabil, iar scrierea în ea devenea treptat tot mai lentă.
Se pare că este un dicționar... fiecare înregistrare ar trebui să fie prezentă exact o dată... și asta este corect, dar!... Nu ne împiedică nimeni să avem câte un dicționar pentru fiecare zi! Da, asta aduce o anumită redundanță, dar permite:
- să scriem/citim mai repede datorită dimensiunii mai mici a secțiunii
- să consumăm mai puțină memorie datorită lucrului cu indici mai compacți
- să stocăm mai puține date datorită posibilității de a șterge rapid înregistrările învechite,
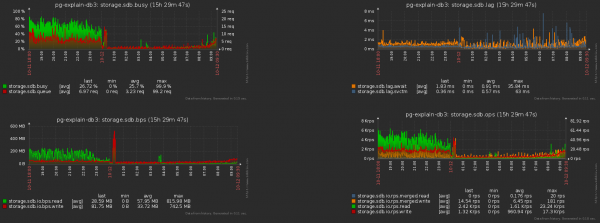
Ca urmare a întregului complex de măsuri încărcarea CPU-ului a scăzut cu aproximativ 30%, iar pe disc — cu aproximativ 50%:
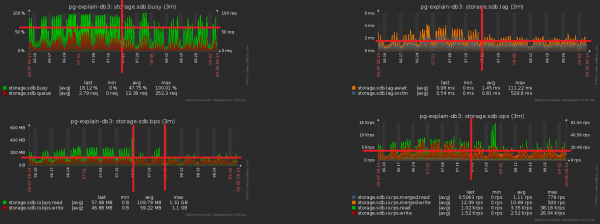
În același timp, am continuat să scriem în baza de date exact același lucru, doar cu o încărcare mai mică.
#2. Эволюция и рефакторинг БД
Așadar, ne-am oprit la faptul că avem pentru fiecare zi o secțiune cu date. De fapt, CHECK (dt = '2018-10-12'::date) — acesta este cheia secționării și condiția de includere a înregistrării în secțiunea specifică.
Deoarece toate raportele din serviciul nostru sunt construite pe baza unei date specifice, indecșii din vremurile "nemodificate" pentru acestea au fost toți de tipul (Server, Data, Șablon plan), (Server, Data, Nod plan), (Data, Clasa de eroare, Server),…
Dar acum, în fiecare secțiune trăiesc exemplare proprii fiecărui astfel de index… Și în cadrul fiecărei secțiuni data este o constantă… Rezultatul este că acum în fiecare astfel de index scriem pur și simplu constantă ca unul dintre câmpuri, ceea ce face ca volumul său și timpul de căutare să crească, dar nu aduce niciun rezultat. Ne-am lăsat singuri capcane, ups…
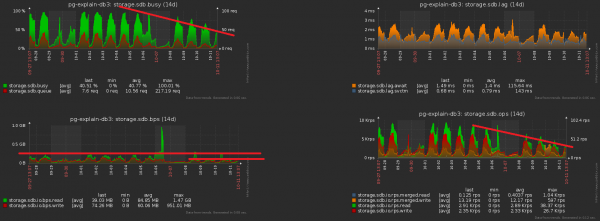
Direcția de optimizare este evidentă — pur și simplu îndepărtăm câmpul cu data din toate indecșii de pe tabelele secționate. La volumele noastre, câștigul este de aproximativ 1TB/săptămână!
Și acum să observăm că acest terabyte trebuia, cumva, și înregistrat. Cu alte cuvinte, trebuie să încărcăm discul mai puțin! În această imagine se poate vedea bine efectul obținut din curățenia realizată, căreia i-am dedicat o săptămână:
#3. «Размазываем» пиковую нагрузку
Una dintre marile probleme ale sistemelor supraîncărcate este sincronizarea excesivă a unor operațiuni care nu o necesită. Uneori „pentru că nu s-a observat”, alteori „era mai simplu”, dar mai devreme sau mai târziu trebuie să scăpăm de ea.
Apropiem imaginea anterioară — și vedem că discul nostru „încarcă” cu o amplitudine de două ori mai mare între măsurători adiacente, ceea ce „statistic” nu ar trebui să fie având în vedere numărul de operațiuni:
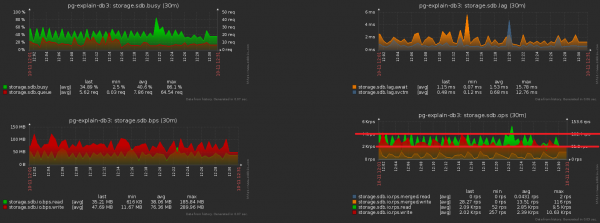
Este destul de simplu să obții acest lucru. La monitorizare am avut deja aproape 1000 de servere, fiecare fiind procesat de un flux logic separat, iar fiecare flux trimite informația acumulată pentru a fi trimisă în bază cu o periodicitate specifică, cam așa:
setInterval(sendToDB, interval)Problema se află exact în faptul că toate fluxurile pornesc cam în același timp, de aceea momentele de trimitere coincid aproape întotdeauna „palpabil”. Ups nr. 2…
Din fericire, acest lucru se corectează destul de ușor, adăugând o „dispersie” aleatorie în timp:
setInterval(sendToDB, interval * (1 + 0.1 * (Math.random() - 0.5)))#4. Кэшируем, что нужно можно
A treia problemă tradițională highload — lipsa cache-ului acolo unde el ar putea fi.
De exemplu, am implementat posibilitatea de analiză pe baza nodurilor planului (toate acestea Seq Scan pe utilizatori), dar ne-am gândit imediat că ele, în masă, sunt identice — am uitat.
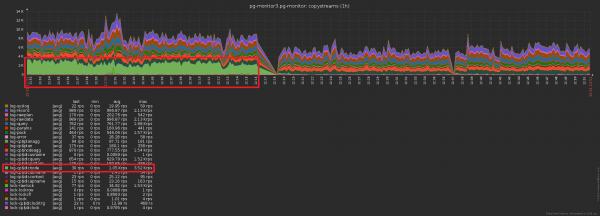
Nu, desigur, în baza nu se scrie nimic încă o dată, asta blochează trigger-ul cu INSERT ... ON CONFLICT DO NOTHING. Dar până la baza de date, aceste date ajung totuși, iar citirea suplimentară pentru verificarea conflictelor trebuie să o facem. Ups №3… Diferența în numărul de înregistrări trimise în bază înainte/după activarea caching-ului — este evidentă:
Și aceasta — o cădere asociată a încărcării pe stocare:
«Terabyte-pe-zi» doar pare înfricoșător. Dacă faceți totul corect, atunci este doar
În concluzie
2^40 bytes / 86400 sec = ~12.5MB/s , ceea ce au putut chiar și unitățile SATA de birou. 🙂Dar, ca să fiu serios, chiar și cu un „dezechilibru” de zece ori al încărcării pe parcursul zilei, puteți să vă încadrați ușor în capacitățile SSD-urilor moderne.
Economisim niște bani pe volume mari în PostgreSQL
Sursa: habr.com
