

Efectul de umflare a tabelelor și indexurilor (bloat) este bine cunoscut și nu este prezent doar în Postgres. Există metode de combatere a acestuia „din cutie”, cum ar fi VACUUM FULL sau CLUSTER, dar acestea blochează tabelele în timpul utilizării și, prin urmare, nu pot fi întotdeauna utilizate.
Articolul va conține puțină teorie despre cum apare bloat-ul, cum poate fi combătut, despre constrângerile deferred și problemele pe care le aduc în utilizarea extensiei pg_repack.
Acest articol este bazat pe de la PgConf.Russia 2020.
De ce apare bloat-ul
La baza Postgres se află un model multiversional (). Esența acestuia este că fiecare rând dintr-un tabel poate avea mai multe versiuni, iar tranzacțiile văd nu mai mult de una dintre aceste versiuni, dar nu neapărat aceeași. Aceasta permite mai multor tranzacții să funcționeze simultan și să nu se influențeze practic una pe alta.
Este evident că toate aceste versiuni trebuie păstrate. Postgres lucrează cu memoria pe pagini și pagina este volumul minim de date care poate fi citit de pe disc sau înregistrat. Să analizăm un exemplu mic pentru a înțelege cum se întâmplă acest lucru.
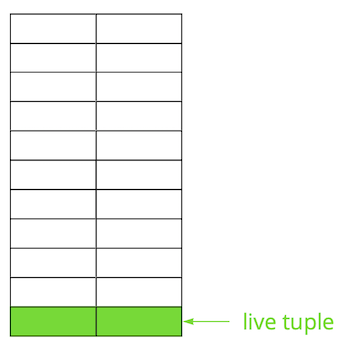
Să presupunem că avem un tabel în care am adăugat mai multe înregistrări. În prima pagină a fișierului în care este stocat tabelul, au apărut date noi. Acestea sunt versiunile active ale rândurilor, disponibile altor tranzacții după comitere (pentru simplitate, să presupunem că nivelul de izolare este Read Committed).
Apoi, am actualizat una dintre înregistrări, marcând astfel versiunea veche ca fiind neactuală.
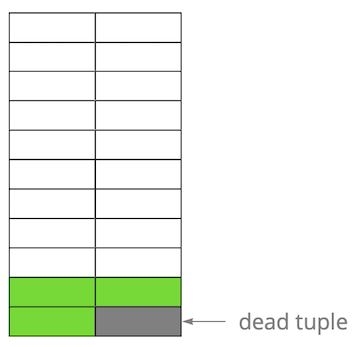
Pas cu pas, actualizând și ștergând versiunile rândurilor, am obținut o pagină în care aproximativ jumătate din date constituie „gunoi”. Aceste date nu sunt vizibile pentru nicio tranzacție.
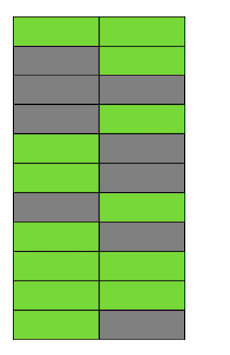
În Postgres există un mecanism , care șterge versiunile neactuale și eliberează loc pentru date noi. Dar dacă acesta nu este configurat suficient de agresiv sau este ocupat cu lucrări în alte tabele, atunci „datele de gunoi” rămân și trebuie să folosim pagini suplimentare pentru datele noi.
Astfel, în exemplul nostru, într-un anumit moment, tabelul va consta din patru pagini, dar datele active din el vor reprezenta doar jumătate. Ca rezultat, când accesăm tabelul, vom citi mult mai multe date decât este necesar.
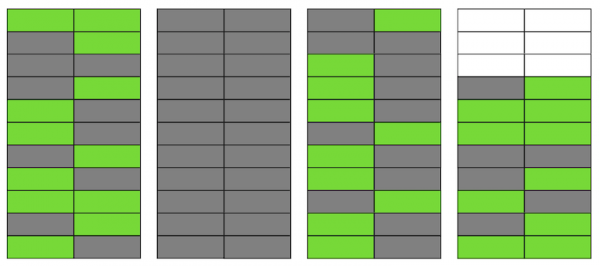
Chiar dacă VACUUM elimină acum toate versiunile de rânduri neactuale, situația nu se va îmbunătăți radical. Vom avea spațiu liber pe pagini sau chiar pagini întregi pentru rânduri noi, dar tot vom citi mai multe date decât este necesar.
Apropo, dacă pagina complet goală (a doua în exemplul nostru) ar fi fost la sfârșitul fișierului, VACUUM ar fi putut să o taie. Dar acum se află la mijloc, așa că nu se poate face nimic cu ea.
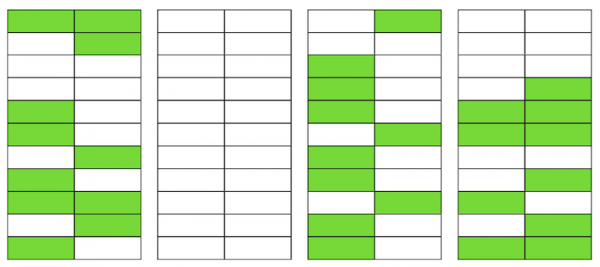
Când numărul acestor pagini goale sau foarte sparse devine mare, ceea ce se numește bloat, aceasta începe să afecteze performanța.
Tot ceea ce am descris mai sus este mecanica apariției bloat în tabele. În indexuri, acest lucru se întâmplă cam la fel.
Am eu bloat?
Există mai multe metode pentru a determina dacă aveți bloat. Ideea primei este utilizarea statisticilor interne PostgreSQL, care conțin informații aproximative despre numărul de rânduri din tabele, numărul de rânduri „viabile” etc. Pe internet puteți găsi multe variații de scripturi deja gata. Noi ne-am bazat pe de la PostgreSQL Experts, care poate evalua bloat-ul tabelelor, împreună cu toast și bloat-ul indexurilor btree. Din experiența noastră, eroarea sa este de 10-20%.
O altă metodă este utilizarea extensiei , care permite să priviți înăuntrul paginilor și să obțineți atât o evaluare, cât și o valoare exactă a bloat-ului. Dar în cazul celui de-al doilea, va trebui să scanați întreaga tabelă.
O valoare mică de bloat, de până la 20%, este considerată acceptabilă. Poate fi considerată similar cu fillfactor pentru și . La 50% și mai sus pot apărea probleme de performanță.
Moduri de combatere a bloat-ului
În Postgres există mai multe metode de combatere a bloat-ului „din cutie”, dar acestea nu sunt întotdeauna adecvate pentru toți.
Configurați AUTOVACUUM astfel încât să nu apară bloat.Și, mai exact, pentru a se menține la un nivel acceptabil pentru tine. Pare a fi un sfat „de căpitan”, dar în realitate nu este întotdeauna ușor de realizat. De exemplu, dacă ai un proces activ de dezvoltare cu modificări regulate ale schemei de date sau se desfășoară o migrare a datelor. Drept urmare, profilul tău de încărcare se poate schimba frecvent și, de obicei, este diferit pentru diferite tabele. Asta înseamnă că trebuie să lucrezi constant ușor înainte și să ajustezi AUTOVACUUM în funcție de profilul în continuă schimbare al fiecărei tabele. Dar este evident că a face acest lucru nu este simplu.
O altă cauză comună pentru care AUTOVACUUM nu reușește să proceseze tabelele este prezența tranzacțiilor lungi, care nu îi permit să curețe datele deoarece acestea sunt accesibile acestor tranzacții. Recomandarea aici este, de asemenea, evidentă – scăpați de tranzacțiile „suspendate” și minimizați timpul tranzacțiilor active. Dar dacă încărcarea aplicației tale este un hibrid OLAP și OLTP, atunci poți avea simultan atât multe actualizări frecvente și interogări scurte, cât și operațiuni lungi – de exemplu, generarea unui raport. În această situație, ar trebui să te gândești la distribuirea sarcinii pe diferite baze de date, ceea ce va permite o reglare mai fină a fiecărei dintre ele.
Un alt exemplu – chiar dacă profilul este uniform, dar baza de date se află sub o încărcare foarte mare, chiar și un AUTOVACUUM maxim agresiv poate să nu facă față și bloat-ul va apărea. Scalarea (verticală sau orizontală) este singura soluție.
Ce să faci în situația în care ai configurat AUTOVACUUM, dar bloat-ul continuă să crească.
Comanda VACUUM FULL reconstruiește conținutul tabelelor și indexurilor lăsându-le doar cu datele actuale. Pentru eliminarea bloat-ului, funcționează perfect, dar în timpul execuției sale, se blochează exclusiv tabelele (AccessExclusiveLock), ceea ce nu permite executarea interogărilor pe această tabelă, nici măcar select-urile. Dacă îți poți permite să oprești serviciul sau o parte din acesta pentru o perioadă de timp (de la zeci de minute la câteva ore, în funcție de dimensiunea bazei de date și hardware-ul tău), atunci această opțiune este cea mai bună. Din păcate, nu reușim să rulăm VACUUM FULL în timpul întreținerii planificate, așa că această metodă nu ne este potrivită.
Comanda CLUSTER reconstruiește conținutul tabelelor la fel ca VACUUM FULL, însă permite specificarea unui index conform căruia datele vor fi ordonate fizic pe disc (dar pentru noile rânduri, ordinea nu este garantată în viitor). În anumite situații, aceasta este o optimizare bună pentru diverse interogări – cu citirea mai multor înregistrări pe index. Dezavantajul comenzii este același ca pentru VACUUM FULL – blochează tabelul în timpul funcționării.
Comanda REINDEX este similară cu cele două anterioare, dar efectuează reconstruirea unui index specific sau a tuturor indiciilor din tabel. Blocările sunt puțin mai slabe: ShareLock pe tabel (îngreunează modificările, dar permite execuția select) și AccessExclusiveLock pe indexul reconstruit (blochează interogările care utilizează acest index). Totuși, în versiunea 12 a Postgres a apărut parametrul , care permite reconstruirea indexului fără a bloca adăugarea, modificarea sau ștergerea înregistrărilor în paralel.
În versiunile anterioare ale Postgres, se poate obține un rezultat similar cu REINDEX CONCURRENTLY folosind . Acesta permite crearea unui index fără o blocare strictă (ShareUpdateExclusiveLock, care nu împiedică interogările paralele), apoi înlocuirea indexului vechi cu cel nou și ștergerea indexului vechi. Acest lucru permite eliminarea bloat-ului din indici fără a afecta funcționarea aplicației dumneavoastră. Este important de menționat că, în timpul reconstruirii indicilor, va exista o sarcină suplimentară pe subsistemul de discuri.
Astfel, dacă pentru indici există modalități de eliminare a bloat-ului „în timp real”, pentru tabele nu există. Aici intervin diverse extensii externe: (cunoscut anterior ca pg_reorg), , și altele. În cadrul acestui articol nu le voi compara și voi vorbi doar despre pg_repack, pe care, după câteva ajustări, îl folosim la noi.
Cum funcționează pg_repack
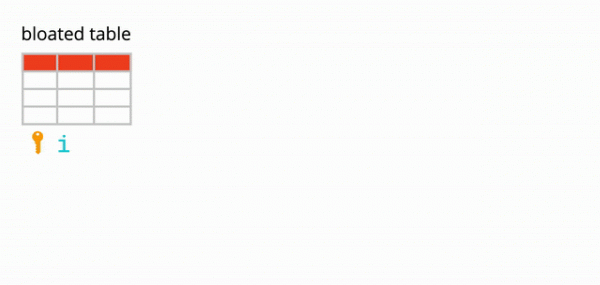
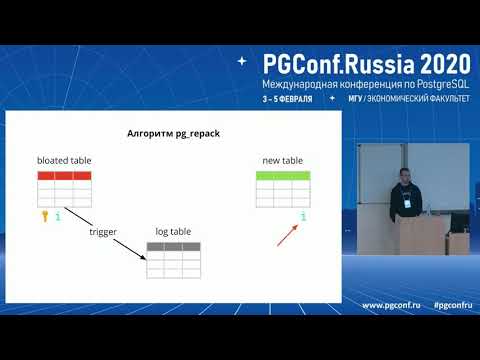
Să zicem că avem un tabel complet normal – cu indici, constrângeri și, din păcate, cu bloat. Primul pas pe care îl face pg_repack este să creeze o tabelă de log, pentru a stoca date despre toate modificările efectuate în timpul funcționării. Un trigger va replica aceste modificări la fiecare insert, update și delete. Apoi se creează o tabelă similară cu cea originală, dar fără indici și constrângeri, pentru a nu încetini procesul de inserare a datelor.
Apoi, pg_repack transferă datele din vechea tabelă în una nouă, filtrând automat toate înregistrările neactualizate, și apoi creează indecși pentru noua tabelă. Pe parcursul tuturor acestor operații, modificările se acumulează în tabelul de jurnal.
Următorul pas este să transferăm modificările în noua tabelă. Transferul se realizează în mai multe iterații, iar când în tabelul de jurnal rămân mai puțin de 20 de înregistrări, pg_repack captează o blocare strictă, transferă ultimele date și înlocuiește vechea tabelă cu noua în tabelele de sistem Postgres. Aceasta este singura și foarte scurtă perioadă în care nu veți putea lucra cu tabela. După aceea, vechea tabelă și tabelul de jurnale sunt șterse, eliberând astfel spațiu în sistemul de fișiere. Procesul este finalizat.
În teorie, totul arată excelent, dar ce se întâmplă în practică? Am testat pg_repack fără sarcină și sub sarcină, verificând modul în care funcționează în cazul unei opriri premature (cu alte cuvinte, prin Ctrl+C). Toate testele au fost pozitive.
Am ajuns pe produs — și aici lucrurile nu au decurs așa cum ne așteptam.
Prima încercare pe produs
Pe primul cluster, am întâmpinat o eroare legată de încălcarea constrângerii unice:
$ ./pg_repack -t tablename -o id
INFO: rearanjarea tabelului "tablename"
ERROR: interogarea a eșuat:
    ERROR: valoarea cheii duplicat încalcă constrângerea unică "index_16508"
DETALII: Cheia (id, index)=(100500, 42) există deja.
Această constrângere avea un nume generat automat, index_16508 – a fost creată de pg_repack. După atributele incluse în ea, am identificat „constrângerea noastră” corespunzătoare. Problema s-a dovedit a fi că aceasta nu era o constrângere obișnuită, ci una amânată (), adică verificarea acesteia se face mai târziu decât comanda SQL, ceea ce conduce la consecințe neașteptate.
Constrângeri amânate: de ce sunt necesare și cum funcționează
Puțină teorie despre constrângerile amânate.
Să luăm un exemplu simplu: avem o tabelă de referință pentru automobile cu două atribute – denumirea și ordinea automobilelor în referință.
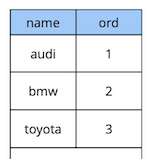
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique
);
Să presupunem că dorim să schimbăm locurile primelor două automobile. Soluția „directă” este să actualizăm prima valoare cu a doua și a doua cu prima:
begin;
  update cars set ord = 2 where name = 'audi';
  update cars set ord = 1 where name = 'bmw';
commit;
Dar, la executarea acestui cod, ne vom aștepta să primim o încălcare a constrângerii, deoarece ordinea valorilor din tabelă este unică:
[23305] EROARE: valoarea cheii duplicate încalcă constrângerea unică “uk_cars”
Detaliu: Cheia (ord)=(2) deja există.
Cum să facem altfel? Prima variantă: adăugați o înlocuire suplimentară a valorii pentru ordinea care cu siguranță nu există în tabel, de exemplu “-1”. În programare, aceasta se numește „schimbarea valorilor a două variabile printr-o a treia”. Singurul dezavantaj al acestei metode este actualizarea suplimentară.
A doua variantă: reproiectați tabelul pentru a folosi pentru valoarea ordinii un tip de date cu virgulă mobilă în loc de numere întregi. Astfel, la actualizarea valorii de la 1, de exemplu, la 2.5, prima înregistrare se va „așeza” automat între a doua și a treia. Aceasta este o soluție funcțională, dar există două limitări. În primul rând, nu va funcționa dacă valoarea este utilizată undeva în interfață. În al doilea rând, în funcție de precizia tipului de date, veți avea un număr limitat de inserții posibil până la recalcularea valorilor tuturor înregistrărilor.
A treia variantă: faceți constrângerea amânată, astfel încât să fie verificată doar în momentul comiterii:
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique deferrable initially deferred
);
Deoarece logica cererii noastre inițiale garantează că la momentul comiterii toate valorile sunt unice, aceasta va fi executată cu succes.
Exemplul de mai sus, desigur, este foarte sintetic, dar ilustrează idea. În aplicația noastră, folosim constrângeri amânate pentru a implementa logica care se ocupă de rezolvarea conflictelor în timpul lucrului simultan al utilizatorilor cu obiecte-widget comune pe tablă. Utilizarea unor astfel de constrângeri ne permite să simplificăm puțin codul aplicației.
În general, în funcție de tipul de constrângere în Postgres, există trei niveluri de granularitate pentru verificarea acestora: nivel de rând, tranzacție și expresie.
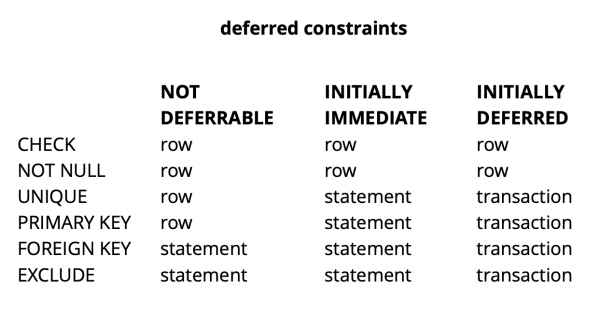
Sursa:
CHECK și NOT NULL sunt verificate întotdeauna la nivel de rând, pentru celelalte constrângeri, așa cum se poate vedea din tabel, există variante diferite. Detalii suplimentare pot fi citite .
În sumă, constrângerile amânate oferă un cod mai clar și un număr mai mic de comenzi în anumite situații. Cu toate acestea, acesta vine cu costul complicării procesului de depanare, deoarece momentul în care apare o eroare și momentul în care afli despre aceasta sunt desfășurate în timp. O altă problemă posibilă este că planificatorul nu poate construi întotdeauna un plan optim dacă în cerere este implicată o constrângere amânată.
Îmbunătățirea pg_repack
Am înțeles ce sunt constrângerile amânate, dar cum se leagă acestea de problema noastră? Să ne amintim de eroarea pe care am primit-o anterior:
$ ./pg_repack -t tablename -o id
INFO: rearanjarea tabelului "tablename"
ERROR: interogarea a eșuat:
    ERROR: valoarea cheii duplicat încalcă constrângerea unică "index_16508"
DETALII: Cheia (id, index)=(100500, 42) există deja.
Aceasta apare în momentul copierii datelor din tabela de jurnal în tabla nouă. Aparent, acest lucru este ciudat, deoarece datele din tabela de jurnal sunt comitate împreună cu datele din tabela originală. Dacă aceste date respectă constrângerile tabelei originale, cum pot ele încălca aceleași constrângeri în tabla nouă?
Se pare că rădăcina problemei se află în pasul anterior al funcționării pg_repack, în care se creează doar indecșii, dar nu și constrângerile: în tabela veche a existat o constrângere unică, iar în noua tabla a fost creat un indice unic în locul acesteia.
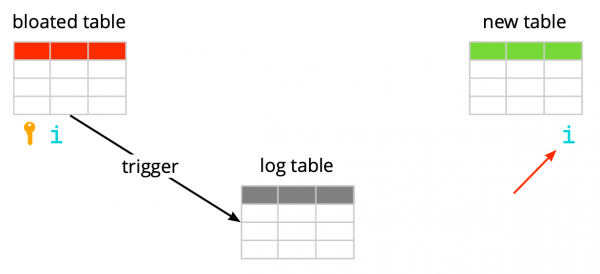
Este important de menționat că, dacă constrângerea este obișnuită și nu amânată, indicele unic creat în locul ei este echivalent cu această constrângere, deoarece constrângerile unice în Postgres sunt implementate prin crearea unui indice unic. Dar în cazul unei constrângeri amânate, comportamentul nu este același, deoarece indicele nu poate fi amânat și este întotdeauna verificat în momentul executării comenzii SQL.
Astfel, esența problemei constă în 'amânarea' verificării: în tabela originală aceasta are loc în momentul comiterii, iar în noua tabela – în momentul execuției comenzii SQL. Așadar, trebuie să ne asigurăm că verificările se efectuează în mod identic în ambele cazuri: fie întotdeauna amânate, fie întotdeauna imediat.
Așadar, ce idei am avut.
Să creăm un indice similar cu deferred
Prima idee este de a efectua ambele verificări în mod imediat. Aceasta poate genera câteva false pozitive în ceea ce privește restricția, dar dacă acestea sunt puține, nu ar trebui să afecteze activitatea utilizatorilor, deoarece pentru ei astfel de conflicte sunt o situație normală. Ele apar, de exemplu, atunci când doi utilizatori încep să editeze simultan același widget, iar clientul celui de-al doilea utilizator nu reușește să primească informații că widgetul este deja blocat pentru editare de primul utilizator. În această situație, serverul îi transmite celui de-al doilea utilizator un refuz, iar clientul său revine asupra modificărilor și blochează widgetul. Ulterior, când primul utilizator finalizează editarea, al doilea va primi informația că widgetul nu mai este blocat și va putea repeta acțiunea sa.
Pentru ca verificările să fie întotdeauna în modul de urgență, am creat un nou index, similar cu restricția originală amânată:
CREATE UNIQUE INDEX CONCURRENTLY uk_tablename__immediate ON tablename (id, index);
-- rulează pg_repack
DROP INDEX CONCURRENTLY uk_tablename__immediate;
În mediul de testare am obținut doar câteva erori așteptate. Succes! Am reluat pg_repack pe producție și am întâmpinat 5 erori în primul cluster în prima oră de funcționare. Acesta este un rezultat acceptabil. Totuși, deja în al doilea cluster numărul erorilor a crescut de câteva ori și a trebuit să oprim pg_repack.
De ce s-a întâmplat asta? Probabilitatea de a apărea o eroare depinde de câți utilizatori lucrează simultan cu aceleași widget-uri. Se pare că în acel moment, datele stocate pe primul cluster aveau mult mai puține modificări concurente decât cele de pe celelalte, adică am avut pur și simplu "noroc".
Ideea nu a funcționat. La acel moment am văzut două alte opțiuni de soluționare: să rescriem codul nostru aplicațional pentru a renunța la restricțiile amânate sau să "învățăm" pg_repack să lucreze cu acestea. Am ales a doua variantă.
A schimba indecșii din noua tabelă cu restricții amânate din tabelă originală
Scopul modificării era evident – dacă tabela originală are o restricție amânată, atunci pentru nouă trebuie să creăm o astfel de restricție, nu un index.
Pentru a verifica modificările noastre, am scris un test simplu:
- tabelă cu restricție amânată și o înregistrare;
- inserăm în buclă date care intră în conflict cu înregistrarea existentă;
- facem update – datele nu mai intră în conflict;
- comitând modificările.
create table test_table
(
  id serial,
  val int,
  constraint uk_test_table__val unique (val) deferrable initially deferred
);
INSERT INTO test_table (val) VALUES (0);
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (0) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    COMMIT;
  END;
END LOOP;
Versiunea inițială a pg_repack cădea întotdeauna la primul insert, versiunea îmbunătățită a funcționat fără erori. Excelent.
Trecem în producție și din nou primim o eroare în aceeași fază de copiere a datelor din tabela de jurnal în nouă:
$ ./pg_repack -t tablename -o id
INFO: rearanjarea tabelului "tablename"
ERROR: interogarea a eșuat:
    ERROR: valoarea cheii duplicat încalcă constrângerea unică "index_16508"
DETALII: Cheia (id, index)=(100500, 42) există deja.
Situație clasică: în medii de testare totul funcționează, dar în producție – nu?!
APPLY_COUNT și intersecția dintre două batch-uri
Am început să analizăm codul absolut linie cu linie și am descoperit un punct important: transferul datelor din tabela de jurnal în nouă se face în batch-uri, constanta APPLY_COUNT indica dimensiunea batch-ului:
for (;;)
{
num = apply_log(connection, table, APPLY_COUNT);

if (num > MIN_TUPLES_BEFORE_SWITCH)
     continue;
/* ar putea mai fi câteva tuple, repetă. */
...
}
Problema este că datele din tranzacția inițială, în care mai multe operațiuni ar putea potențial să încalce constrângerea, la transfer ar putea ajunge pe intersecția a două batch-uri – o jumătate din comenzi ar fi comise în primul batch, iar cealaltă jumătate – în al doilea. Și aici depinde de noroc: dacă comenzile din primul batch nu încalcă nimic, totul este în regulă, dar dacă încalcă – apare o eroare.
APPLY_COUNT este de 1000 de înregistrări, ceea ce explică de ce testele noastre au trecut cu succes – ele nu acopereau cazul "intersecției batch-urilor". Am folosit două comenzi – insert și update, astfel încât exact 500 de tranzacții cu două comenzi au fost întotdeauna introduse în batch și nu am întâmpinat probleme. După adăugarea celui de-al doilea update, modificarea noastră a încetat să funcționeze:
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (1) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    UPDATE test_table set val = i where id = v_id; -- un alt update
    COMMIT;
  END;
END LOOP;
Deci, următoarea sarcină este să ne asigurăm că datele din tabela inițială, care au fost modificate într-o singură tranzacție, ajung în noua tabelă de asemenea într-o singură tranzacție.
Renunțarea la batch-ing
Și am avut din nou două opțiuni pentru soluționare. Prima: să renunțăm complet la divizarea în batch-uri și să transferăm datele într-o singură tranzacție. Avantajul acestei soluții era simplitatea – modificările de cod necesare erau minime (apropos, în versiunile mai vechi, pg_reorg funcționa exact astfel). Dar există o problemă — creăm o tranzacție de lungă durată, iar aceasta, așa cum s-a menționat anterior, reprezintă o amenințare pentru apariția unui nou bloat.
A doua soluție — mai complexă, dar probabil mai corectă: să creăm în tabelul de log un coloană cu identificatorul tranzacției care a adăugat datele în tabel. Atunci, când copiem datele, vom putea să le grupăm după acest atribut și să garantăm că modificările corelate vor fi transferate împreună. Batch-ul va fi format din mai multe tranzacții (sau dintr-una mare) și dimensiunea acestuia va varia în funcție de cât de multe date au fost modificate în aceste tranzacții. Este important de menționat că, având în vedere că datele din tranzacții diferite ajung în tabelul de log în ordine aleatorie, nu vom mai putea să le citim secvențial, așa cum era înainte. seqscan la fiecare cerere cu filtrare după tx_id – este prea scump, avem nevoie de un index, dar acesta va încetini, de asemenea, funcționarea metodei din cauza costurilor suplimentare de actualizare. În general, ca întotdeauna, trebuie să sacrificăm ceva.
Așadar, am decis să începem cu prima opțiune, fiind mai simplă. La început, a fost necesar să înțelegem dacă tranzacția de lungă durată va reprezenta o problemă reală. Deoarece transferul principal de date din tabelul vechi în cel nou se efectuează de asemenea într-o singură tranzacție de lungă durată, întrebarea s-a transformat în „cât de mult vom crește această tranzacție?” Durata primei tranzacții depinde în principal de dimensiunea tabelului. Durata celei noi – de cât de multe modificări se vor acumula în tabel în timpul transferului de date, adică de intensitatea încărcării. Rularea pg_repack a avut loc în timpul unei încărcări minime a serviciului, iar volumul modificărilor a fost incomparabil mic în comparație cu volumul inițial al tabelului. Am decis că putem ignora timpul noii tranzacții (ca referință, în medie, acesta este de 1 oră și 2-3 minute).
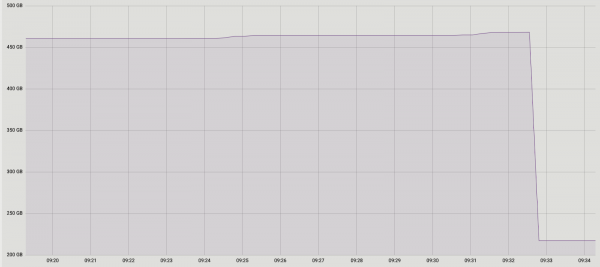
Experimentele au fost pozitive. Rularea în producție, de asemenea. Pentru a ilustra – imaginea cu dimensiunea uneia dintre baze după rulare:
Deoarece această soluție ne-a satisfăcut pe deplin, nu am încercat să implementăm a doua, dar luăm în considerare posibilitatea de a discuta acest lucru cu dezvoltatorii extensiei. Îmbunătățirea noastră actuală, din păcate, nu este încă pregătită pentru publicare, deoarece am rezolvat problema doar cu constrângerile unice amânate, iar pentru un patch complet este necesar să facem suport și pentru alte tipuri. Sperăm că vom reuși să facem acest lucru în viitor.
Este posibil să vă fi trecut prin minte întrebarea de ce ne-am implicat în această poveste cu îmbunătățirea pg_repack, și nu am folosit, de exemplu, analogii săi? La un moment dat ne-am gândit și noi la asta, dar experiența pozitivă anterioară în utilizarea sa, pe tabele fără constrângeri amânate, ne-a motivat să încercăm să înțelegem esența problemei și să o corectăm. De asemenea, utilizarea altor soluții necesită de asemenea timp pentru testare, așa că am decis să încercăm mai întâi să rezolvăm problema în el și, dacă ne dăm seama că nu ne putem descurca într-un timp rezonabil, vom începe să luăm în considerare analogi.
Conclusions
Ce putem recomanda pe baza propriei experiențe:
- Monitorizați bloat-ul dumneavoastră. Pe baza datelor de monitorizare, veți putea înțelege cât de bine este configurat autovacuum.
- Configurați AUTOVACUUM pentru a menține bloat-ul la un nivel acceptabil.
- Dacă totuși bloat-ul crește și nu îl puteți combate cu mijloacele „de cutie”, nu ezitați să utilizați extensii externe. Principalul lucru este să testați totul temeinic.
- Nu ezitați să adaptați soluțiile externe la nevoile dumneavoastră – uneori acest lucru poate fi mai eficient și chiar mai simplu decât modificarea codului dumneavoastră.
Sursa: habr.com
